
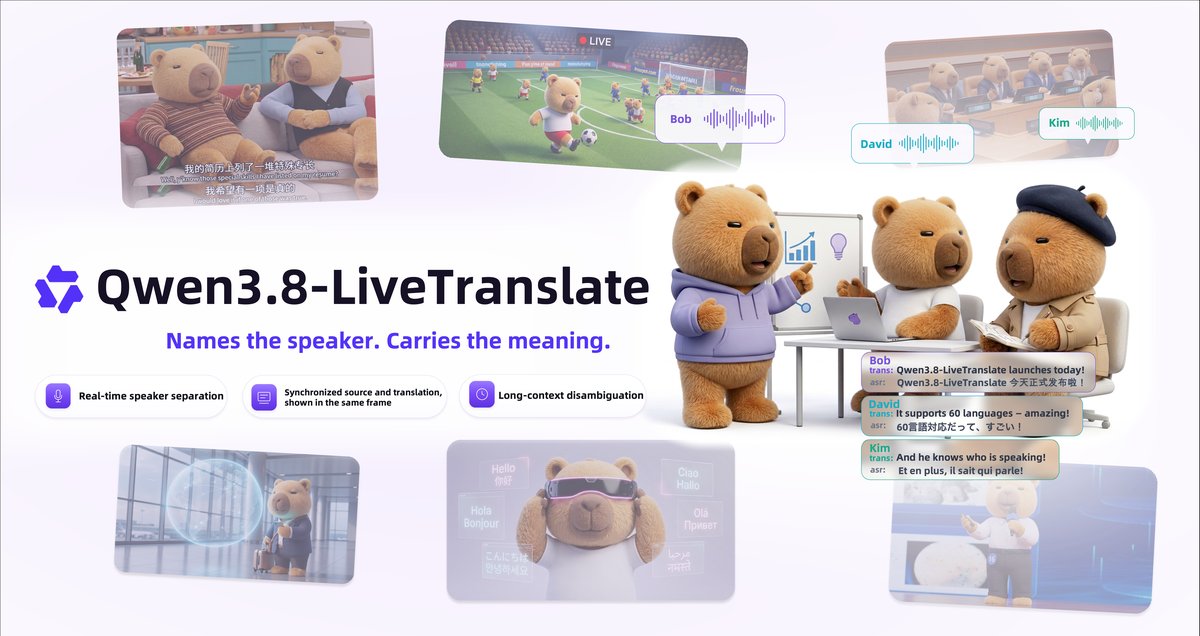
Qwen 3.8 Live Translate: A Nova Era da Tradução Simultânea Speech-to-Speech
A inteligência artificial acaba de dar mais um salto massivo no campo de processamento de voz e linguagem natural. O anúncio oficial do Qwen 3.8 Live Translate chega para alterar fundamentalmente o modo como interagimos em idiomas estrangeiros. Diferente de abordagens tradicionais que traduziam o áudio para texto, depois o texto para o idioma desejado e finalmente de volta para áudio (o chamado modelo em cascata), a nova versão da família Qwen (desenvolvida pela Alibaba Cloud) adota um loop direto de interações nativas e uma arquitetura multimodal unificada de altíssimo desempenho.
Neste artigo completo , recheado de detalhes técnicos, análises de arquitetura, gráficos de benchmark e demonstrações , vamos mergulhar fundo no que faz essa atualização ser um diferencial não só para o ecossistema Qwen, mas para toda a indústria de IA.
A Arquitetura Multimodal e o Problema da Cascata
Historicamente, aplicações de "Live Translate" dependiam de uma arquitetura fragmentada. O caminho de um áudio no idioma A até o áudio no idioma B sofria de atrasos significativos causados por três componentes trabalhando lado a lado:
- ASR (Automatic Speech Recognition): Transformar o áudio em texto.
- NMT (Neural Machine Translation): Traduzir o texto A para o texto B.
- TTS (Text-to-Speech): Sintetizar o texto B em voz.
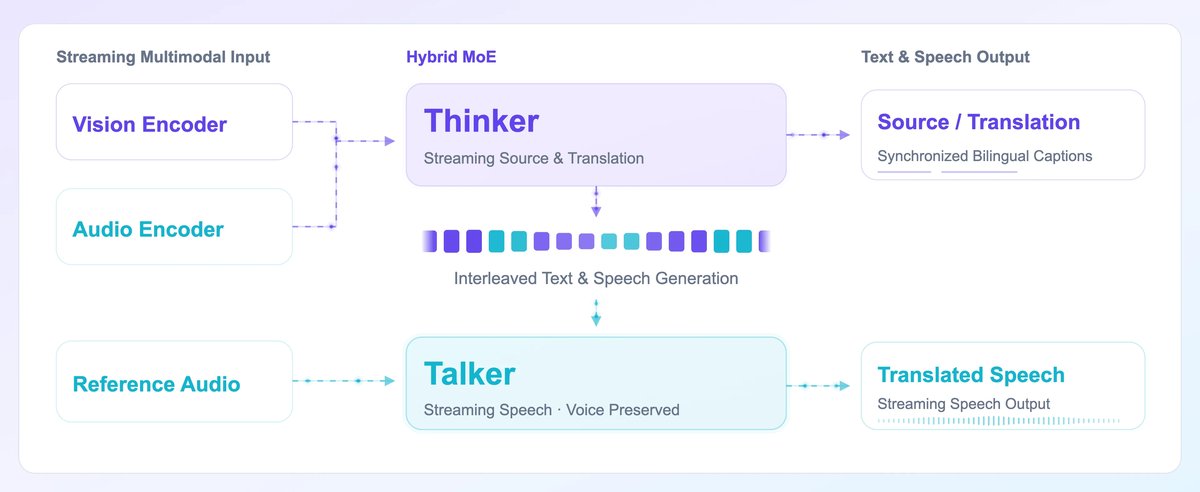
Cada etapa carregava não apenas latência, mas um gargalo na fidelidade da entonação, expressividade e na emoção da fala. No Qwen 3.8 Live Translate, a Alibaba adotou uma abordagem holística. A estrutura (demonstrada nas documentações oficiais com uma topologia otimizada) consolida as camadas, absorvendo as representações acústicas e processando-as diretamente através do modelo fundacional de linguagem (LLM).
Essa arquitetura end-to-end não só reduz drasticamente a latência de processamento "Time to First Audio" (TTFA), mas preserva o timbre, a ênfase original e a nuance de quem está falando. Para aplicações críticas como reuniões corporativas e cobertura de mídia global, a diferença é da água para o vinho. Você deixa de escutar aquele clássico tom robótico, passando a ouvir um locutor com flutuações humanas, respirações e dinâmicas coerentes.
Funcionalidades de Destaque S2S e a Conversa em Loop
Um dos conceitos inovadores introduzidos juntamente com esse modelo é o chamado "Loop de Tradução". Se observarmos de perto o fluxo de uso, o Live Translate permite uma conversa natural e bilateral que não quebra a cadência de interatividade do usuário.
Essa funcionalidade é descrita de forma dinâmica na documentação, garantindo:
- Latência Ultra Baixa: Possibilitando o engate rápido em reuniões via Zoom ou Google Meet.
- Continuidade Contextual: O modelo lembra do que foi falado há cinco minutos atrás e entende gírias ou siglas que se aplicam especificamente àquela sessão contínua.
- Adaptação Acústica: Conforme o ruído de fundo altera, os mecanismos de atenção ajustam os tensores com robustez impressionante.
Múltiplos Falantes: A Solução Definitiva (Multi-Speaker Support)
Tentar legendar ou traduzir áudios com duas, três ou quatro pessoas conversando e se interrompendo simultaneamente é o calcanhar de Aquiles das APIs de comunicação (Diarixação de locutores). O Qwen 3.8 Live Translate parece ter superado o limite da transcrição isolada com a identificação e separação nativa de fluxo (Speaker Diarization em tempo real).
Como o Qwen lida com a entrada de áudio como "tokens de áudio integrados" no núcleo da LLM, o mecanismo de atenção (Attention Mechanism) isola assinaturas acústicas. Resultado: ele traduz a Pessoa A com a entonação da Pessoa A, e, com precisão admirável, a Pessoa B com as peculiaridades dela, não misturando contextos. Imagine uma mesa redonda: agora as transcrições S2S conseguem separar os canais do interlocutor antes mesmo de formatar a matriz de tradução inteligente.
O Benchmark FLEURS: Prova Real Categórica do Desempenho
Como medir qualitativamente a tradução automática por voz? Atualmente, um dos padrões de ouro é o FLEURS (Few-shot Learning Evaluation of Universal Representations of Speech). É uma base de dados expansiva pensada para verificar o reconhecimento de fala em múltiplos idiomas (especialmente idiomas com poucos recursos – low resource languages).
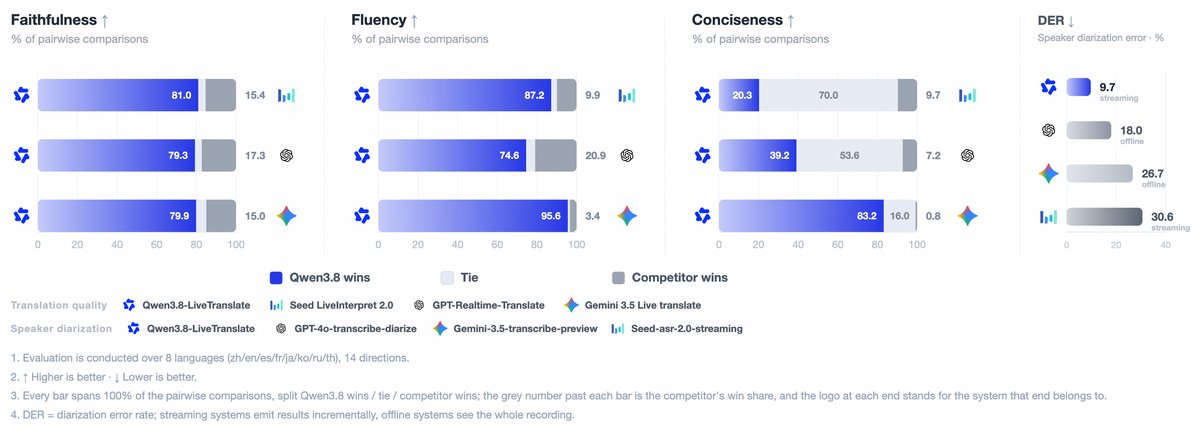
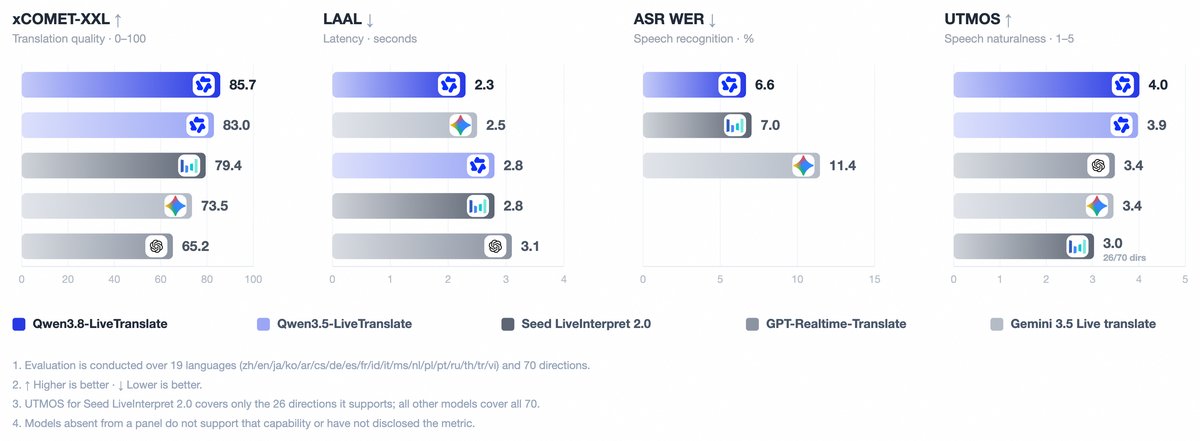
As estatísticas mostram a dominância do Qwen 3.8 em várias ramificações do FLEURS comparado aos seus equivalentes open-weights mais antigos ou a concorrentes diretos (como algumas ramificações do Llama ou mesmo sistemas proprietários engessados). Quando avaliado em acurácia de tradução BLEU/ChrF com áudio simultâneo, este ponto consolida o porquê essa geração é tão celebrada na comunidade MLOps. Maior eficiência por parâmetro significa que você pode hospedar uma instância pesada de processamento S2S usando menos VRAM.
Pontos Chave para Adoção e Casos de Uso Empresarial
Na visão de adoção de negócio, o que vemos é que a era de transcrição atrasada acabou. Algumas aplicações práticas em que a adoção será acelerada incluem:
- E-commerce Cross-Border: Transmissões ao vivo e atendimento por vídeo em plataformas que interagem globalmente, como o próprio ecossistema Alibaba/AliExpress, terão assistência em voz unificada.
- Centrais de Atendimento e Telemedicina: Diálogos técnicos requerem a precisão natural. Quando médicos e pacientes consultam globalmente, a fluidez do Multi-Speaker resolve ruídos de comunicação antes impossíveis para a IA S2S.
- Produção de Mídia: Dublagem instantânea e "auto-captions" sem passar por arquivos
.srtextensos.
Conclusão: Um Passo Gigante no Paradigma Omnichannel
Para desenvolvedores, engenheiros em infraestrutura de dados IA e líderes em inovação, o lançamento e as capacidades detalhadas do Qwen 3.8 sugerem que a arquitetura unificada de fala-para-fala (Speech-to-Speech nativa, ou S2S-LLMs) é o futuro imutável do Natural Language Processing avançado. A quebra do paradigma da "fita de montagem" (ASR -> Tradutor -> Voz Sintética) e a consolidação no mesmo transformador geracional ditam a velocidade e fidelidade que o mercado exigirá a partir de hoje.
A evolução constante e os resultados mostrados pelas análises de arquitetura, a flexibilidade vista nos gifs práticos e o rigor verificado nos benchmarks do FLEURS afirmam a superioridade desta novidade técnica. Se o mercado abraçará essas características isoladamente numa API ou via instâncias privadas completas, é apenas uma questão de velocidade de distribuição – pois a tecnologia já é madura.
O que você acha dessa revolução da tradução em tempo real sem latência? Sinta-se à vontade para compartilhar este material, mergulhe nos tutoriais nas páginas do Qwen Studio ou descubra mais conteúdos excepcionais sobre MLOps e Automação no nosso ecossistema de artigos técnicos do Baita Site!
Quer ajuda para colocar isso em pratica?
A Baita Site trabalha com sites, e-commerce, sistemas e IA. Quem prefere resolver com acompanhamento, sem ter que virar especialista em tudo, costuma procurar esse tipo de suporte.
Veja tambem
Perguntas Frequentes (FAQ)
1. O que diferencia o Qwen 3.8 Live Translate dos tradutores antigos?
Em vez de transformar áudio em texto, traduzir o texto e sintetizar a voz novamente (modelo em cascata), o Qwen processa voz-para-voz de forma nativa e unificada no LLM, reduzindo latência drásticamente e mantendo o formato humano do locutor.
2. O que é Suporte a Múltiplos Falantes (Multi-Speaker)?
Significa que o modelo entende quando há duas ou mais pessoas conversando ao mesmo tempo ou com tons de voz diferentes, sendo capaz de isolá-las nativamente sem bugar a tradução do fluxo de reunião.
3. Como foi a performance do Qwen 3.8 no benchmark FLEURS?
Como demonstrado nas análises, o Qwen 3.8 possui resultados proeminentes nas modalidades do FLEURS (parâmetro global para reconhecimento de línguas). Ele bate recordes em acurácia de tradução mesmo com áudio simultâneo perante a concorrência aberta.