
Xiaomi MiMo V2.6: o modelo open-weight mais poderoso do mundo é chinês, custa 60x menos e foi treinado ao vivo
22 de setembro de 2026 , A Xiaomi acaba de lançar e abrir o código da série MiMo V2.6. Três modelos. Licença MIT. 1 milhão de tokens de contexto. E um placar que ninguém esperava de uma fabricante de celular e carros elétricos.
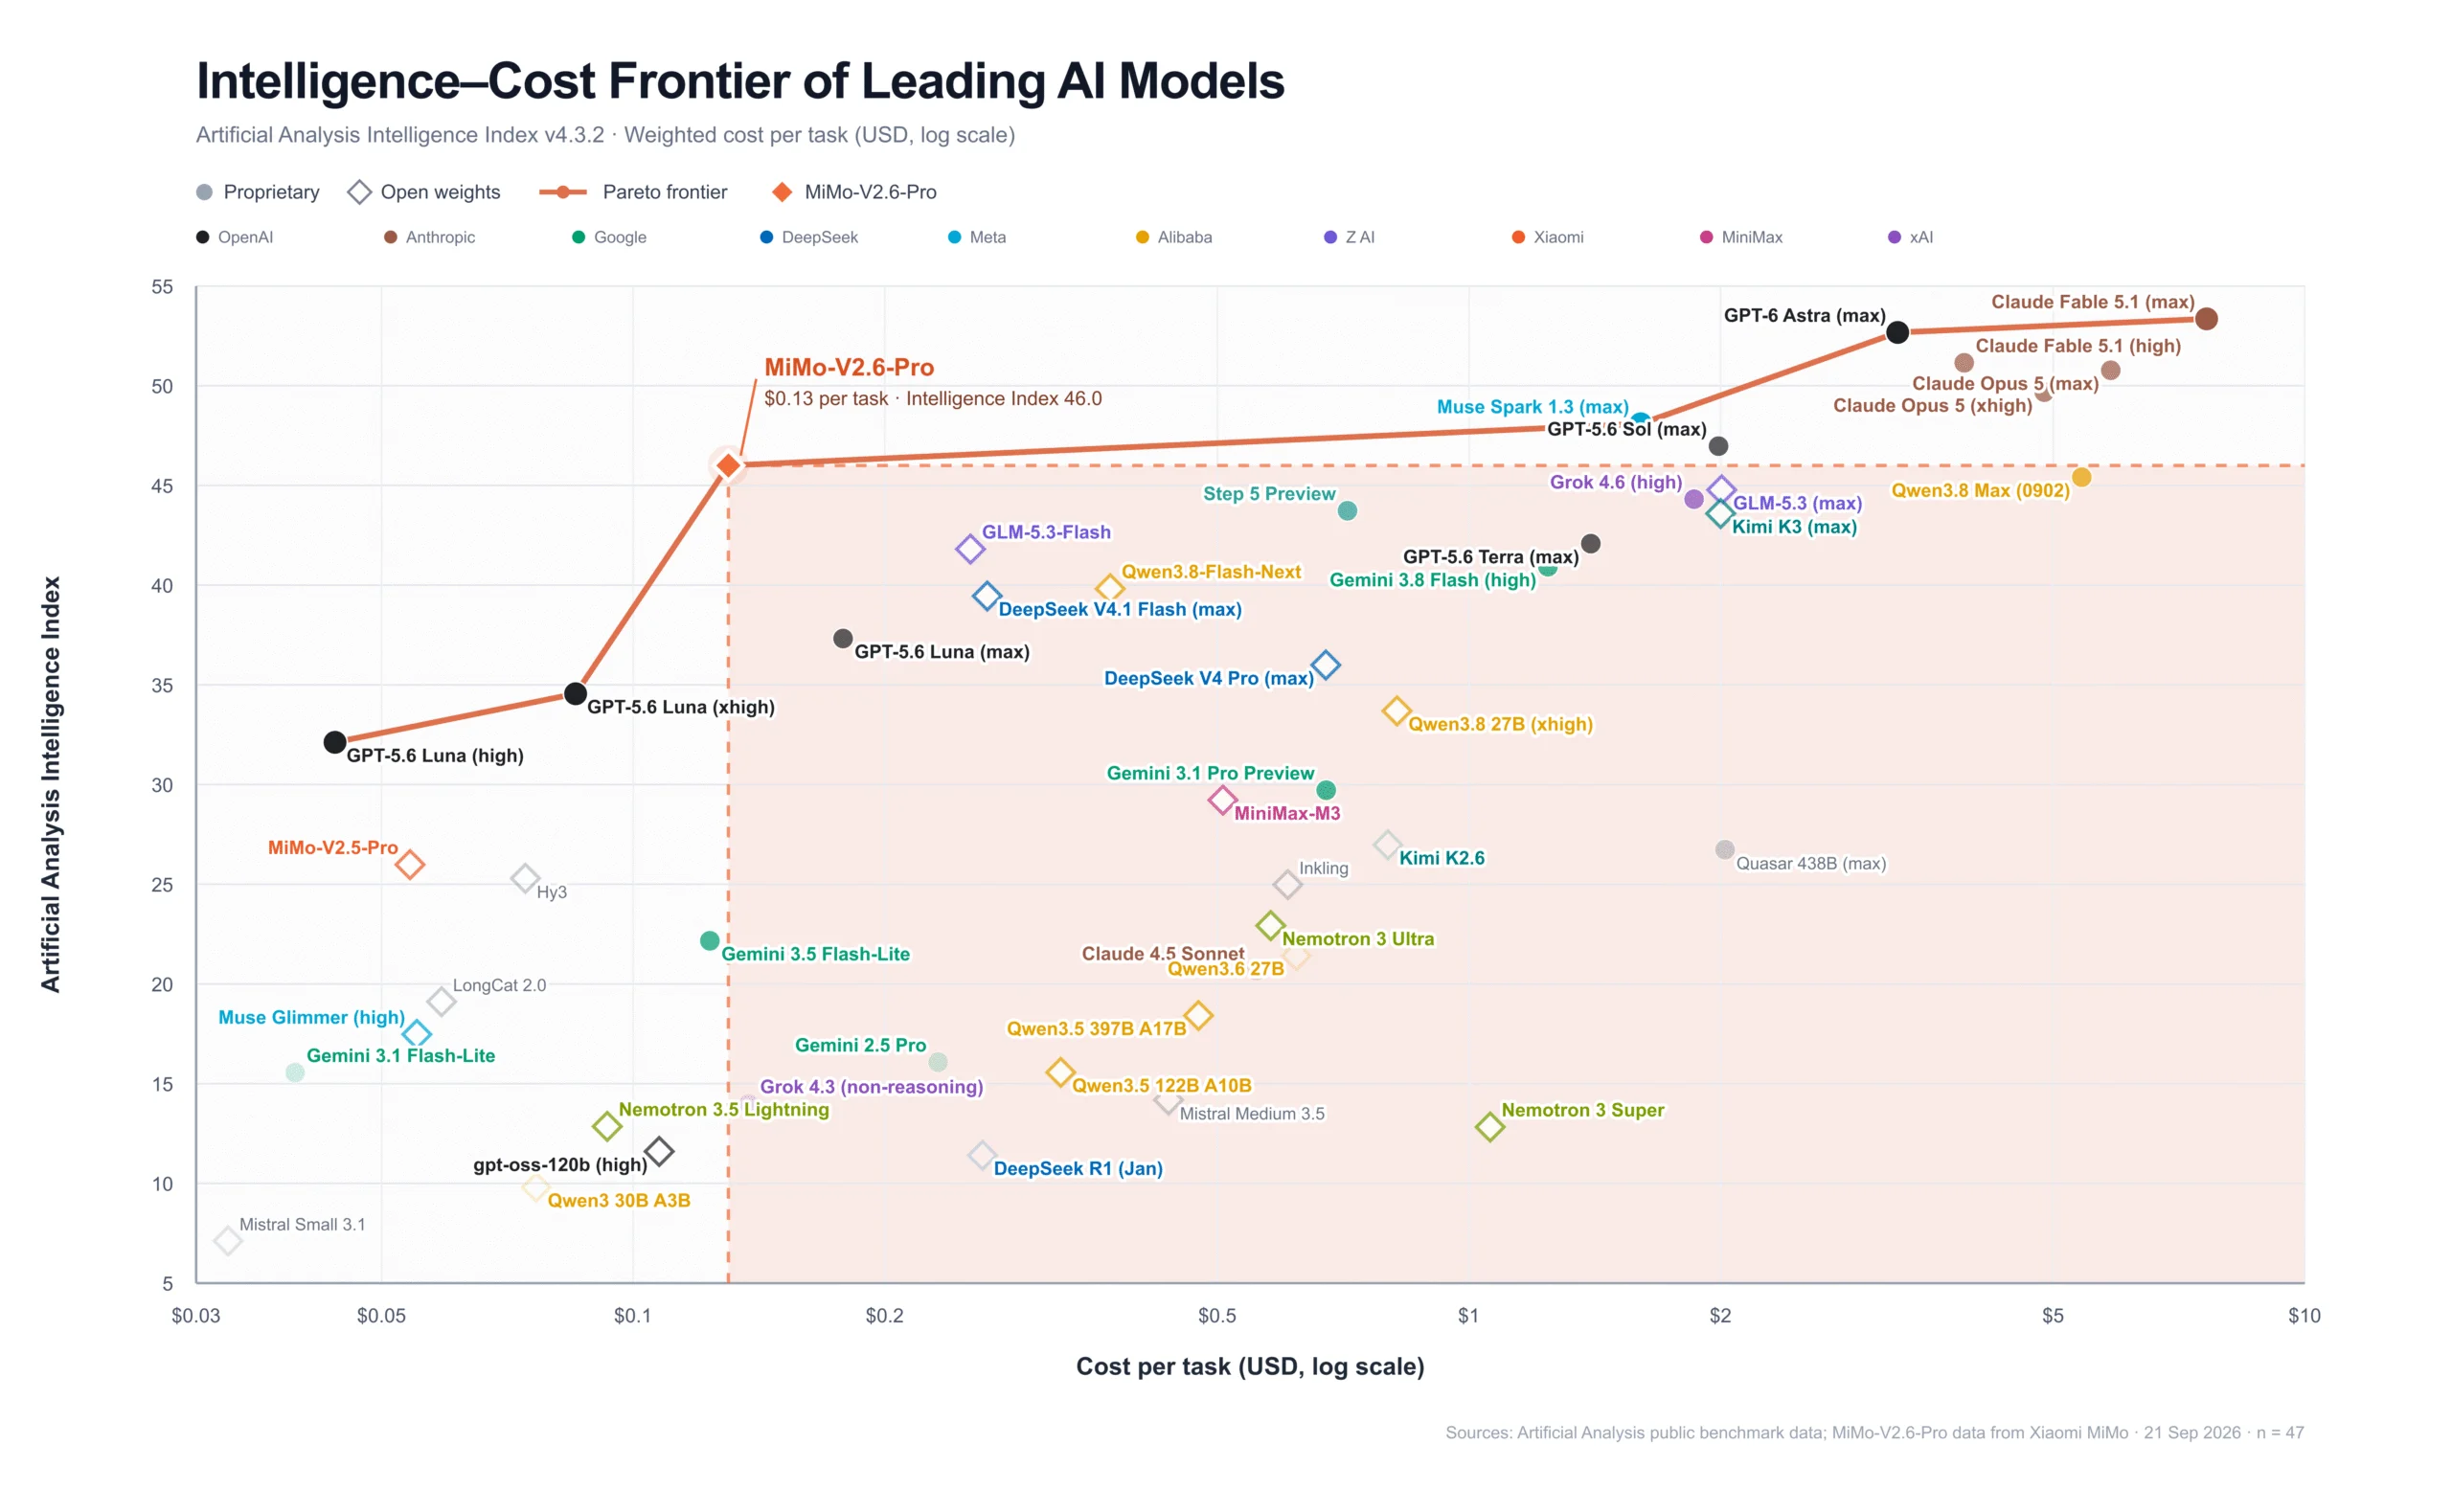
O MiMo V2.6 Pro chegou com 46.32 pontos no Artificial Analysis Intelligence Index , o maior score já registrado para um modelo open-weight. Passou Kimi K3 (44), Qwen 3.8 Max, GLM-5.3, e empatou com o Grok 4.7 da SpaceXAI que estreou no mesmo dia. Ficou a 1 ponto do GPT-5.6 Sol (47) e a 7 dos líderes fechados Claude Fable 5.1 e GPT-6 Astra (53).
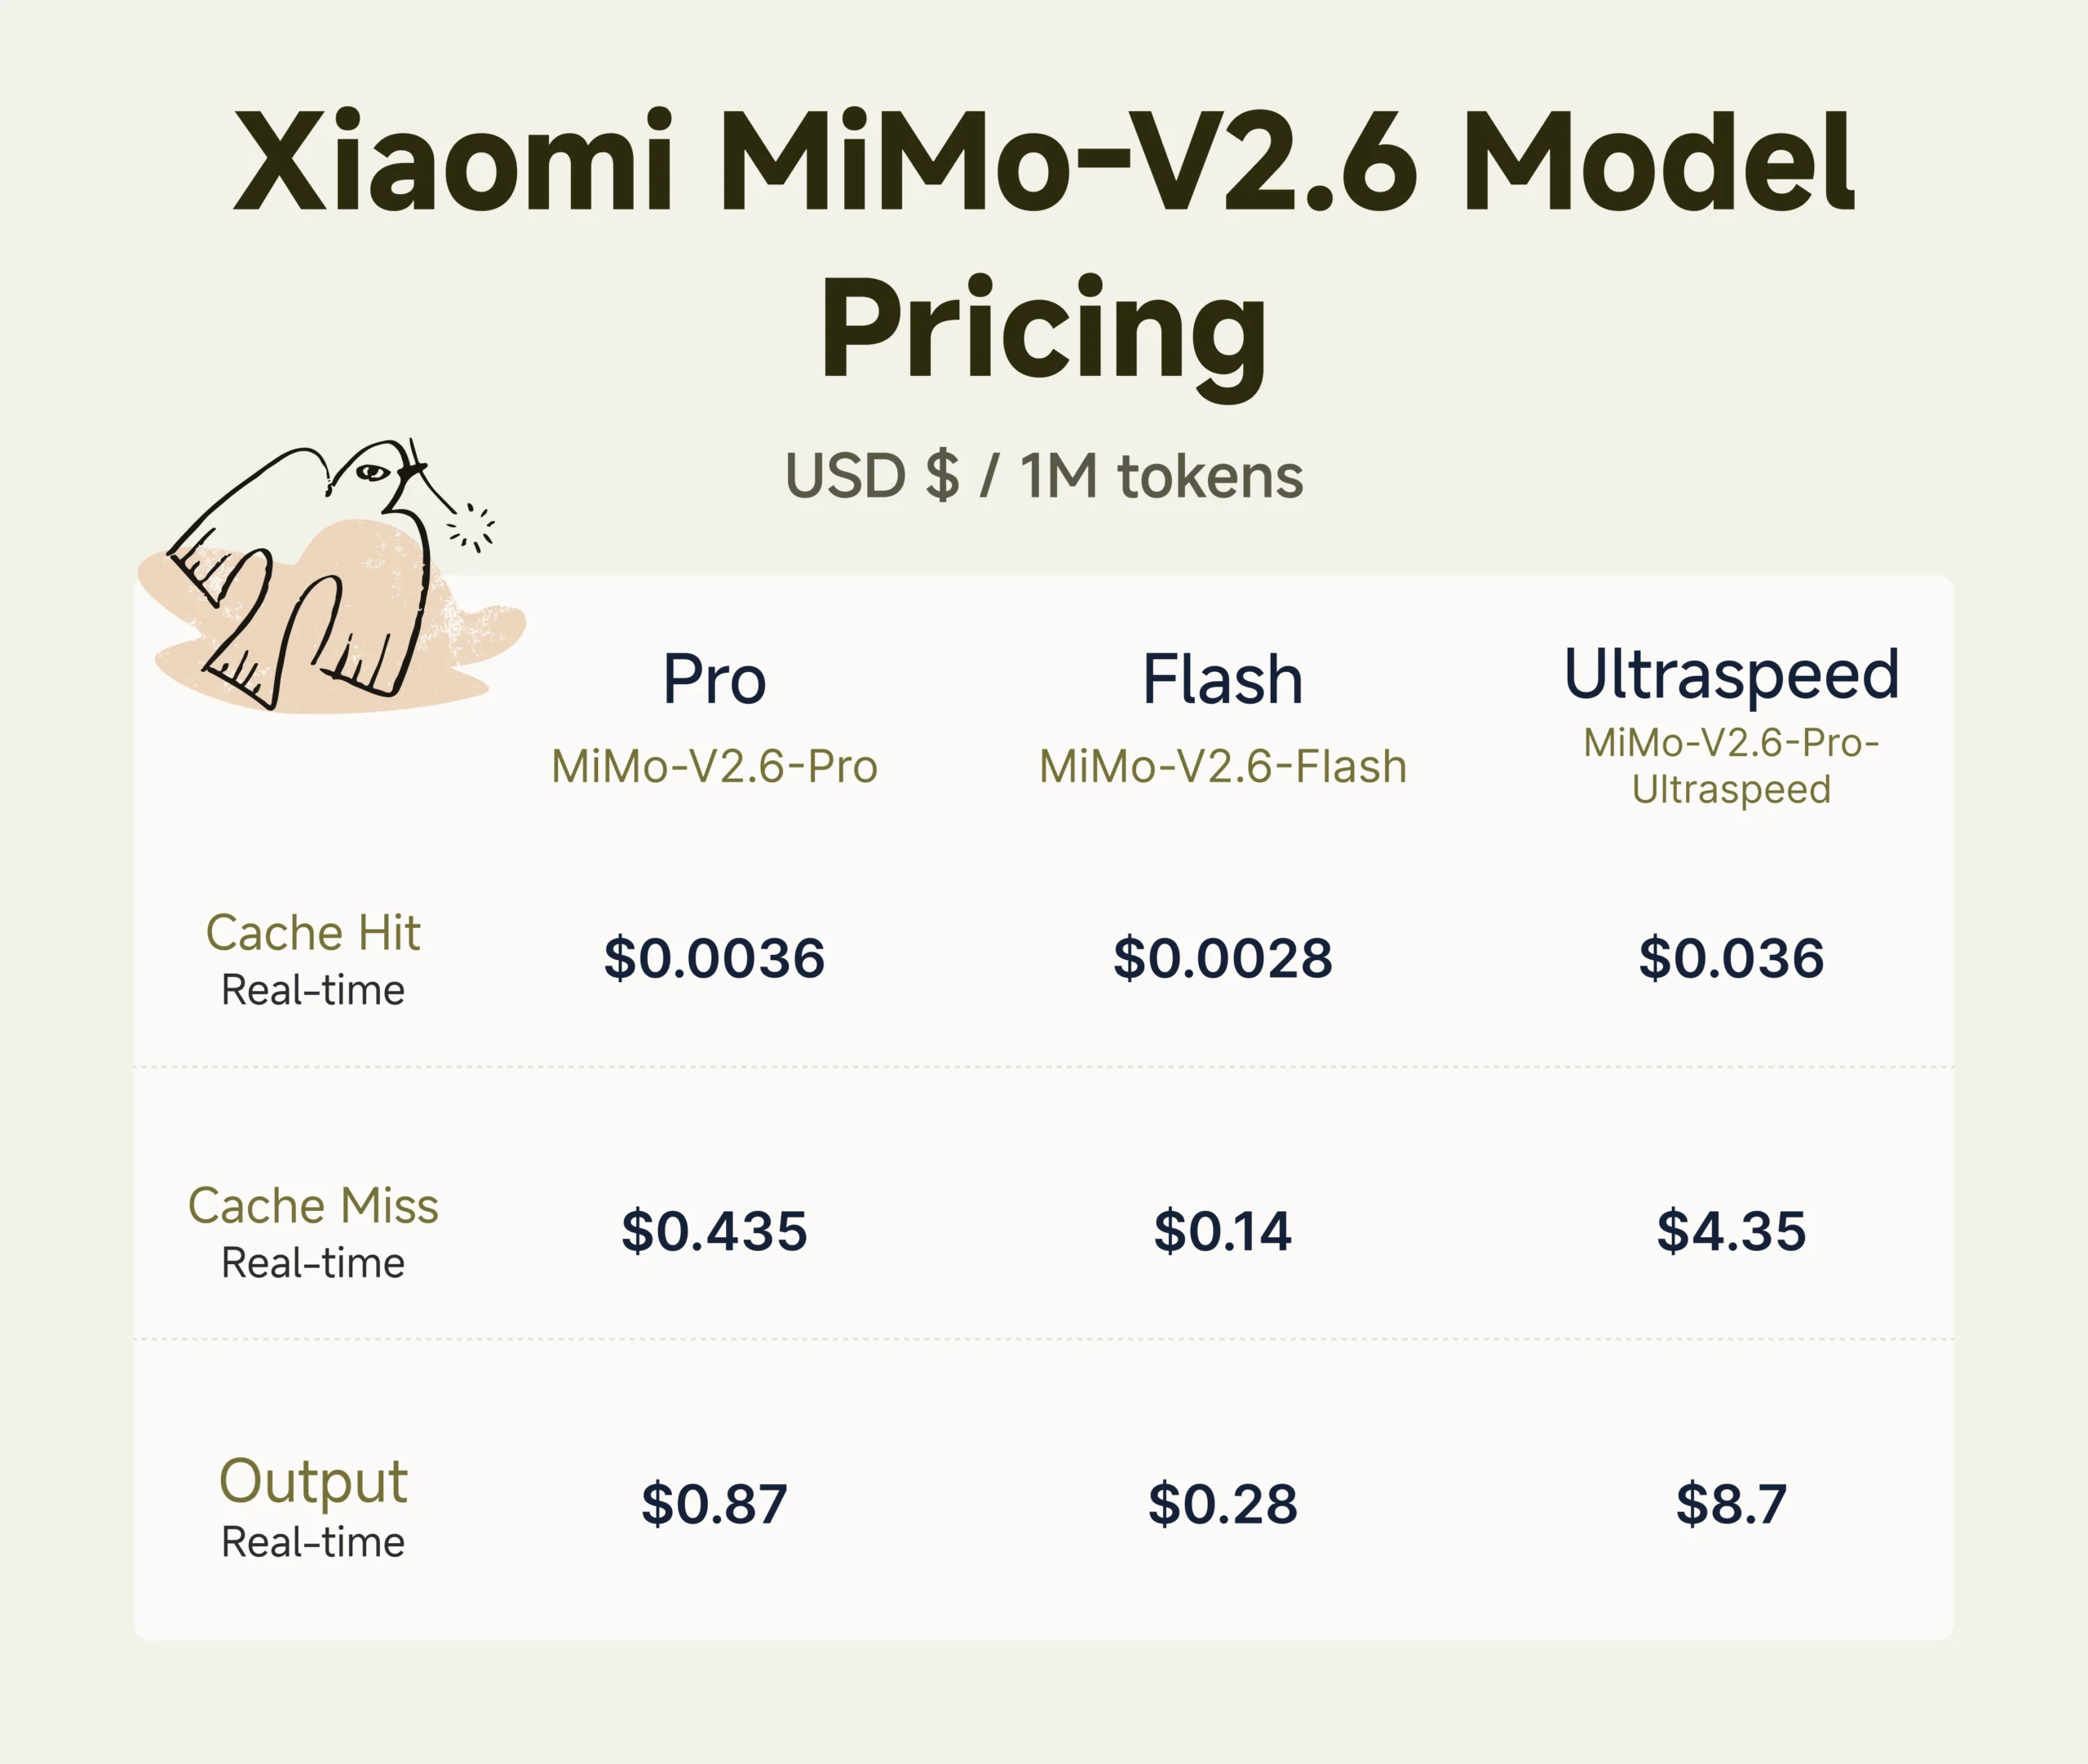
Mas o número mais violento não está no benchmark: o MiMo V2.6 Pro custa 1/20 a 1/60 do preço dos modelos proprietários no mesmo patamar de inteligência. A precificação da linha V2.5 foi mantida , input sem cache a $0.435/milhão de tokens, output a $0.87. O Flash sai por $0.14/$0.28. Para tarefas de alto volume, é a nova fronteira de Pareto em custo × inteligência.
O treinamento que o mundo assistiu
Antes do lançamento, a Xiaomi fez algo que nenhum grande laboratório havia feito: transmitiu ao vivo o treinamento RL dos dois modelos por 6 dias. O dashboard público mostrava steps, curvas de reward, throughput de tokens, falhas de GPU e um contador de custo que subia em tempo real.
O resultado:
| MiMo V2.6 Flash | MiMo V2.6 Pro | |
|---|---|---|
| Steps de RL | 30 | 30 |
| Trajetórias totais | ~750k (combinado) | ~750k (combinado) |
| Tokens consumidos | 81.4B | 75B |
| Custo do treinamento | $854k | $2.62M |
| Tempo de wall-clock | 3 dias 11h | 5 dias 7h |
| Melhoria relativa no pass rate | +25% | +12% |
| DeepSWE v1.1 (pré → pós RL) | 48.8 → 65.68 | 58.4 → 72.57 |
Cada step processava 1,568 prompts com 16 rollouts , 25,088 trajetórias por step , rodando GRPO totalmente assíncrono. O time liderado por Luo Fuli (ex-DeepSeek, ex-DAMO Academy) documentou tudo com um nível de transparência que torna muito difícil descartar os números como cherry-picking.
Por trás dos 6 dias públicos, meio ano de pesquisa fundamental e tentativa-e-erro de engenharia. A frase da Xiaomi: "onde o caminho é plano e próximo, muitos viajantes; onde é acidentado e distante, poucos chegam ao fim."
A linha completa
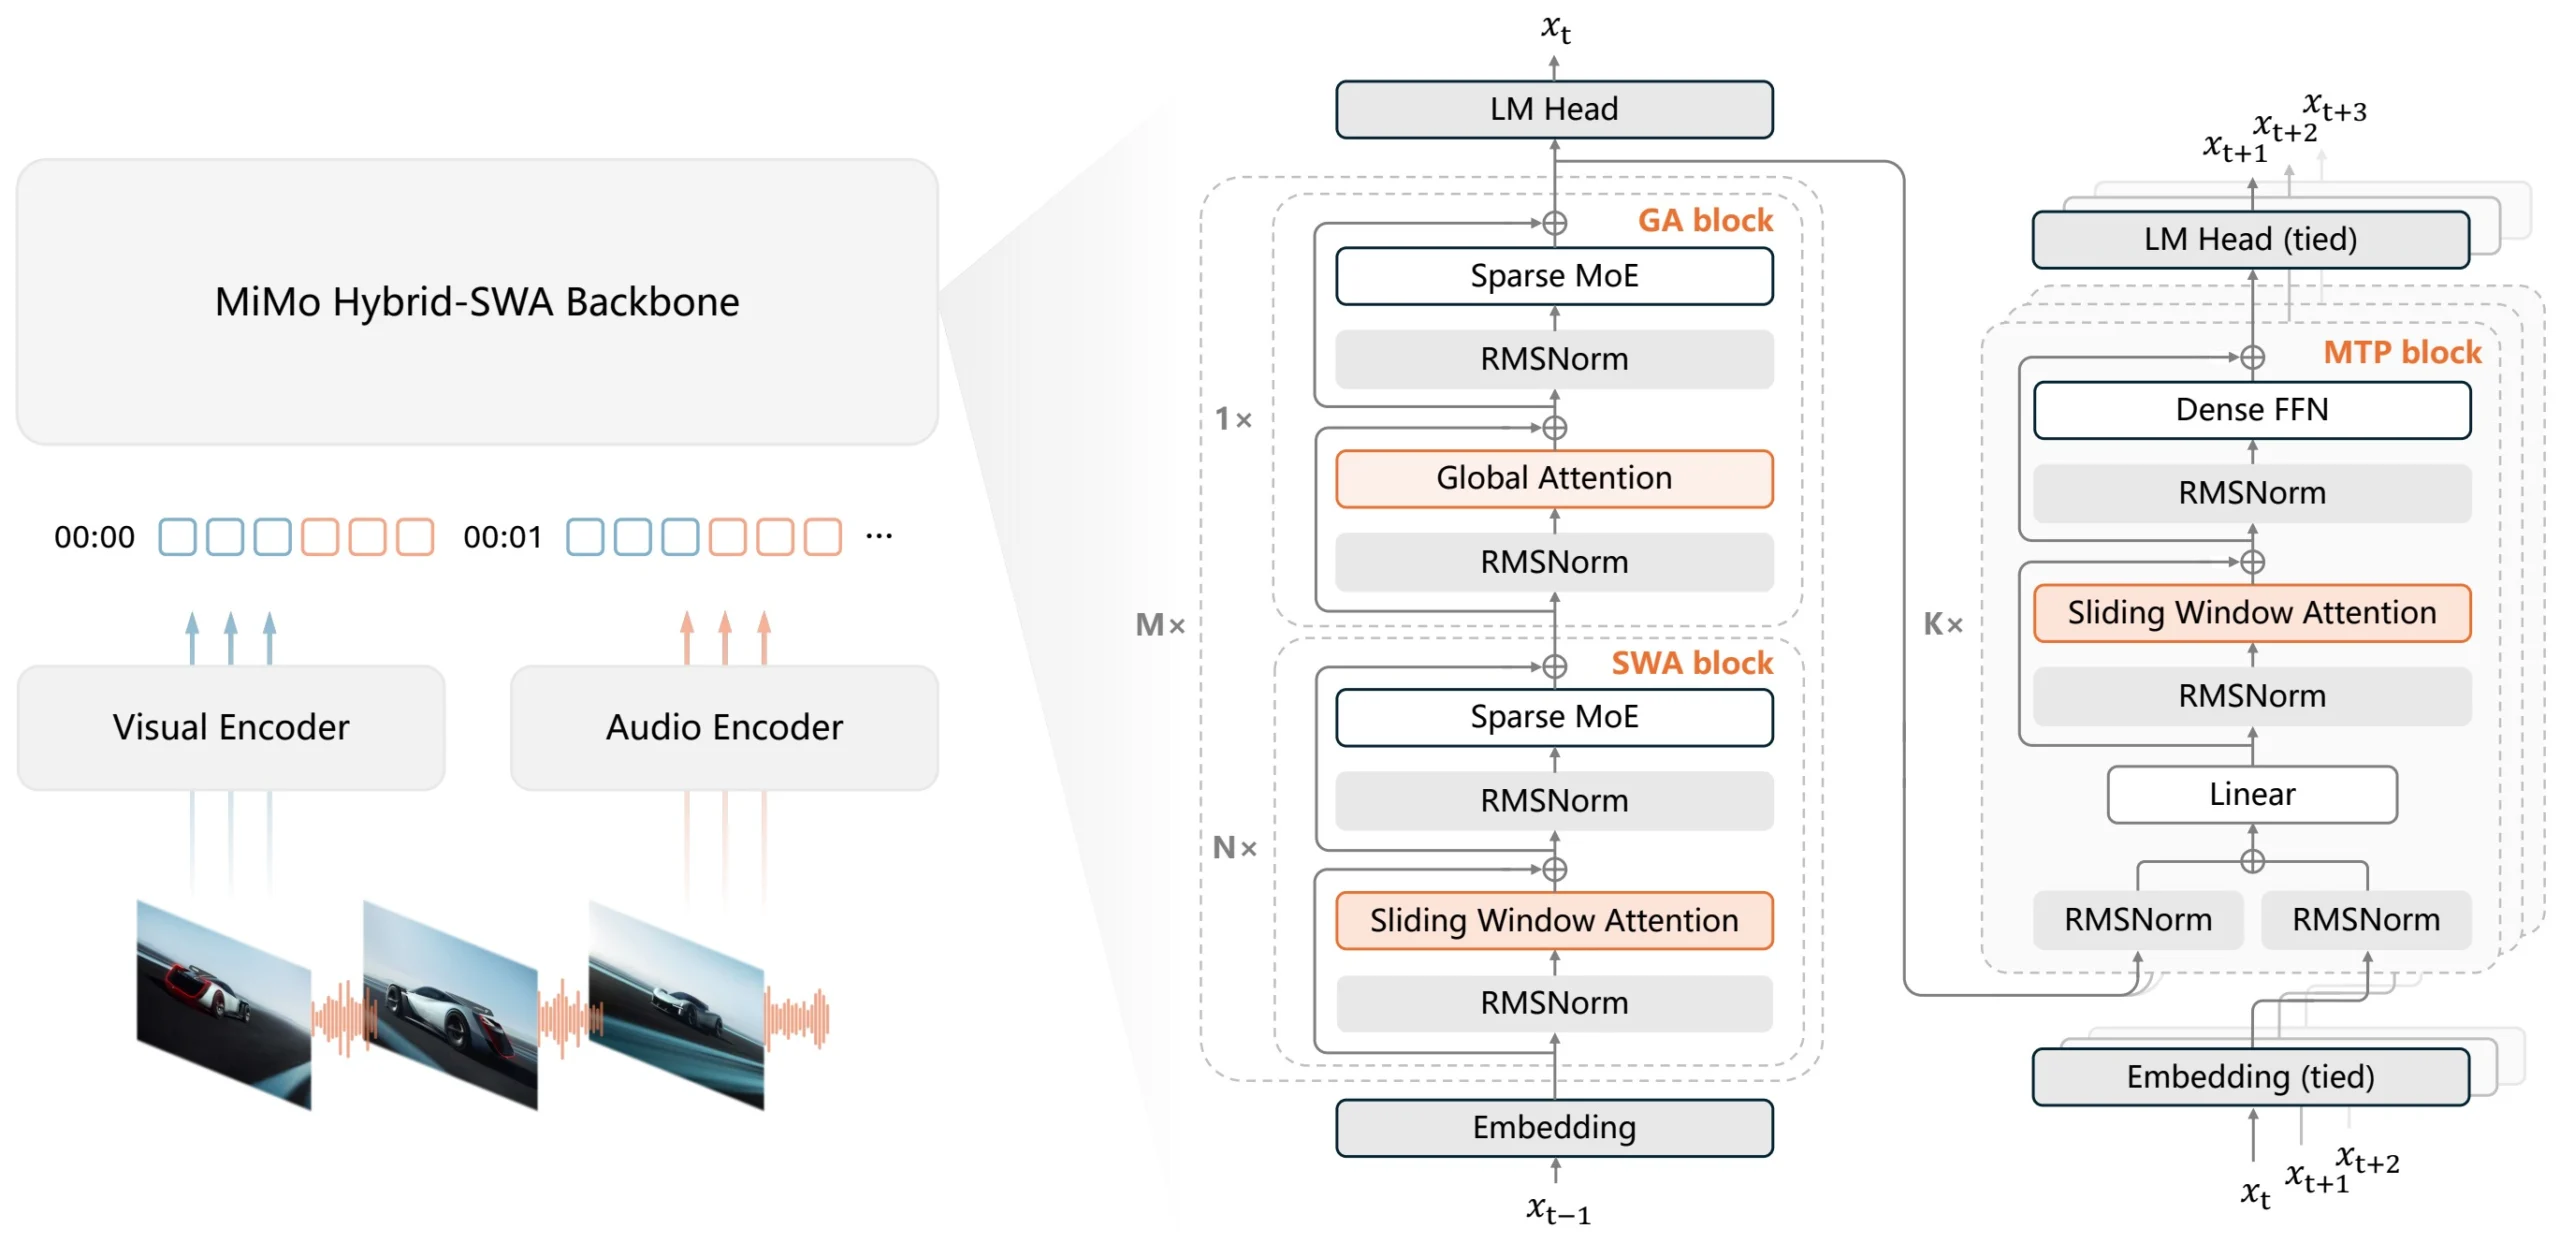
MiMo V2.6 Pro , Flagship. 1.02 trilhão de parâmetros totais (42B ativos por token). MoE esparso com 384 experts roteados, 8 ativos por token. Contexto de 1M tokens. Native multimodal: texto, imagem, vídeo, áudio.
MiMo V2.6 Flash , Custo-benefício extremo. 309B total / 15B ativos. Mesma janela de 1M tokens, mesmas capacidades multimodais. Performance de agente surpreendentemente próxima do Pro em várias tarefas, por ~1/3 do preço.
MiMo V2.6 Pro UltraSpeed , Modo de inferência ultra-rápida do Pro. Até 20x mais velocidade de output, mesma qualidade. Pensado para trading quantitativo em tempo real, controle de risco de fraude em milissegundos, e code assistants com latência zero percebida. Preço premium: $4.35/$8.70 por milhão de tokens.
MiMo V2.6 Distill Qwen 9B , Modelo de 9B destilado para pesquisa aberta em RL agentivo. SFT sobre Qwen 3.5 9B com dados gerados pelo MiMo. Cobre coding, agentes, cybersecurity e visual coding. Ideal para quem não tem cluster mas quer brincar com RL.
Arquitetura
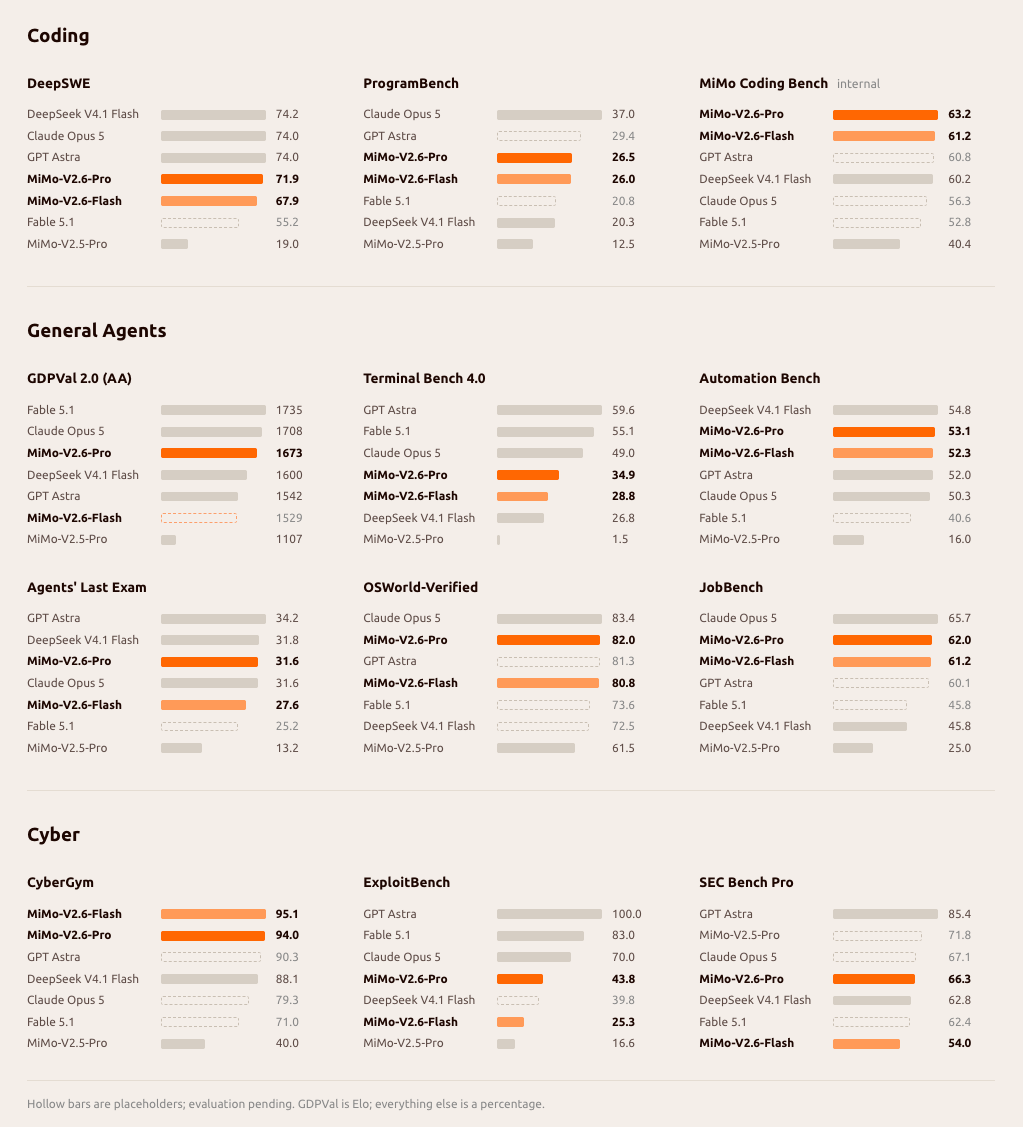
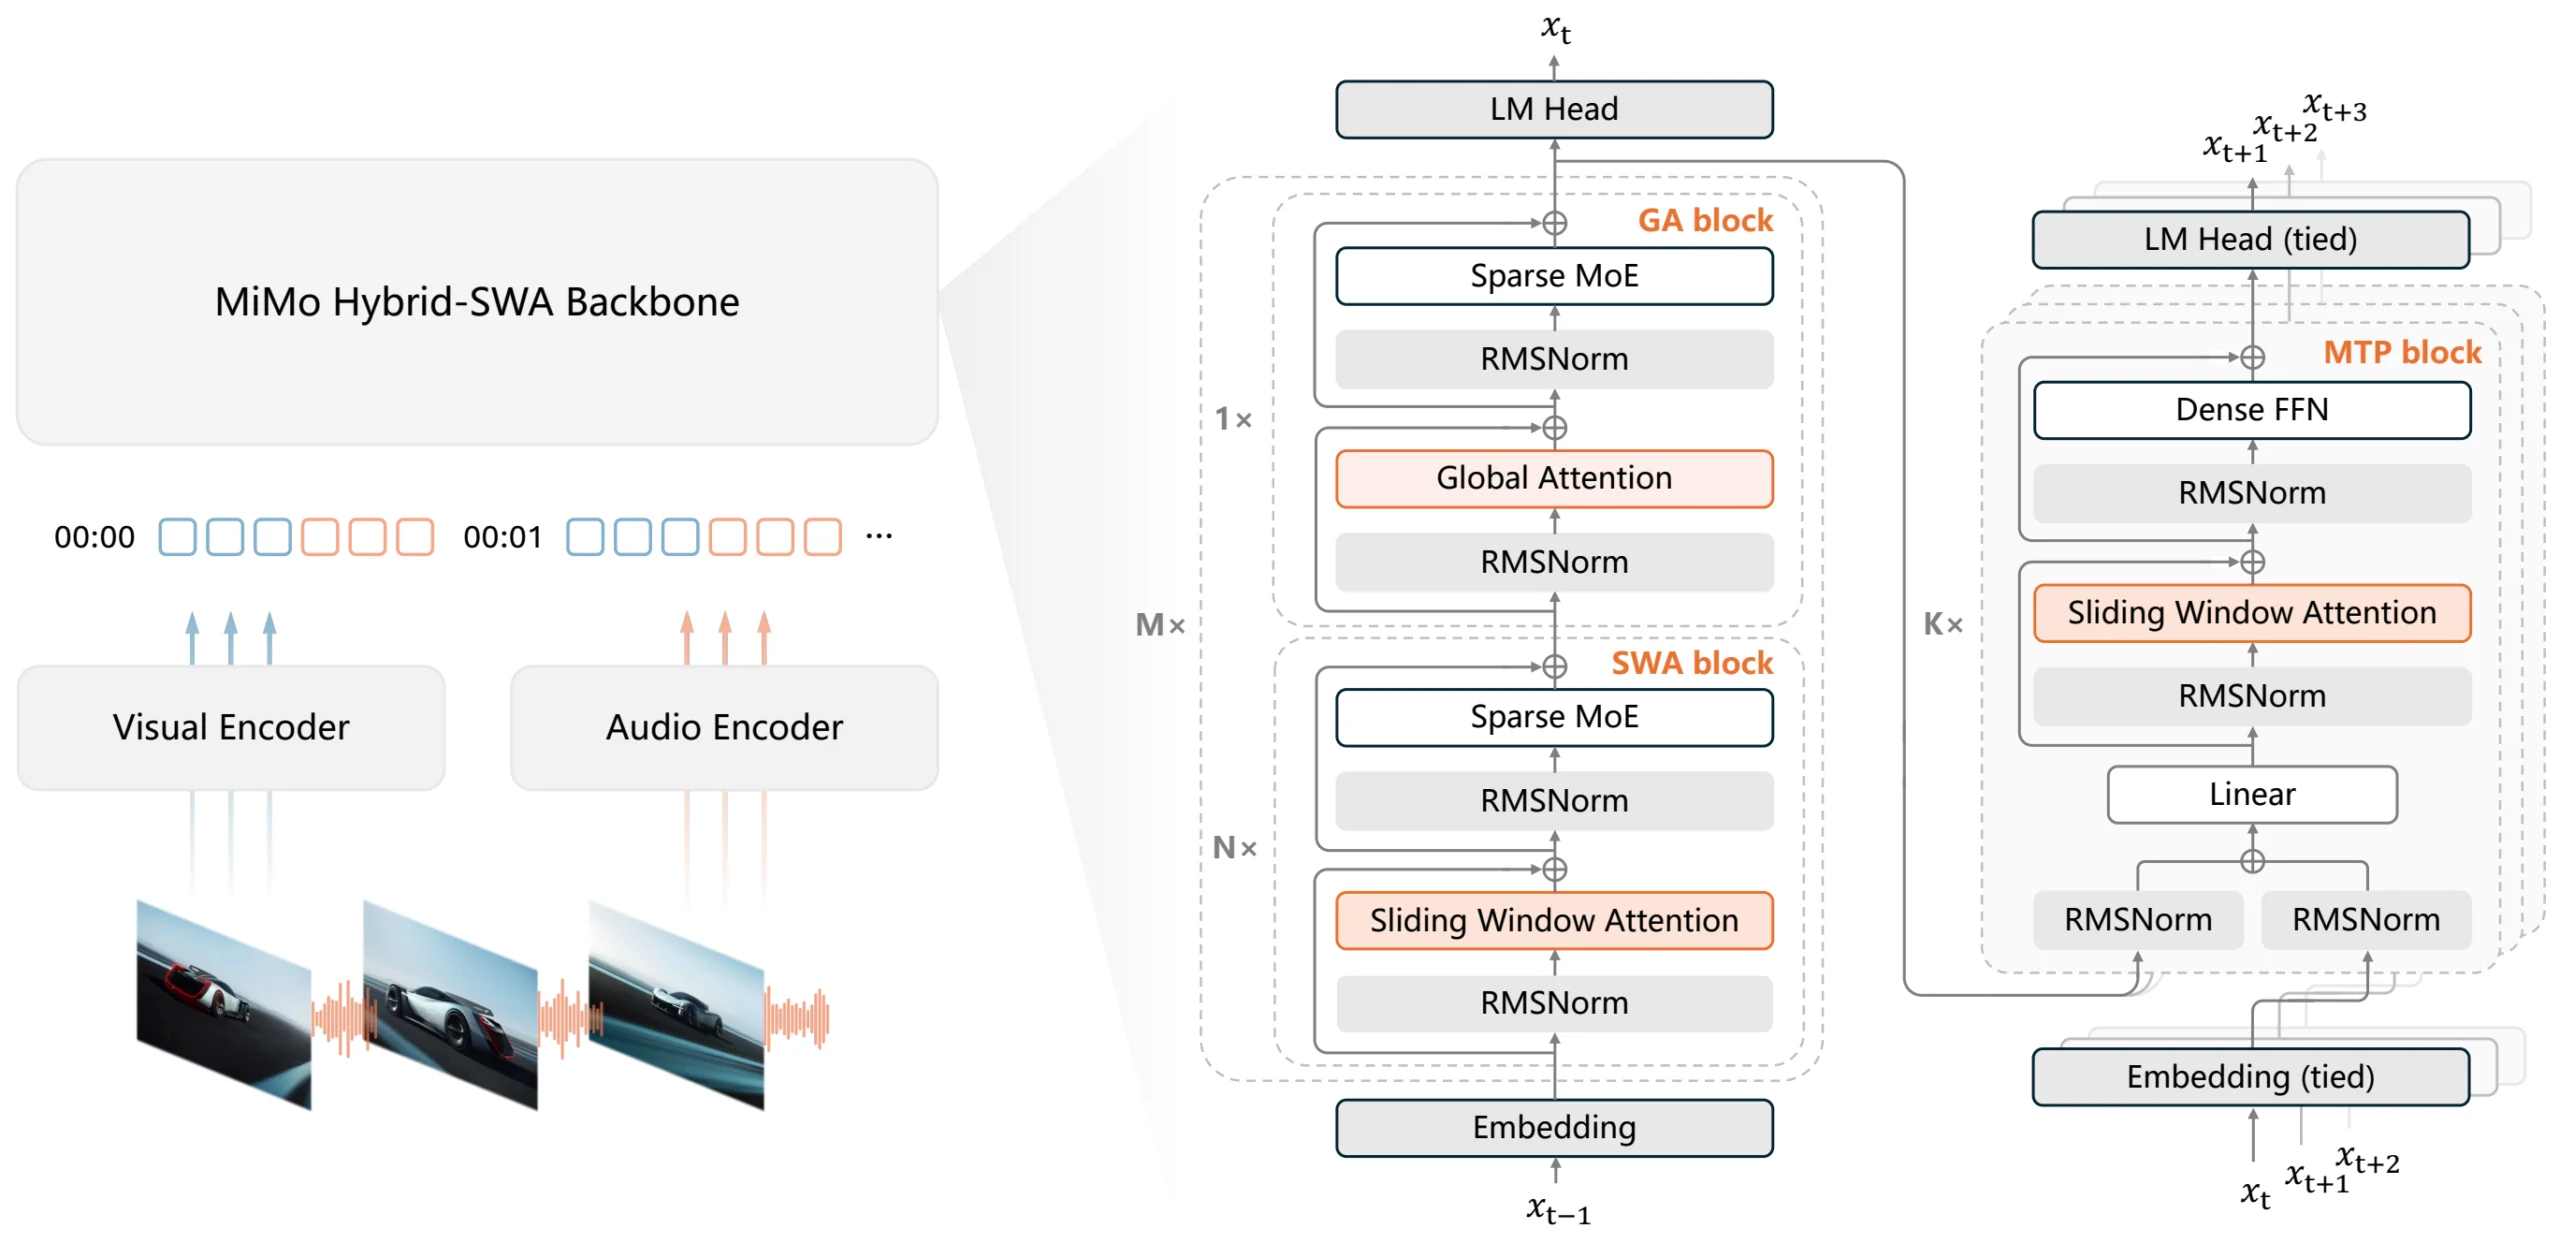
A arquitetura mantém o design híbrido SWA + Global Attention da família MiMo, com melhorias:
- Vision Encoder: ViT de 681M parâmetros (28 camadas: 24 SWA + 4 Full)
- Audio Encoder: AudioTokenizer de 308M + patch encoder de áudio de 127M
- Multi-Token Prediction: decoder especulativo de 5 camadas (contra 3 do V2.5)
- Contexto: 1M tokens nativo para todos os modelos
- MoE: 384 experts roteados, 8 por token (Pro); 256 experts, 8 por token (Flash)
- Grouped Query Attention: 128 attention heads, 8 KV heads (GQA)
O segredo do salto não está na arquitetura , está no RL em escala. A Xiaomi chama de "You Only RL Once": um único run de RL misturando coding, agentes, tarefas visuais e cybersecurity no mesmo batch, com as capacidades se reforçando mutuamente.
O sistema de grading também é inovador. Em vez de binary pass/fail (que não distingue soluções boas de excelentes), usam Groupwise Agentic Grading: um grader agentivo compara rollouts dentro de cada grupo, rankings de qualidade que vão além do teste binário, e redistribuição de vantagem que empurra a policy para soluções mais curtas e com menos tokens.
MOPD² (Multi-Prefix Multi-Teacher On-Policy Distillation): depois do RL misto, combina rollouts autônomos do student com rollouts condicionados por prefixos de professores , reutilizando históricos de trajetórias docentes para estender capabilities a tarefas difíceis de verificar.
Benchmarks: a letra miúda que importa
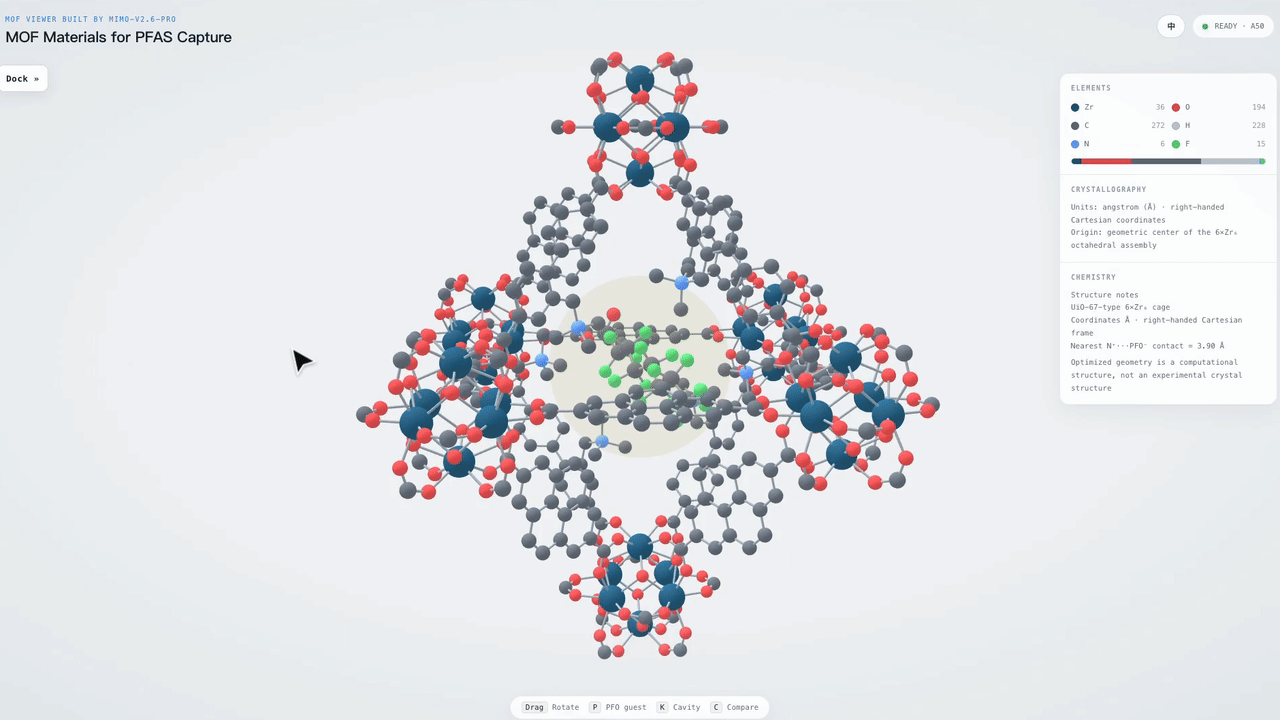
A Xiaomi publicou uma tabela honesta , mostrando onde ganha e onde ainda perde. Isso é raro.
Onde o Pro brilha:
| Benchmark | V2.6 Pro | V2.6 Flash | V2.5 Pro | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|---|
| DeepSWE v1.1 | 71.9 | 67.9 | 19.0 | 74.0 | 73.0 |
| Terminal Bench 2.1 | 89.9 | 87.6 | 65.2 | 89.1 | 88.8 |
| AutomationBench | 53.1 | 52.3 | 16.0 | 50.3 | 45.8 |
| CyberGym | 94.0 | 95.1 | 40.0 | , | , |
| Toolathlon-Verified | 76.9 | 73.6 | 49.1 | 80.6 | 74.9 |
| OSWorld-Verified | 82.0 | , | , | , | , |
| MiMo Visual Coding | 72.3 | 71.5 | , | 70.0 | 73.4 |
Onde o Pro ainda apanha:
| Benchmark | V2.6 Pro | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|
| ProgramBench | 26.5 | 37.0 | , |
| Terminal Bench 4.0 | 34.9 | 49.0 | , |
| ExploitBench | 47.9 | , | 78.5 |
| SEC Bench Pro | 66.3 | , | 79.1 |
Tradução: o V2.6 Pro é um modelo agentivo de classe frontier. Automação, uso de ferramentas, terminal, computer use , troca soco com modelos que custam 20-60× mais. Mas em raciocínio competitivo puro (ProgramBench) e segurança ofensiva (ExploitBench), a fronteira fechada ainda tem vantagem clara.
O que mudou em relação ao V2.5 Pro:
O V2.5 Pro tinha 19.0 no DeepSWE. O V2.6 Pro tem 71.9. Um salto de 52.9 pontos em um ano. O AutomationBench foi de 16.0 para 53.1. O Terminal Bench 2.1 foi de 65.2 para 89.9. O CyberGym foi de 40.0 para 94.0.
O Flash merece menção especial: com 15B parâmetros ativos, fica a 4 pontos do Pro no DeepSWE (67.9 vs 71.9) e empata ou supera em CyberGym (95.1 vs 94.0). Para workloads de alto volume, é o sweet spot absoluto.
Precificação: a navalha chinesa
A Xiaomi manteve os preços da API do V2.5. Isso significa:
| Modelo | Input (cache miss) | Input (cache hit) | Output |
|---|---|---|---|
| V2.6 Pro | $0.435/M | $0.0036/M | $0.87/M |
| V2.6 Flash | $0.14/M | $0.0028/M | $0.28/M |
| V2.6 Pro UltraSpeed | $4.35/M | $0.036/M | $8.70/M |
O Artificial Analysis mede o Pro a $0.13 por tarefa no Intelligence Index e 134 tokens/segundo de output. O Flash é o segundo modelo de fronteira mais barato do mundo via API.
O plano de assinatura (Token Plan) cobre Pro, Flash e toda a linha V2.5, com descontos significativos para uso alto. O MiMo Desktop foi lançado junto, com acesso aos modelos V2.6 e suporte a API key própria.
Open source de verdade
Pesos no Hugging Face. Licença MIT. Sem restrições comerciais.
- MiMo V2.6 Pro RL: XiaomiMiMo/MiMo-V2.6-Pro-RL
- MiMo V2.6 Flash RL: XiaomiMiMo/MiMo-V2.6-Flash-RL
- MiMo V2.6 Distill Qwen 9B: XiaomiMiMo/MiMo-V2.6-Distill-Qwen-9B
- Technical report + RL code + 7k+ task environments: no repo oficial
Os 7.000+ ambientes de tarefa RL cobrem software engineering, reprodução de vulnerabilidades, trabalho intensivo em conhecimento, e web design & development. O modelo Distill-Qwen-9B melhora em todos os 11 benchmarks saindo do SFT baseline com RL.
A letra miúda: servir o Pro você mesmo requer cluster multi-GPU. A recomendação oficial é SGLang com tensor parallel 16 + data parallel 2, ou vLLM com tp 8. O Flash é mais acessível mas ainda pede ~173 GB só para os pesos, antes do KV cache para 1M tokens.
Casos de uso: do código ao laboratório
Vibe World → 3D Open-World Games: De imagens, vídeo ou texto, o V2.6 quebra a tarefa em subtasks, coordena múltiplos agentes para construir cenas 3D, lógica de interação e verificação visual , refinando até o mundo ficar jogável.
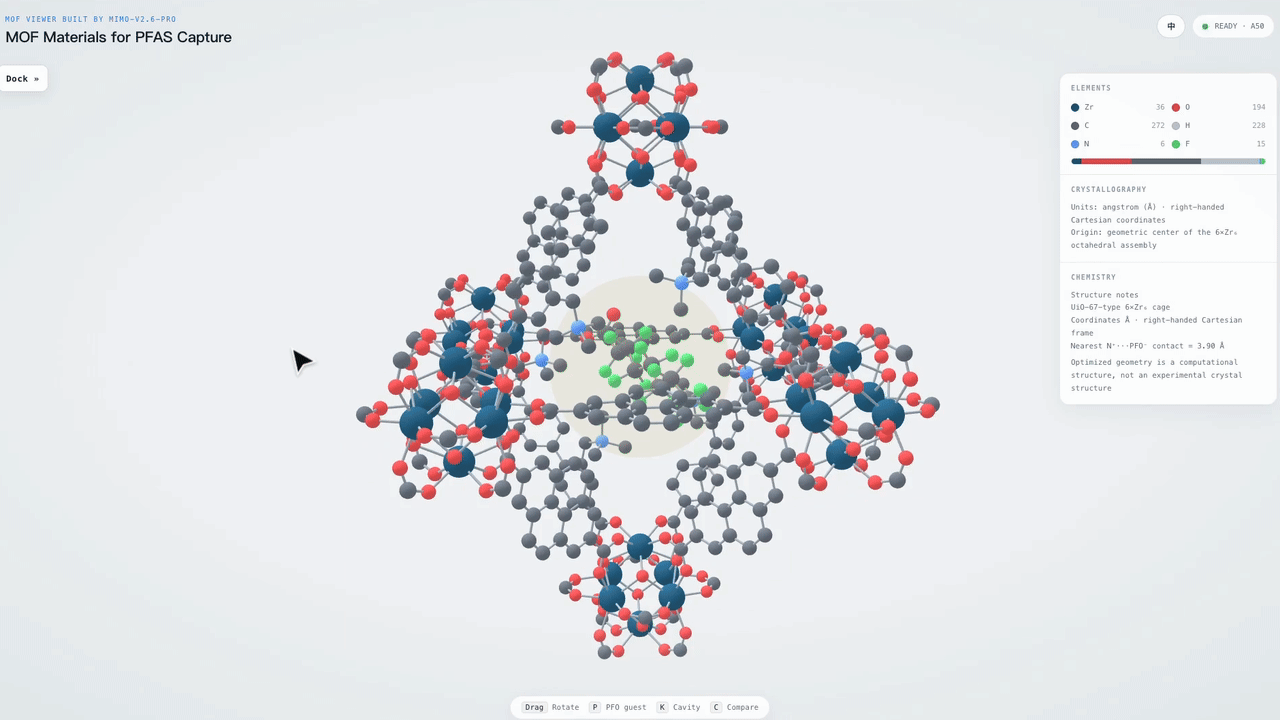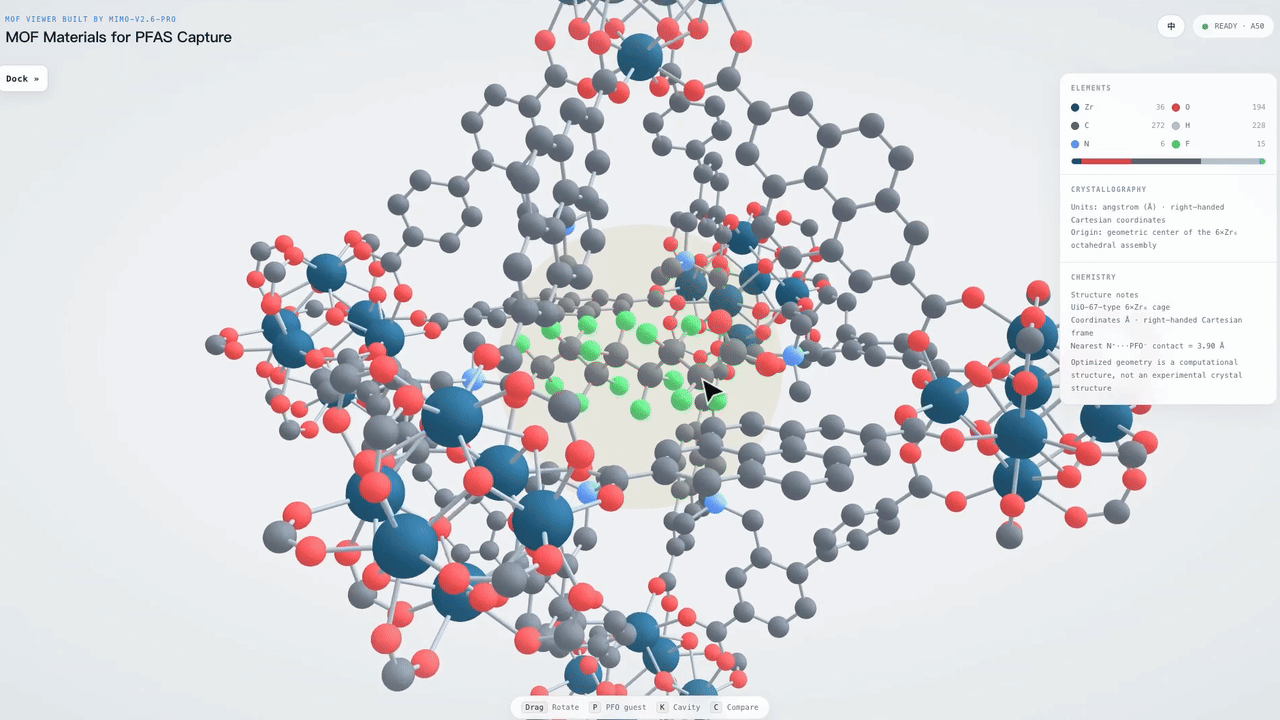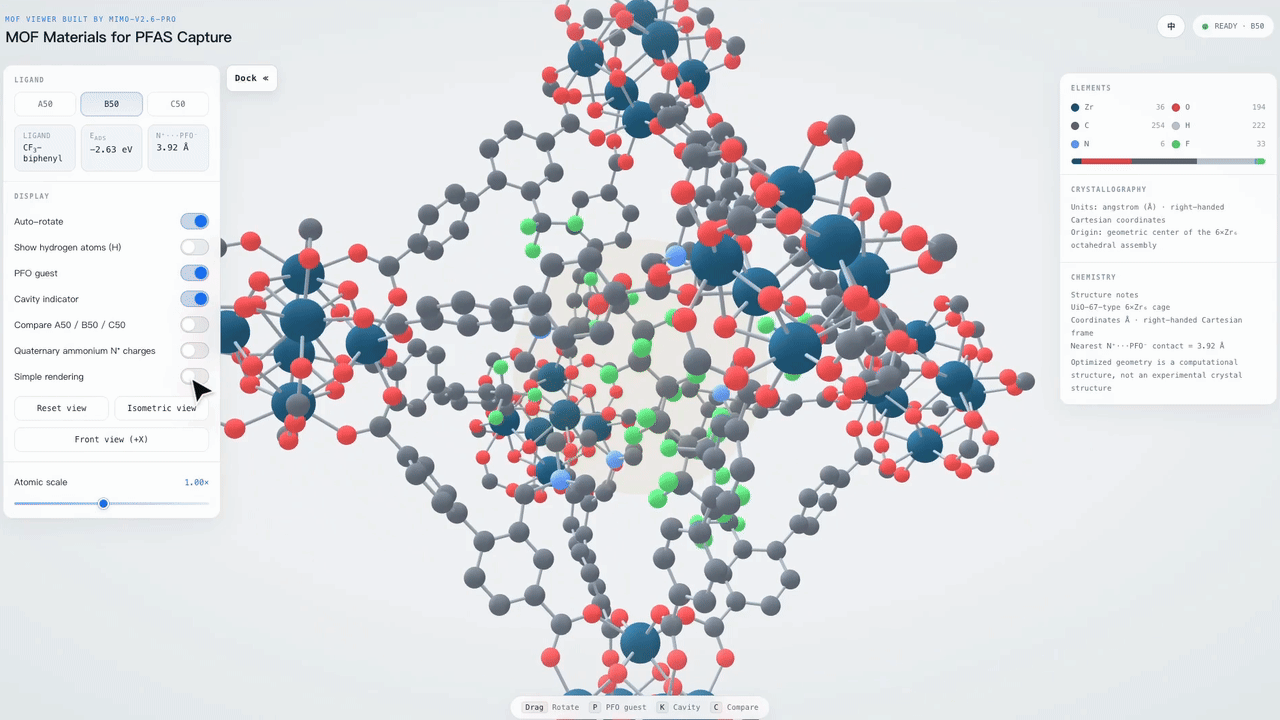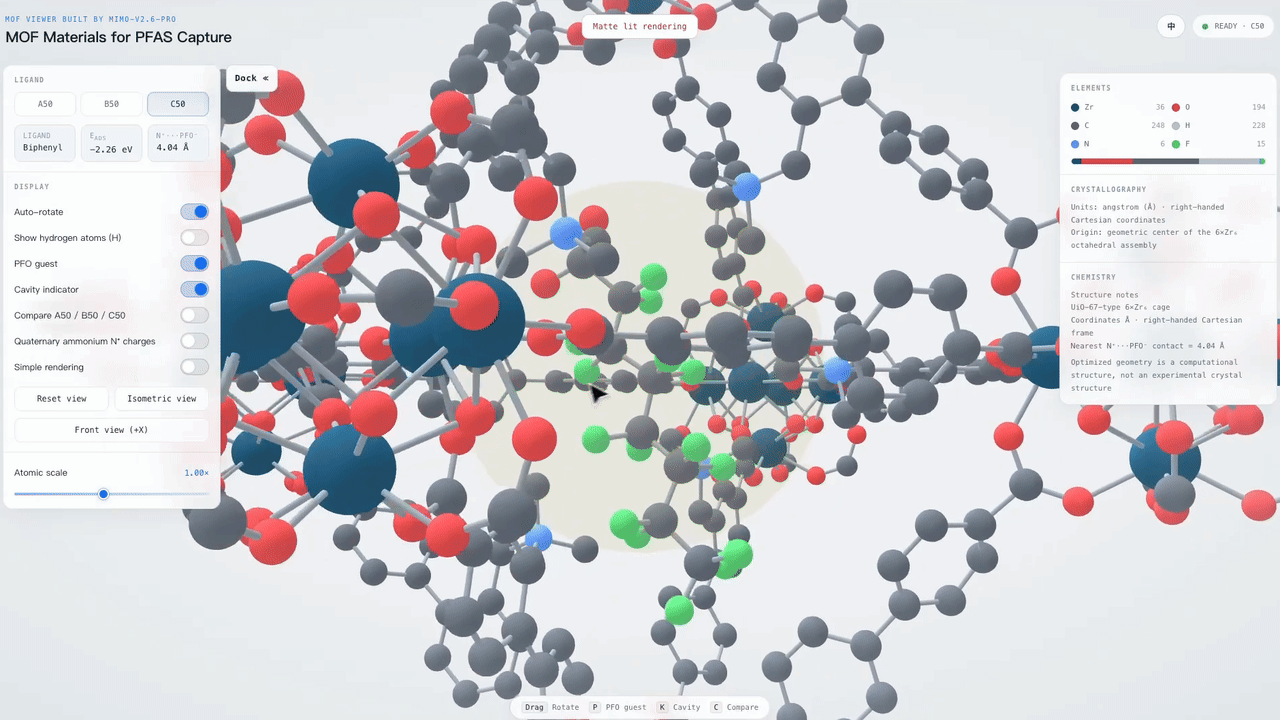
Co-Cientista para Pesquisa de Materiais: O V2.6 Pro ajudou pesquisadores da Xiaomi a projetar estruturas MOF para capturar poluentes PFAS , revisando literatura, formulando hipóteses, simulando binding strength e selecionando os melhores candidatos.
Criação de Conteúdo: Produziu curtas-metragens, showcases de marca e vídeos educacionais de matemática, transformando conceitos como decomposição de Fourier e convex hulls em animações intuitivas.
Trading Quantitativo (UltraSpeed): Quando uma notícia explode, o modelo analisa impacto de mercado e gera sinais em milissegundos , fechando o loop de decisão antes do mercado se mover.
Controle de Risco em Tempo Real (UltraSpeed): Raciocínio completo de fraude em centenas de milissegundos, antes da liquidação. Quebra limites de rule engines tradicionais.
O que isso significa
-
A liderança open-weight agora é totalmente chinesa. Xiaomi, Z.AI (GLM-5.3), Moonshot (Kimi K3), DeepSeek, Alibaba, MiniMax. O share de tokens processados por modelos americanos em plataformas neutras de roteamento caiu de ~70% para ~30% no último ano. MiMo está entre os 10 providers mais usados por volume.
-
Licença MIT em um modelo de 1 trilhão de parâmetros é inédito. Dá para self-host, fine-tune, e shipping comercial sem restrições. É um presente envenenado para quem está tentando vender APIs proprietárias.
-
Transparência radical no treinamento. Seis dias de RL ao vivo, custos discriminados, benchmarks com derrotas admitidas. Nenhum laboratório ocidental chegou perto desse nível de abertura num modelo dessa escala.
-
A Xiaomi não é mais "a fabricante de celular que também faz IA". O time liderado por Luo Fuli entregou em um ano o que levou meia década para laboratórios dedicados. E fizeram isso com um dos budgets de treinamento mais eficientes já documentados: $3.47M totais pelos dois modelos.
-
O UltraSpeed antecipa o futuro. Inferência 20× mais rápida com qualidade idêntica resolve o problema de latência que trava adoção em trading, segurança e coding assistants. É o tipo de feature que modelos fechados cobram premium , aqui é uma opção no mesmo cardápio.
APIs: mimo-v2.6-pro, mimo-v2.6-flash, mimo-v2.6-pro-ultraspeed em api.xiaomimimo.com , compatível com OpenAI e Anthropic protocols.
Hugging Face: huggingface.co/collections/XiaomiMiMo/mimo-v26
MiMo Desktop: disponível para download com suporte a UltraSpeed e API key própria.
Precificação em USD por milhão de tokens. Benchmarks conforme publicado pela Xiaomi e Artificial Analysis em 22/09/2026. Scores do DeepSWE são self-reported (avaliação própria da Xiaomi usando mini-swe-agent no benchmark público); não constam no leaderboard oficial do Datacurve até o fechamento deste post.
Quer ajuda para colocar isso em pratica?
A Baita Site trabalha com sites, e-commerce, sistemas e IA. Quem prefere resolver com acompanhamento, sem ter que virar especialista em tudo, costuma procurar esse tipo de suporte.
Veja tambem
Perguntas Frequentes (FAQ)
1. O que é o Xiaomi MiMo V2.6?
É a nova série de modelos de linguagem da Xiaomi, composta por MiMo V2.6 Pro (1.02 trilhão de parâmetros), Flash (309 bilhões), e Pro UltraSpeed (versão rápida do Pro). Todos são nativamente multimodais (texto, imagem, vídeo, áudio), têm janela de contexto de 1 milhão de tokens, e são open-source sob licença MIT.
2. Quanto custa usar o MiMo V2.6?
A precificação da API manteve os preços da geração anterior. O Pro custa $0.435 por milhão de tokens de input (sem cache) e $0.87 por milhão de tokens de output. O Flash sai por $0.14/$0.28. O UltraSpeed custa $4.35/$8.70. Planos de assinatura com desconto também estão disponíveis.
3. O MiMo V2.6 é melhor que o DeepSeek?
Sim, nos benchmarks independentes. O MiMo V2.6 Pro marcou 46 pontos no Artificial Analysis Intelligence Index, contra 39 do DeepSeek V4.1 Flash e 36 do DeepSeek V4.1 Pro. No DeepSWE v1.1 (engenharia de software), o Pro fez 71.9 contra o V2.5 Pro que fazia apenas 19.0 , um salto de 52.9 pontos.
4. Posso rodar o MiMo V2.6 no meu computador?
Depende. O modelo completo (Pro) exige cluster multi-GPU , a recomendação oficial é SGLang com tensor parallel 16. O Flash é mais acessível mas ainda pede ~173 GB só para os pesos, antes do KV cache. Para uso local, a Xiaomi lançou o MiMo V2.6 Distill Qwen 9B, um modelo de 9 bilhões de parâmetros. A API também está disponível via OpenAI/Anthropic protocols.
5. O que é o UltraSpeed?
É um modo de inferência acelerada do MiMo V2.6 Pro que gera output até 20x mais rápido, com a mesma qualidade. É voltado para cenários de latência crítica como trading quantitativo em tempo real, detecção de fraude em milissegundos, e coding assistants sem latência percebida.