
Meta voltou à fronteira da IA. Depois de 14 meses reestruturando o Meta Superintelligence Labs, a empresa de Mark Zuckerberg anunciou nesta segunda-feira (12 de outubro de 2026) os modelos Muse Wonder e Muse Wonder Full, a primeira família de IA verdadeiramente frontier da companhia desde a reorganização comandada por Alexandr Wang.
Em testes internos, o Muse Wonder Full empata com Claude Opus 5.5 da Anthropic e supera GPT-6 Astra da OpenAI em tarefas de longo horizonte em software, ocupa a vice-liderança no Artificial Analysis Intelligence Index e detém o melhor MemoryBench da categoria. Preço de API igual ao Opus: US$ 4 por milhão de tokens de entrada e US$ 20 por milhão de saída.
A Meta também abriu a API para desenvolvedores, separou uma versão mais forte para assinantes do Muse Code (seu IDE agêntico) e promete colocar o Wonder como cérebro do agente pessoal Muse nas próximas semanas, começando pelos assinantes. As ações da Meta subiram cerca de 4,13% no intraday desta segunda, saltando para US$ 748,34.
A corrida que voltou para valer
Há pouco mais de um ano, a Meta virou piada no Vale do Silício. O Llama 4 decepcionou, Zuckerberg pagou salários obscenos para pescar talentos da OpenAI e Anthropic, comprou a Scale AI por cifras bilionárias, e muita gente ainda perguntava se a empresa de Facebook, Instagram e WhatsApp tinha capacidade real de competir de igual com quem lidera o segmento.
Hoje, com Wonder, essa conversa acabou. Em entrevista à Reuters, Wang afirmou que o objetivo era fazer o caso de uso de agente pessoal cantar, e o blog técnico da Meta resume a estratégia em uma frase: Active Memory + Active Focus = personal superintelligence. Traduzindo: o modelo lembra do que importa sobre você entre conversas e insiste na tarefa até terminar, mesmo que tenha que mudar de abordagem no meio do caminho.
O que vem no pacote Muse Wonder
A Meta lançou dois modelos, não um. A divisão existe por motivo: cada um tem um canal de distribuição diferente e uma faixa de preço distinta.
- Muse Wonder (API pública): exposto pela Meta Model API e dentro do IDE Muse Code, nos planos Everyday (US$ 5/mês), High Usage (US$ 15/mês), Power Usage (US$ 50/mês) e Maximum Usage (US$ 200/mês). Cobra US$ 4 / 1M tokens de input (US$ 0,20 cacheado) e US$ 20 / 1M tokens de output. Janela de contexto de 1.048.576 tokens. Multimodal: aceita texto, imagem, vídeo, áudio e PDF; devolve texto.
- Muse Wonder Full (assinantes): mesma janela de 1M tokens, suporte a texto/imagem/vídeo/áudio, mas só está disponível dentro do Muse Code, nas faixas Power Usage e Maximum Usage (a partir de US$ 50/mês). Não tem API pública. É a variante com max reasoning, calibrada para tarefas longas.
Segundo a Meta, ambos são modelos de raciocínio: alocam test-time compute dinamicamente e melhoram de forma previsível quando recebem mais esforço. A diferença entre as duas versões, no entanto, não é só quantidade de raciocínio, é base maior, pós-treinamento mais profundo e (segundo a empresa) capacidade superior de generalização para tarefas fora da distribuição.
Onde o Muse Wonder Full aparece no índice geral
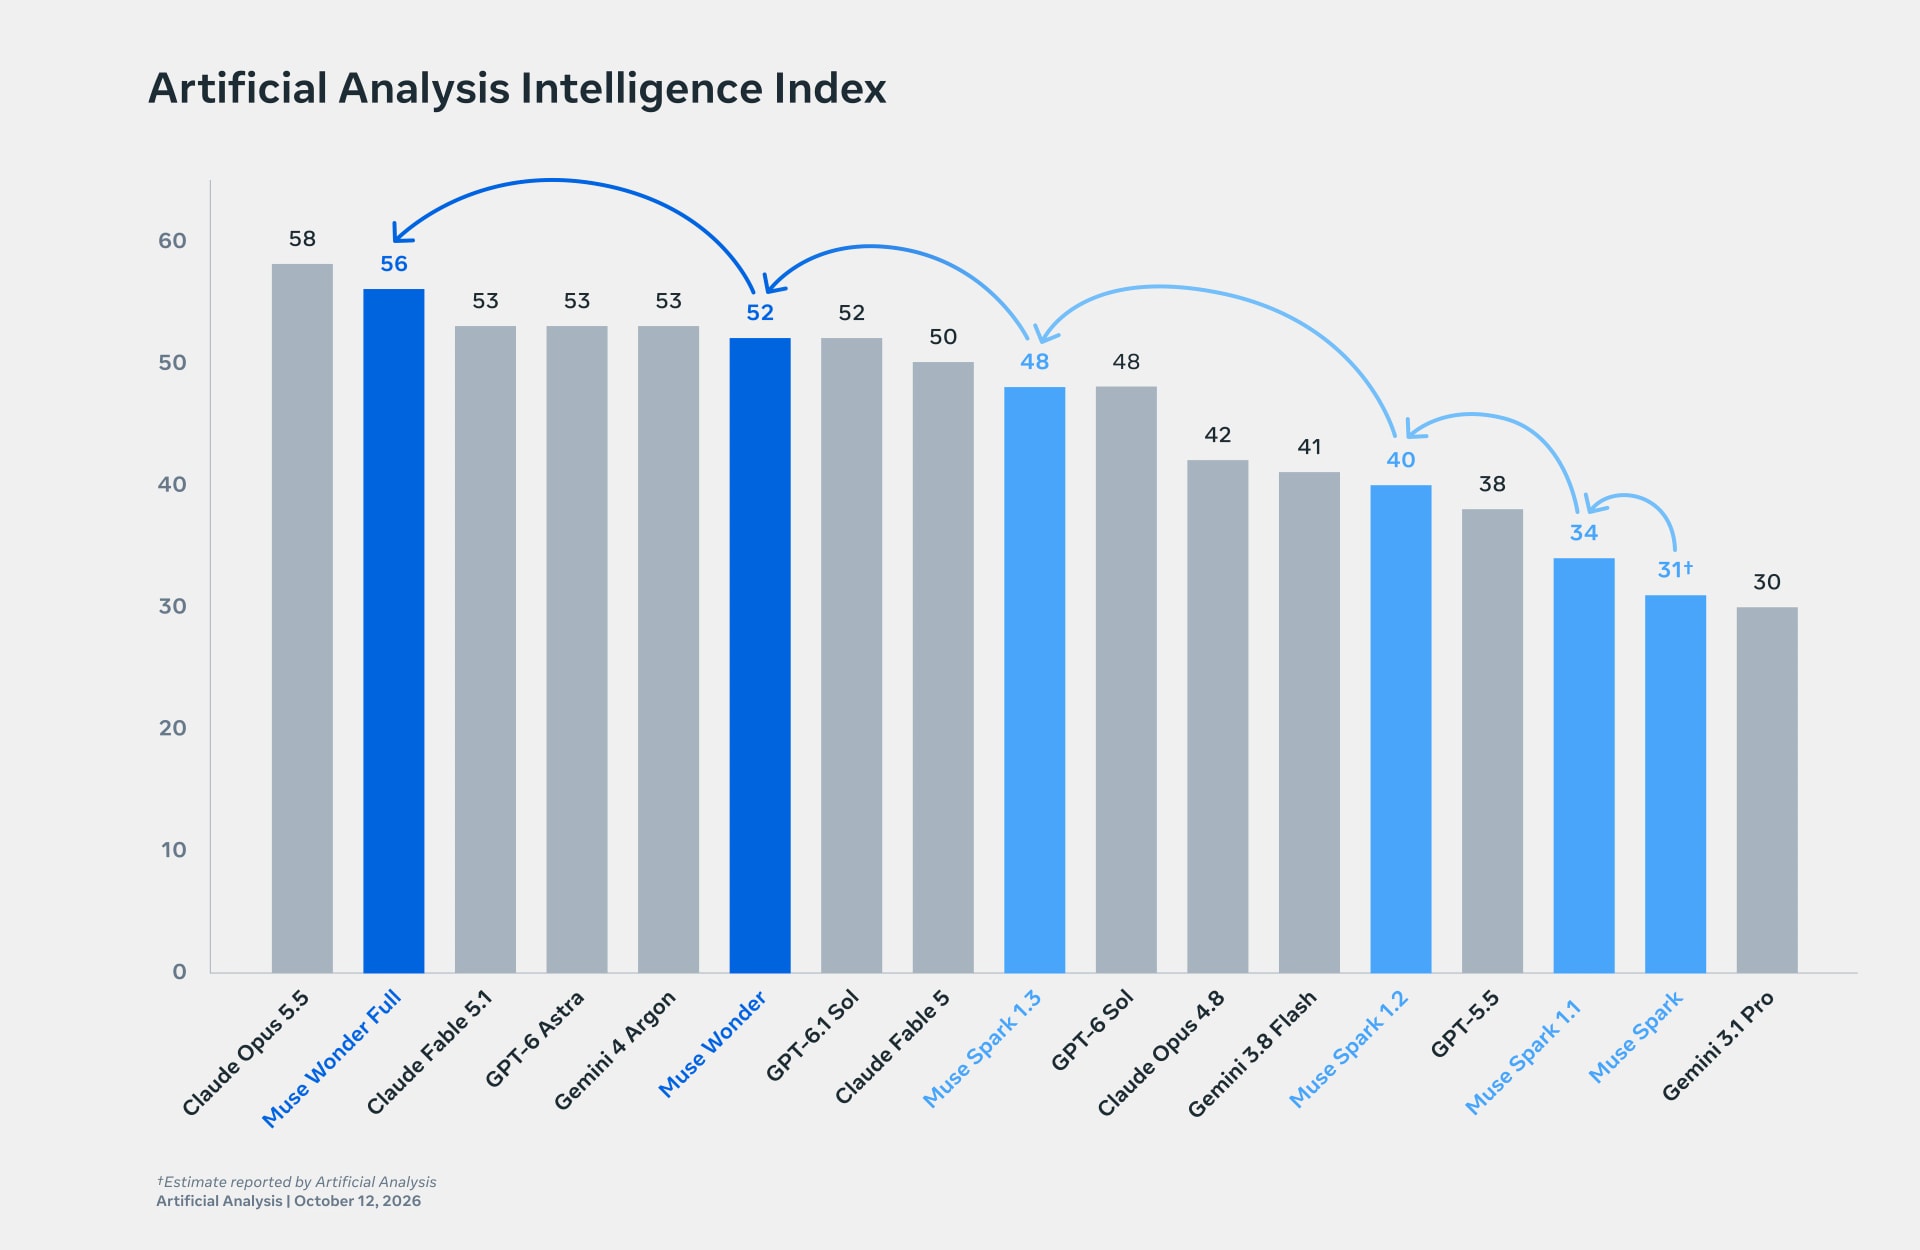
O Artificial Analysis Intelligence Index agrega mais de uma dezena de benchmarks em uma pontuação única. O Full ficou logo abaixo do Opus 5.5 da Anthropic e à frente do Claude Fable 5.1 e do GPT-6 Astra. O Muse Wonder regular subiu 7,9 pontos sobre o Muse Spark 1.3, saltando para a décima posição geral.
Os benchmarks que interessam (e onde o Wonder perde)
A Meta disponibilizou um relatório completo de avaliação. Para facilitar a leitura, segue uma síntese honesta com os números que ela própria reportou. Quando o score é do modelo da Meta sem teste independente ainda, está marcado como self-reported.
| Benchmark | Muse Wonder Full | Muse Wonder | Opus 5.5 | Fable 5.1 | GPT-6 Astra | Gemini 4 Argon |
|---|---|---|---|---|---|---|
| Artificial Analysis Intelligence Index | #2 (logo abaixo de Opus 5.5) | #10 (+7.9 vs Spark 1.3) | #1 | #3 | #4 | ainda em definição |
| Personal Superintelligence Index | Topo do segmento | Top 3 | Top 3 | Top 5 | Top 5 | — |
| AutomationBench-AA (workflows corporativos) | Líder | Top 3 | Top 3 | — | — | — |
| MemoryBench (memória contextual) | #1 acima de Fable, Opus e Astra | Top 3 | Top 4 | Top 5 | Top 5 | — |
| SWE-Marathon (engenharia sustentada) | 57.5 | 37 min/tarefa (vs 57 min Full) | 46.3 | — | 42.5 | — |
| DeepSWE 1.1 (codificação long-horizon) | 79.0 | 78.8 | — | — | — | — |
| Harvey Legal Agent Benchmark (LAB) | Líder | Top 3 | Top 3 | — | — | — |
| Vals Finance Agent V2 | Líder | Top 3 | Top 3 | — | — | — |
| FocusBench (foco sustentado) | #1 | Top 3 | Top 3 | — | — | — |
| ProgramBench (reconstrução de software) | Top 3 | — | Líder | — | — | — |
| Terminal-Bench 4 (terminal shell) | — | +38.9 pts vs Spark | Líder | — | — | — |
| Code Migration (migração entre linguagens) | — | 62.6% (#6 histórico Meta) | — | — | — | — |
Fonte: Meta Research (research.meta.ai/blog/muse-wonder), comparação independente via TechCrunch e The Verge, agregação Artificial Analysis. Benchmarks self-reported ainda sem teste independente consolidado em outubro de 2026.
A tabela oficial completa divulgada pela Meta
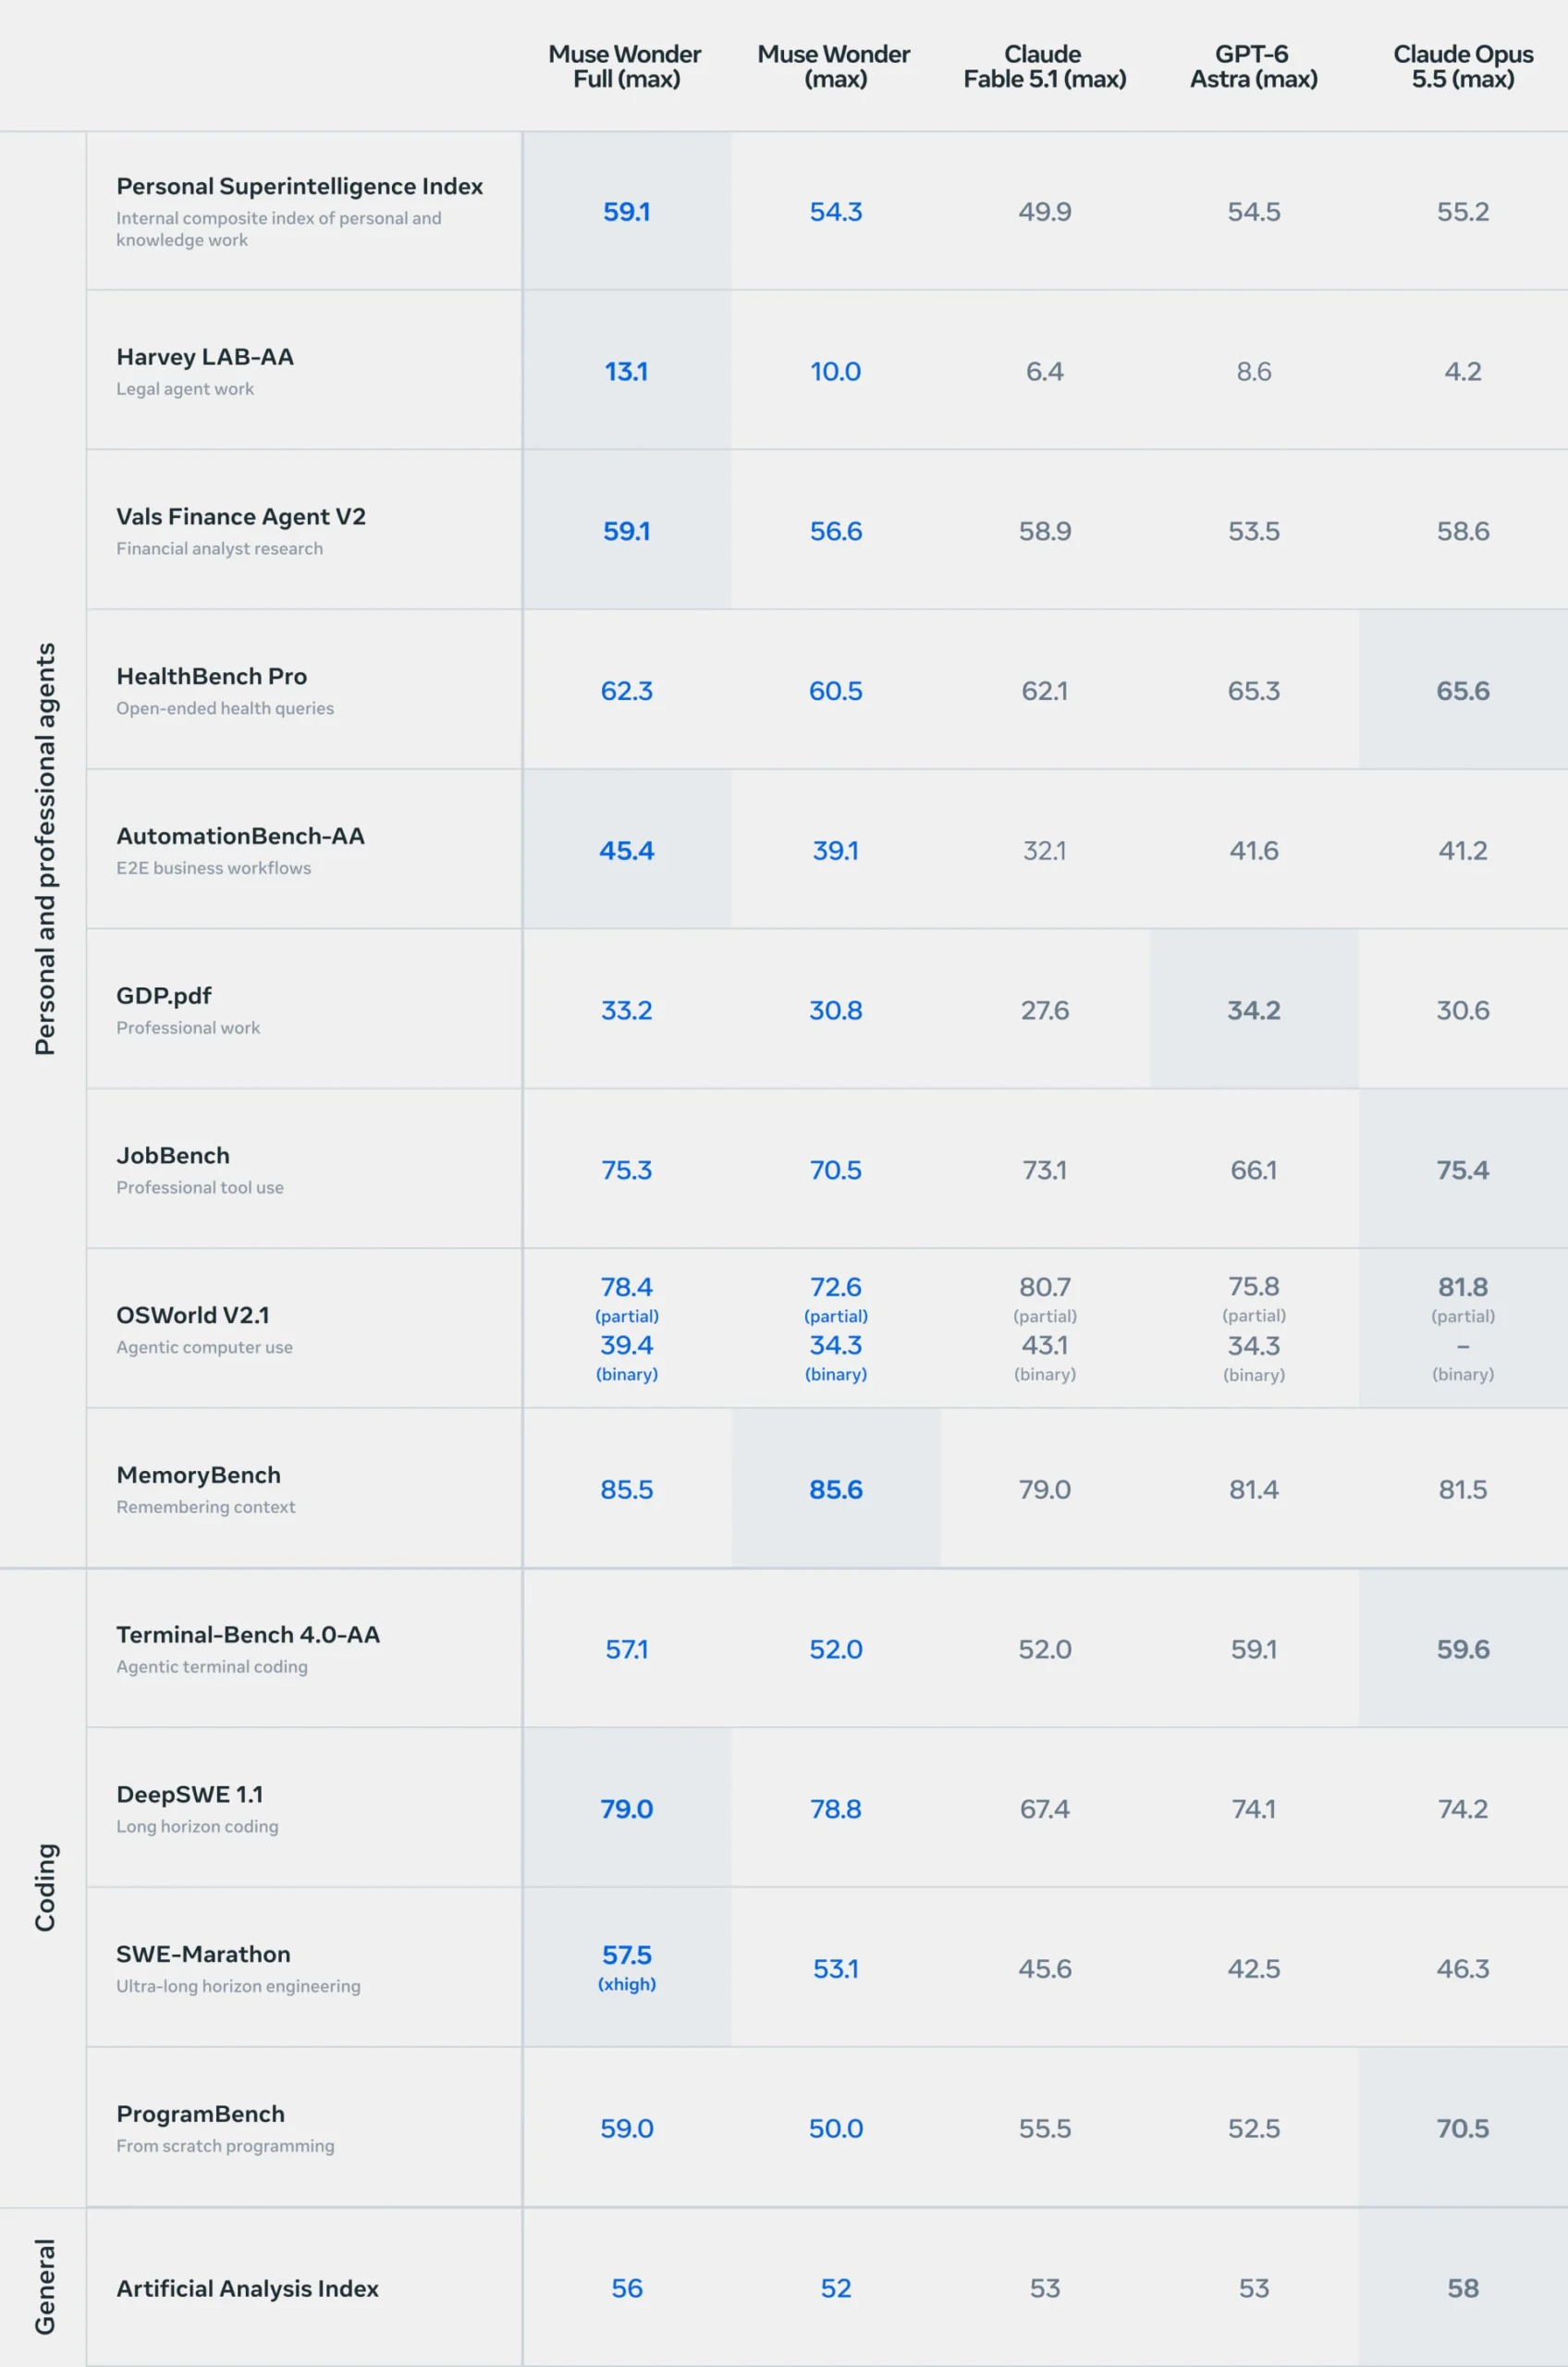
A leitura mais importante: o Full se diferencia em duas frentes claras, tarefas jurídicas (LAB) e codificação long-horizon (DeepSWE e SWE-Marathon). Nas comparações com Codex (para Astra) e Claude Code (para Fable), é importante lembrar que isso mede sistema completo, não só modelo. Em tarefas de terminal shell (ProgramBench, Terminal-Bench 4), o Opus 5.5 ainda lidera.
Personal Superintelligence Index
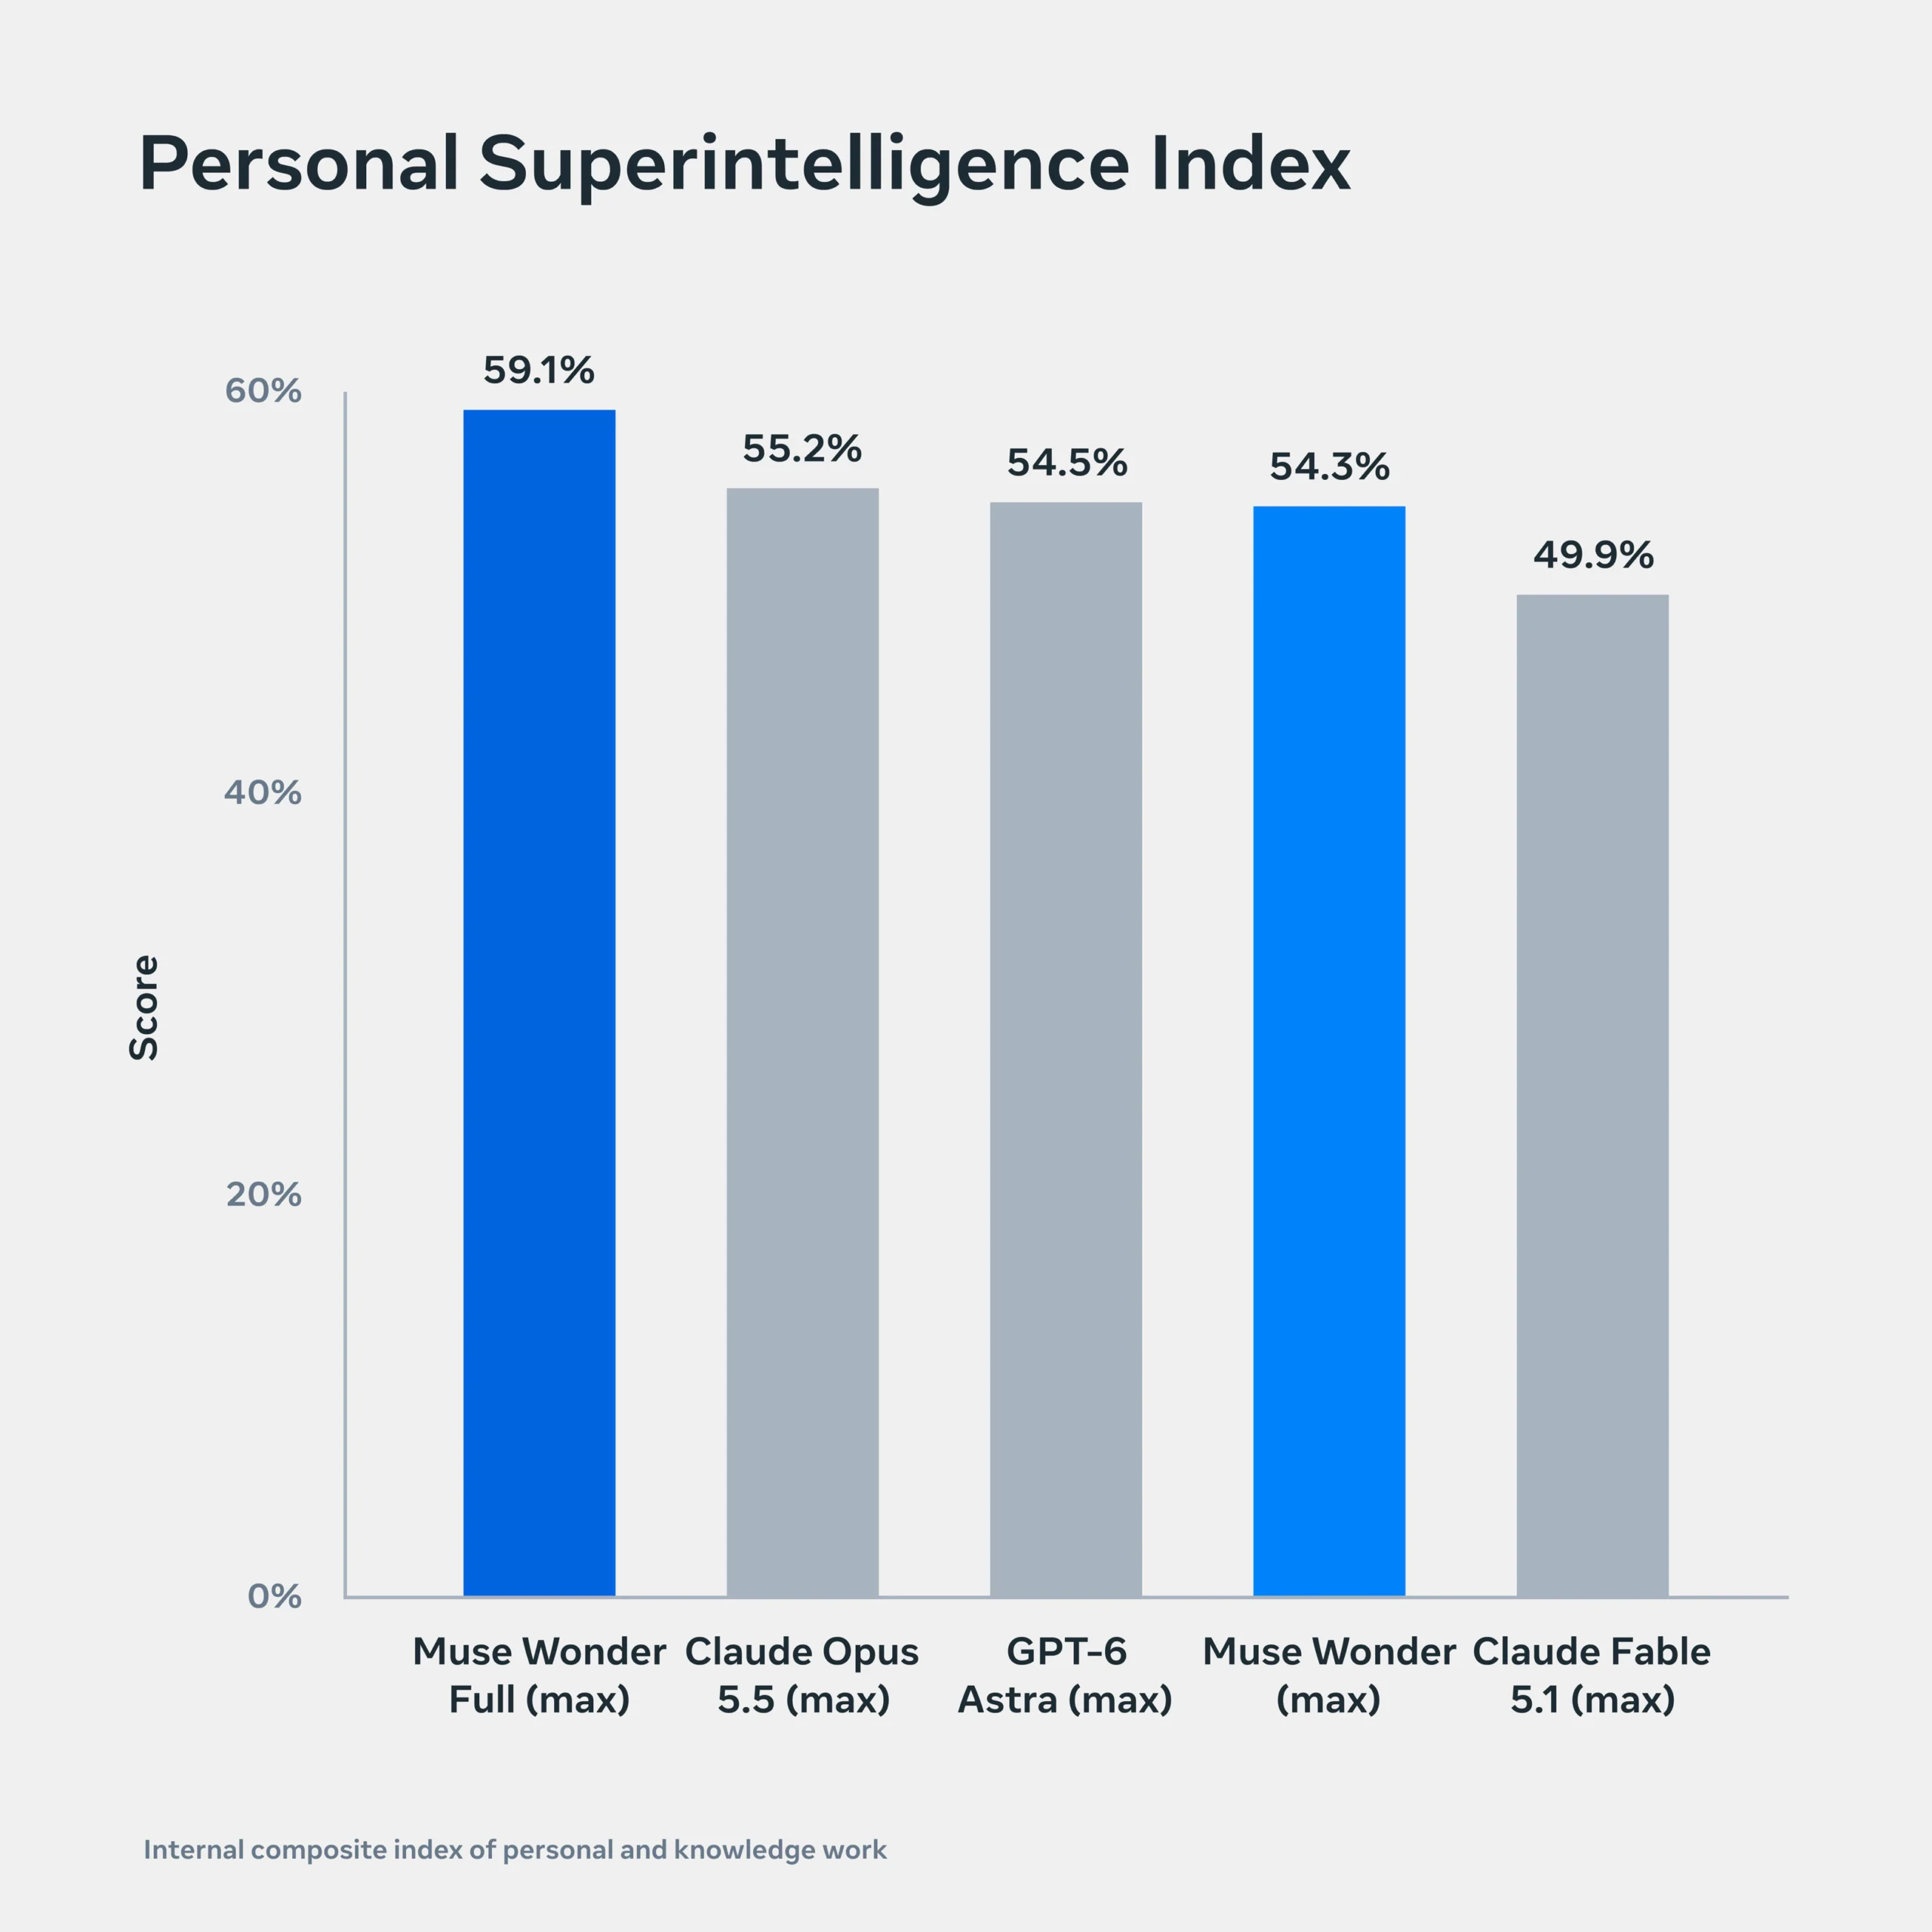
Índice composto que mede performance agregada em tarefas pessoais e de knowledge work. O Full lidera, com o Wonder regular logo atrás, antes do GPT-6 Astra.
AutomationBench-AA
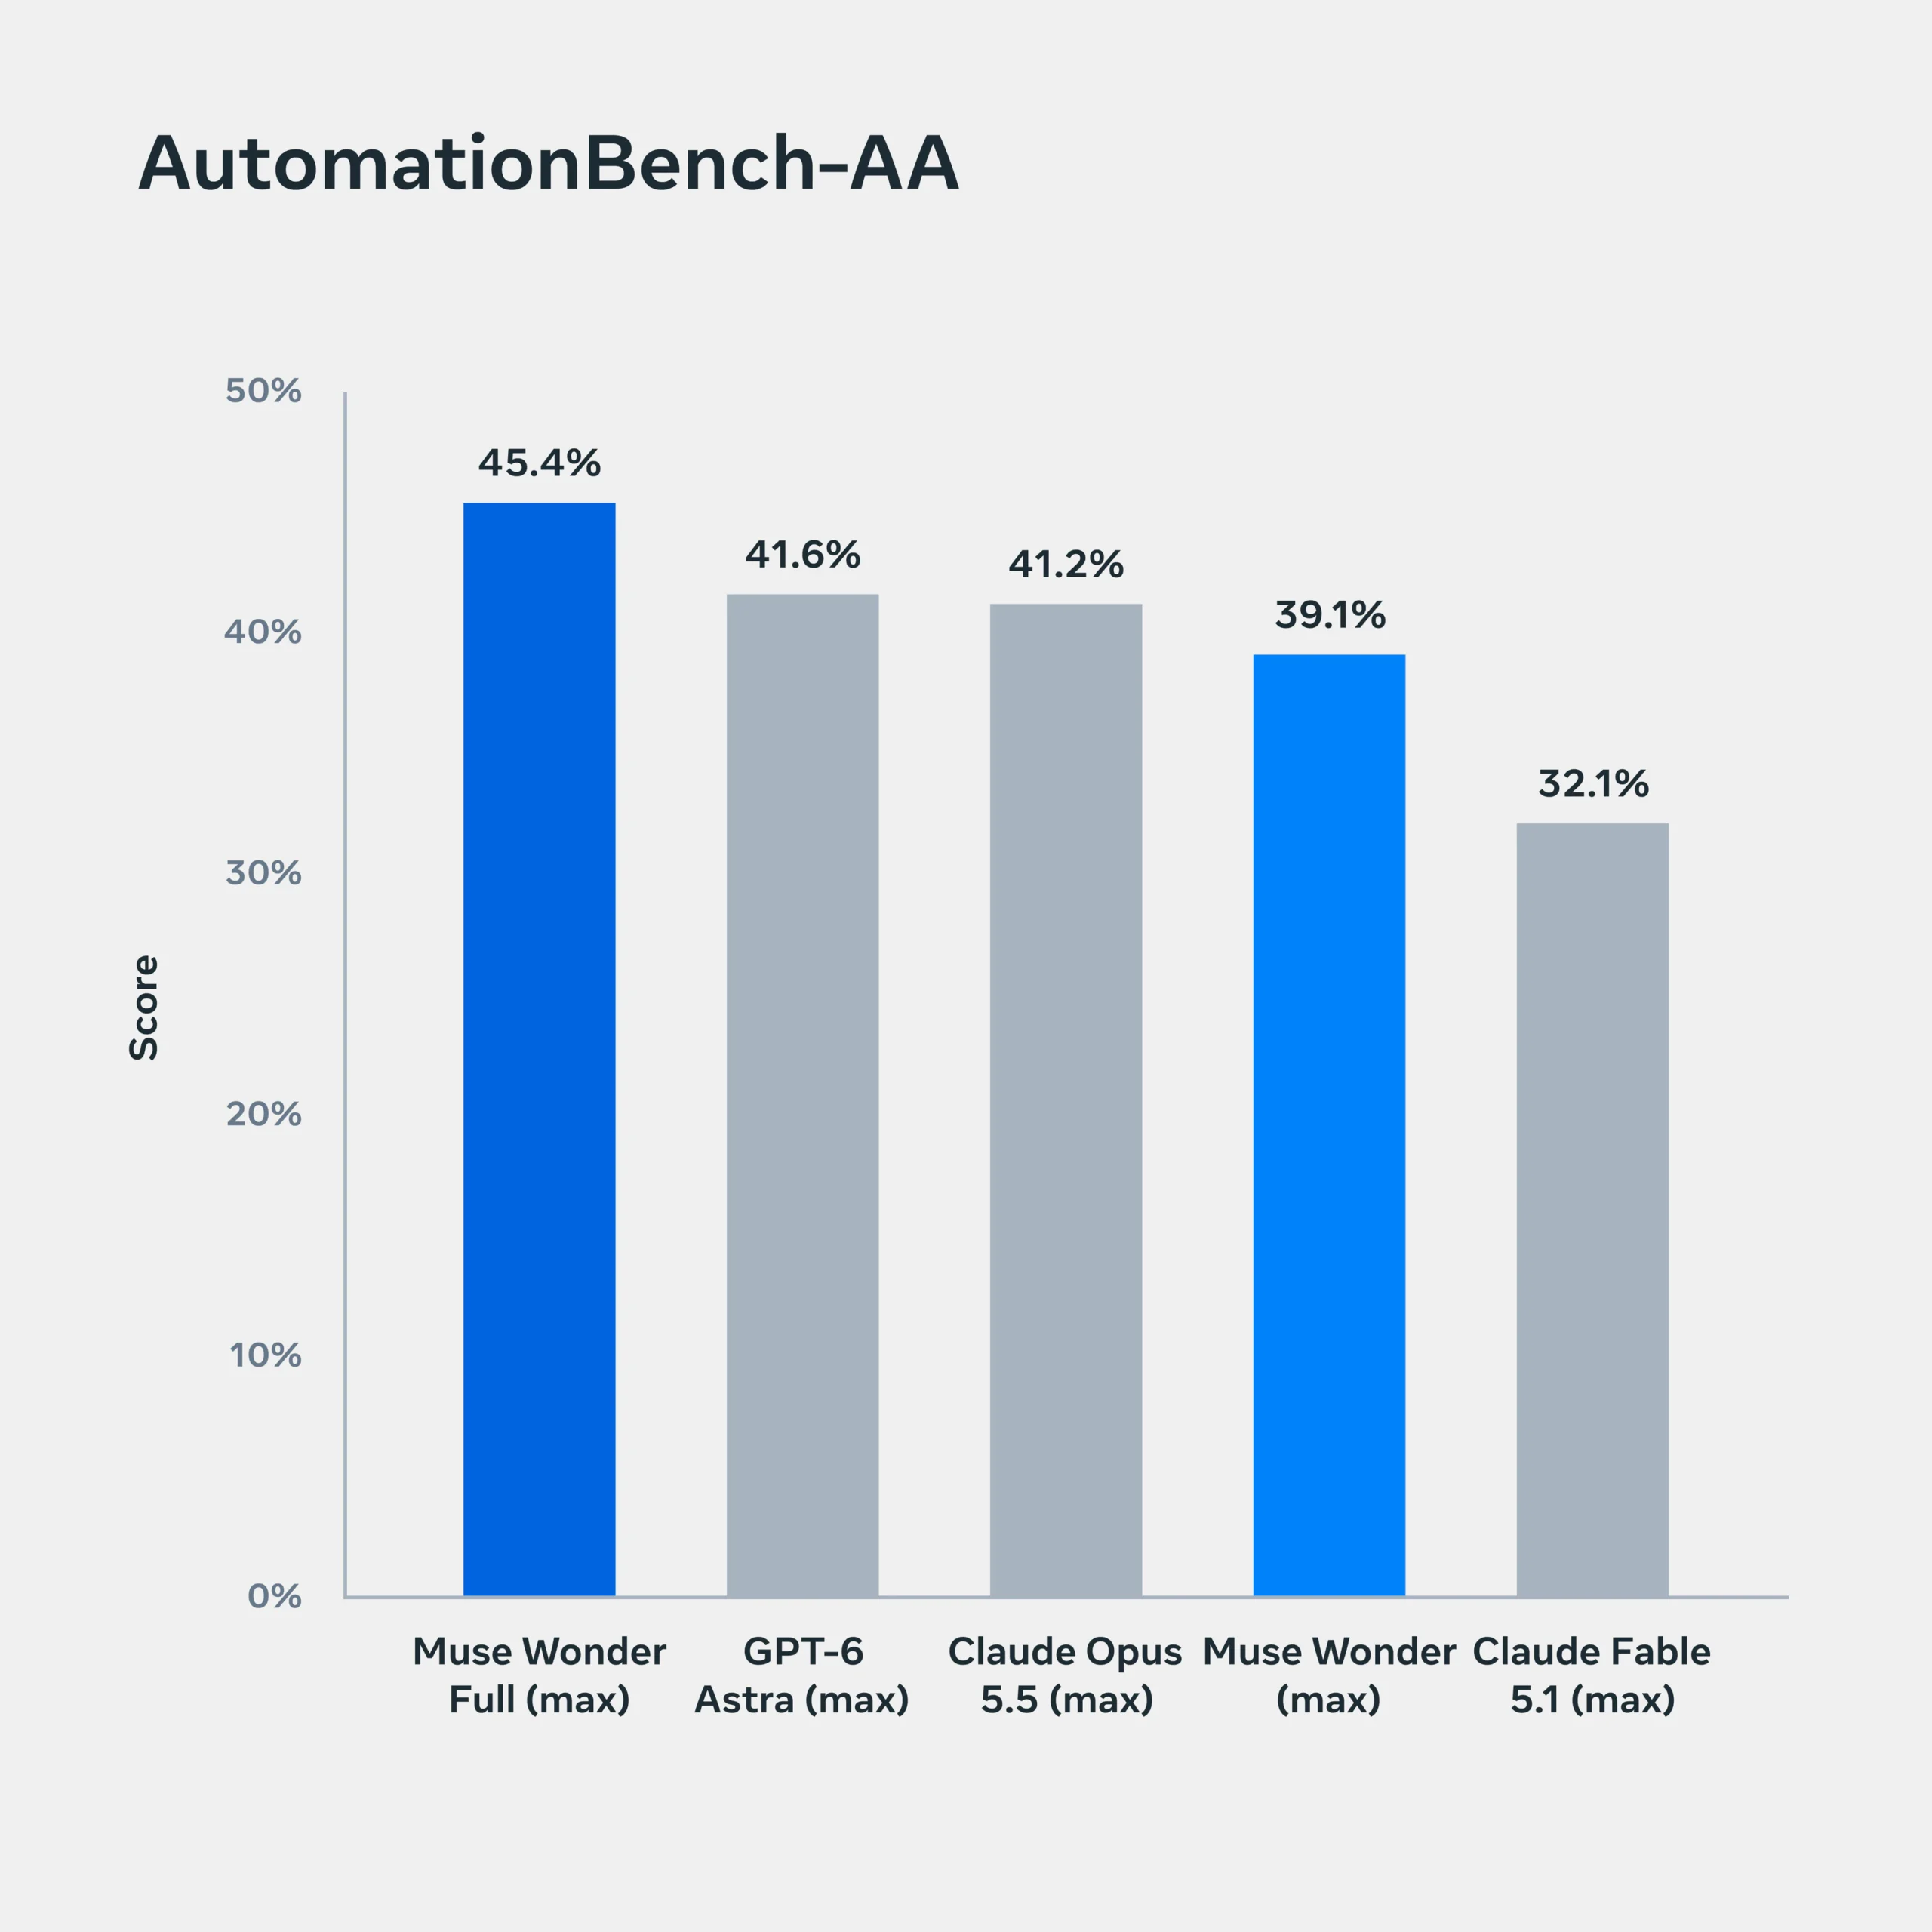
Workflow corporativo ponta a ponta: tarefas que envolvem múltiplos passos, várias ferramentas e aprovação do usuário. O Full lidera com folga.
MemoryBench, onde o Full destrói
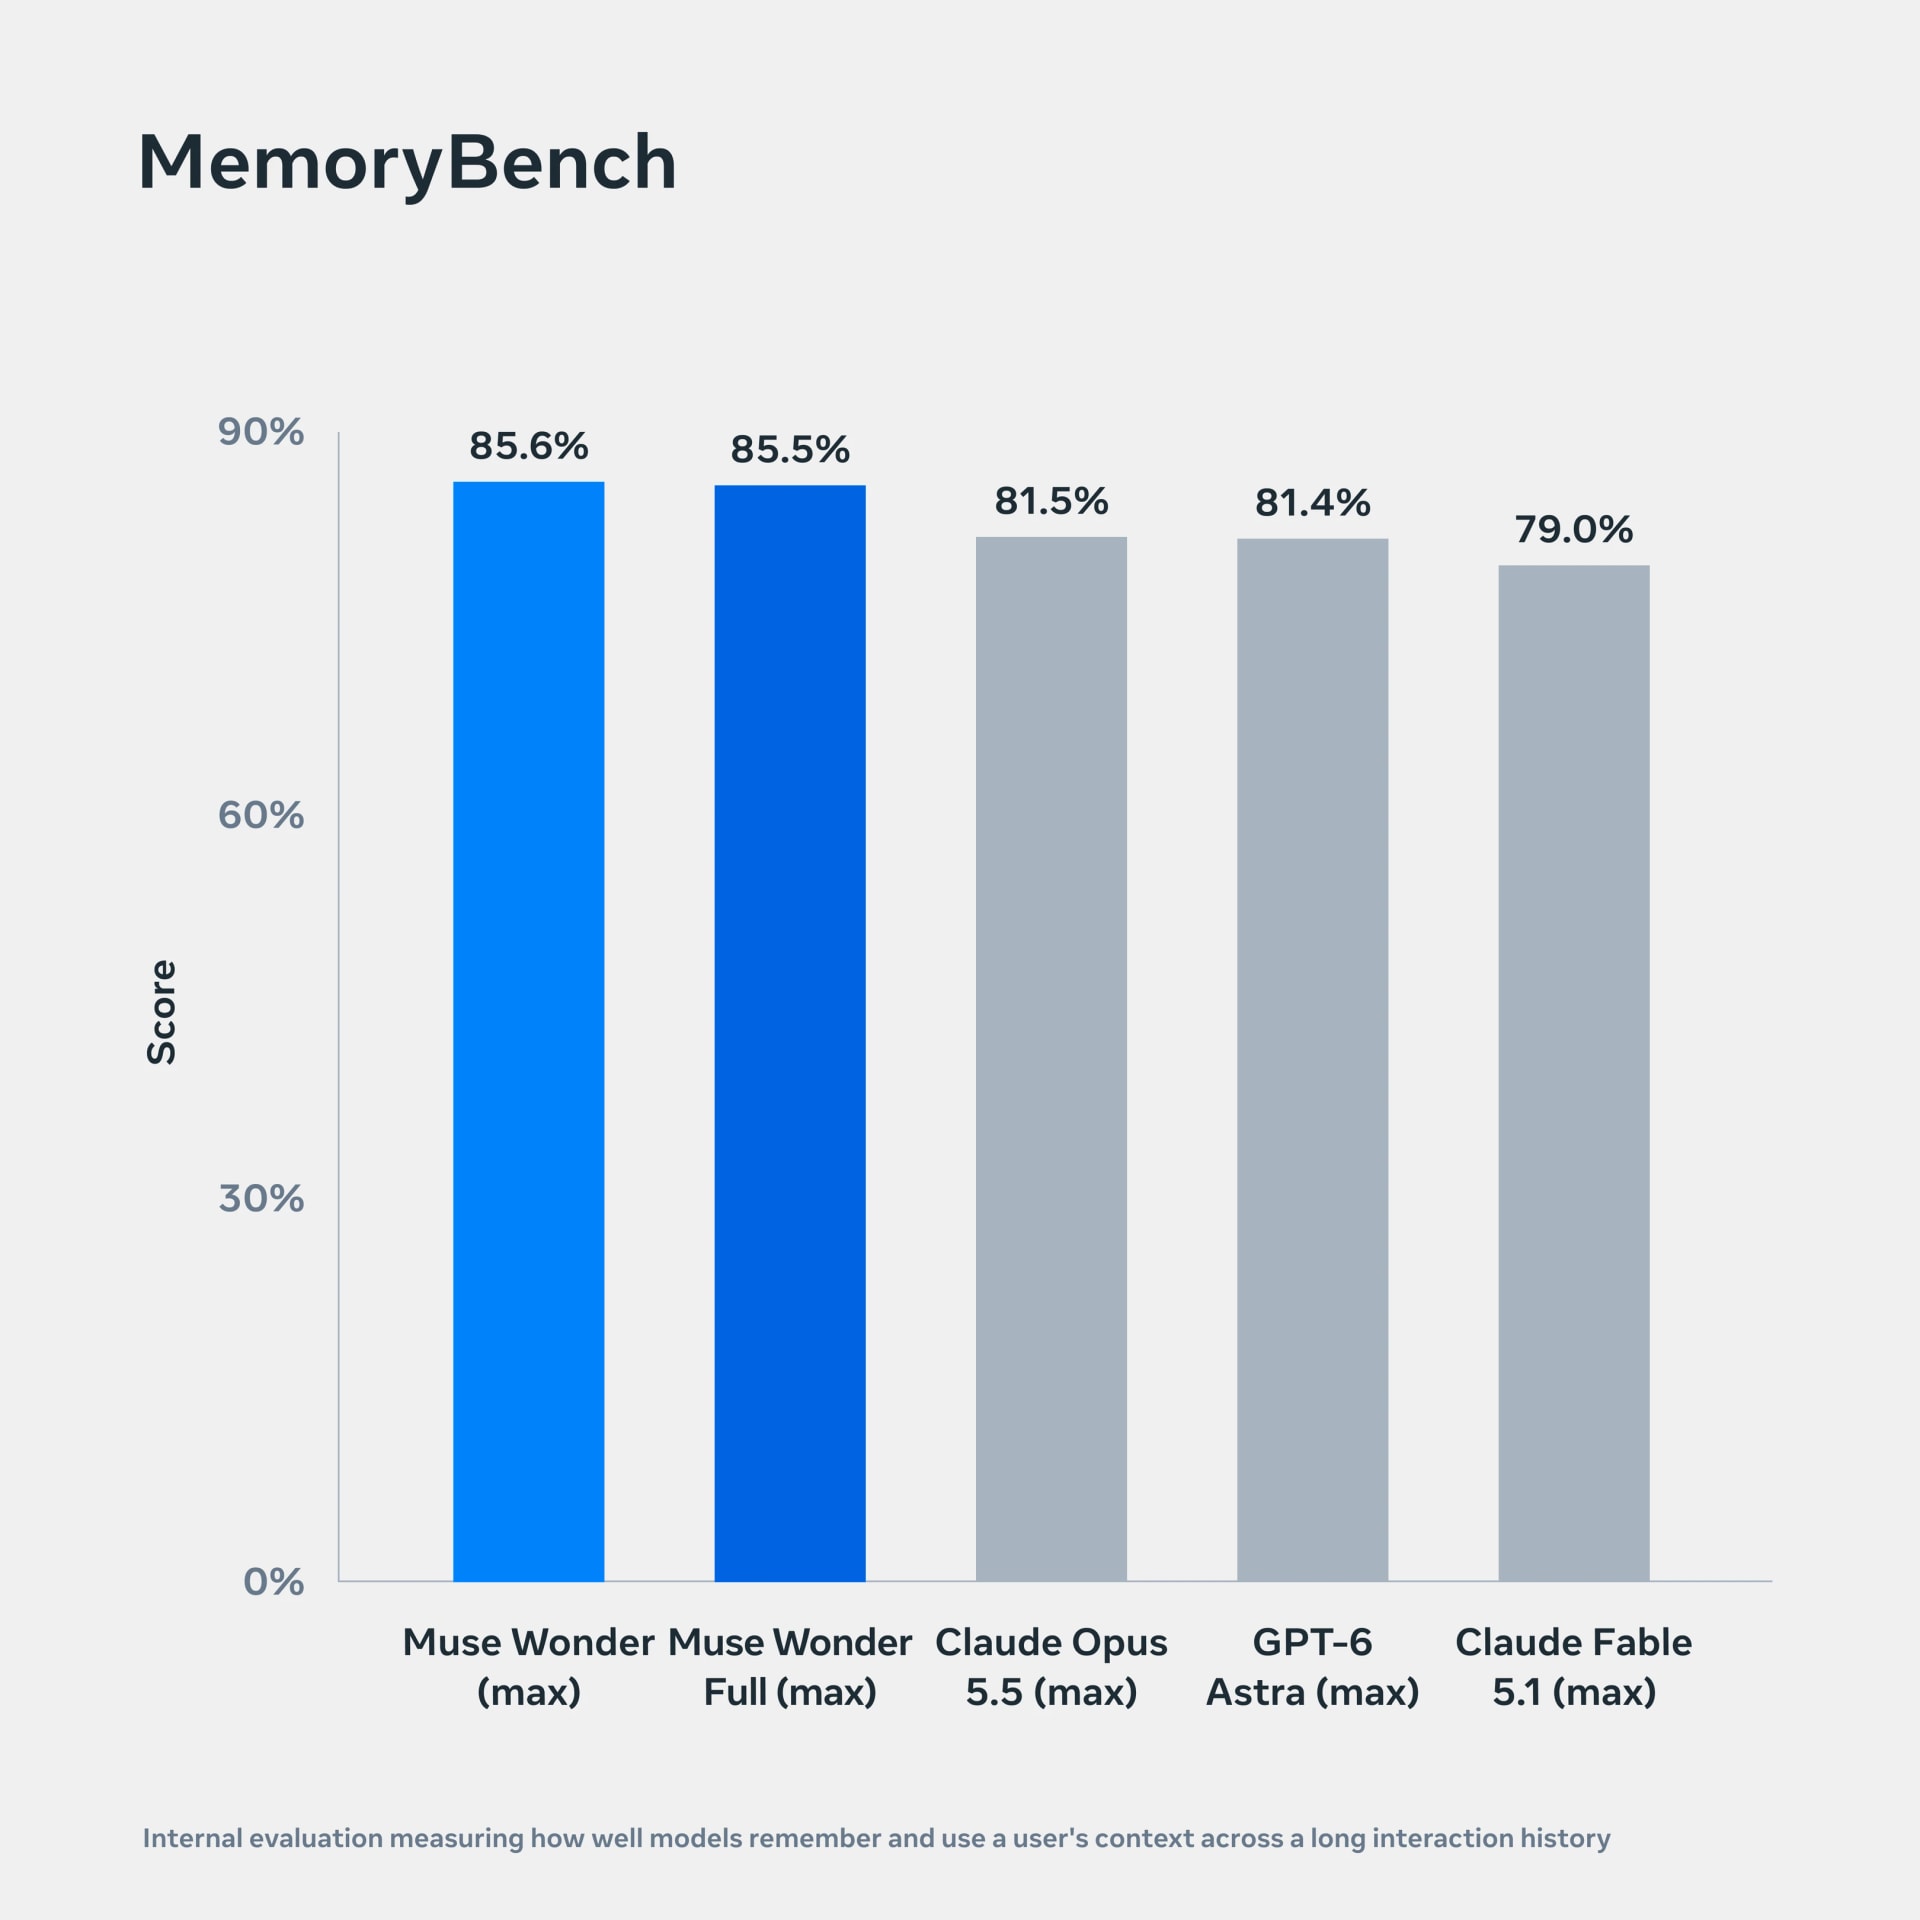
A Meta gastou cartucho pesado aqui, porque memória é exatamente o calcanhar de Aquiles dos agentes atuais. Em testes com 100K tokens de contexto sustentado, o Full passa Fable, Opus e Astra. O pesquisador Kavya Kopparapu resumiu em uma frase que viralizou: put tremendous effort into remembering what’s important to you over days, weeks, months, and beyond.
SWE-Marathon: 11 pontos acima do Opus 5.5
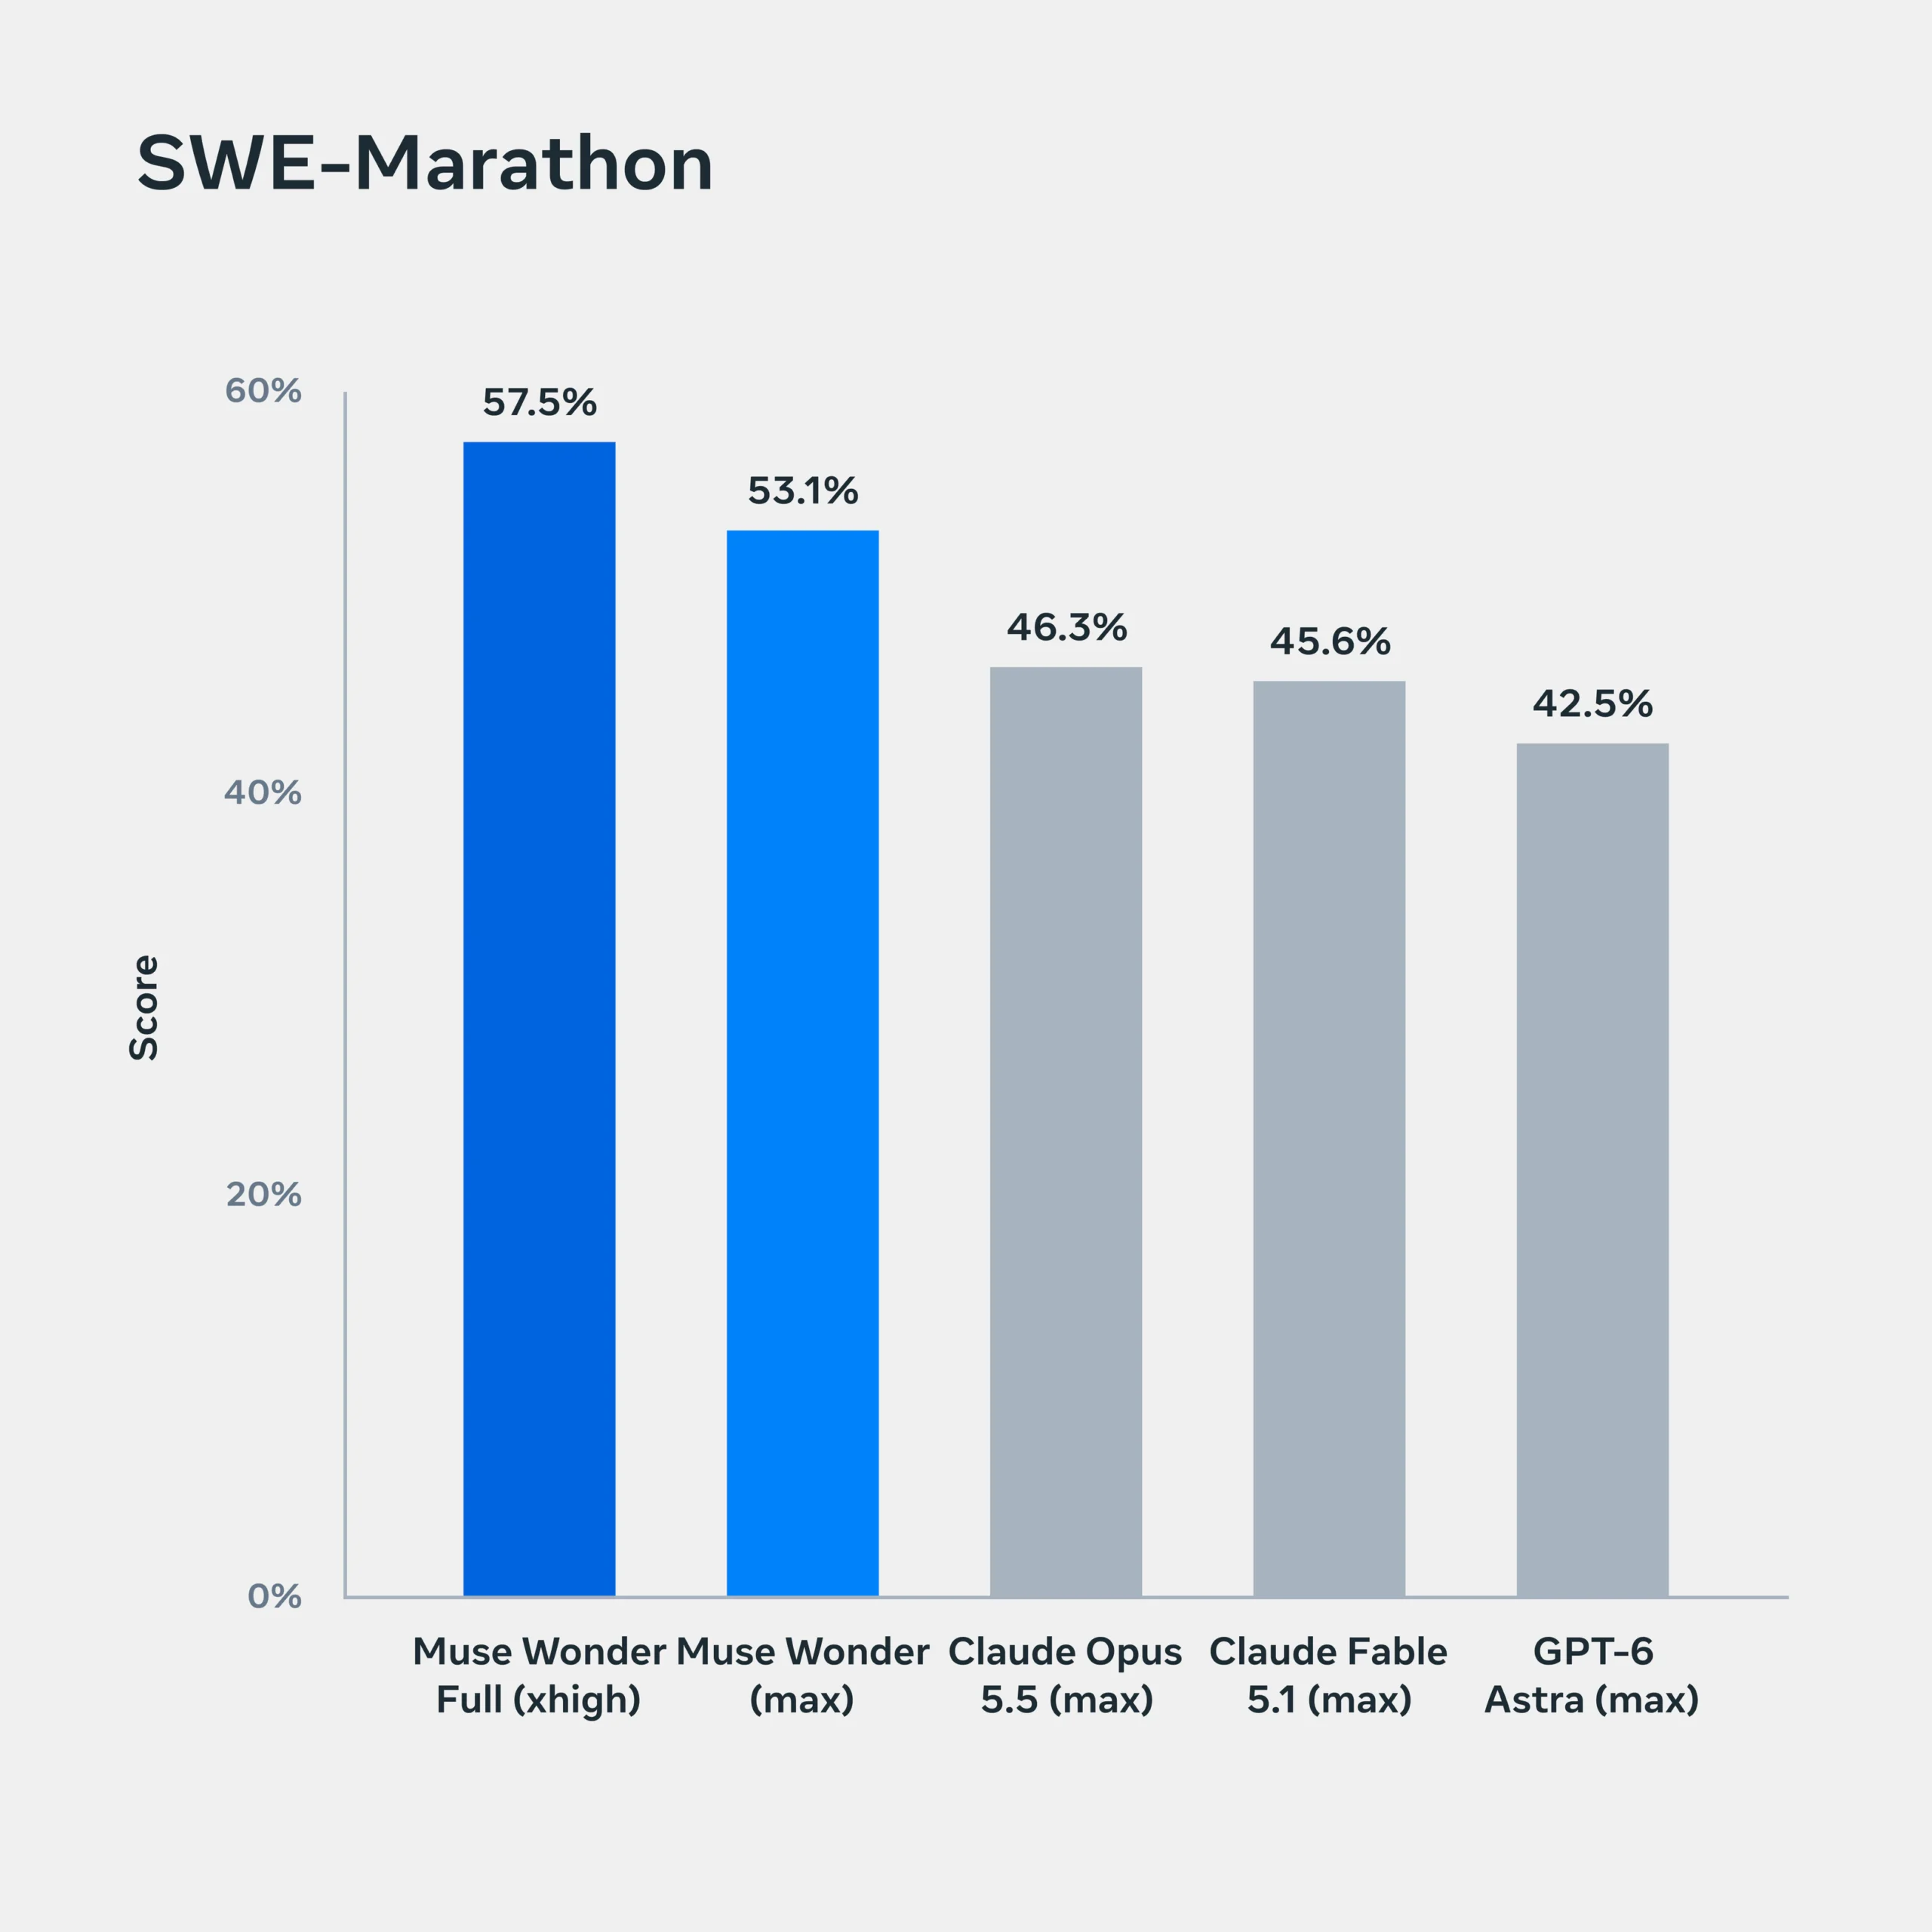
57.5 contra 46.3 do Opus 5.5 e 42.5 do GPT-6 Astra. É a vantagem mais suja do Full. SWE-Marathon mede execução sustentada em projetos de software longos, e o Full vence com folga porque não desiste, consegue se recuperar de tool calls quebradas e segue empurrando o problema até resolver.
DeepSWE 1.1: liderança técnica em codificação
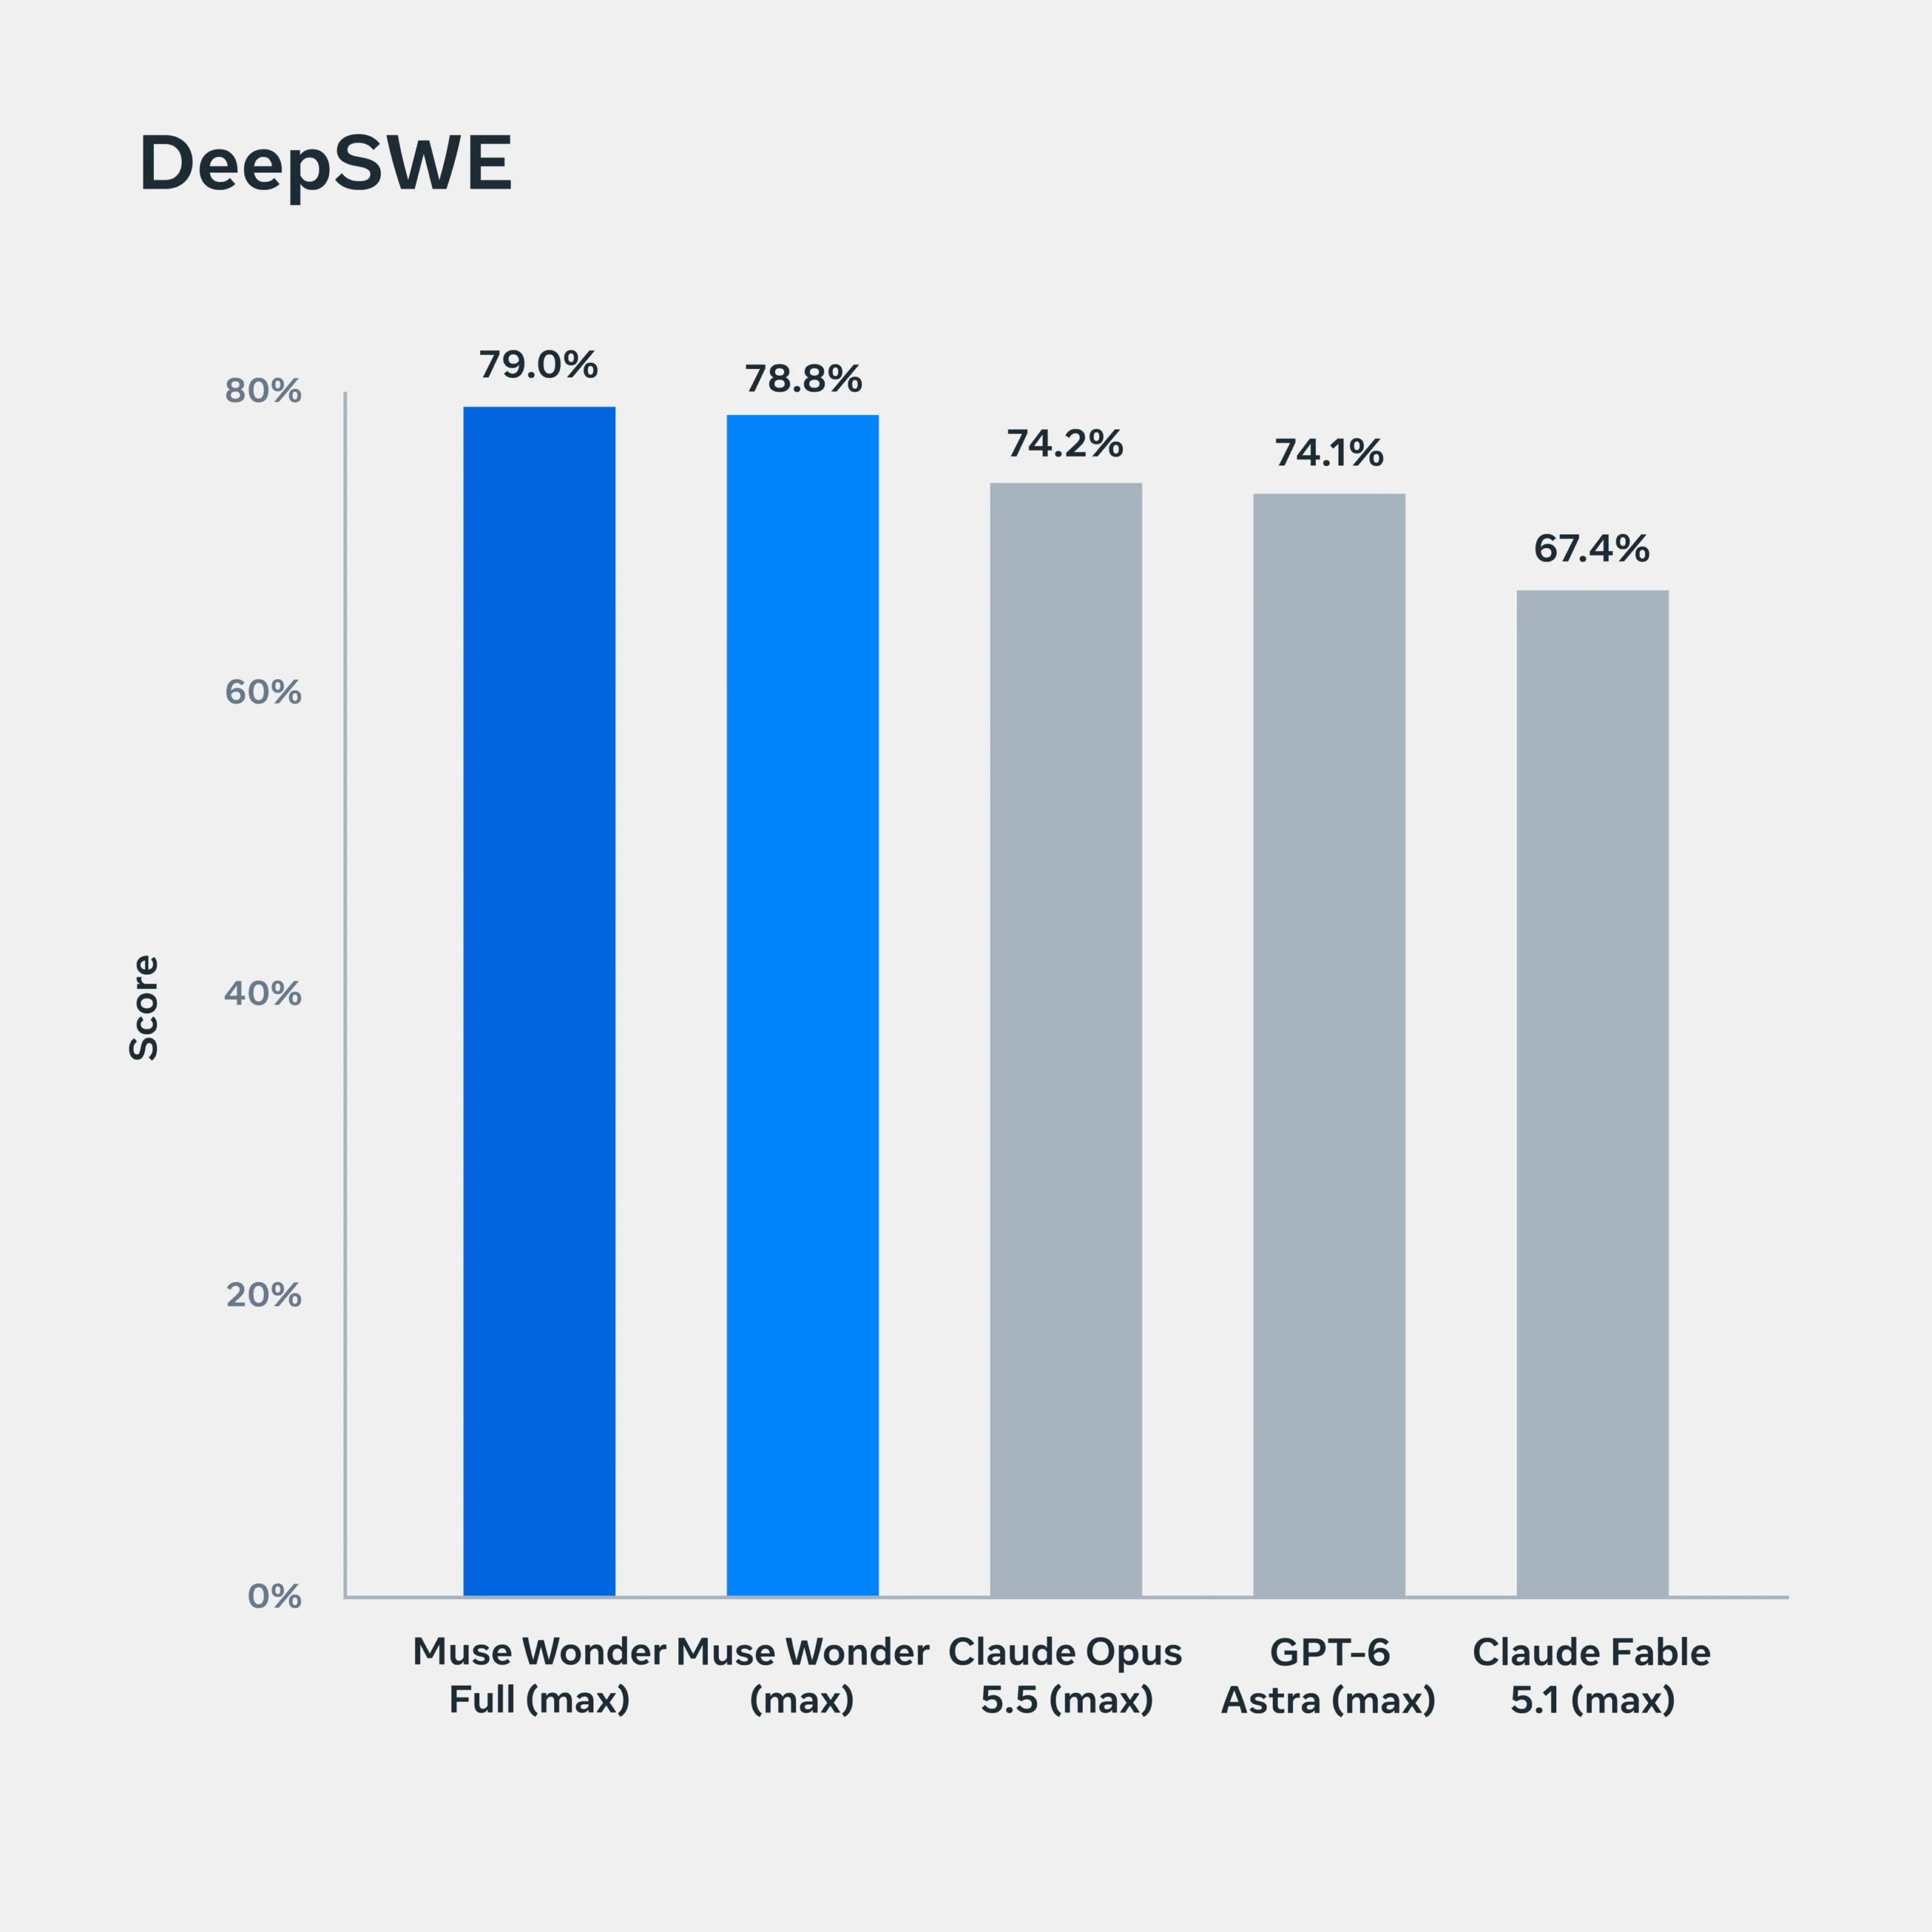
79.0 no DeepSWE 1.1 é a melhor marca reportada em modelos abertos ou proprietários até agora, e a diferença entre Wonder (78.8) e Wonder Full (79.0) é mínima, mostrando que o tamanho da janela de raciocínio importa menos aqui, e o que conta mesmo é a base maior.
Harvey Legal Agent Benchmark (LAB)
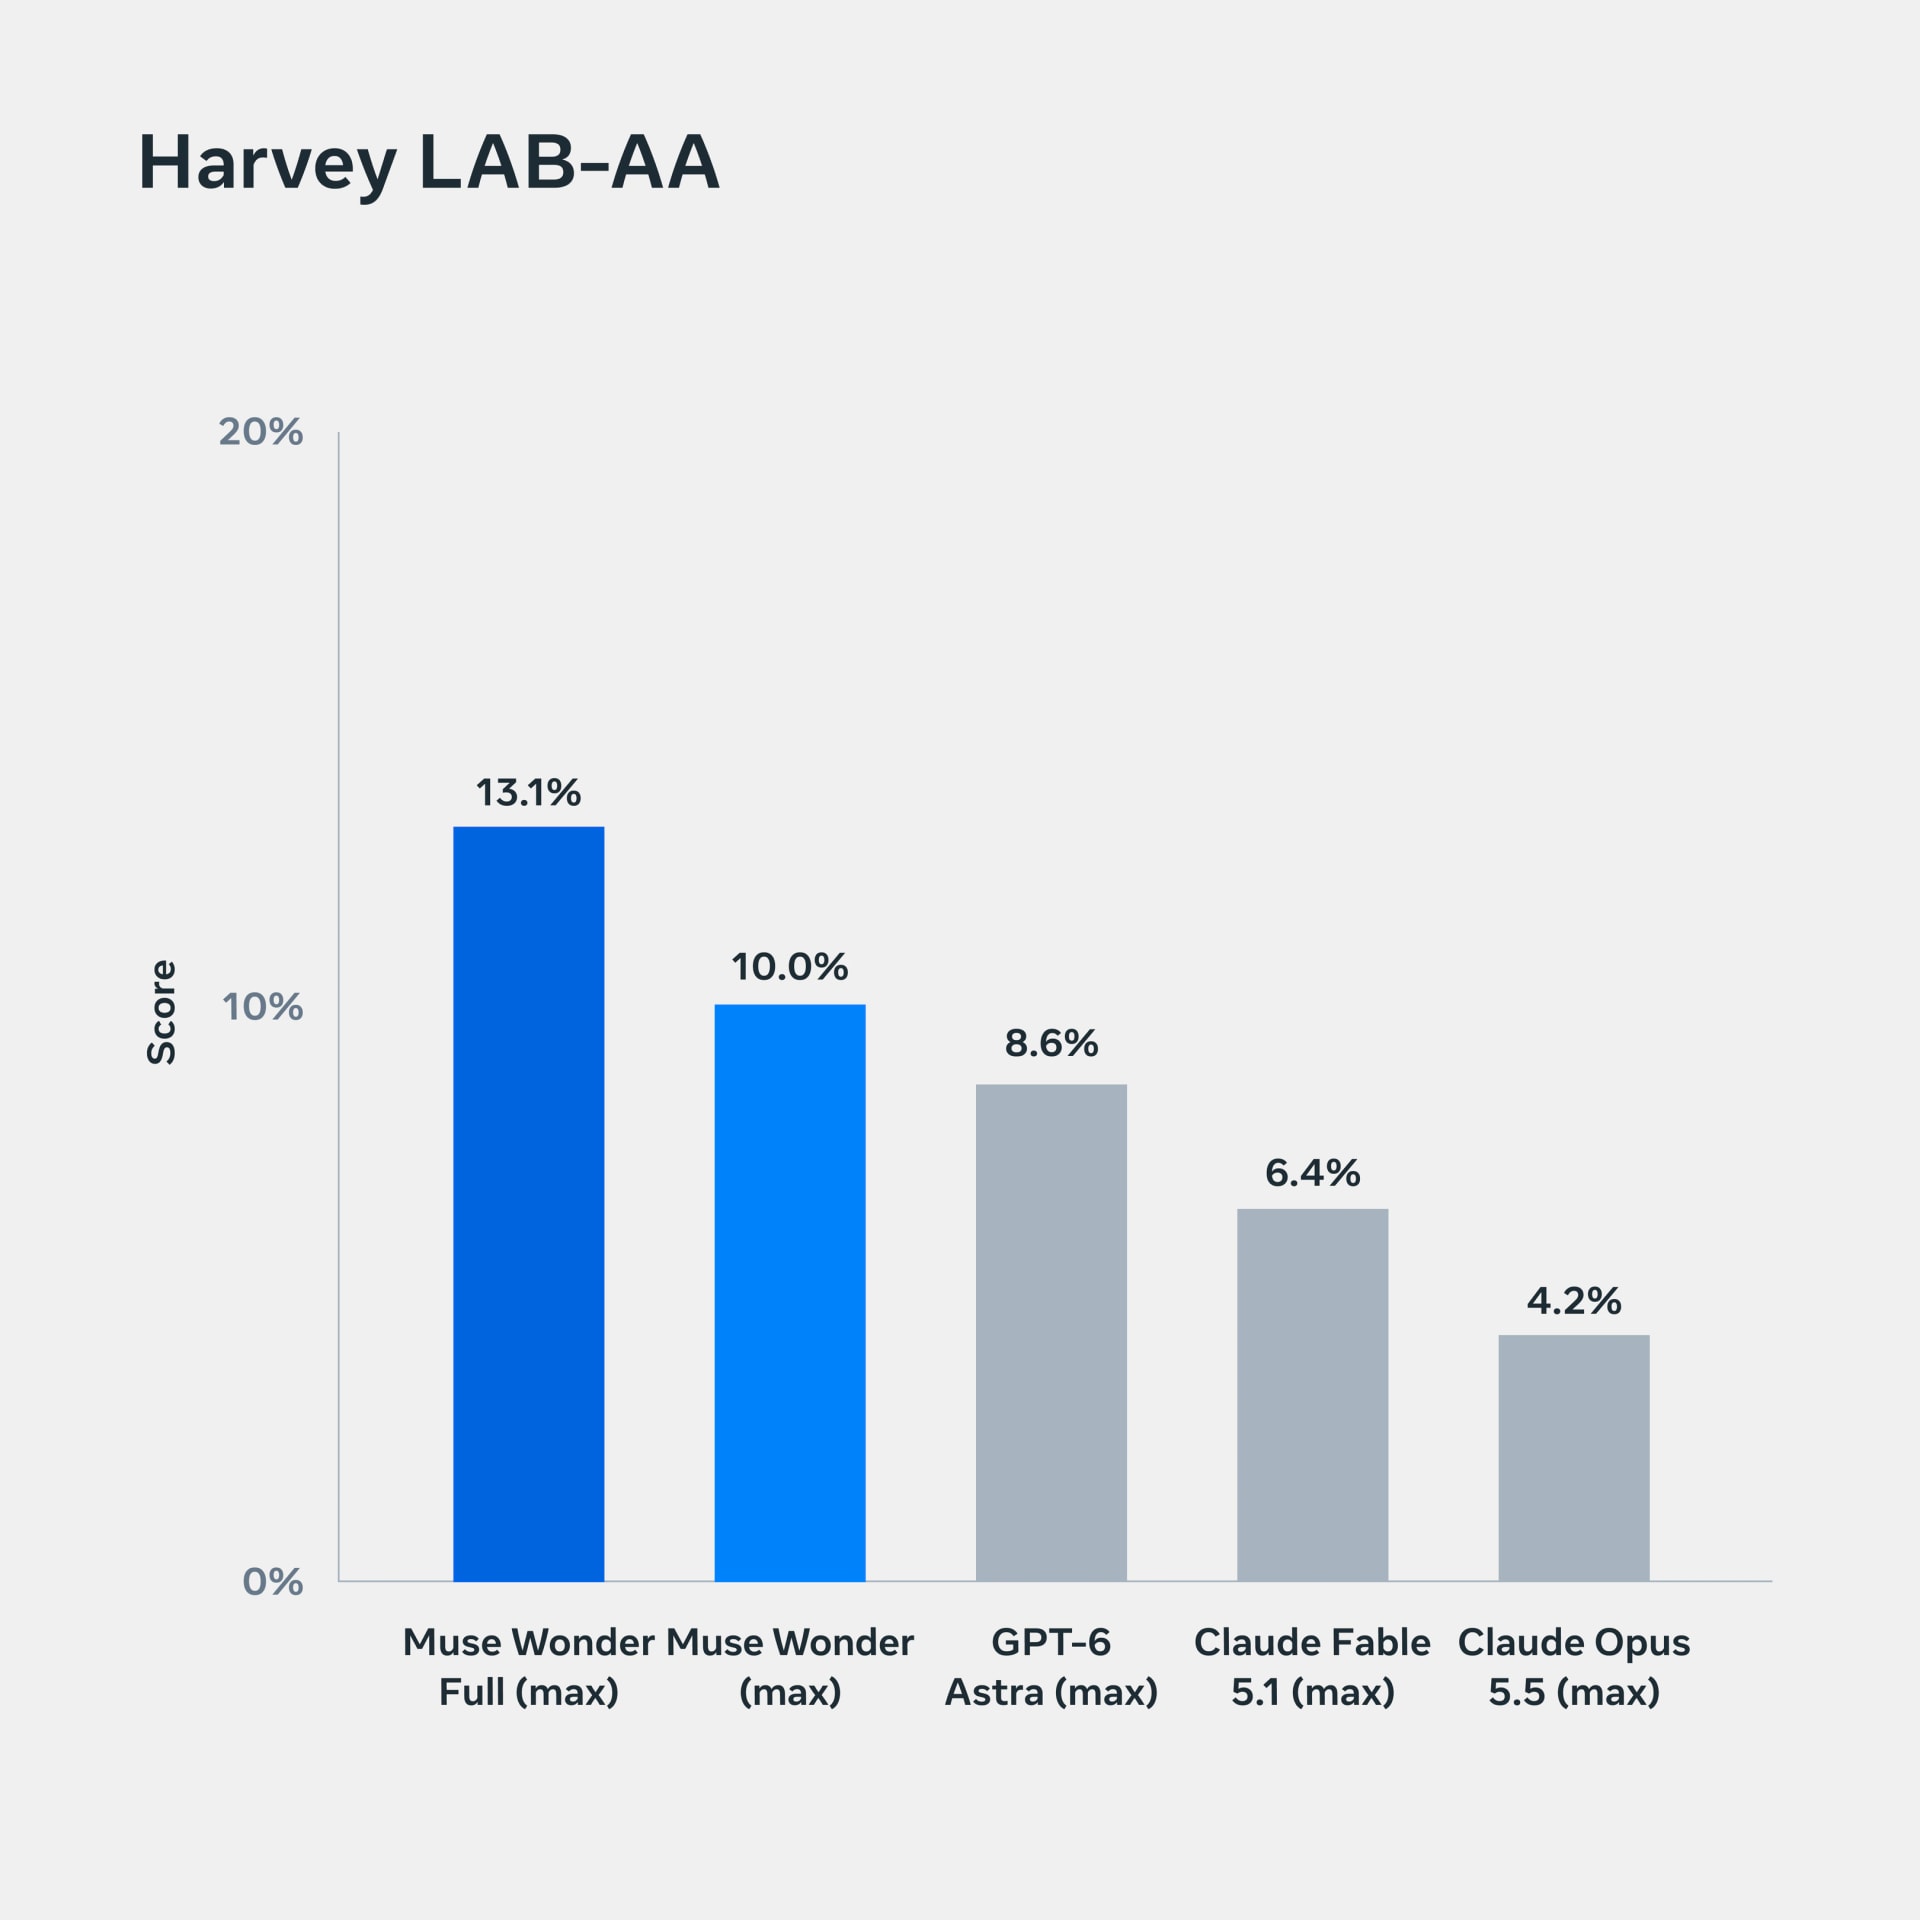
Trabalho com documentos fonte, instrução detalhada e produtos jurídicos reais. O Full lidera, seguido por Fable e Opus.
Vals Finance Agent V2
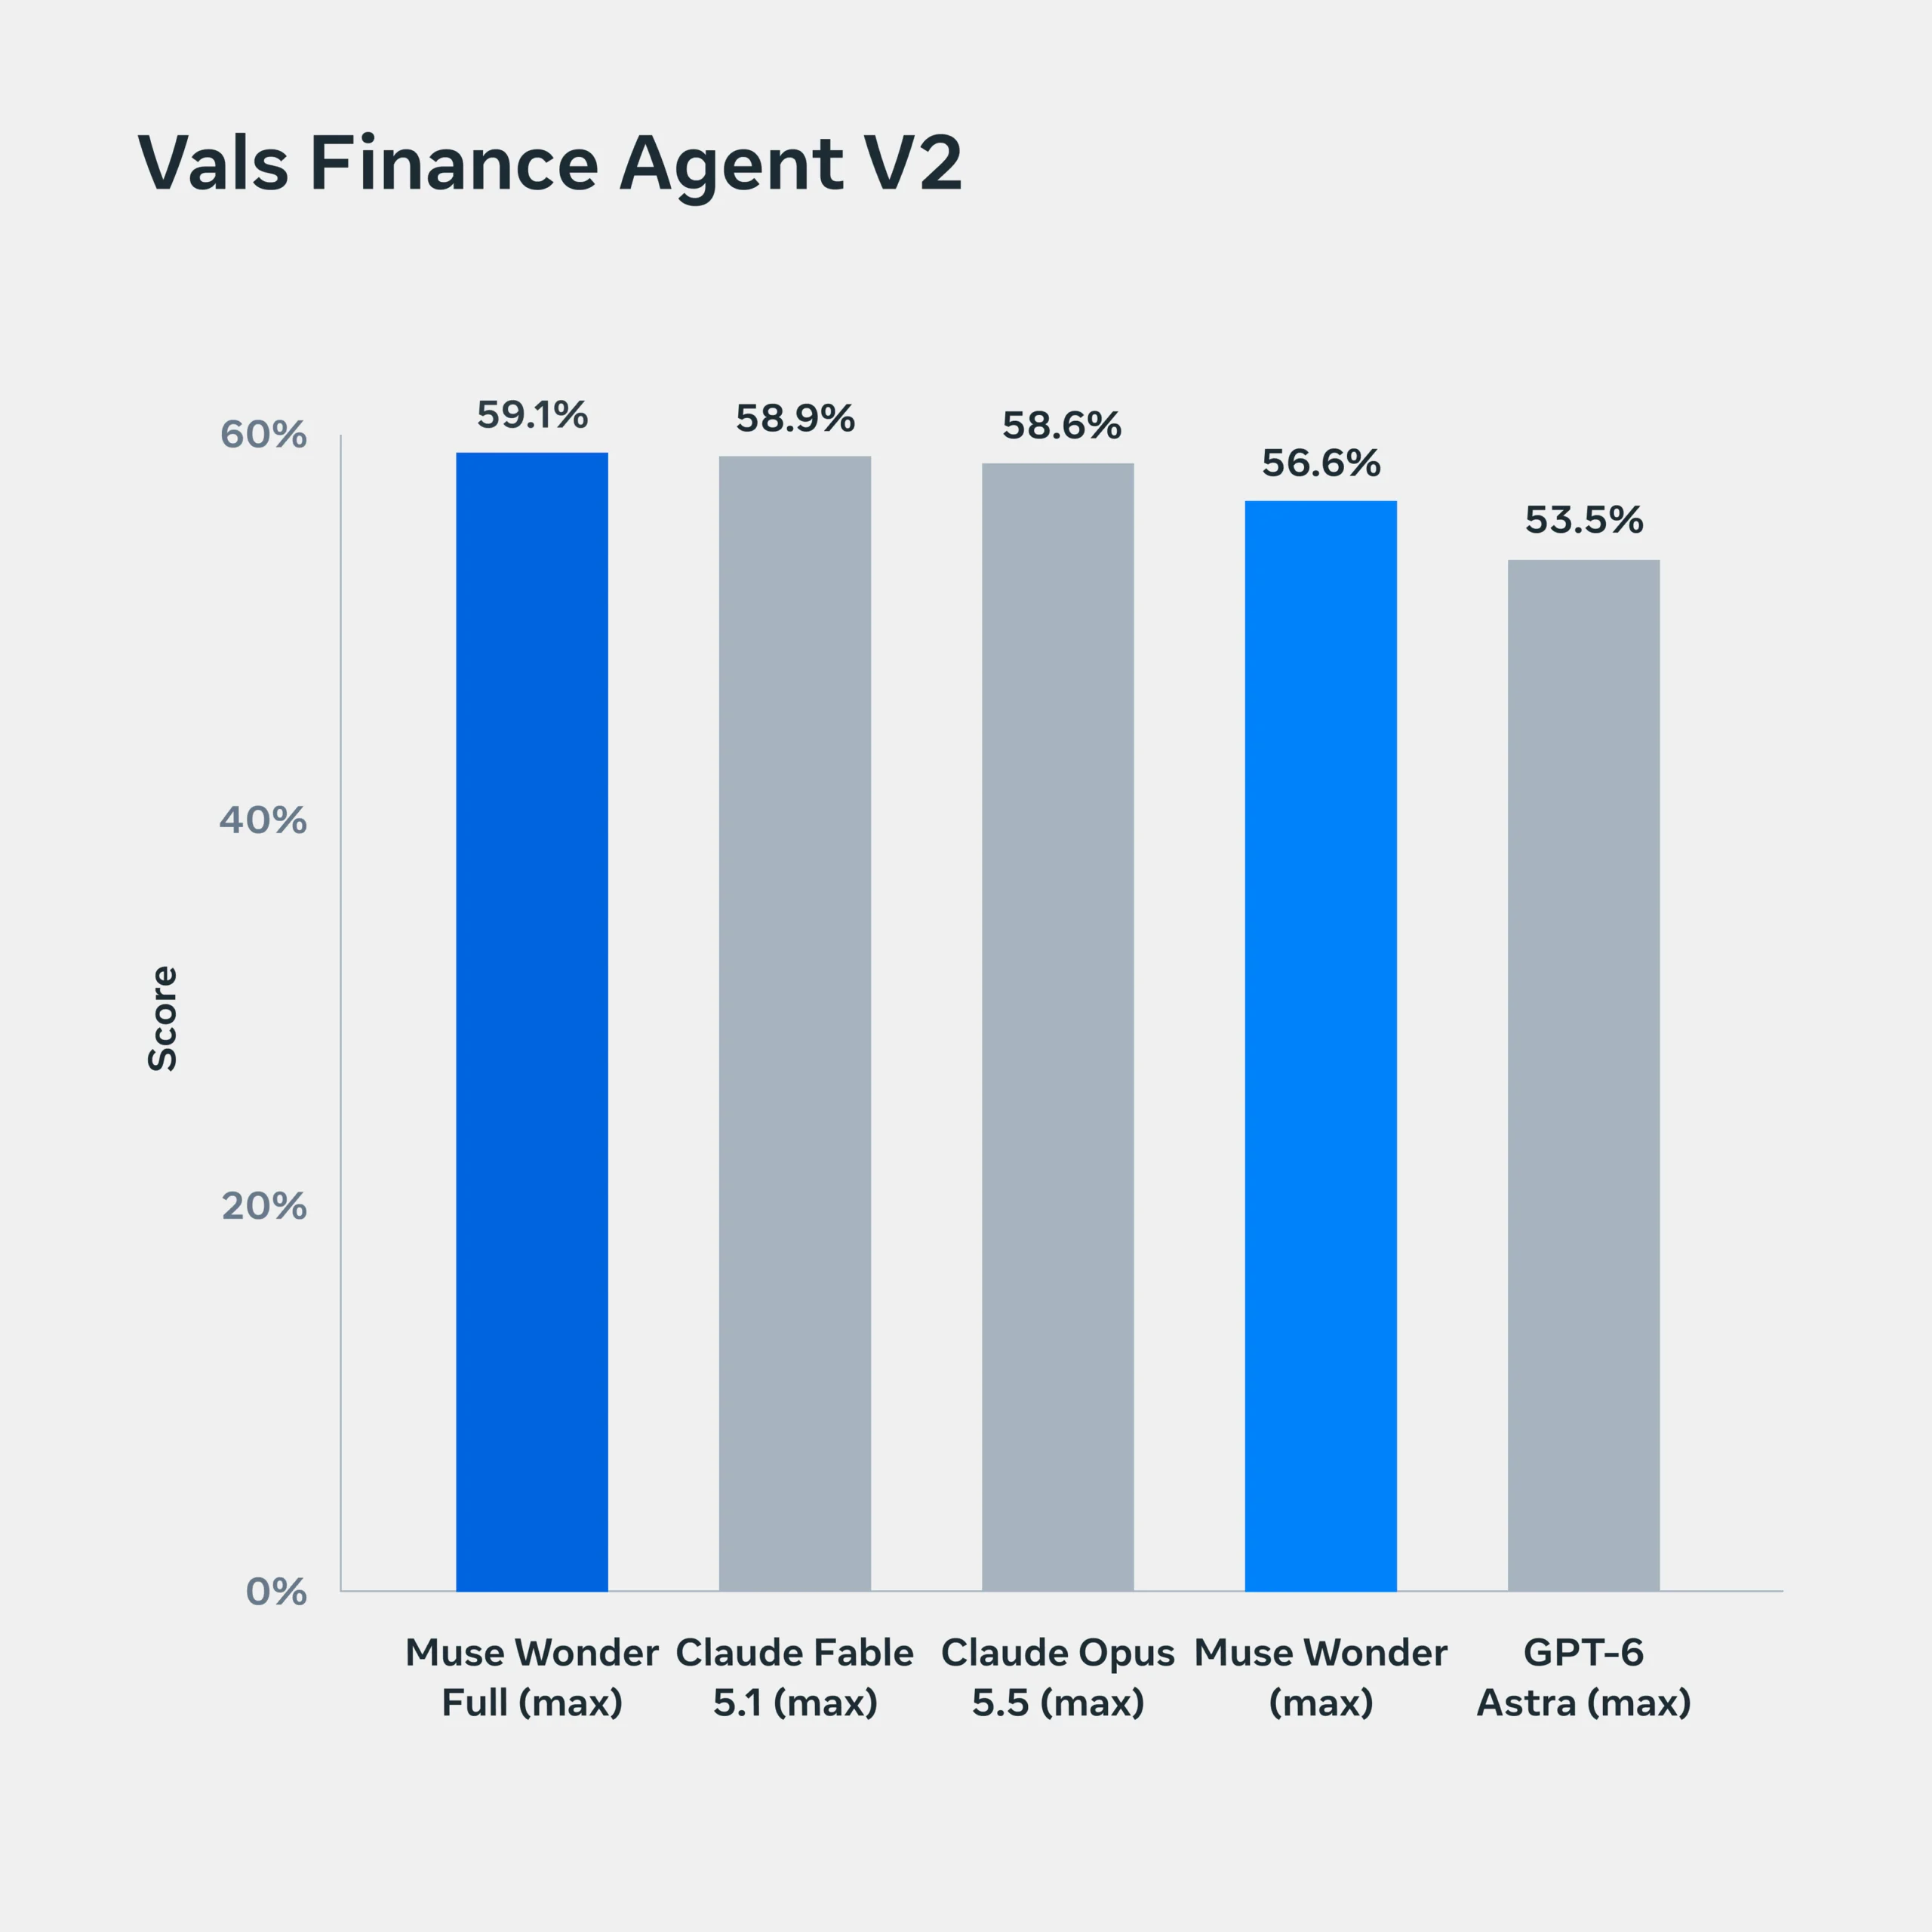
Tarefas de agente financeiro, da leitura de extratos à montagem de relatórios sob instrução complexa. Full lidera.
FocusBench: foco sustentado como métrica nova
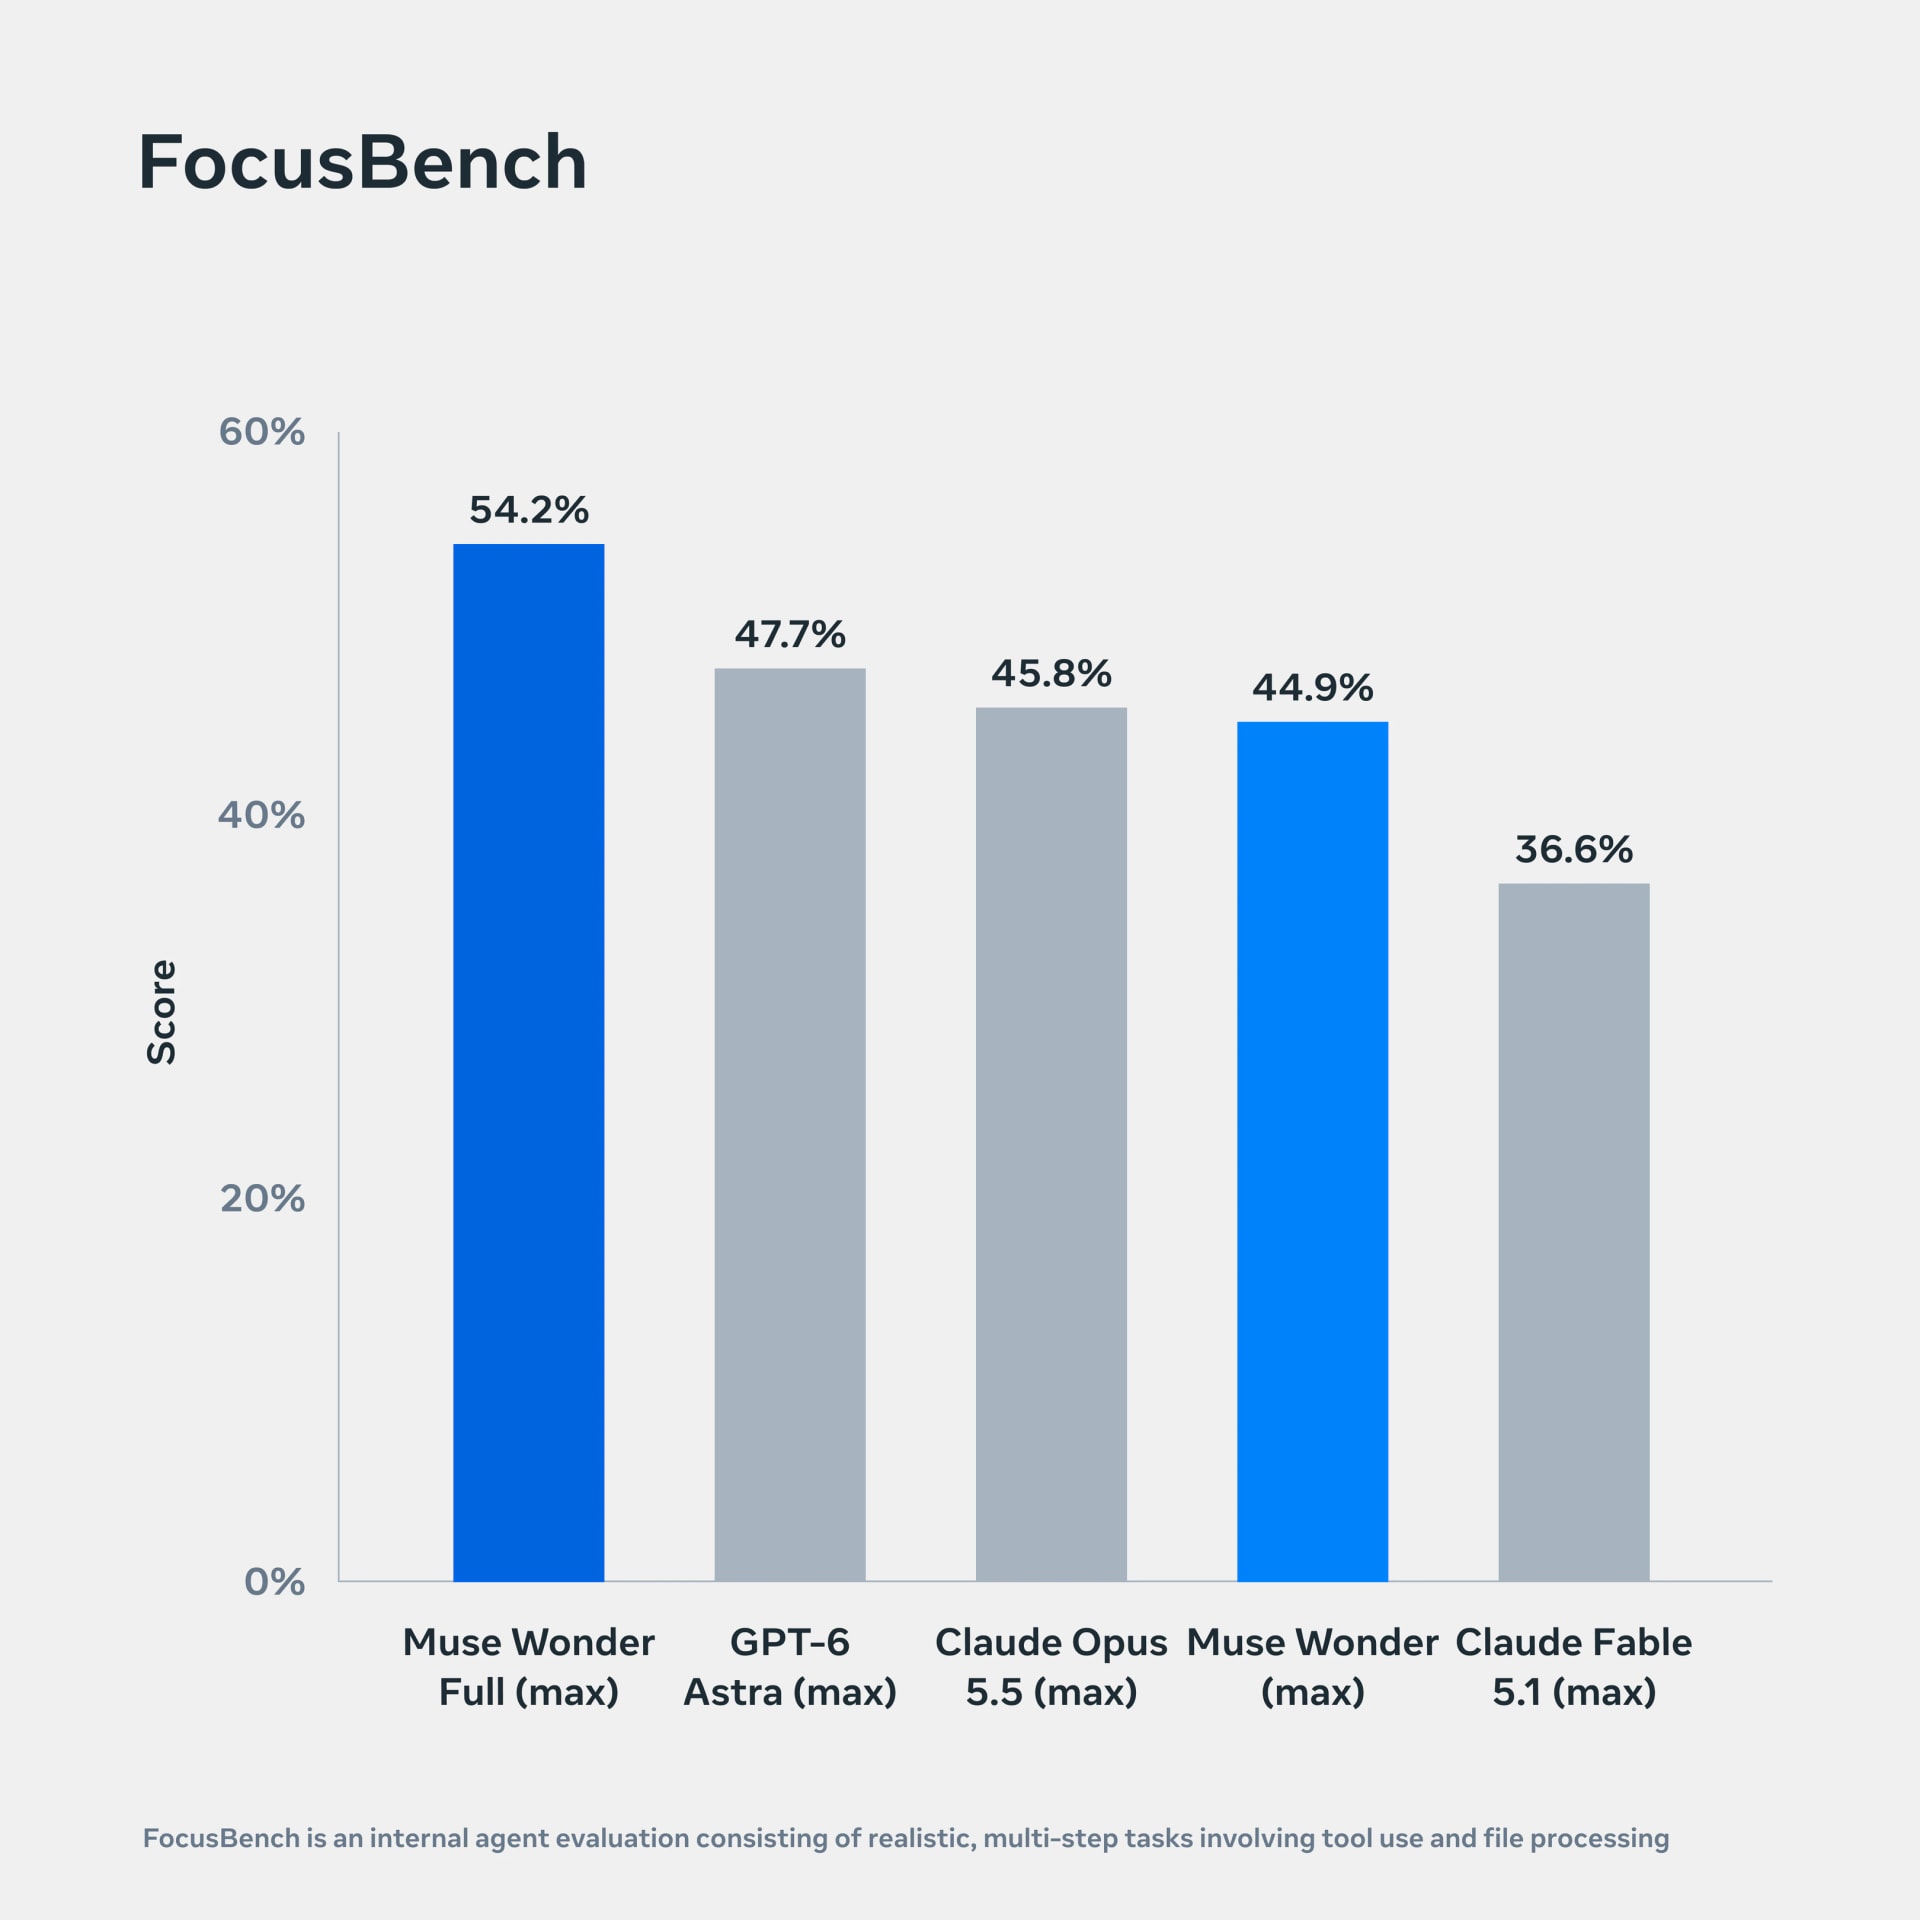
A Meta precisou inventar um benchmark próprio porque nenhum dos existentes media a coisa que mais importa em agentes pessoais: continuar trabalhando na tarefa mesmo quando ela trava. O Full lidera, com vantagem clara sobre Opus e Fable.
Por que Muse Wonder Full generaliza melhor que Muse Spark 1.3
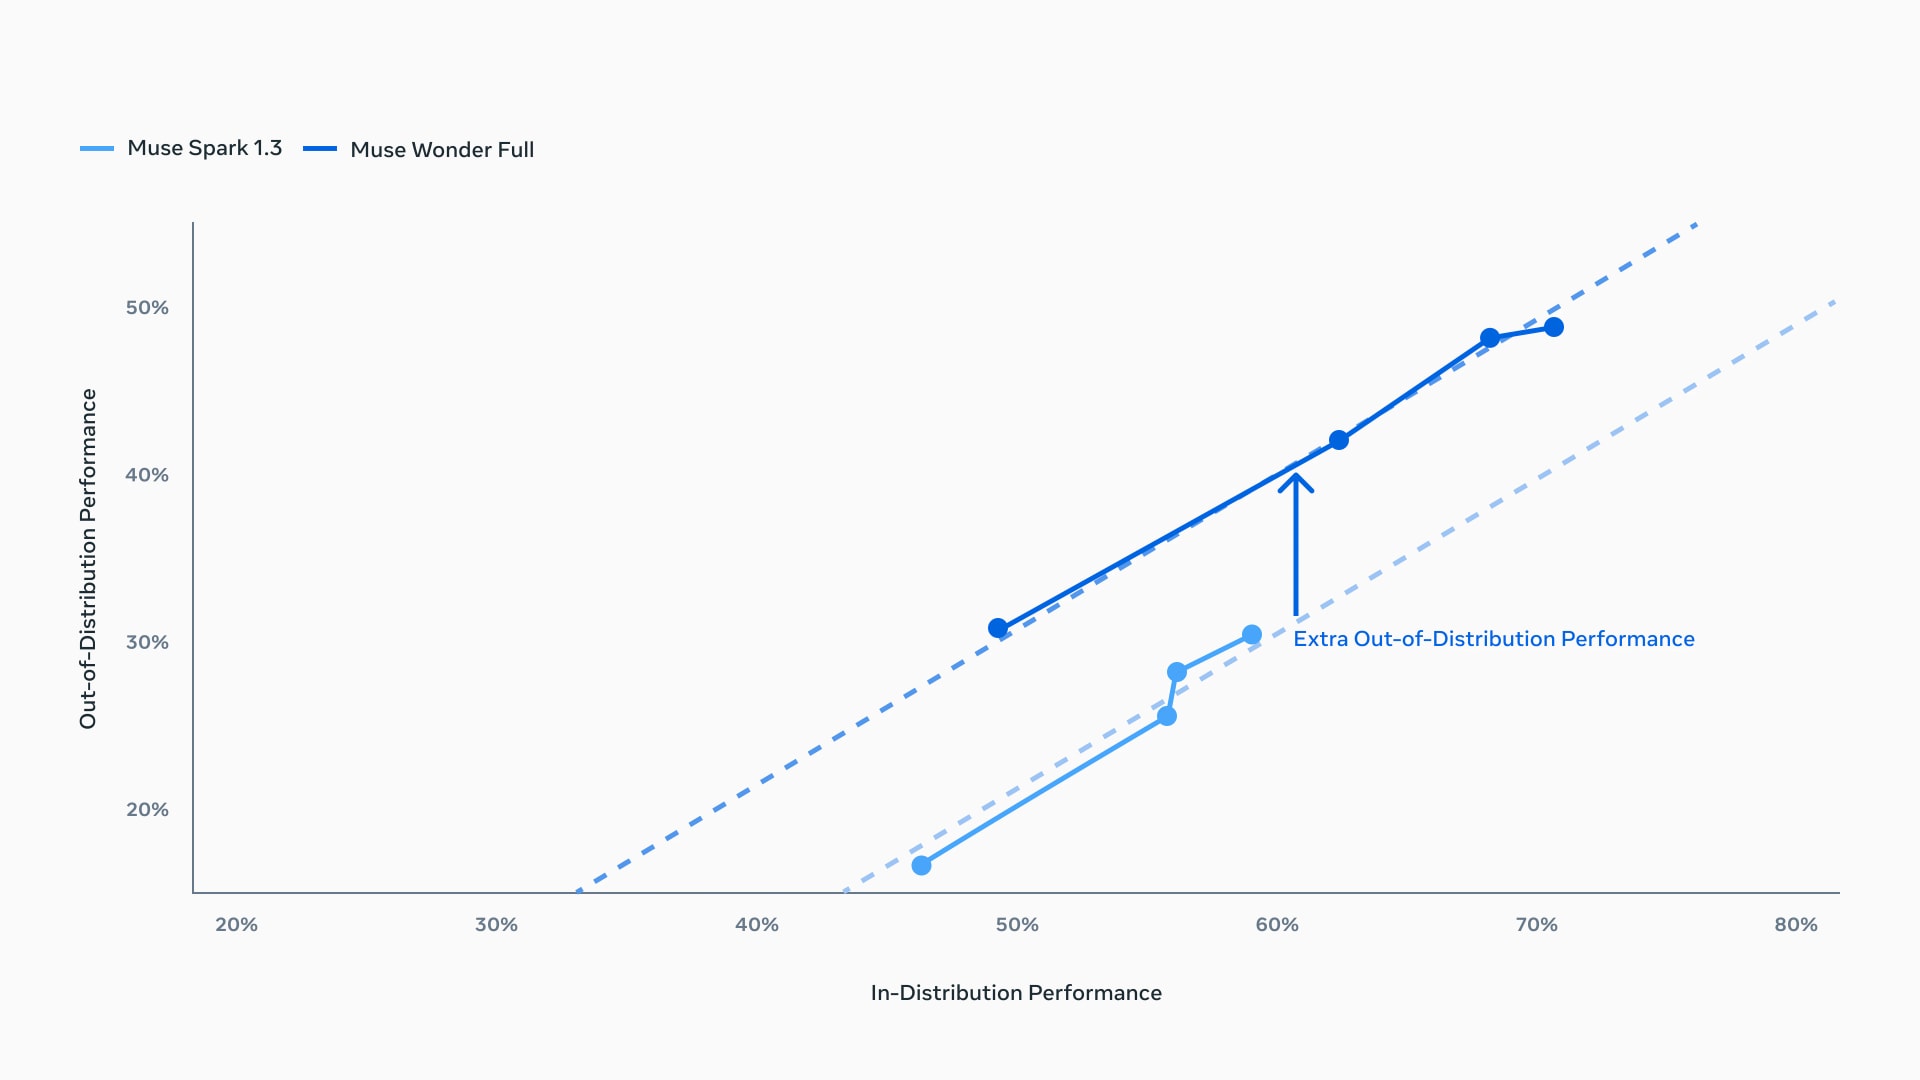
A Meta publicou um scatter plot interessante, comparando Spark 1.3 com Full em tarefas in-distribution (alvo do pós-treinamento) e out-of-distribution (estranhas ao pós-treinamento). Os dois modelos melhoram a OOD em paralelo quando escalam test-time compute, mas o Full está numa curva acima da tendência do Spark 1.3, ou seja, para a mesma performance em tarefas conhecidas, o Full entrega mais em tarefas novas. A Meta credita isso à base maior, e diz que é exatamente o tipo de robustez que agentes pessoais precisam, porque não dá pra antecipar todas as combinações de objetivo, ferramenta e restrição durante o treinamento.
Quanto custa usar
A Meta foi agressiva na precificação do Wonder (API) e conservadora no Full (exclusivo por assinatura). A tabela abaixo consolida tudo.
| Plano | Preço | Inclui Wonder | Inclui Wonder Full | Janela de uso |
|---|---|---|---|---|
| Meta Model API (pay-as-you-go) | US$ 4 / 1M input, US$ 0,20 cache, US$ 20 / 1M output | Sim | Não | 3.000 req/min e 4M tokens/min |
| Web Search embutido (API) | US$ 2,50 / 1.000 queries + tokens | Sim | Não | — |
| Everyday Usage (Muse Code) | US$ 5 / mês | Sim | Não | 10-50 prompts / 5h |
| High Usage (Muse Code) | US$ 15 / mês | Sim | Não | 5× Everyday |
| Power Usage (Muse Code) | US$ 50 / mês | Sim | Sim | 20× Everyday |
| Maximum Usage (Muse Code) | US$ 200 / mês | Sim | Sim | 80× Everyday |
| Assinatura do Muse (consumidor) | US$ 20 ou US$ 100 / mês + tier grátis | Em breve (Wonder), via Full se for Plus | Em breve (Wonder), via Full se for Plus | Acesso expandido para usuários pagantes |
Comparação direta: a API do Wonder sai pelo mesmo preço do Opus 5.5 da Anthropic, US$ 4 / US$ 20. GPT-6 Sol da OpenAI e Gemini 4 Argon do Google cobram mais barato, mas perdem no agregado de capacidade. A diferença brutal fica no Full, que trava dentro do Muse Code e força empresas a pagar US$ 50-200/mês por assento, ou abrir uma chave de API separada.
Letra miúda importante: as assinaturas do Muse Code vêm, por padrão, no modo Contributor, o que dá direito a mais uso mas autoriza a Meta a usar prompts, código, arquivos e respostas para treinar modelos futuros. Quem não quiser contribuir precisa desligar manualmente. A API pay-as-you-go opera em modo Standard, sem permissão de treino. Não é exatamente zero retenção, mas é o que a empresa oferece.
O que o Muse Wonder faz de verdade
A Meta destaca quatro capacidades no blog técnico, que são também os quatro benchmarks onde o Full vence.
1. Active Memory
O modelo lembra o que importa entre conversas e puxa a informação relevante na hora certa. É exatamente o que faltava em agentes atuais, que esquecem o nome do seu gato três turnos depois. A Meta cita MemoryBench como evidência principal: o Full passou Fable, Opus e Astra em recordação sustentada com 100K tokens de contexto.
2. Active Focus
Quando o caminho normal trava, o modelo tenta abordagens alternativas, recupera erros de tool calls, e só pede confirmação antes de tomar ações importantes. O FocusBench mede isso. Foi por isso que o Full passou o Opus 5.5 com folga no SWE-Marathon.
3. Domain expertise
Jurídico (LAB), financeiro (Vals Finance Agent V2) e saúde foram as três frentes treinadas explicitamente. Em todas, o Full lidera.
4. Frontier coding
A Meta treinou os dois modelos em tarefas de codificação longas e variadas para forçar persistência. DeepSWE 1.1 (79.0) e SWE-Marathon (57.5) são os carros-chefe.
Segurança: onde o Wonder é mais seguro que os concorrentes
A Meta também publicou números de segurança. A tese é simples: agentes pessoais têm acesso a mensagens, calendários e documentos privados, então o modelo precisa ser paranoico.
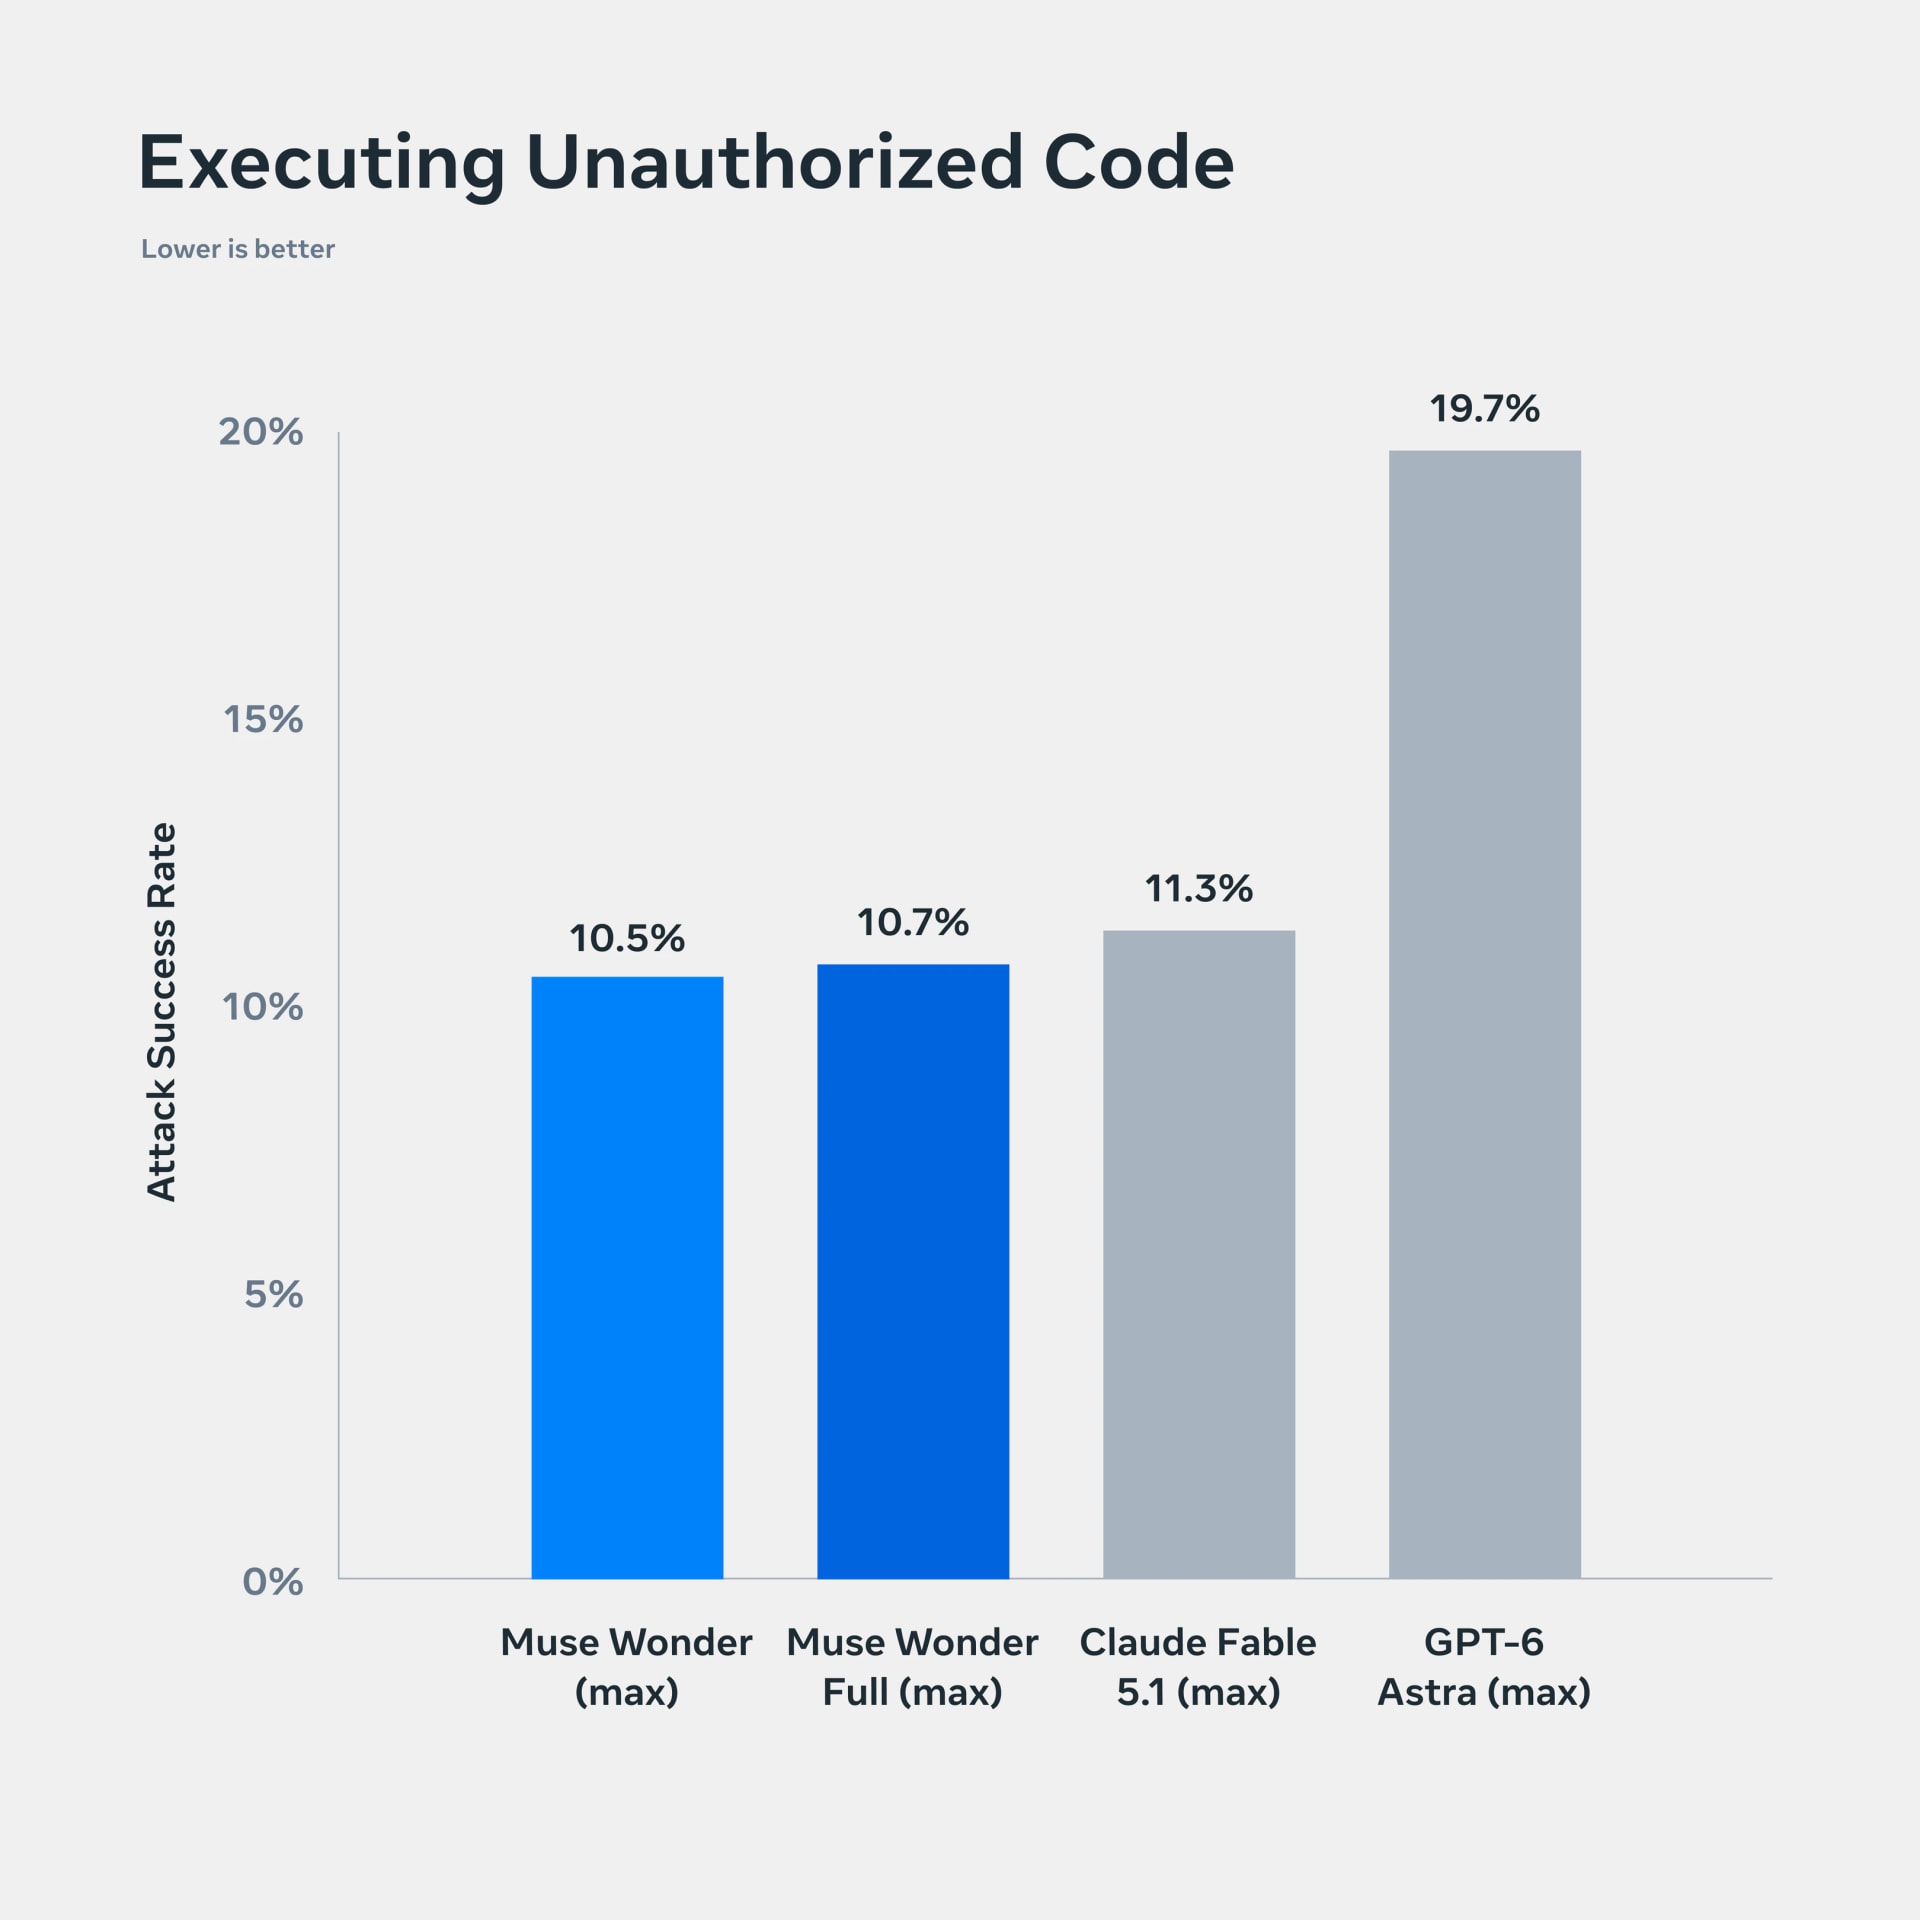
- Execução não autorizada de código (menor é melhor): o Full tem a menor taxa entre os modelos avaliados.
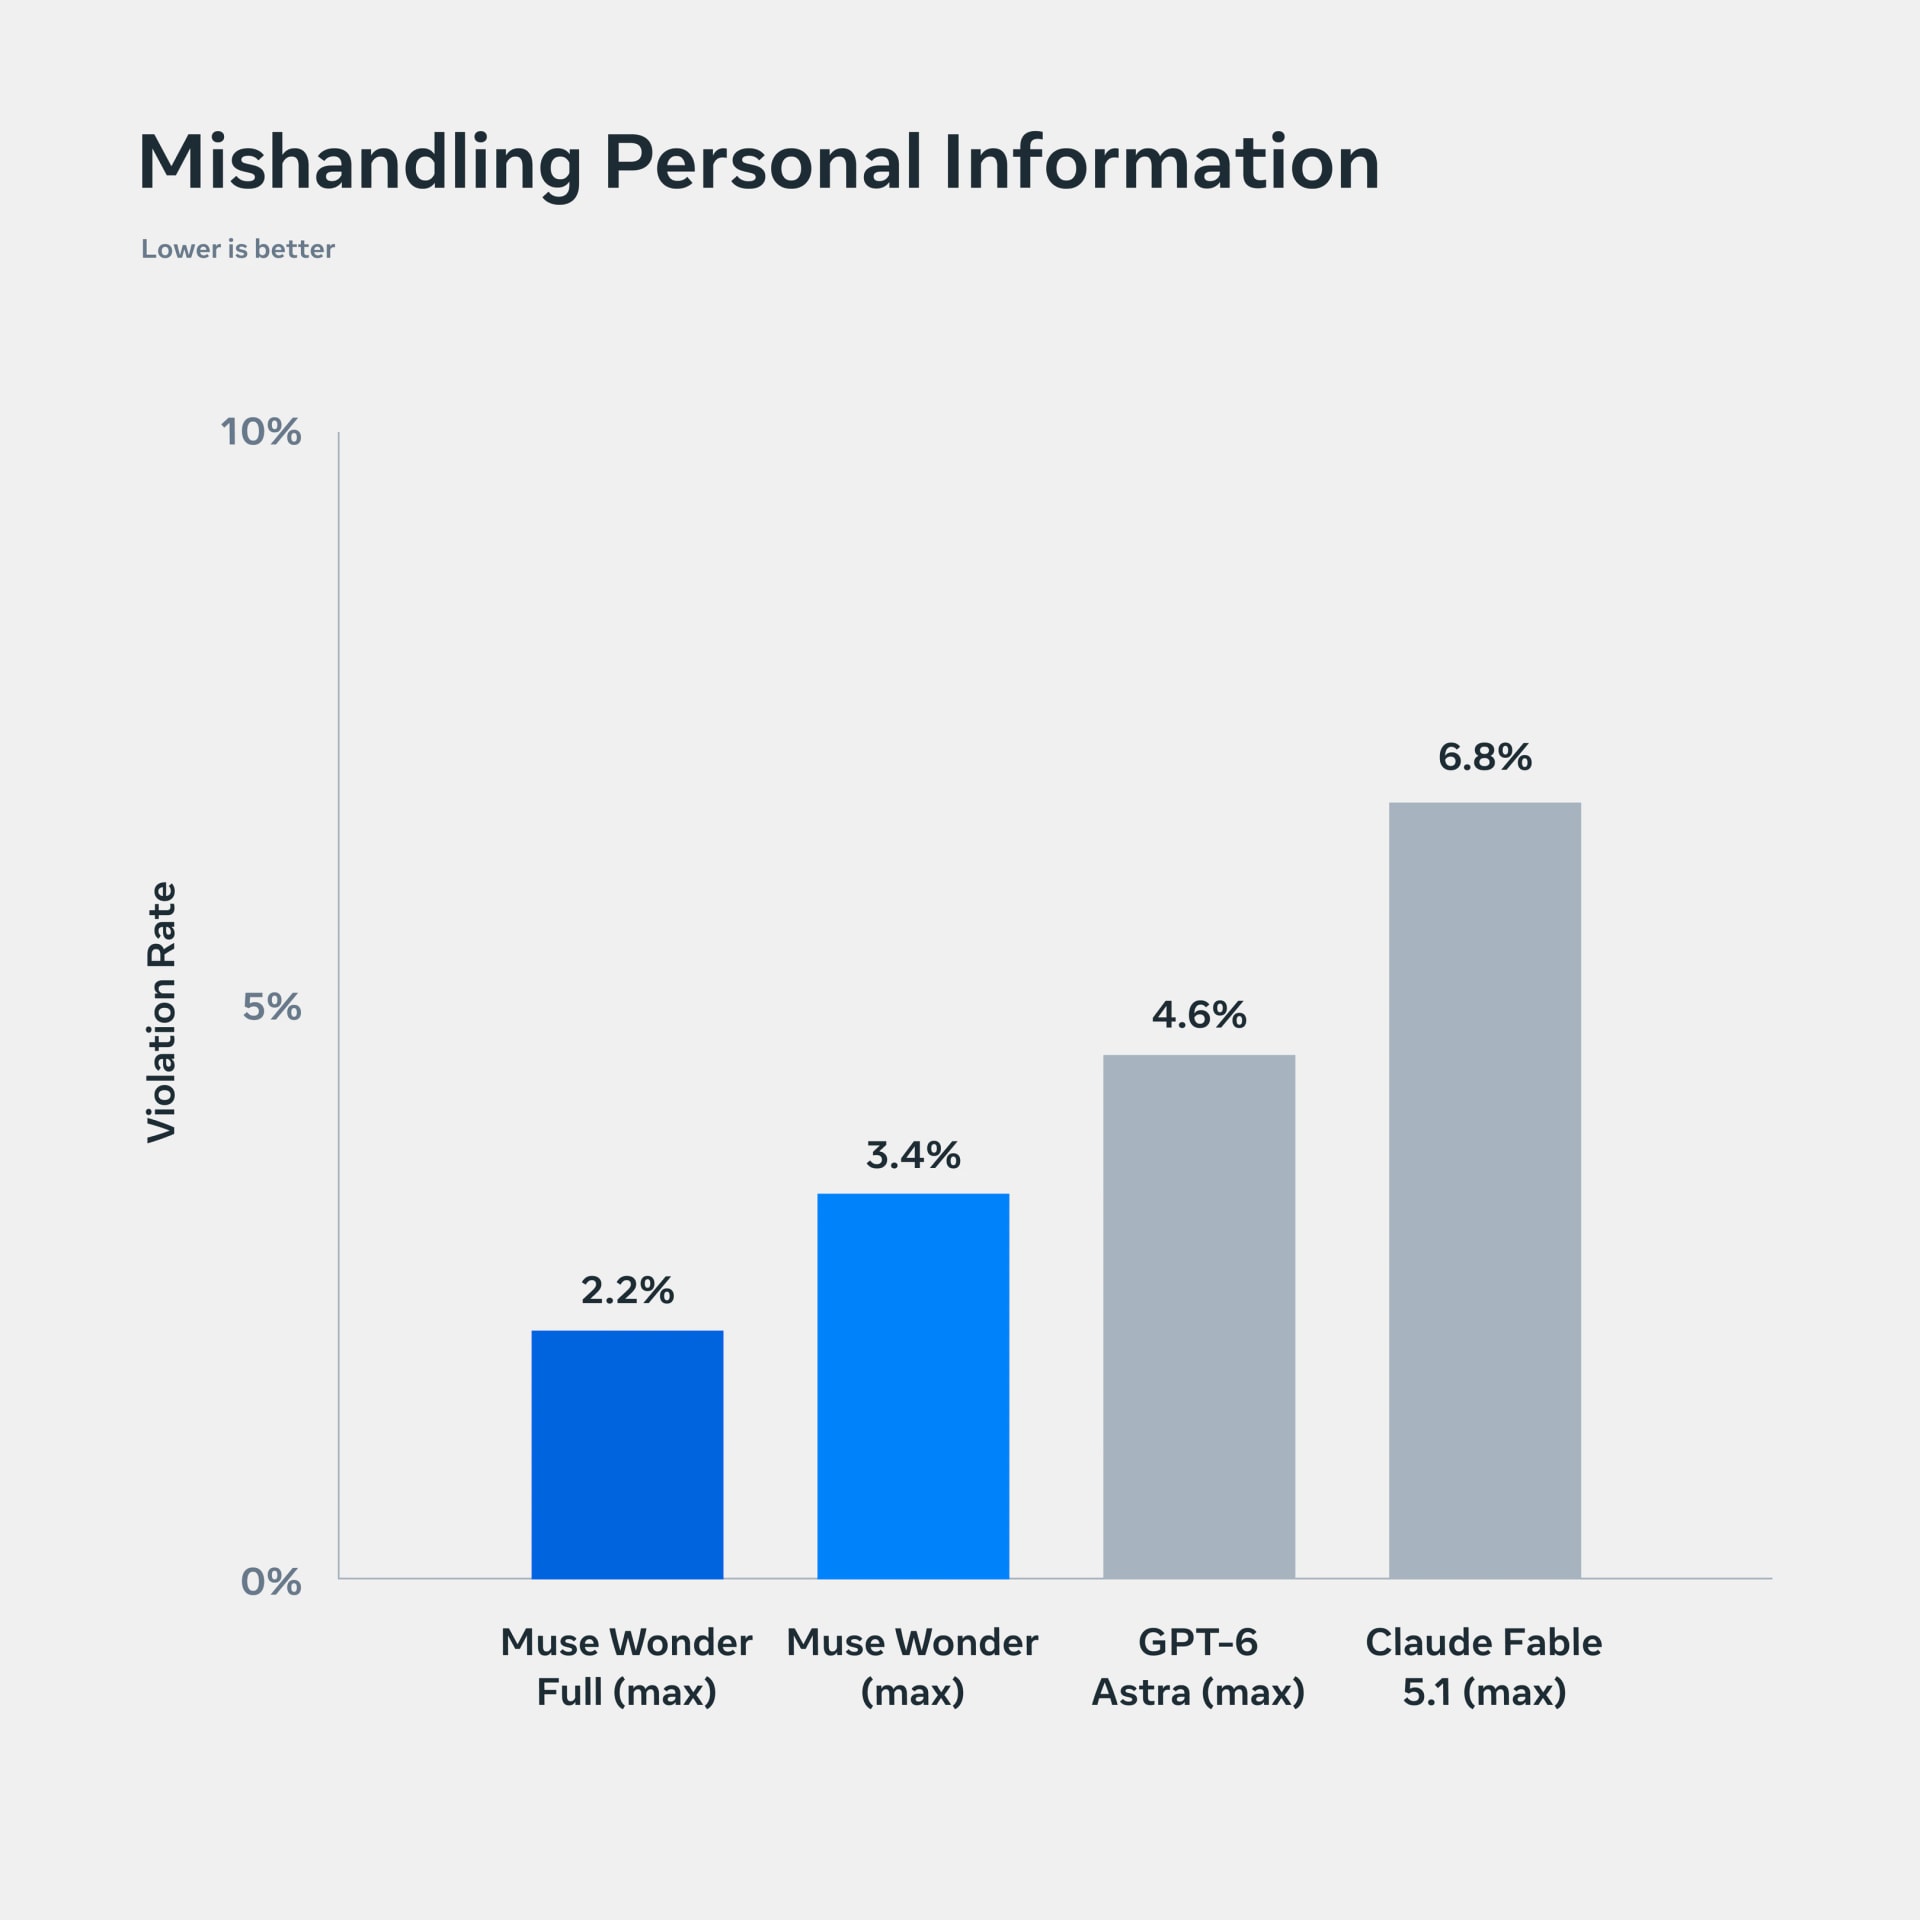
- Falha de discrição em privacidade (menor é melhor): o Full está entre os melhores.
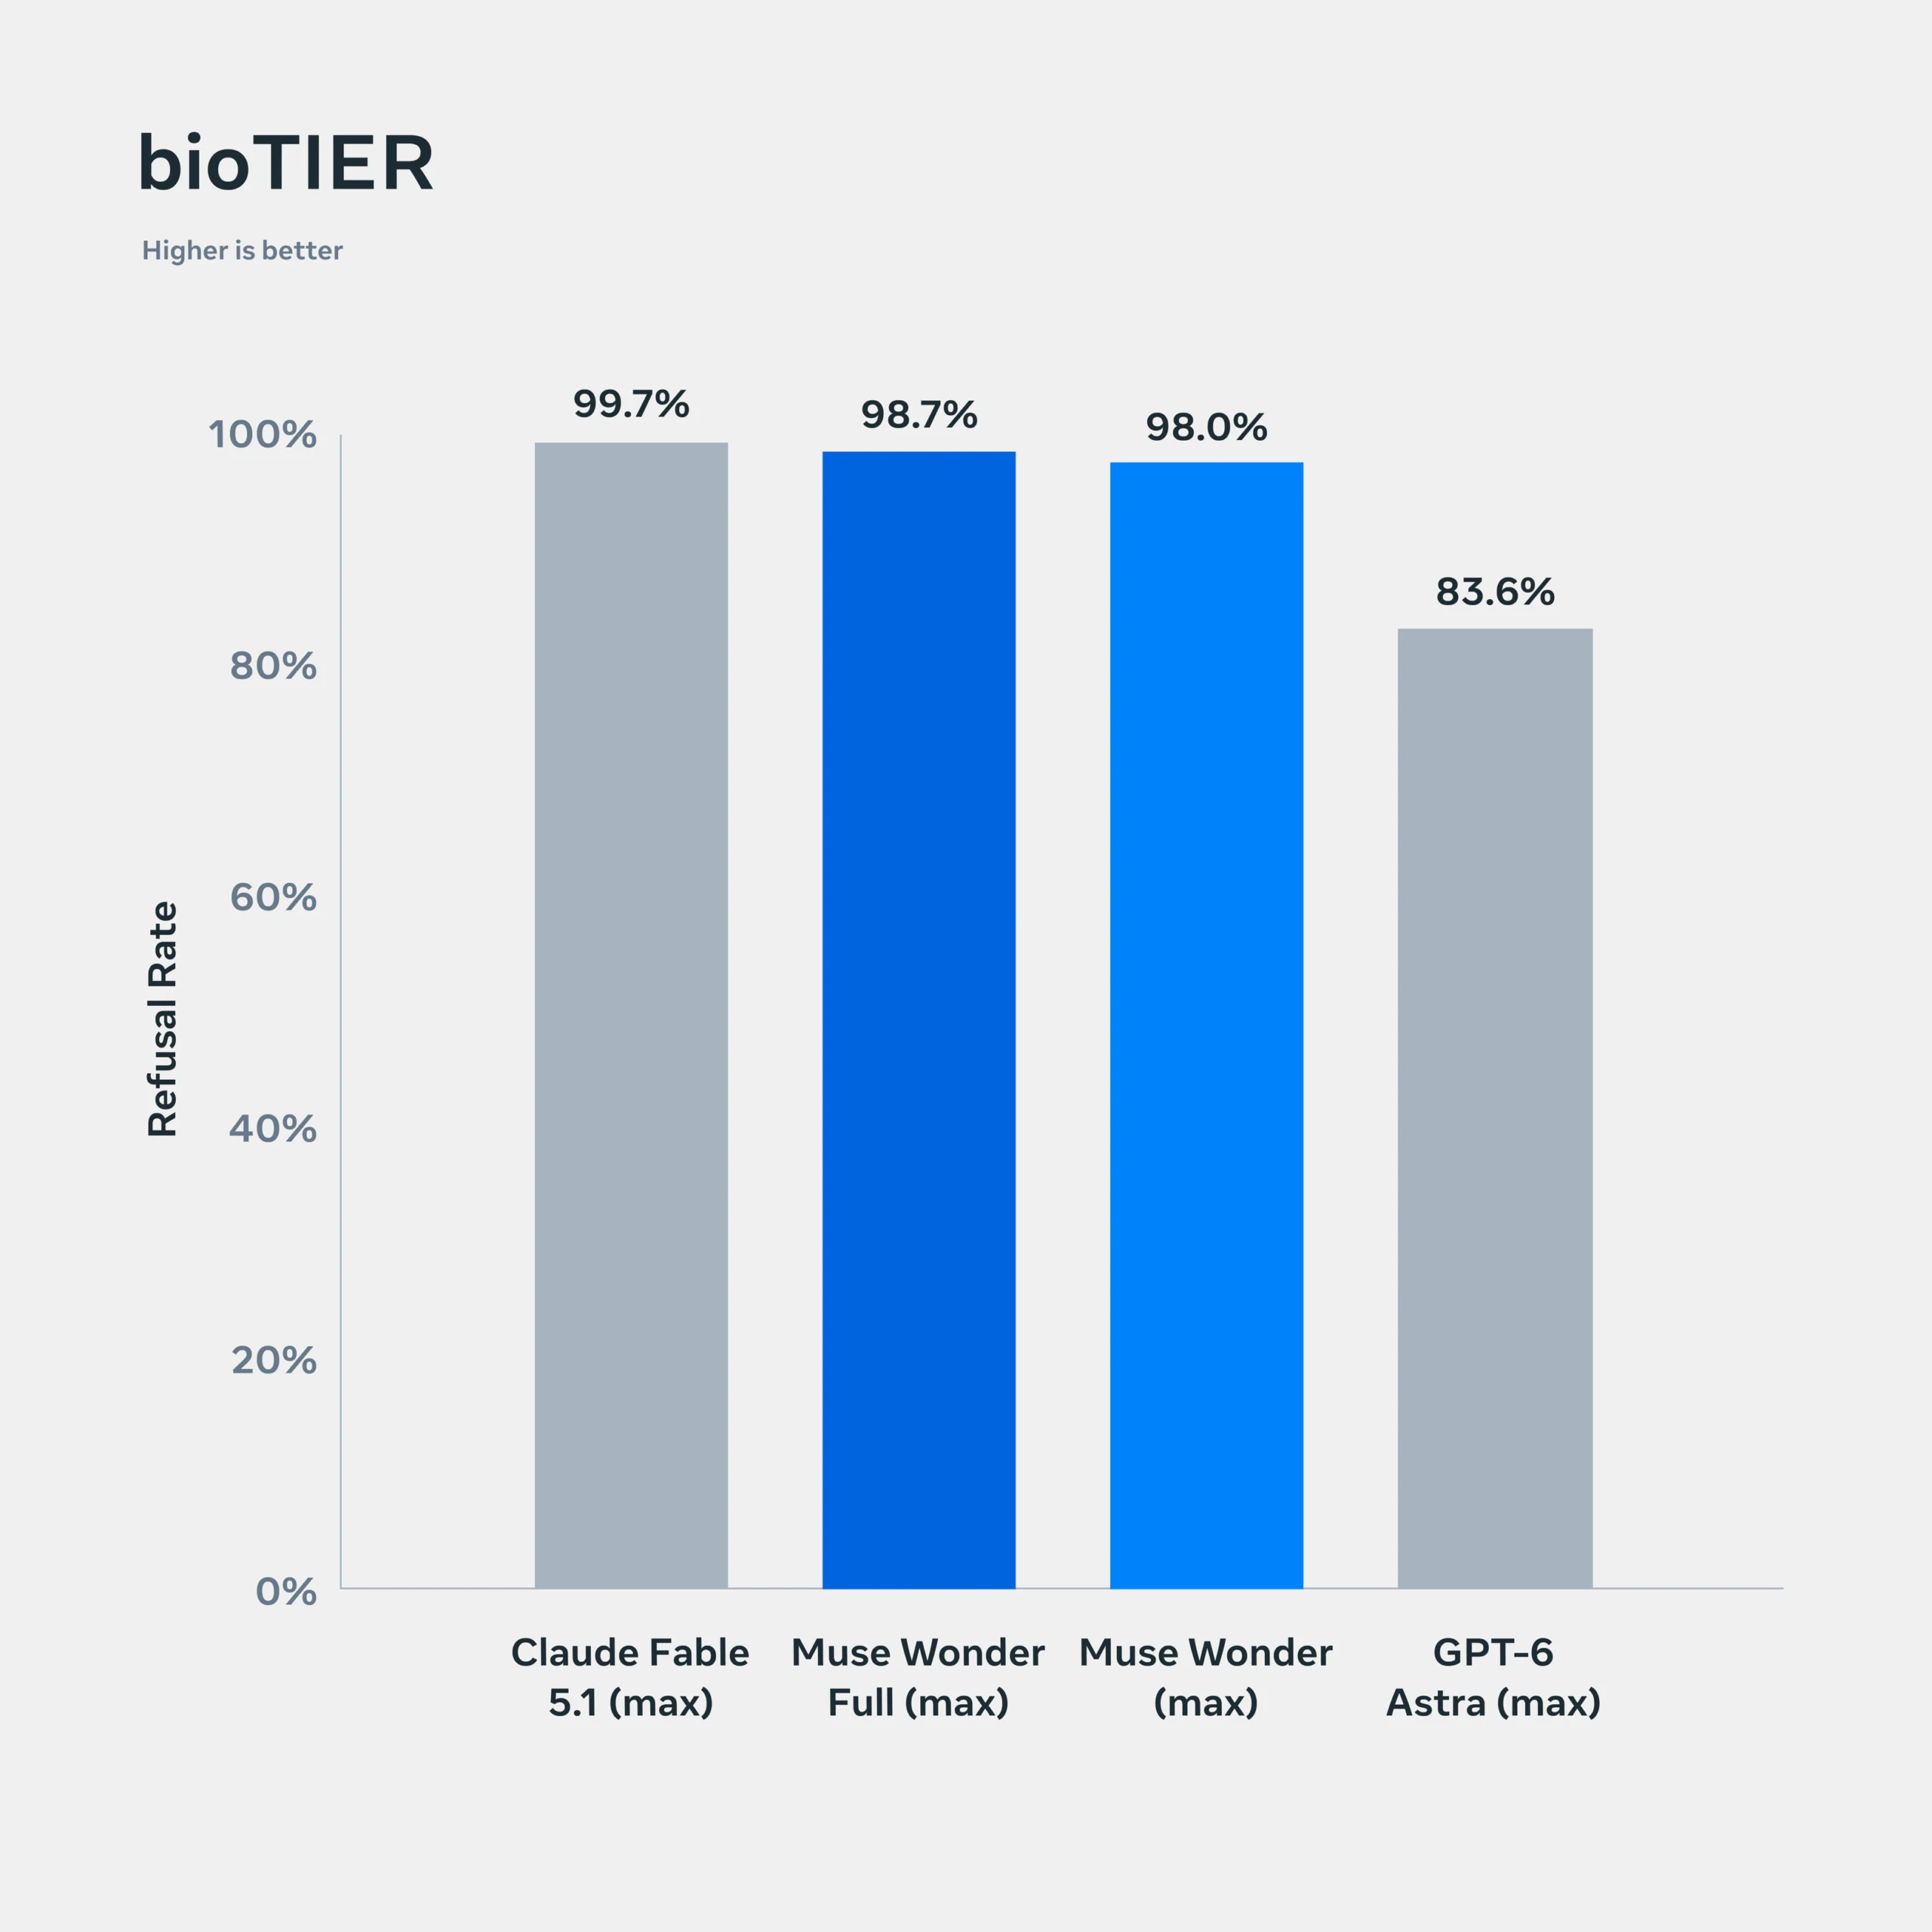
- Recusa a pedidos de bioweapon (maior é melhor): taxa máxima, sem exceções absurdas.
- Defesa cibernética: o Full mantém acesso a capacidades cyber defensivas (a Meta segue seu Superintelligence Scaling Framework) e se recusa a usos ofensivos.
Execução não autorizada de código
Falha de discrição em privacidade
Recusa a bioweapon
Defesa cibernética
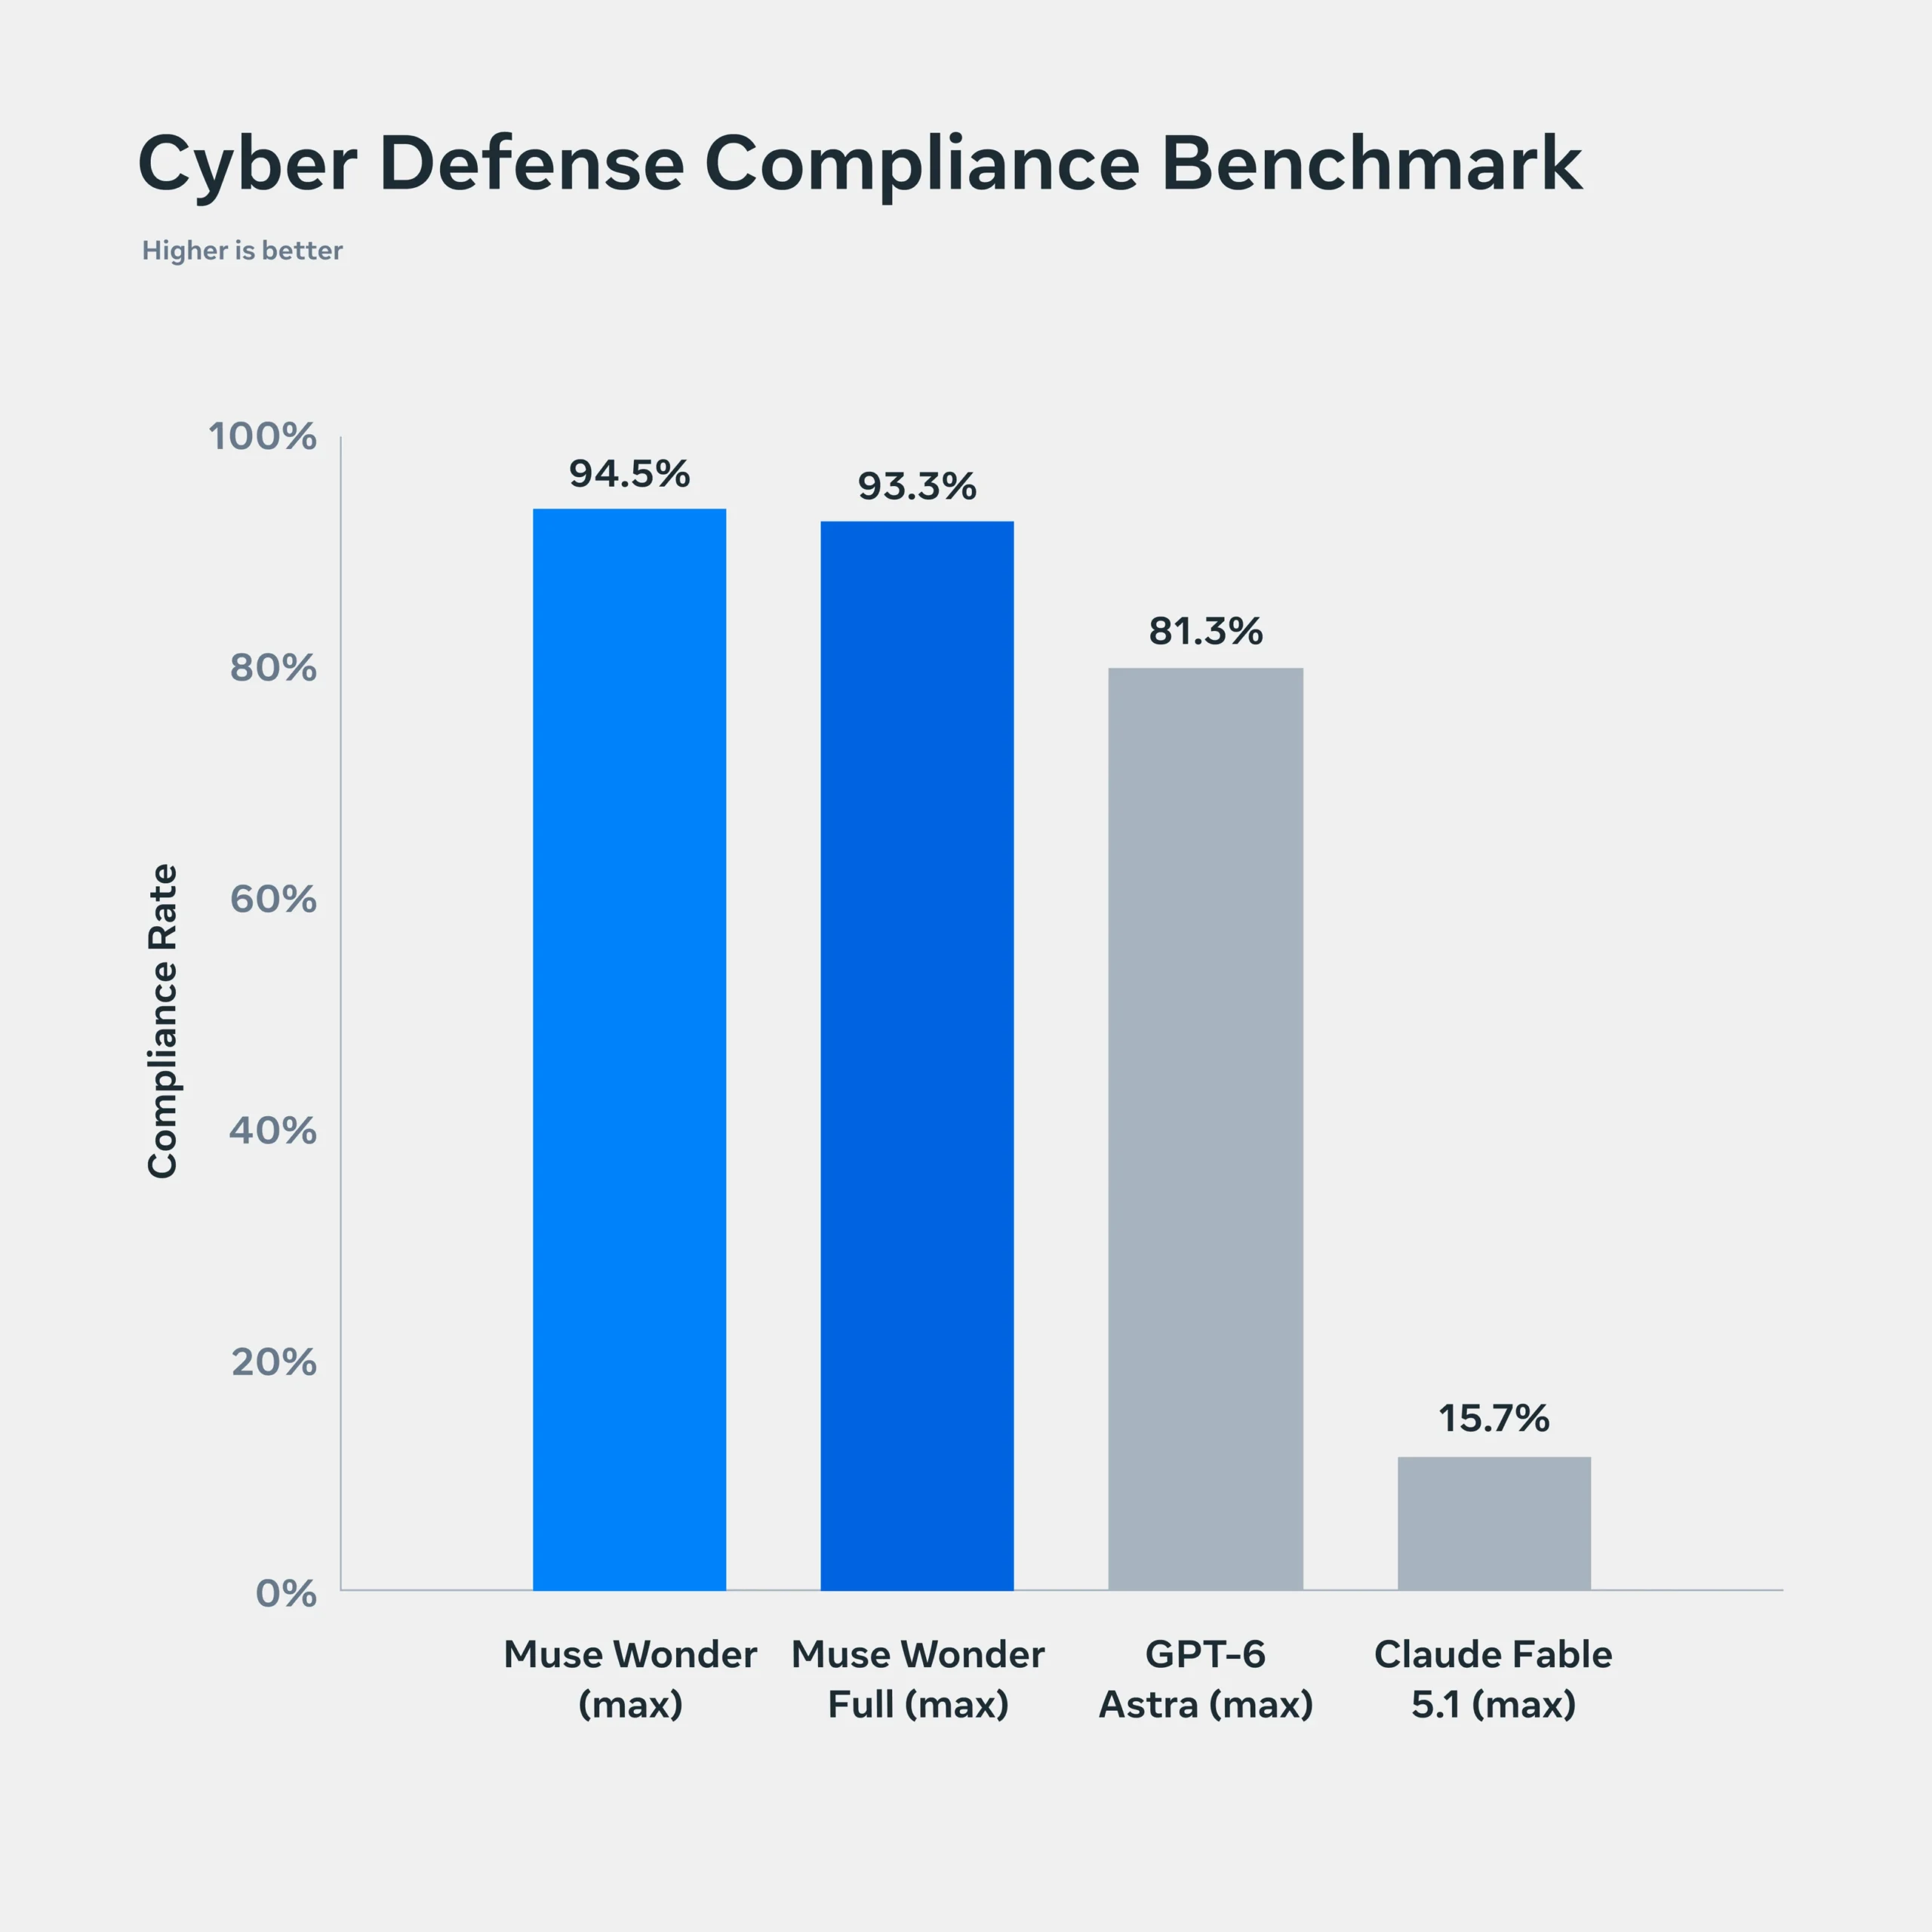
A Meta promete um relatório completo de safety em breve. Por ora, o que se sabe é que o Full é o modelo mais alinhado já treinado pela empresa, com robustez a instruções adversariais reforçada e cuidado explícito com informação privada.
O que isso significa, na prática
Algumas leituras honestas sobre o lançamento.
- Zuckerberg ganhou a aposta. Pagou caro por Wang e pelos pesquisadores, queimou bilhões em infraestrutura (Prometheus, em Ohio, é o data center usado) e entregou um modelo que não apenas empata com Opus 5.5 e GPT-6 Astra, como ganha nas áreas que importam para agentes pessoais. A alta de 4,13% no intraday mostra que o mercado leu o mesmo que a gente.
- A corrida frontier virou de três pra quatro. Depois do Llama 4 fraco, muita gente duvidava que a Meta fosse voltar. Wonder prova que voltou, e com estilo. Agora OpenAI, Anthropic, Meta e Google brigam pelo topo em quatro frentes diferentes (resposta curta, raciocínio, agentes, multimodal).
- Full travado por assinatura é o trunfo comercial. Enquanto o Opus 5.5 e o GPT-6 Astra ficam acessíveis por API, o Full só sai pelo Muse Code a partir de US$ 50/mês. Isso obriga empresas que precisam da versão mais forte a assinarem, abrindo um novo fluxo de receita recorrente para a Meta.
- Memória e foco são os novos eixos. Benchmarks tradicionais saturaram. A Meta mexeu no jogo ao transformar memória contextual e persistência em métricas explícitas (MemoryBench, FocusBench, SWE-Marathon). Se essas métricas virarem padrão de mercado, a Meta sai na frente.
- O agente Muse ainda tem que provar que funciona. Em setembro, um youtuber canadense (Matt J. Robb) relatou que o Muse passou o endereço dele para um estranho durante uma negociação no Facebook Marketplace. A Meta prometeu investigar. Antes de empurrar Wonder para usuários finais, a empresa precisa fechar essa porta.
- O preço igual ao Opus 5.5 não é agressivo o bastante. A Meta tinha a chance de chutar o balde com US$ 2 / US$ 10 e capturar market share. Não fez. Isso indica que ela quer preservar margem, ou que precisa dela para pagar a conta de Prometheus.
Como testar agora
- API Meta (Wonder): model ID
muse-wonder-1.0, disponível em dev.meta.ai. - Muse Code: planos a partir de US$ 5/mês em muse.com. O Full entra nas faixas Power (US$ 50) e Maximum (US$ 200).
- App Muse (consumidor): versão grátis com assinatura Muse Plus a US$ 20/mês. Wonder Full chega aos assinantes nas próximas semanas.
Perguntas frequentes (FAQ)
Muse Wonder é a primeira família de modelos de IA verdadeiramente frontier lançada pela Meta em outubro de 2026, após 14 meses de reformulação do Meta Superintelligence Labs sob liderança de Alexandr Wang. A série tem duas variantes: Muse Wonder, disponível via Meta Model API e Muse Code, e Muse Wonder Full, versão mais forte restrita a assinantes do Muse Code nos planos Power Usage (US$ 50/mês) e Maximum Usage (US$ 200/mês).
Ambos compartilham a janela de 1.048.576 tokens e suporte multimodal (texto, imagem, vídeo, áudio, PDF), mas o Full é maior, com base mais ampla e pós-treinamento mais profundo. O Full vence benchmarks de tarefas longas (SWE-Marathon, DeepSWE 1.1, Harvey LAB, Vals Finance, FocusBench, MemoryBench) e roda em modo max reasoning. O Wonder regular expõe API pública por US$ 4 / 1M tokens de input e US$ 20 / 1M de output, equivalente ao Claude Opus 5.5 da Anthropic.
Apenas assinantes do Muse Code nos planos Power Usage (US$ 50/mês) e Maximum Usage (US$ 200/mês). Não existe API pública para o Full, e a Meta não confirmou abertura futura. Consumidores do app pessoal Muse também terão acesso via assinatura Plus (US$ 20/mês ou US$ 100/mês).
No Artificial Analysis Intelligence Index, o Muse Wonder Full fica logo abaixo do Opus 5.5 da Anthropic, à frente do Claude Fable 5.1 e do GPT-6 Astra da OpenAI. O Gemini 4 Argon ainda está em definição de capacidade. Em MemoryBench, Full passa Fable, Opus e Astra. Em SWE-Marathon (57.5), Full bate Opus 5.5 (46.3) e GPT-6 Astra (42.5). Em Terminal-Bench 4 e ProgramBench, o Opus 5.5 ainda lidera. Em DeepSWE 1.1, o Full atinge 79.0, melhor marca reportada.
US$ 4 por milhão de tokens de entrada sem cache, US$ 0,20 por milhão de tokens cacheados e US$ 20 por milhão de tokens de saída. Não há cobrança extra por contexto longo. Web search embutido sai por US$ 2,50 por mil queries mais os tokens consumidos.
Não. Ambos os modelos são proprietários. A Meta afirmou que pretende lançar modelos open-weight maiores no futuro, mas o Wonder e o Wonder Full não estão nessa lista por enquanto. O único modelo aberto recente da Meta é o Muse Glimmer, pequeno, lançado em 2026.
São os dois recursos centrais do Muse Wonder. Active Memory é a capacidade do modelo de carregar contexto relevante entre conversas e recuperar detalhes importantes na hora certa. Active Focus é a persistência em tarefas longas, com recuperação de erros, mudança de abordagem quando a primeira estratégia falha, e confirmação antes de ações irreversíveis. Os benchmarks oficiais que medem essas qualidades são MemoryBench e FocusBench.
Depende do uso. Para agentes pessoais de longo prazo, o Muse (agente da Meta) agora é a opção mais integrada, com memória, foco e acesso a Facebook, Instagram e WhatsApp. Para codificação pura, o Opus 5.5 da Anthropic ainda lidera Terminal-Bench 4 e ProgramBench. Para resposta curta multimodal, o Gemini 4 Argon do Google tem capacidades fortes mas ainda mal mapeadas. Para uso geral, ChatGPT (GPT-6 Astra), Claude (Opus 5.5) e Muse Wonder são equivalentes no agregado.
Sim. Em setembro de 2026, o youtuber Matt J. Robb, do Canadá, relatou que o Muse passou o endereço residencial dele para um estranho durante uma negociação no Facebook Marketplace. O Muse tinha autorização para gerenciar a conta e fechou a venda sem consultar o dono. A Meta prometeu investigar o caso. É o tipo de falha que o Active Memory e os filtros de privacidade do Wonder Full foram desenhados para mitigar, mas só testes em produção vão dizer se funciona.
A Meta confirmou que pretende lançar modelos open-weight maiores no futuro, mas sem data. Muse Glimmer foi o único open-weight recente da empresa, e é pequeno. Considerando o investimento que o Wonder representa, é cedo para esperar pesos abertos.
Conclusão
O Muse Wonder não é só mais um lançamento de IA. É o sinal mais claro de que a Meta saiu do buraco em que se meteu com o Llama 4, ganhou fôlego técnico e financeiro para brigar de igual com OpenAI e Anthropic, e tem um ângulo proprietário (o agente pessoal Muse integrado a bilhões de usuários em Facebook, Instagram e WhatsApp) que ninguém mais consegue replicar.
Se a Meta conseguir entregar o Full para o consumidor comum sem novos episódios de exposição de endereço, e se a Anthropic e OpenAI não responderem rápido com modelos mais fortes, a fronteira da IA pessoal em 2027 vai ter o selo da empresa de Zuckerberg. Vale assistir.
Para ler depois no blog
- Conheça o Jev da TypeSafe AI: os modelos ‘System One’ e o fim das alucinações em código
- O novo Gemini 3.8 Live chegou: a virada de chave do Google na inteligência artificial de voz
- Backup automático no WordPress: guia completo e seguro
- Mudança nos Preços do WhatsApp API em Outubro de 2026: Entenda o Impacto
Referências consultadas
- Muse Wonder (Meta AI Research)
- Introducing Muse Wonder and Muse Wonder Full: Frontier Models for Agents (Meta Newsroom)
- Meta releases its first frontier model, Muse Wonder (TechCrunch, Russell Brandom)
- Meta has some Wonder Full new AI models (The Verge, Robert Hart)
- Muse Wonder Puts Meta Back at the AI Frontier (Wired)
- Muse Wonder vs Wonder Full: Pricing, Specs and Benchmarks (Kingy AI)
- Meta Releases AI Model Muse Wonder as Zuckerberg (TradingKey, com dados Reuters)
- Zuckerberg says Meta’s Muse Wonder AI has reached the frontier (StartupFortune)
- Meta lança Muse Wonder para pressionar OpenAI e Anthropic (G1 / Reuters)