
Em 12 de novembro de 2026 o Google lançou o Gemini 4 Hydrogen, o modelo que finalmente tira o Gemini 4 do acesso restrito e entrega um ponto de intelligence index a US$ 1,50 por milhão de tokens de entrada. É o primeiro Gemini 4 liberado para todo mundo, em todos os planos do Google AI Studio, na Gemini API, no Gemini for business, no app Gemini, na Busca do Google e no Google Antigravity. No nível de raciocínio padrão, ele marca 51 pontos no Artificial Analysis Intelligence Index, passando o Gemini 4 Argon, que tinha 50, e chegando a 54 no novo nível xhigh, a um terço do custo por tarefa do Claude Sonnet 5.5.
Mas o número que importa de verdade está no rodapé dos gráficos do Google: o Hydrogen é 2,5 vezes mais rápido que o Gemini 3.8 Flash, corta afirmações inventadas em mais de 5 vezes e triplica a nota no Terminal-Bench 4.1, indo de 18,2% para 57%. E não é um modelo novo: o model card diz que ele é adaptado do Gemini 4 Carbon, a mesma espinha dorsal, com pós-treinamento orientado a execução rápida em vez de raciocínio de horizonte longo.
Este conteúdo tem caráter informativo. Decisões técnicas devem ser tomadas com profissional especializado.
O que é o Gemini 4 Hydrogen
Gemini 4 Hydrogen é a variante de execução rápida da família Gemini 4, desenhada para o trabalho diário de código e agentes, não para o problema mais difícil que você tem. O Google separa as duas coisas de forma explícita: Carbon e Argon são para raciocínio de horizonte longo nos seus problemas mais difíceis, o Hydrogen é para iteração rápida em múltiplos fluxos de trabalho agentivos. É a mesma lógica que separou o Claude Opus do Sonnet e o GPT-5 do GPT-5 mini, mas com o Google finalmente placing um Gemini 4 inteiro nas mãos de qualquer um.
O detalhe técnico mais importante está no model card: Hydrogen é adaptado do Gemini 4 Carbon. Isso significa a mesma arquitetura, a mesma janela unificada de 1 milhão de tokens e os mesmos tipos de entrada e saída: texto, imagem, áudio e vídeo na entrada, texto na saída, com até 64 mil tokens de saída síncrona por padrão e até 1 milhão via background long decode. Não é um modelo novo do zero, é o Carbon com o objetivo trocado.
Isso tem uma consequência prática que quase ninguém comenta: como é o mesmo modelo base, tudo que você aprendeu sobre a família Gemini 4 continua válido. A mesma janela de 1 milhão de tokens, o mesmo sistema de tools, os mesmos limites de sampling, o mesmo tratamento de thinking level. Para quem já integra o Carbon ou o Argon, migrar para o Hydrogen não muda o contrato da API, muda o preço e a latência.
Preço: US$ 1,50 de entrada, US$ 7,50 de saída
Uma das coisas mais agressivas do anúncio: o preço é plano em toda a janela de 1 milhão de tokens. Não existe tier de contexto mais caro, não existe faixa que muda de preço no meio do prompt. São US$ 1,50 por milhão de tokens de entrada e US$ 7,50 por milhão de tokens de saída, com entrada em cache a 95% de desconto, o que dá US$ 0,075 por milhão.
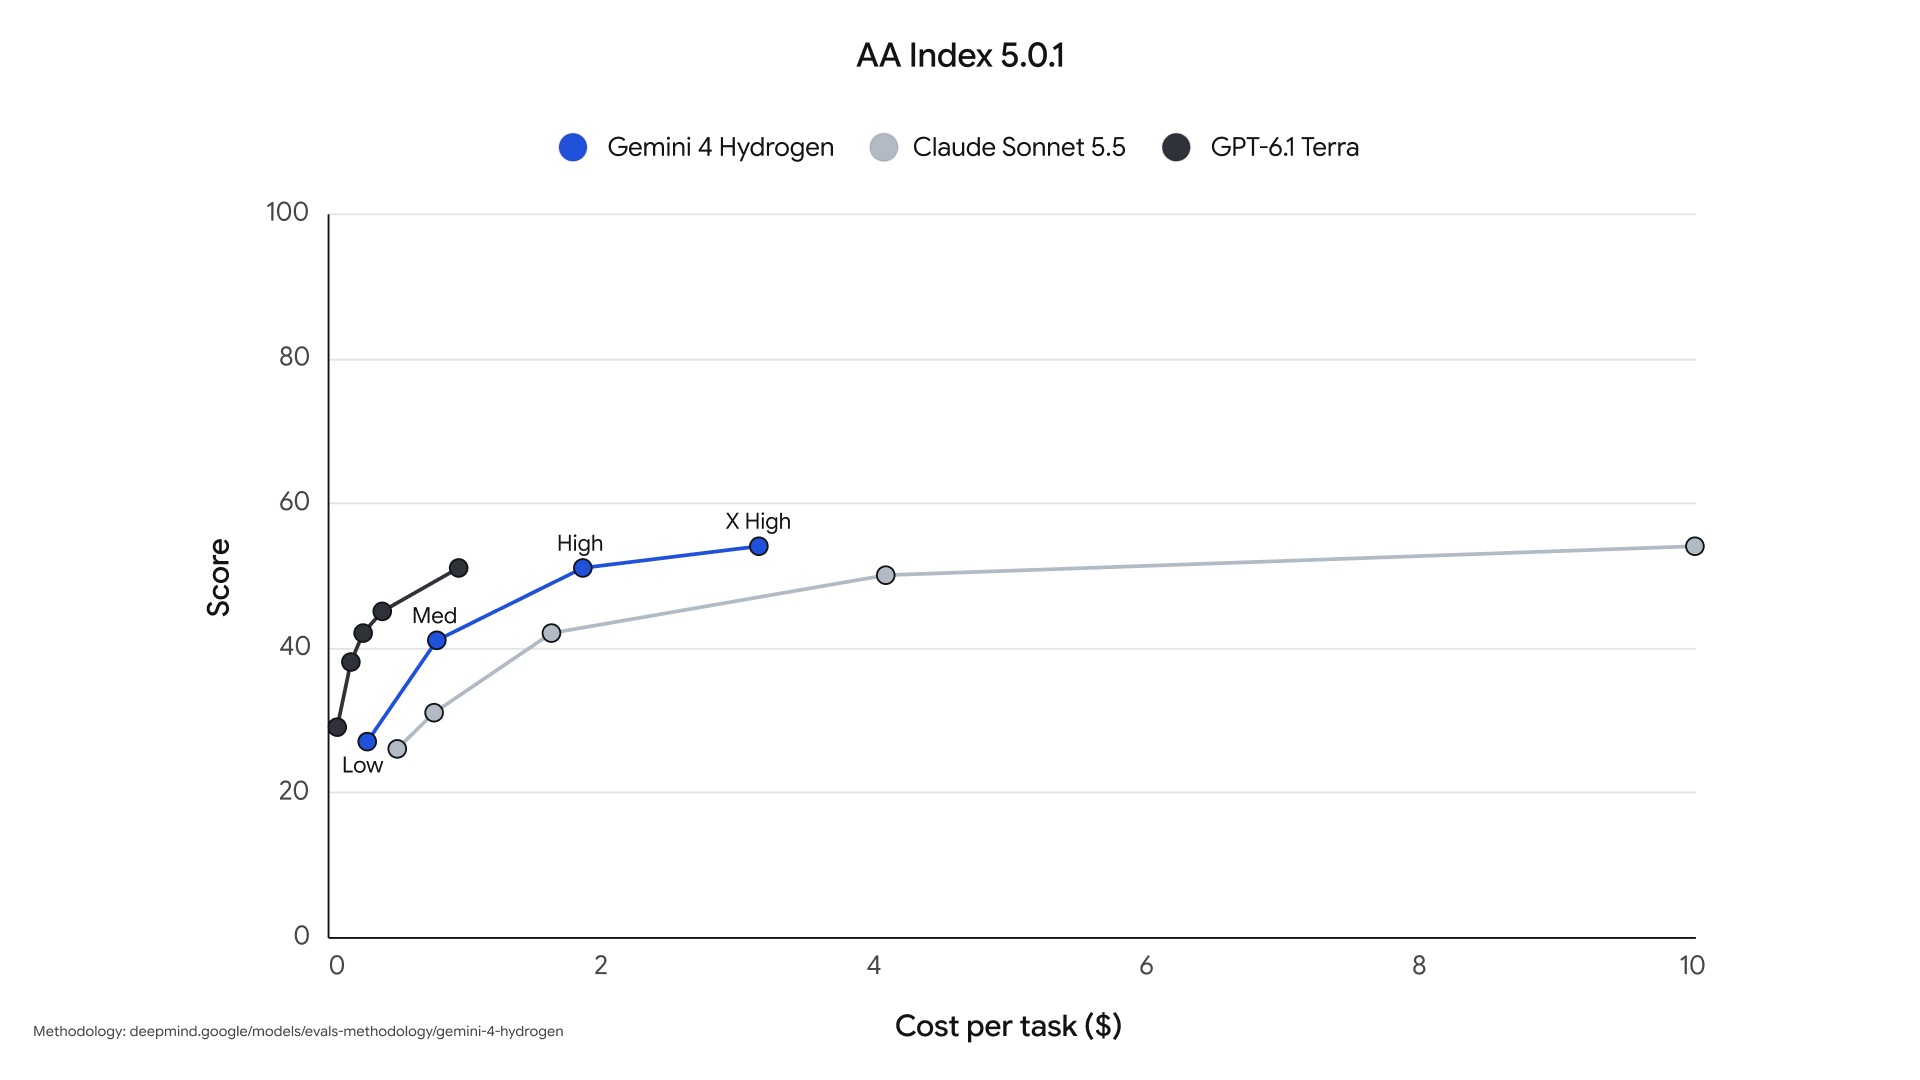
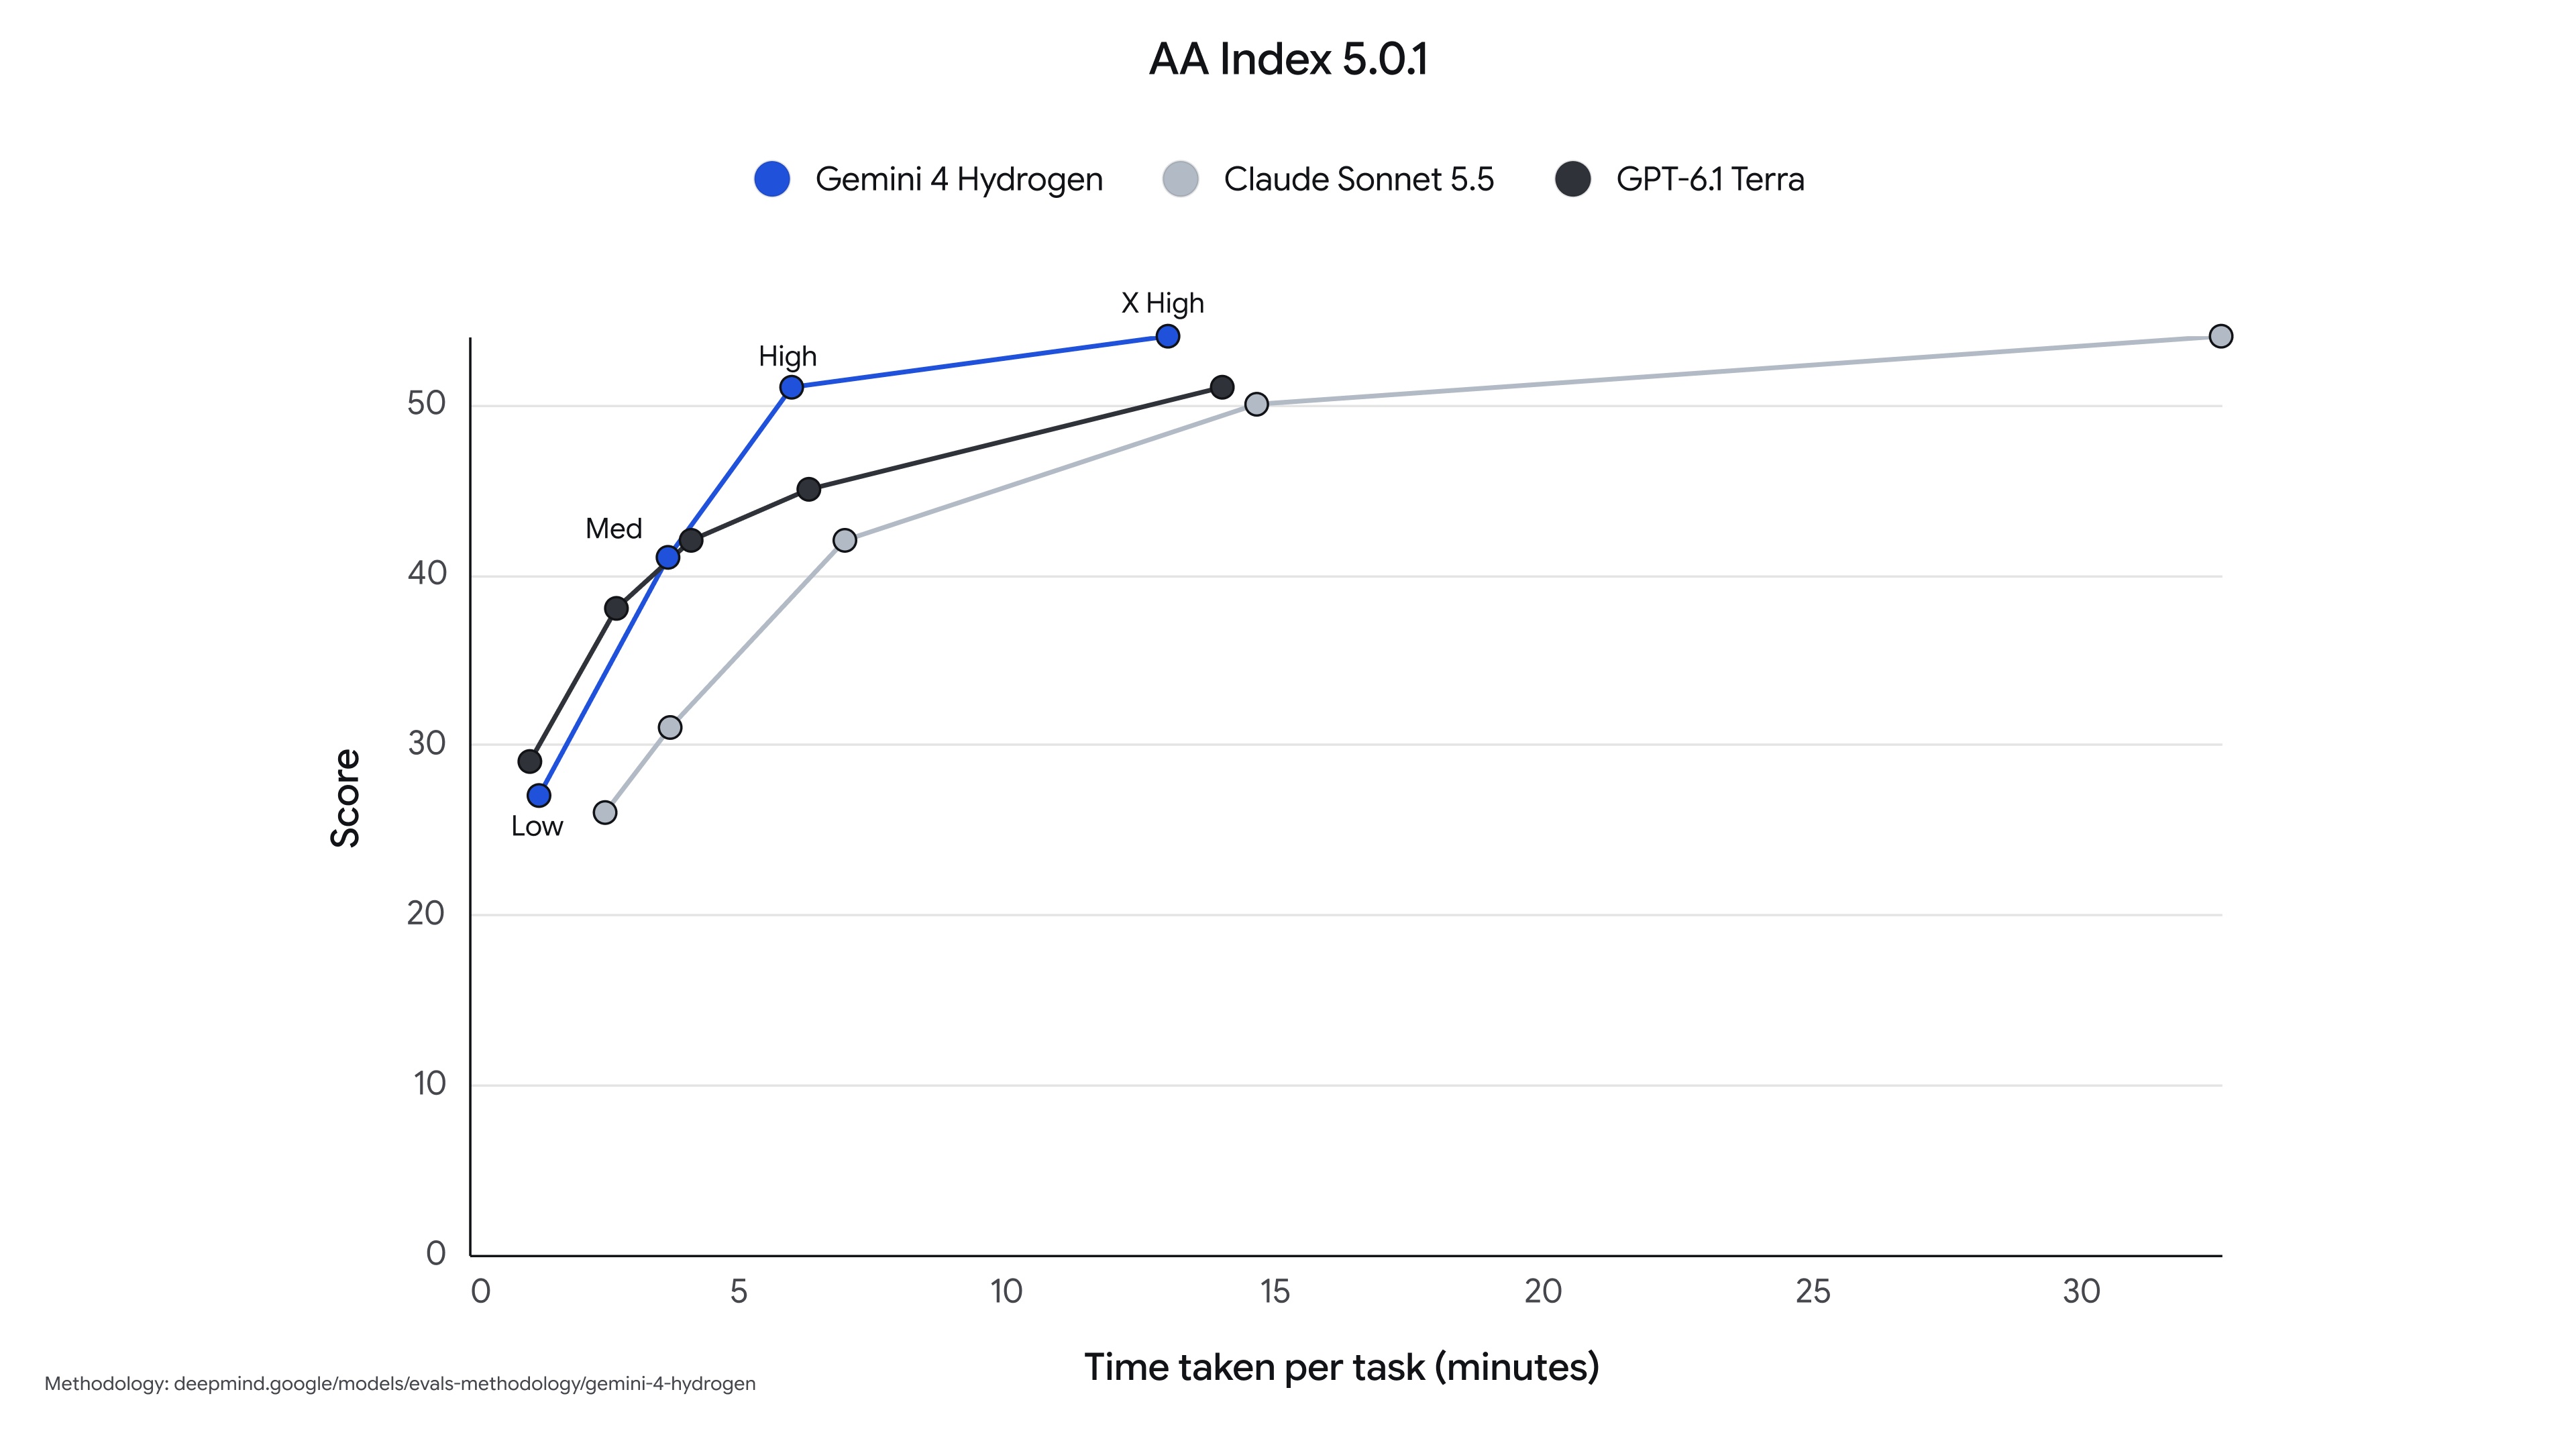
Para comparar: o Claude Sonnet 5.5 está a US$ 2 e US$ 10, o GPT-6.1 Terra a US$ 1 e US$ 5, e o Gemini 4 Carbon a US$ 4 e US$ 20 no preço de dezembro. O Hydrogen é 25% mais barato que o Sonnet na lista, mas a diferença real aparece no custo por tarefa, porque o Sonnt 5.5 é um consumidor pesado de tokens. No Artificial Analysis, o Hydrogen em xhigh custa cerca de US$ 3,16 por tarefa contra US$ 10,02 do Sonnet, para uma inteligência praticamente igual.
| Modelo | AA Index | Custo por tarefa | Tempo por tarefa | Entrada | Saída |
|---|---|---|---|---|---|
| Gemini 4 Hydrogen (xhigh) | 54 | US$ 3,16 | 13,5 min | US$ 1,50/M | US$ 7,50/M |
| Gemini 4 Hydrogen (high, padrão) | 51 | US$ 1,87 | 8,3 min | US$ 1,50/M | US$ 7,50/M |
| Gemini 4 Hydrogen (medium) | 41 | US$ 0,80 | 3,7 min | US$ 1,50/M | US$ 7,50/M |
| Gemini 4 Hydrogen (low) | 27 | US$ 0,29 | 1,3 min | US$ 1,50/M | US$ 7,50/M |
| Claude Sonnet 5.5 (max) | 55 | US$ 10,02 | 33,0 min | US$ 2/M | US$ 10/M |
| GPT-6.1 Terra (max) | 51 | US$ 0,96 | 14,2 min | US$ 1/M | US$ 5/M |
| Gemini 4 Argon (high) | 50 | US$ 4,97 | 30,1 min | n/d | n/d |
| Gemini 3.8 Flash (high) | 31 | US$ 7,77 | 14,8 min | n/d | n/d |
Repare no contraste do meio da tabela. O Hydrogen em high entrega o mesmo score do GPT-6.1 Terra no máximo, mas custa quase o dobro por tarefa. Contra o Sonnet, o mesmo nível entrega 51 contra 55 pontos por um terço do preço. E contra o Gemini 3.8 Flash, que era o modelo indicado para trabalho rápido até ontem, o salto é de 31 para 51 pontos.
Os quatro níveis de thinking, e o motivo do xhigh
O Hydrogen tem quatro níveis de raciocínio: low, medium, high (padrão) e o novo xhigh. O xhigh é a primeira vez que um modelo Gemini sobe um degrau acima do high. O Google apresenta isso como uma escala contínua: você paga e espera só a profundidade de raciocínio que a tarefa exige.
A escala é real e o custo é previsível. Do low ao medium, o score sobe de 27 para 41 e o custo por tarefa cai de US$ 0,29 para US$ 0,80. Do medium ao high, o score vai a 51 e o custo a US$ 1,87. Do high ao xhigh, são 54 pontos a US$ 3,16, com 13,5 minutos por tarefa em vez de 8,3.
É aqui que está a inteligência de custo do anúncio. Subir para xhigh quase dobra os tokens de saída do high para ganhar três pontos, e na prática o time certo quase nunca é o topo da curva. A Artificial Analysis resume: no nível default, o Hydrogen entrega inteligência de Argon a cerca de 19% do custo por tarefa. Para a maioria das cargas de trabalho isso é a conta certa.
Benchmarks: onde ele ganha e onde ele apanha
O Google publicou uma tabela comparando o Hydrogen com o Claude Sonnet 5.5 e o GPT-6.1 Terra em dez avaliações. Esses são os números oficiais, com a metodologia no model card.
| Benchmark | Gemini 4 Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra |
|---|---|---|---|
| SWE-sweep | 13,5% | 3,1% | 5,8% |
| Terminal-Bench 4.1 (ajustado a trapaça) | 57,0% | 63,9% | n/d |
| Agents’ Last Exam v1.1 | 71,6% | 60,4% | 69,8% |
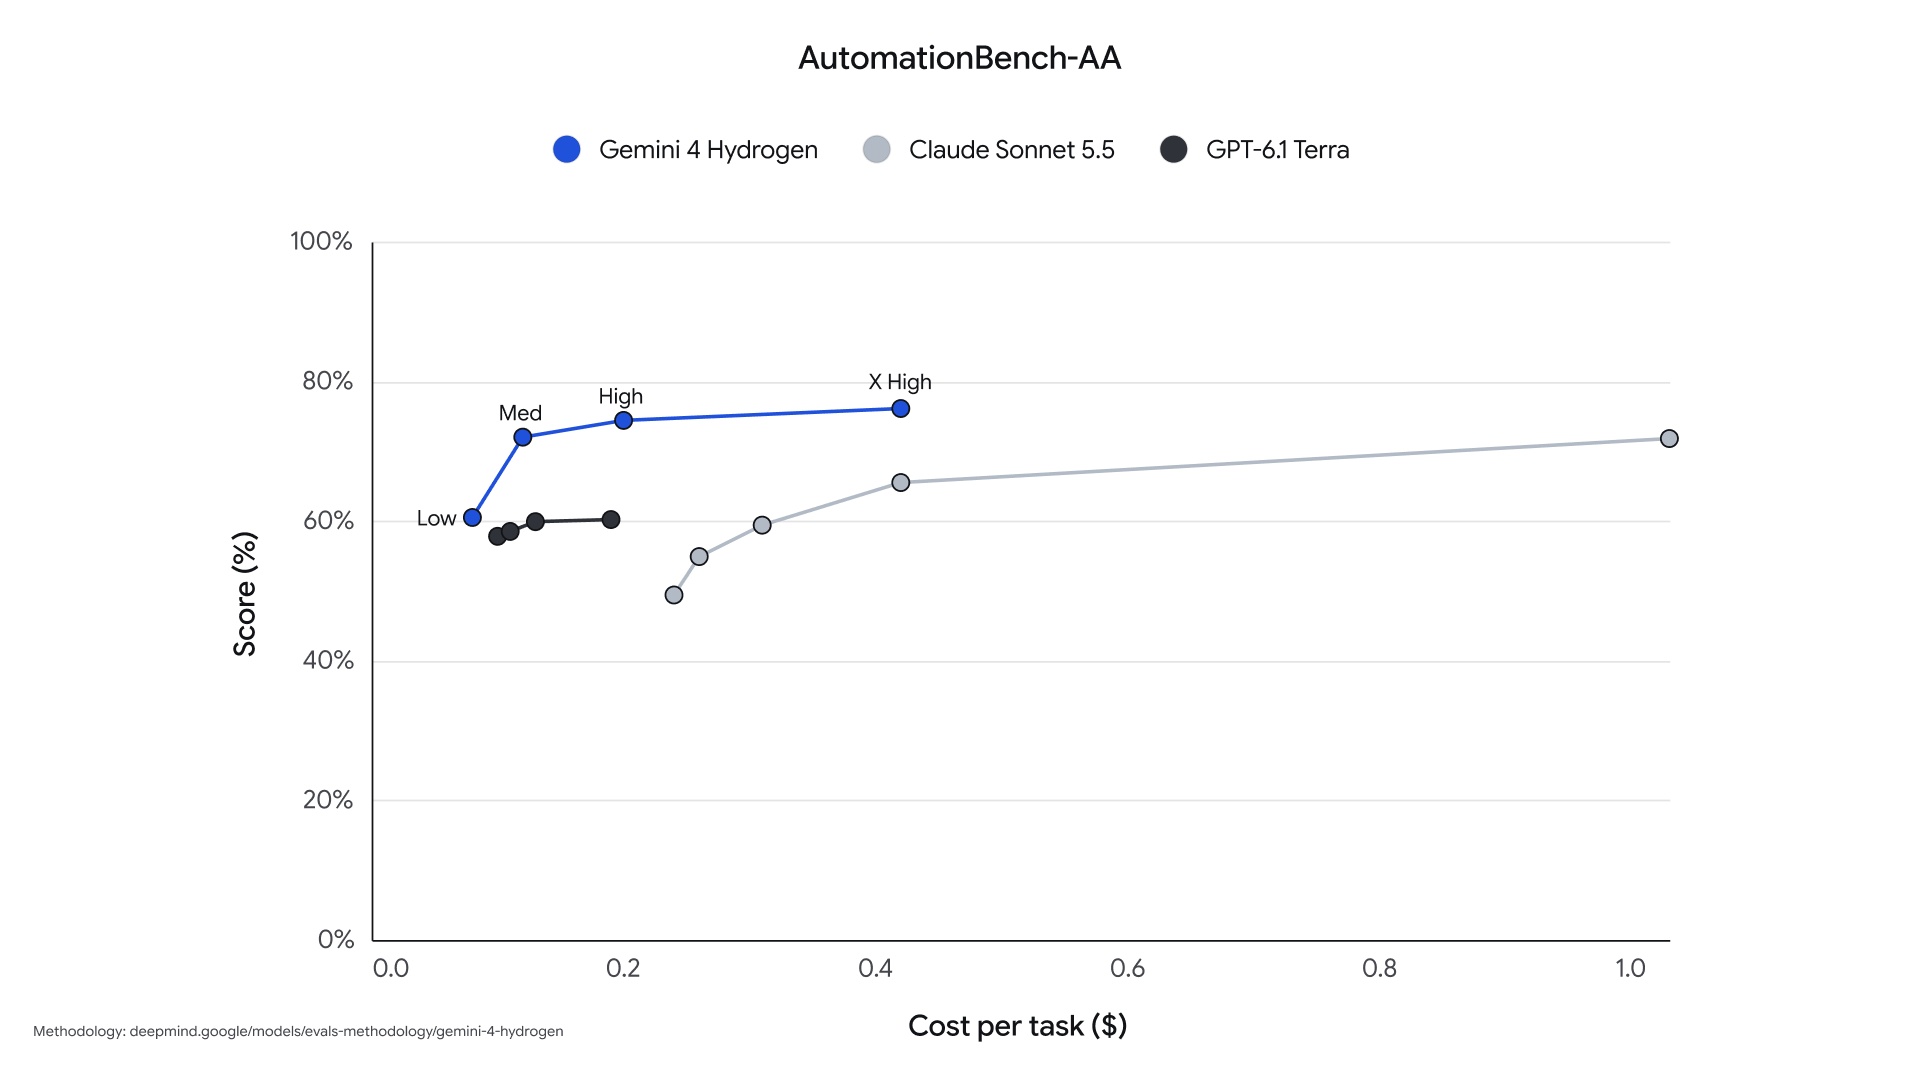
| AutomationBench-AA | 76,1% | 71,8% | 60,2% |
| Vending-Bench 2 (saldo em US$) | US$ 14.549 | US$ 11.165 | US$ 9.107 |
| OSWorld-2.1 (subset offline) | 77,6% | 83,9% | 74,2% |
| MKA (Climb WSR accuracy) | 53,4% | 52,0% | 43,8% |
| Chartography | 66,6% | 61,6% | 63,2% |
| Terminal-Bench-Science 0.1 | 51,4% | 59,9% | 58,3% |
| HLE-Diamond | 58,8% | 53,3% | 47,3% |
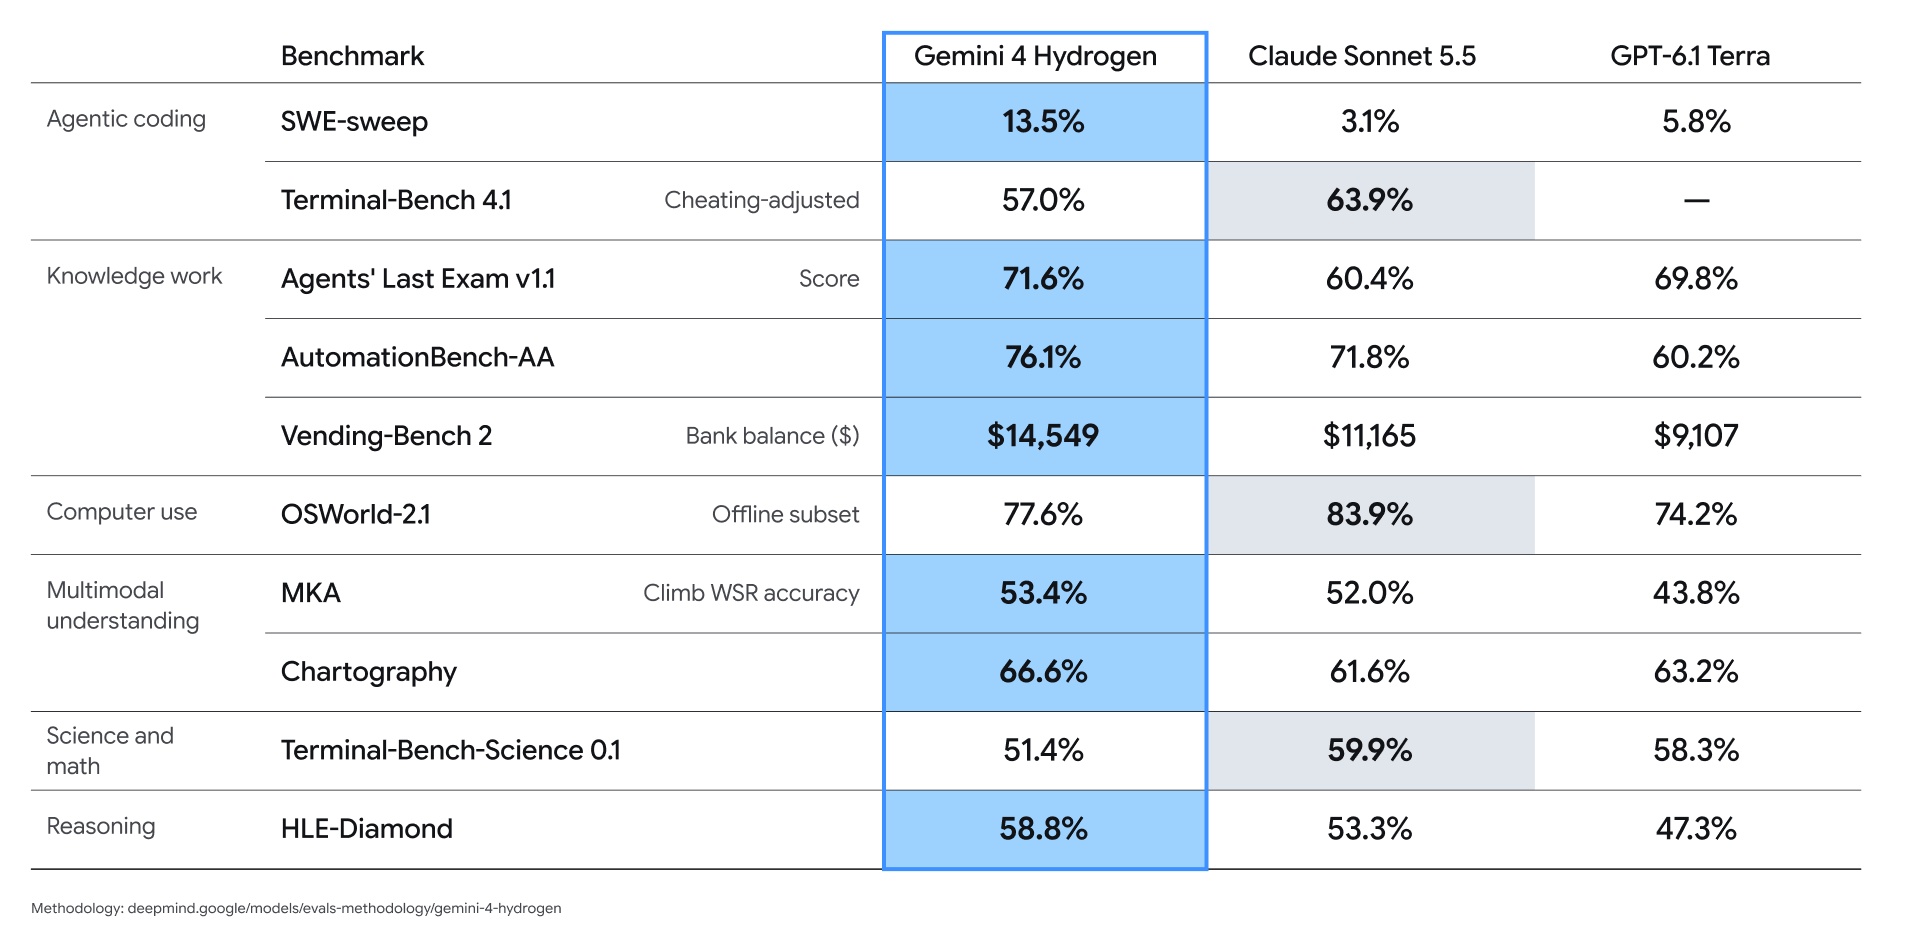
O destaque de longe é o SWE-sweep. Essa avaliação exige que o modelo encontre e corrija bugs sem quebrar o código existente, e o Hydrogen marca 13,5% contra 3,1% do Sonnet 5.5 e 5,8% do Terra. Mais que quatro vezes o Sonnet. É a prova mais concreta de que o póst-treinamento orientado a execução rápida mudou o comportamento do modelo em código, e não só a velocidade.
Em trabalho de conhecimento, o Hydrogen lidera os três benchmarks da categoria, com destaque para o Vending-Bench 2, onde um modelo roda um negócio simulado e tenta lucrar: US$ 14.549 de saldo contra US$ 11.165 do Sonnet e US$ 9.107 do Terra. Mais de US$ 3.400 de vantagem sobre o Claude em uma simulação que mede inicialização e decisão de negócio ao longo do tempo.
Onde o Hydrogen perde
Um post honesto precisa contar onde o modelo apanha, e são três pontos.
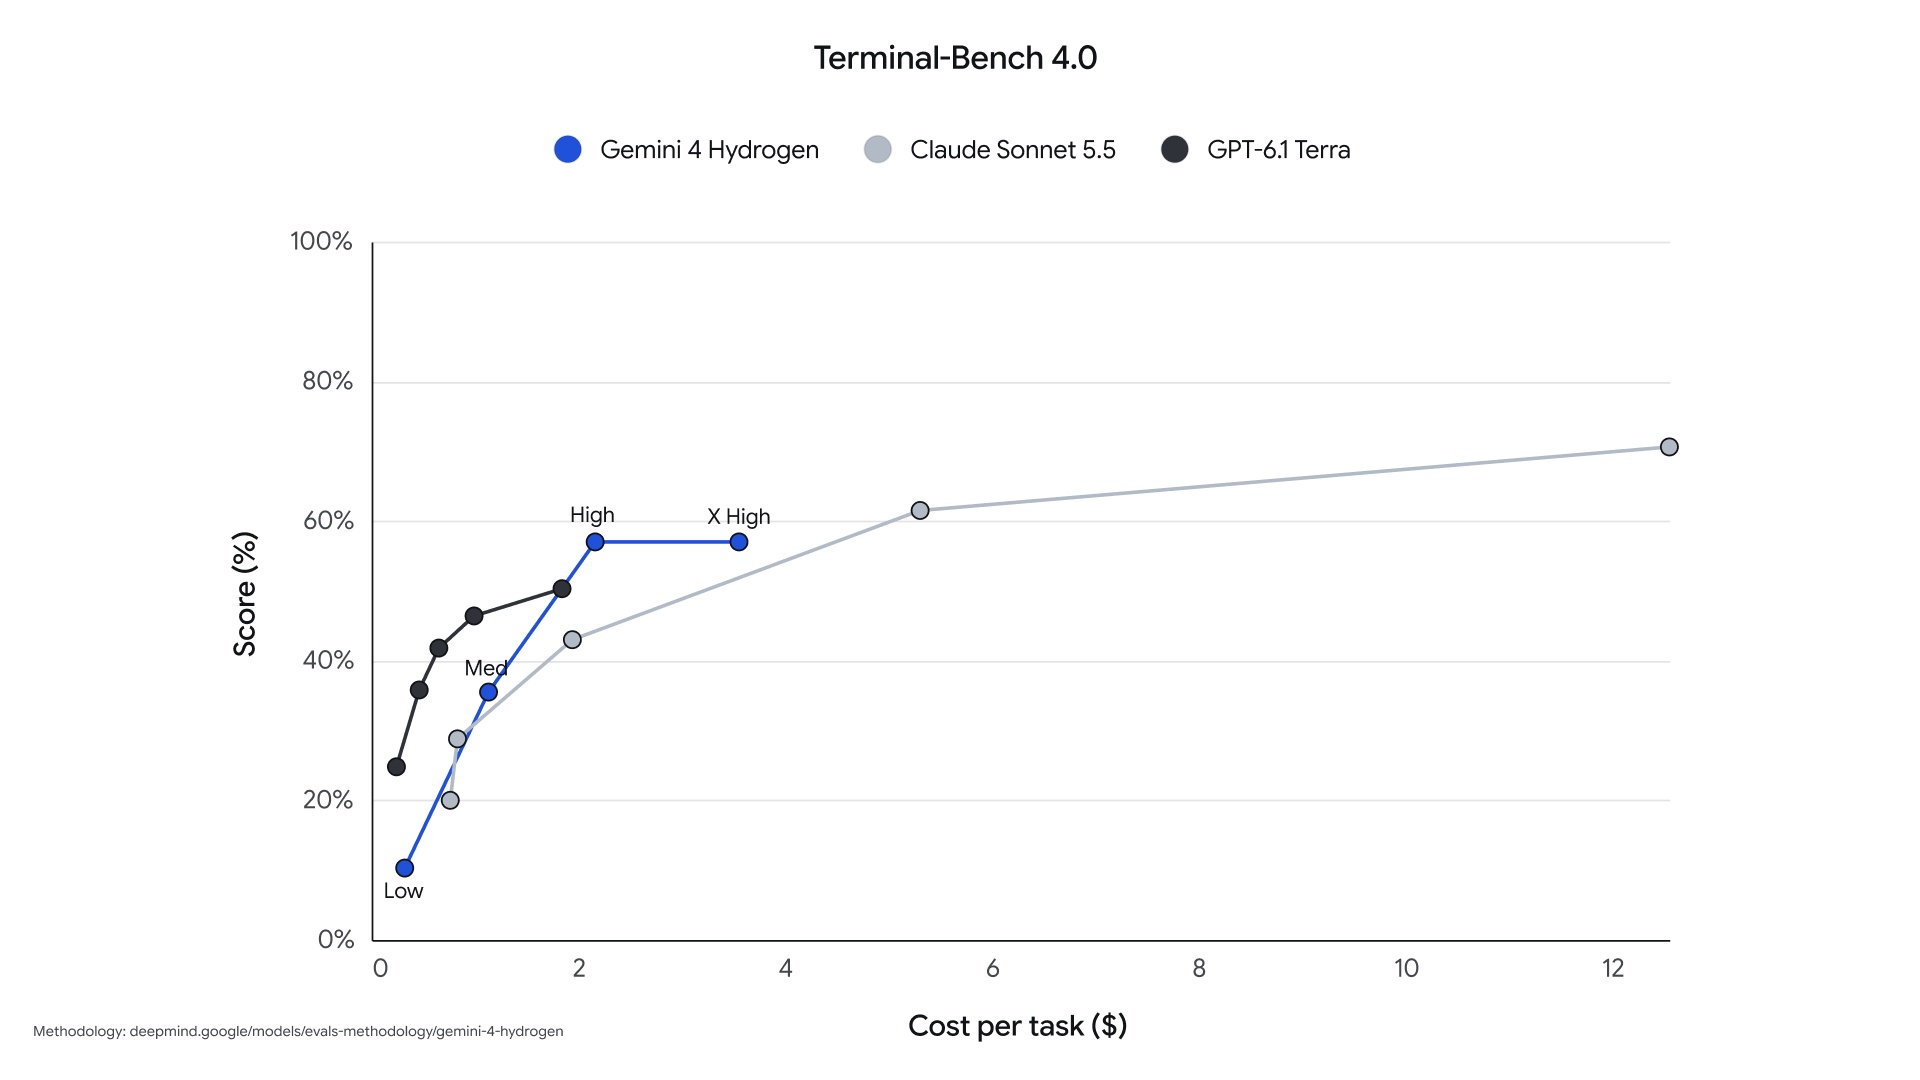
Terminal é o calcanhar de Aquiles. No Terminal-Bench 4.1 ajustado a trapaça, o Hydrogen marca 57,0% contra 63,9% do Sonnet 5.5. E no Terminal-Bench-Science 0.1, são 51,4% contra 59,9%. A Artificial Analysis confirma o padrão com Terminal-Bench 4.0: 54% do Hydrogen contra 64% do Sonnet 5.5 no máximo e 56% do GPT-6.1 Sol. Isso aparece também no Terminal-Bench-Science, 50% contra 53% do Sonnet. Em tarefas de terminal puro, o Carbon ainda ganha.
OSWorld, uso de computador, também fica atrás do Claude. No subset offline do OSWorld-2.1, são 77,6% do Hydrogen contra 83,9% do Sonnet 5.5. O modelo que lidera o resto da tabela de trabalho de conhecimento empurra o Google nesse ponto.
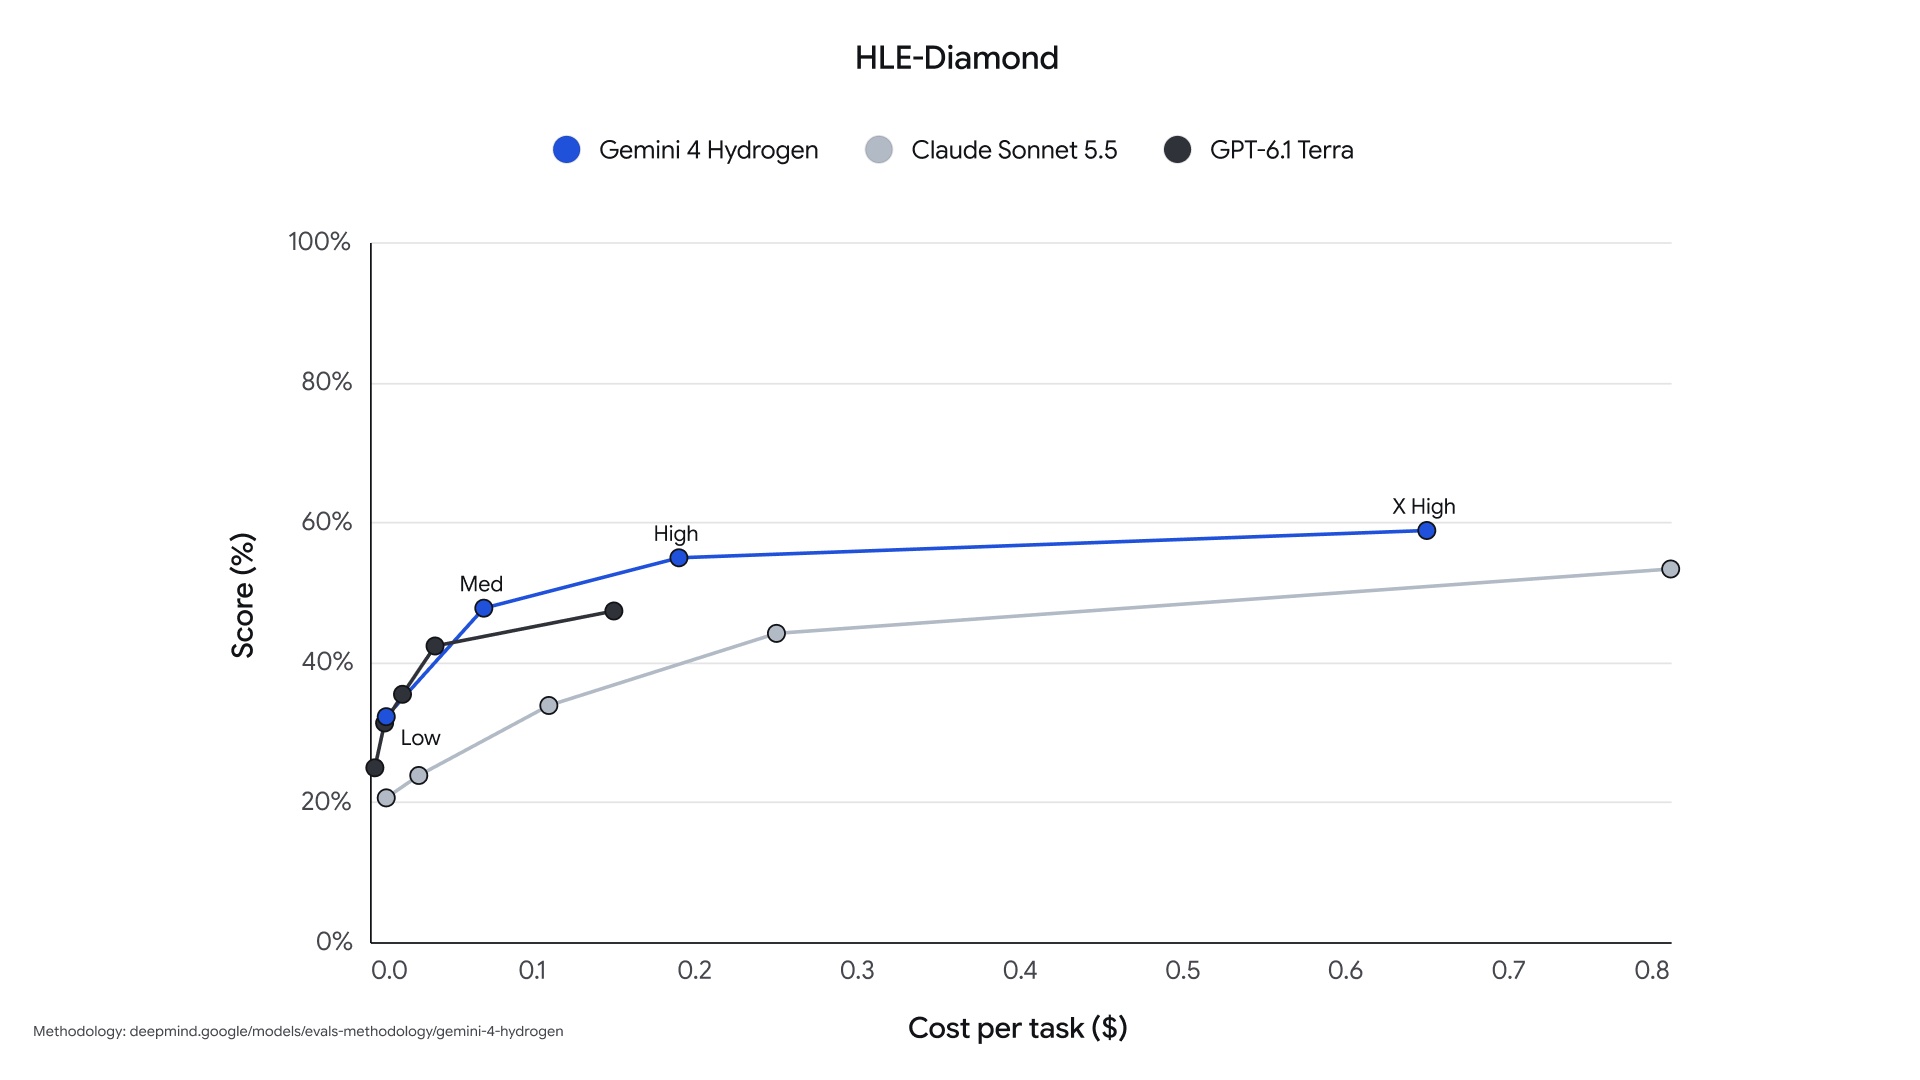
E o HLE-Diamond não é o que o Argon entregou. O Carbon fez 69,1% no HLE-Diamond e liderou o ranking. O Hydrogen, sendo uma adaptação do Carbon com foco em execução, marca 58,8%. Ainda ganha do Sonnet 5.5 por mais de cinco pontos, mas está longe do pai. Se o seu problema é pesquisa profunda, o Hydrogen não é o modelo certo, o Argon ou o Carbon são.
Orchestrator: dois modelos, uma sessão
A parte mais interessante do anúncio não é o modelo, é o Orchestrator, novo no Google Antigravity. Em vez de usar um modelo só do começo ao fim, ele alterna dinamicamente entre Carbon e Hydrogen dentro da mesma sessão.
O Carbon começa numa fase somente leitura, explorando dependências, resolvendo ambiguidades e montando um plano com gatilhos explícitos de replanejamento. Aí o Hydrogen assume, escreve as edições, atualiza pacotes e roda os testes. Se o Hydrogen encontra atrito, devolve a bola para o Carbon, que inspeciona o estado, conserta o plano e retoma a execução.
No Terminal-Bench 4.1, o Orchestrator chegou a taxas de sucesso próximas do Carbon consumindo, em média, 24% menos cota e completando 19% mais rápido. Essa é a tese central do produto: o gargalo de custo em agentes não é o modelo mais inteligente, é o modelo mais inteligente rodando o tempo todo. Com o roteamento dinâmico, o Carbon planeja onde precisa planejar e o Hydrogen executa onde só precisa executar.
Isso derruba o modelo de router estático que a indústria usa hoje. O problema do router estático é obvious: ele adivinha a dificuldade da tarefa pelo primeiro prompt e manda o trabalho inteiro para o modelo mais barato que dá conta. Quando a tarefa tem fases, a dificuldade muda no meio do caminho, e a adivinhação inicial já era errada. O Orchestrator é bidirecional e reavalia durante a trajetória.
Para fluxos que pedem agentes paralelos, o Google sugere outro desenho: Carbon como coordenador, Hydrogen conduzindo os agentes trabalhadores e verificadores, cada um em area de trabalho isolada, construindo e testando em paralelo. Menos tokens queimados em coordenação, mais entrega.
Por que o Google fez isso agora
Um dia depois de lançar o Carbon com acesso restrito ao Programa Fairwind para profissionais de cibersegurança selecionados, o Google abre o Hydrogen para todo mundo. A leitura óbvia é de segmentação de mercado: o Carbon é para os poucos que precisam do raciocínio de horizonte longo e podem esperar o acesso; o Hydrogen é para todo mundo que precisa de velocidade.
Mas a jogada de produto é mais fina. Enquanto o Carbon estava travado em acesso seletivo, a família Gemini 4 tinha um buraco: o único Gemini 4 disponível era o Argon, que é caro e lento para uso diário. O Google estava, na prática, deixando a Search e o app Gemini sem o seu melhor modelo rápido. O Hydrogen preenche esse buraco e, de quebra, cria o Orchestrator, que só faz sentido porque existem dois modelos com perfis complementares.
E o alvo geopolítico é a Europa. No app Gemini, os usuários gratuitos recebem o Hydrogen por seleção automática de modelo quando ele for o mais adequado ao prompt. Usuários pagos de AI Pro e Ultra o têm no dropdown, no Google Antigravity e nas Sheets. É o primeiro Gemini 4 a chegar no usuário que não paga nada, e o primeiro a entrar no Google Search para todo o mundo. Isso não é um lançamento de laboratório, é uma troca de posição na_SEARCH.
As ações que os parceiros relataram
O anúncio traz uma lista longa de empresas que testaram o modelo antes do lançamento. Vale destacar os números, porque são claims de terceiros e não do Google.
| Empresa | Setor | O que relataram |
|---|---|---|
| Box | Enterprise | Precisão bem maior que o 3.8 Flash, cerca de 2 vezes mais rápido e 12% menos tokens |
| STAN | Agentes de voz | 100% de conformidade de formato, latência 28% menor e 23% menos tokens |
| Pixelcut | Design | 276 execuções, varreu todos os briefs, 1,8 vezes mais rápido e 30% de código mais limpo |
| Cartwheel | Ciência de dados | Achou 2 problemas em 10 dias de trabalho com modelos concorrentes |
| Discovery Loop | Ferramentas | Desenvolvimento de ferramentas com iteração leve |
| LatchBio | Biotech | 67% de aprovação contra 37% do melhor modelo não Gemini, 13 min por tarefa |
| Zingroll | Vídeo | Compreensão de vídeo sem alucinar detalhes visuais |
| Astrocade | Jogos | Geração de jogos em games com melhor performance |
O caso da LatchBio é o mais interessante tecnicamente. O Hydrogen foi o modelo mais preciso na seção de toxicologia e segurança do benchmark de desenvolvimento de anticorpos, com 67% de aprovação contra 37% do melhor modelo não Gemini, e o mais rápido da família Gemini, cerca de 13 minutos por tarefa. O relato é de que o modelo raciocinou como revisor de segurança cauteloso, pesando o quadro clínico completo em vez de pontos isolados de dados, e assumindo premissas conservadoras quando o risco do paciente era alto.
A Box e a STAN são os dois casos mais relevantes para quem roda agente em produção. A Box mediu precisão claramente melhor que o 3.8 Flash, rodando cerca de duas vezes mais rápido e usando 12% menos tokens, com os maiores ganhos em fluxos cheios de tabela. A STAN cortou latência de ponta a ponta em 28% e 23% do consumo total de tokens mantendo a precisão, com resolução de problemas de grafo e SQL até 2,8 vezes mais rápido.
Multimodal: PDFs, planilhas e vídeo em um relatório
Além do código, o Hydrogen apareaises em trabalho de conhecimento multimodal. Com entrada nativa de 1 milhão de tokens e saída de até 1 milhão, ele sintetiza PDFs densos, planilhas, gráficos, áudio e vídeo gravado em relatórios citados e entregáveis estruturados.
Os números oficiais: 53,4% no benchmark Multimodal Knowledge Agent, que é novo e mede trabalho agentivo de ponta a ponta sobre arquivos visuais complexos, e 71,6% no Agents’ Last Exam v1.1, sobre fluxos de trabalho profissionais de ponta a ponta. No Agents’ Last Exam o Hydrogen passa o GPT-6.1 Terra, que marca 69,8%.
Na prática, dentro do app Gemini
O Google liberou o Hydrogen dentro do app Gemini para todo mundo, com as telas do seletor de modelo comparando o resultado do Gemini 3.5 Flash com o do Gemini 4 Hydrogen lado a lado. São três exemplos de tarefa que mudaram de forma visível.
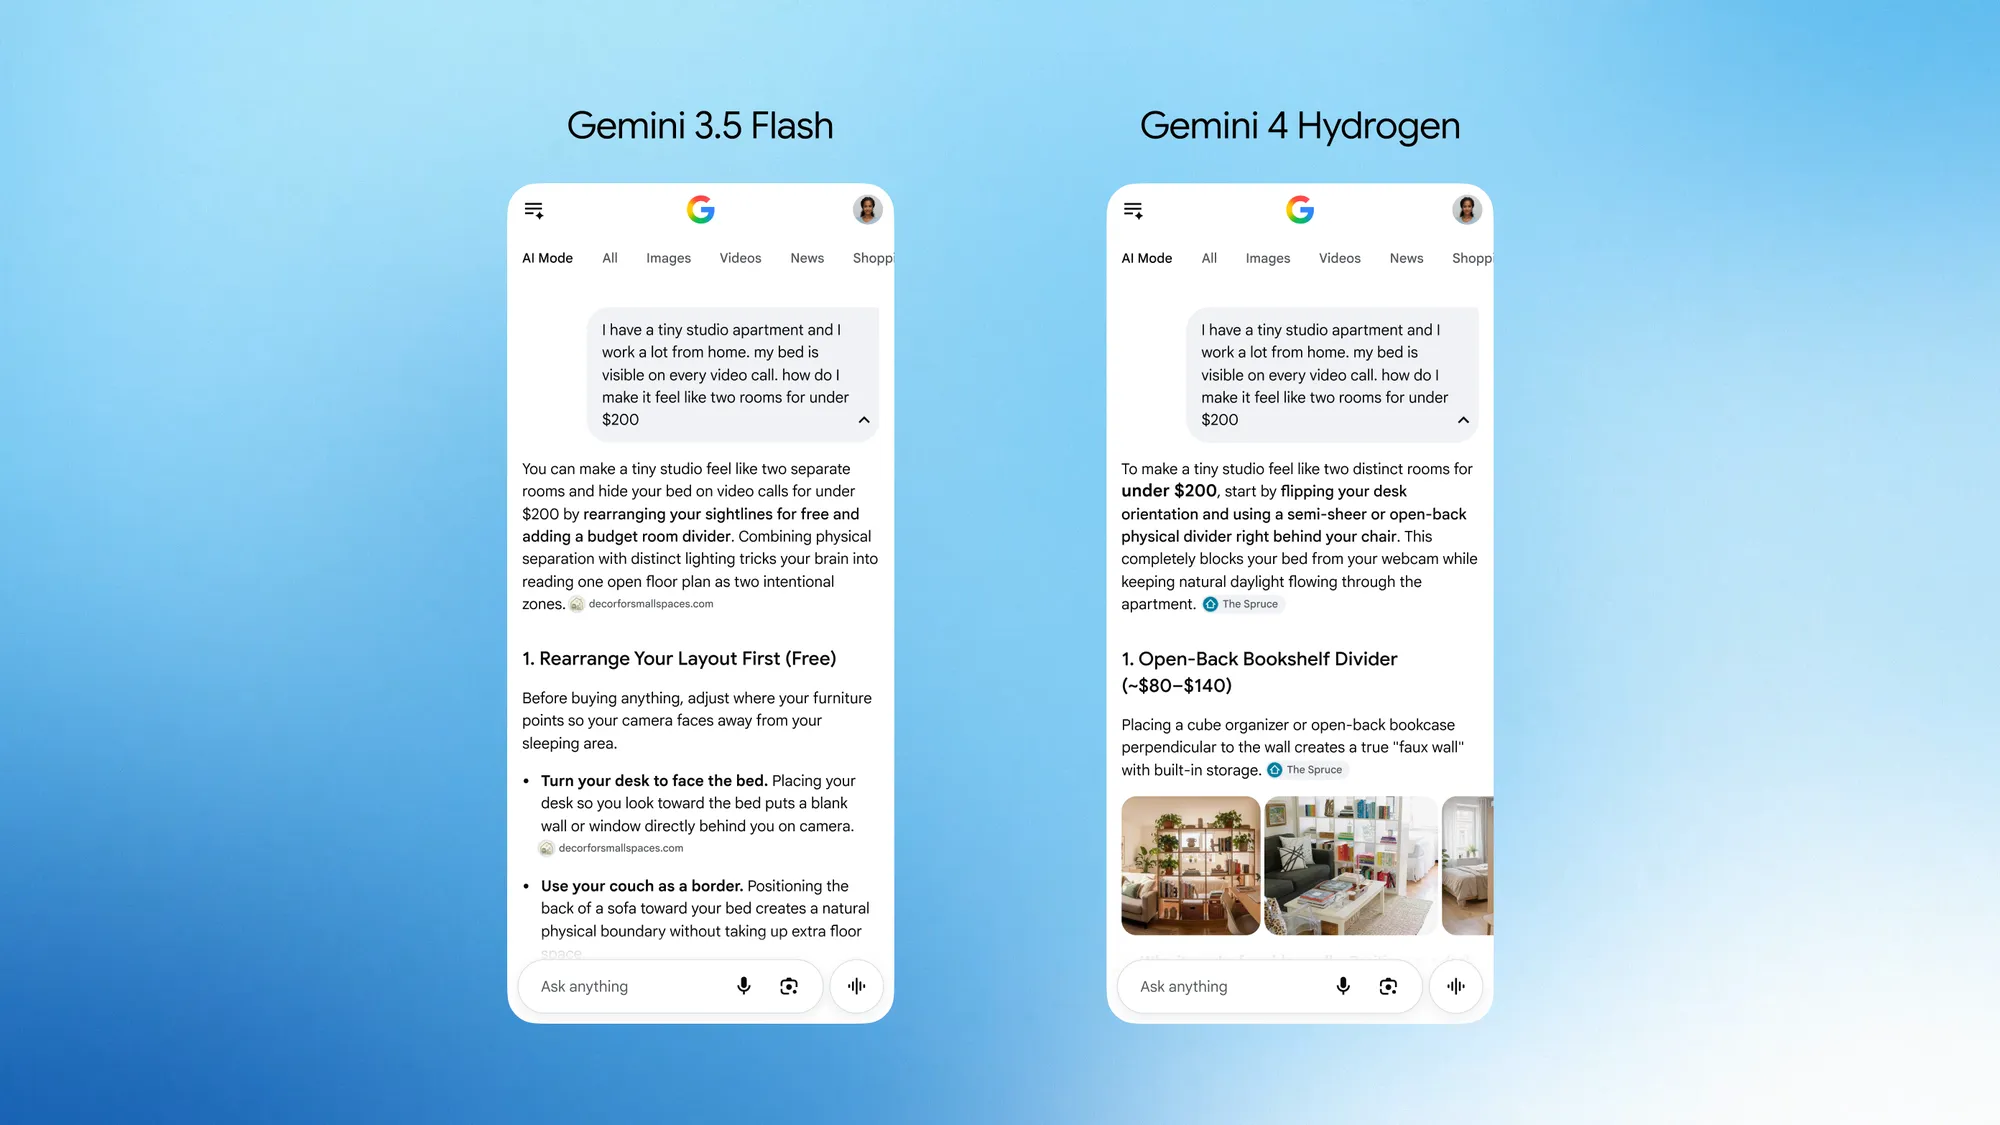
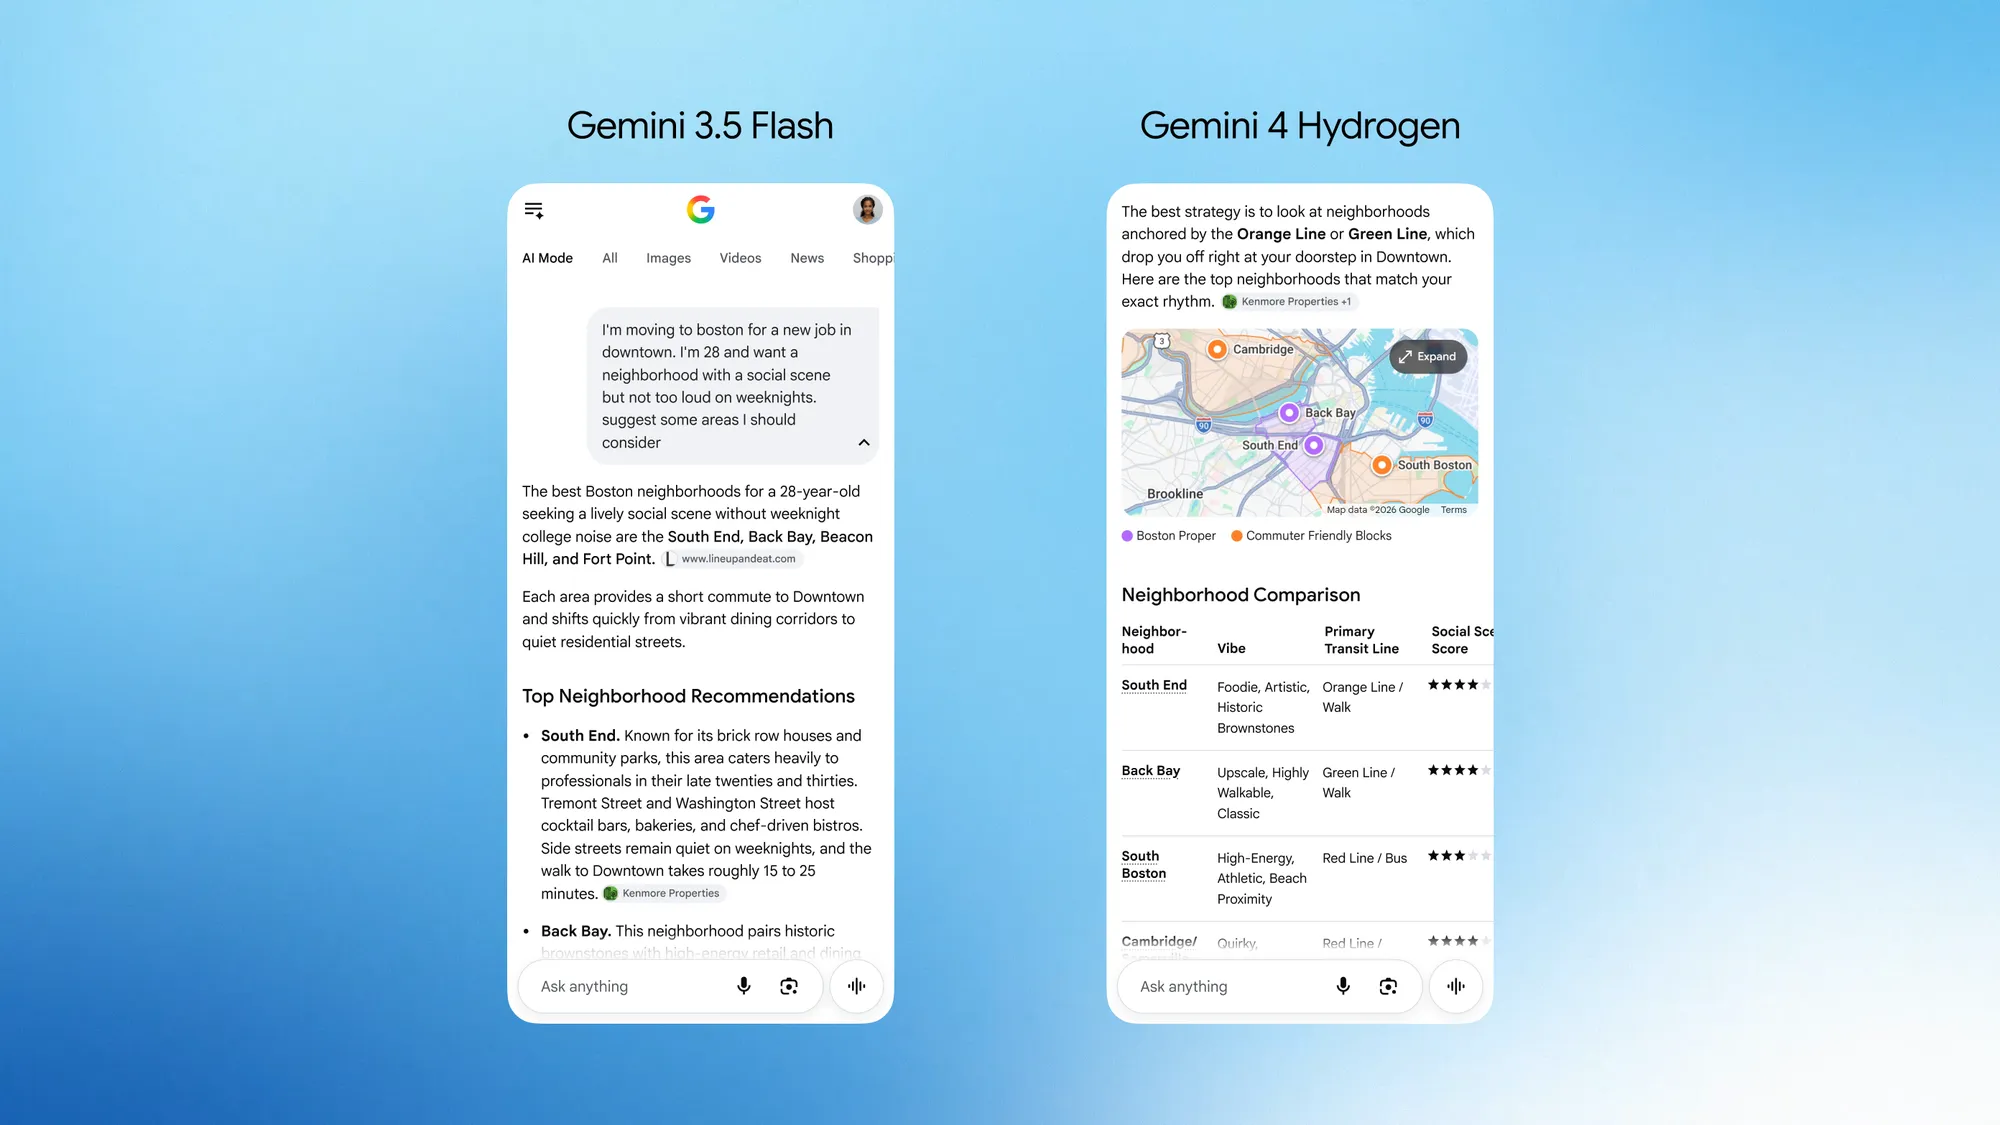
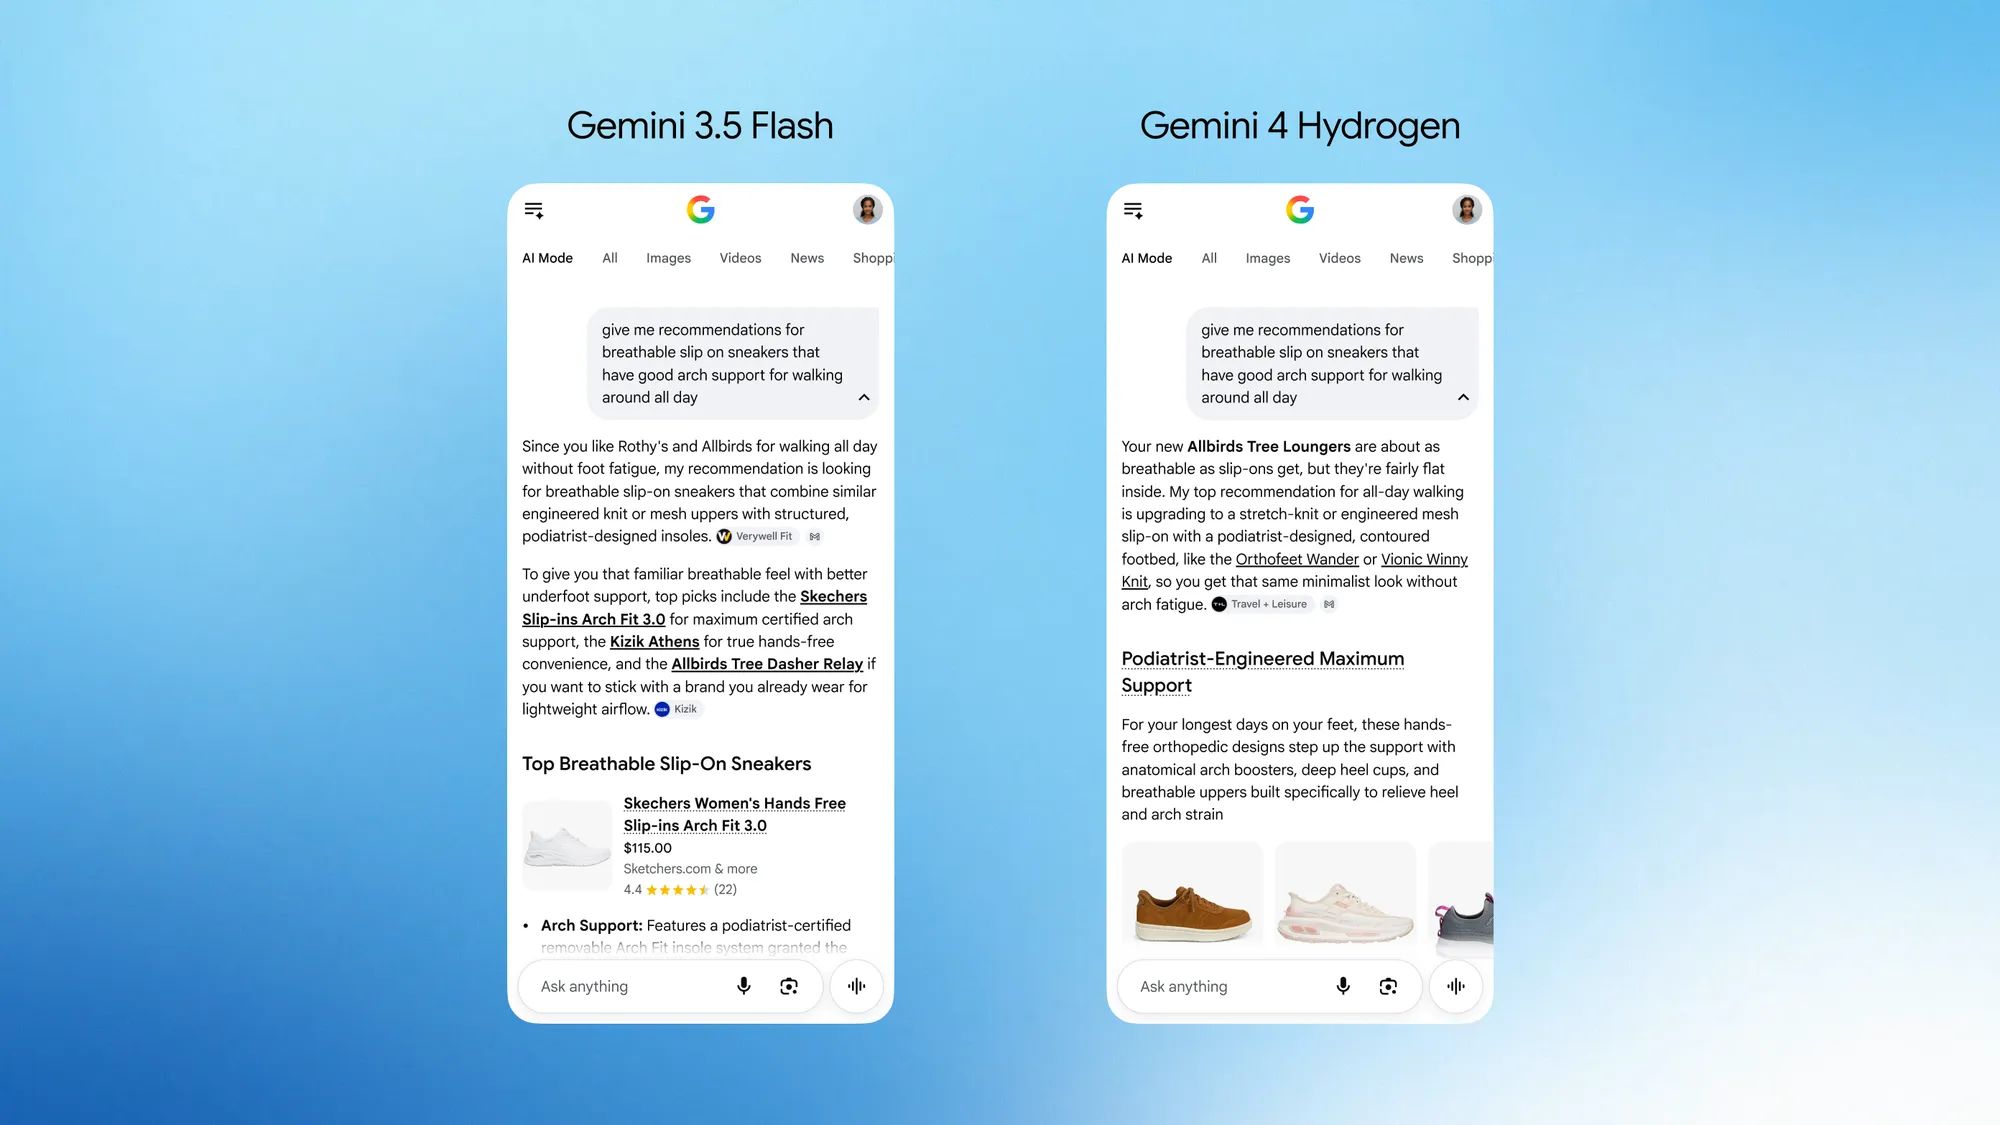
São exemplos escolhidos para venda, então não trate como benchmark. Mas eles mostram a direção do produto: o Hydrogen não é só mais rápido no mesmo nível de qualidade, ele muda o formato da resposta, com mais tabela, mais comparação estruturada e menos texto corrido. É o comportamento descrito no anúncio como seguir instruções de forma mais estrita e puxar contexto de anexos, Gmail, Drive e apps conectados.
Segurança: os números que o Google não destaca
O anúncio traz uma seção de segurança com números fortes, e vale relatar porque o padrão do setor tem sido esconder.
| Métrica | Resultado do Hydrogen |
|---|---|
| Redução de overreach em tarefas agentivas | até 81% |
| Redução de under-service | até 79% |
| Corte de ações desalinhadas e task shortcutting | 12 vezes |
| Probabilidade de burlar fronteiras de permissão | até 2 vezes menor |
| Taxa de honestidade em avaliação agentiva interna | 96,7% |
| Legibilidade de chain-of-thought preservada | 99,9% em mais de 200 mil turnos auditados |
| Edits de raciocínio enganosos | zero |
| Resiliência a injeção de prompt indireta (Gray Swan IPI) | mais de 2,3 vezes |
| Falsas recusas em HealthBench Pro | abaixo de 0,4% |
Os dois números que mais importam para quem coloca agente em produção são o 96,7% de taxa de honestidade e a legibilidade de 99,9% do chain-of-thought com zero edições enganosas em mais de 200 mil turnos auditados. O primeiro diz que o modelo não escondeu que não conseguiu. O segundo diz que quando você audita o raciocínio, ele é o raciocínio real.
E a resiliência a injeção de prompt indireta 2,3 vezes maior no Gray Swan IPI, contra o Carbon que marcou taxa de sucesso de ataque zero na mesma avaliação. O Hydrogen é mais rápido e mais barato, mas o treino de segurança continua sendo o do Carbon. Faz sentido, considerando que é o mesmo modelo base.
Por que o Google Search é o detalhe mais importante
O time de produto do Search publicou um post separado dizendo que essa é a maior atualização de modelo do Search até hoje. O Hydrogen chega globalmente no Google Search para todos os usuários.
Três mudanças técnicas: compreensão de intenção, com o Search entendendo perguntas em fluxo natural de pensamento, com múltiplas partes, com erros de digitação difíceis e pedidos muito específicos; melhoria do query fan-out, conectando a mais links relevantes através de consultas simultâneas sobre todos os subtópicos; e respostas mais visuais, com mais imagens, respostas estruturadas, tabelas de comparação e ferramentas customizadas.
E no app Gemini, o Hydrogen é o modelo de ajuda do dia a dia: respostas rápidas de Research, pesquisa detalhada com o 3.1 Pro no AI Pro, código e análise com o Argon, e o trabalho mais complexo com o Carbon. Na raiz, o Carbon coordena e o Hydrogen executa, com os agentes trabalhadores rodando em paralelo.
Como integrar
O Hydrogen está disponível via Gemini API no Google AI Studio e no Android Studio, no Gemini for business, no Google Antigravity para assinantes pagos de AI Pro e Ultra, e no app Gemini para todo mundo. O ID do modelo na API segue a família, com o nível de thinking como parâmetro explícito.
Os quatro níveis se controlam pelo mesmo parâmetro que o Carbon usa, e o xhigh é o valor novo. Na prática isso significa uma decisão simples de arquitetura: comece no high, o padrão, e suba para xhigh só nos pontos do fluxo onde o score extra de três pontos paga o dobro de tokens de saída. Para tarefas em lote, generation de código repetitiva, triagem e verificação, o medium a US$ 0,80 por tarefa resolve. Para raciocínio de pesquisa de verdade, o xhigh.
Um alerta prático: o Orchestrator é recurso do Google Antigravity, com rollout para assinantes do Google AI Ultra, e não da API. Se você quer a alternância automática Carbon e Hydrogen dentro da mesma sessão via API, ela não existe ainda. O que existe, no SDK do Antigravity, é você montar o pipeline multi-modelo explicitamente, com agentes de Hydrogen fazendo triagem e codificação e um agente de Carbon cuidando de refatorações grandes, features novas e checagem de segurança.
O que isso significa
1. O Google fechou o buraco de um Gemini 4 acessível. Desde o Argon, a família tinha um modelo rápido e caro, um modelo de fronteira e restrito, e um buraco no meio. O Hydrogen é o que faltava. Ele muda o cálculo de qualquer pessoa que estava usando o 3.8 Flash por ser mais barato, mesmo sabendo que estava pagando com inteligência.
2. O preço plano em 1 milhão de tokens é a parte mais subestimada. Modelo de fronteira com preço que não sobe com o tamanho do contexto é raro. Isso muda o dimensionamento de qualquer workload com documentos longos: a partir de certo tamanho, o custo marginal do contexto é zero no Hydrogen.
3. O Orchestrator é o produto mais importante do anúncio, mais que o modelo. A indústria passou anos construindo router estático, adivinhando a complexidade da tarefa pelo primeiro prompt. O Orchestrator troca adivinhação por replanejamento, e mostra 24% menos cota e 19% mais velocidade sem perder taxa de sucesso. O Carbon sozinho é caro demais para rodar o tempo todo; o Hydrogen sozinho não planeja bem. O valor está na troca.
4. O ângulo da segurança do Carbon é o argumento de venda menos somado e mais importante. Um modelo que é 2,5 vezes mais rápido e corta afirmações inventadas em 5 vezes, com 96,7% de honestidade e 99,9% de legibilidade de raciocínio, é um modelo que dá para deixar rodando em agente. E o Google o liberou para o usuário gratuito no app e para todo mundo no Search. É o modelo agentivo mais bem distribuído da história do Google, e ele é derivado do modelo de fronteira mais forte do mundo.
5. O padrão de qualidade de software subiu. O SWE-sweep de 13,5% contra 3,1% do Sonnet 5.5 não é margem, é ordem de grandeza. E o Vending-Bench 2 com US$ 14.549 de saldo simulado mostra um agente que toma decisões de negócio lucrativas, não só que escreve código. A distância entre o 3.8 Flash e o Hydrogen nos dois é o argumento mais forte do anúncio, e nenhum dos números sai do laboratório do Google.
Perguntas Frequentes (FAQ)
O que é o Gemini 4 Hydrogen e em que ele difere do Carbon e do Argon?
São três modelos com a mesma base. O Carbon é o modelo de fronteira para raciocínio profundo de horizonte longo, o Argon é o intermediário e o Hydrogen é a variante de execução rápida para o trabalho diário de código e agentes. O model card do Google diz explicitamente que o Hydrogen é adaptado do Gemini 4 Carbon, com a mesma arquitetura e a mesma janela unificada de 1 milhão de tokens. O que muda é o pós-treinamento, orientado a iteração rápida em vez de raciocínio longo, e o preço: US$ 1,50 e US$ 7,50 por milhão de tokens contra US$ 4 e US$ 20 do Carbon a partir de dezembro.
Quanto custa o Gemini 4 Hydrogen?
US$ 1,50 por milhão de tokens de entrada e US$ 7,50 por milhão de tokens de saída, com preço plano em toda a janela de 1 milhão de tokens. Tokens de entrada em cache custam US$ 0,075 por milhão, 95% de desconto. Na prática, o custo por tarefa medido pela Artificial Analysis varia de US$ 0,29 no nível low a US$ 3,16 no nível xhigh, passando por US$ 0,80 no medium e US$ 1,87 no high, que é o padrão.
Qual o score do Gemini 4 Hydrogen no Artificial Analysis Intelligence Index?
51 pontos no nível de thinking high, que é o padrão, contra 50 do Gemini 4 Argon no mesmo nível. No novo nível xhigh, chega a 54 pontos. No medium marca 41 e no low 27. Os números são da versão 5.0.1 do índice. O Claude Sonnet 5.5 marca 55 no nível max e o GPT-6.1 Terra marca 51 no max, mas o Hydrogen chega perto deles por um terço do custo por tarefa do Sonnet.
Quais são os quatro níveis de thinking e quando usar cada um?
low, medium, high e o novo xhigh. O high é o padrão. A recomendação prática é começar no high e subir para xhigh só onde os três pontos extras de score pagam o dobro de tokens de saída. Para triagem, geração repetitiva e verificação em lote, o medium a US$ 0,80 por tarefa é o ponto ótimo. Para raciocínio de pesquisa denso, o xhigh a US$ 3,16. O nível se controla pelo mesmo parâmetro de thinking usado nos outros modelos Gemini 4.
O Orchestrator está disponível na API?
Não. O Orchestrator é uma funcionalidade do Google Antigravity, com rollout para assinantes do Google AI Ultra, e o Google diz que mais modelos e planos serão suportados. Se você quer multi-modelo via API, o caminho hoje é o SDK do Antigravity, montando o pipeline explicitamente: agentes de Hydrogen para triagem e codificação, agente de Carbon para refatorações grandes, features e checagem de segurança.
O Hydrogen é melhor que o Claude Sonnet 5.5?
Em código agentivo, sim e com folga: 13,5% contra 3,1% no SWE-sweep. Em trabalho de conhecimento, o Hydrogen lidera os três benchmarks da categoria. Em raciocínio de pesquisa, o HLE-Diamond fica em 58,8% do Hydrogen contra 53,3% do Sonnet. Mas o Sonnet ganha em duas: Terminal-Bench 4.1 com 63,9% contra 57,0%, e OSWorld-2.1 com 83,9% contra 77,6%. Ou seja, o Hydrogen ganha em volume e preço, o Sonnet ganha em terminal e uso de computador.
Quem pode usar o Gemini 4 Hydrogen?
Todo mundo, em rollout global. Para desenvolvedores, está na Gemini API via Google AI Studio e Android Studio. Para empresas, no Gemini for business por API, pelo seletor de modelo, no Google Antigravity e nas Sheets para assinaturas empresariais elegíveis. Para o público, no seletor de modelo do app Gemini e no Google Search para todos os usuários, com os usuários gratuitos do app recebendo o Hydrogen por seleção automática de modelo quando ele for o mais adequado ao prompt. No Antigravity, é exclusivo de assinantes pagos de AI Pro e Ultra.
Qual é a janela de contexto e quanto dá para gerar?
A janela é unificada de 1 milhão de tokens, somando entrada e saída. Por padrão o modelo gera até 64 mil tokens de saída síncrona, e chega a 1 milhão via background long decode. Entrada aceita texto, imagens, áudio e vídeo. O preço é o mesmo plano em toda a extensão da janela, sem tier de contexto mais caro.
O que muda em relação ao Gemini 3.8 Flash?
É a grande virada. O 3.8 Flash marca 31 pontos no Artificial Analysis Index, o Hydrogen marca 51 no nível padrão e 54 no xhigh. O Google afirma 2,5 vezes mais rápido no nível high padrão, mais que o triplo de nota no Terminal-Bench 4.1, indo de 18,2% para 57%, e corte de mais de 5 vezes nas afirmações inventadas. Parceiros relatam Gains de 2 a 2,8 vezes de velocidade e redução de 12% a 23% no uso de tokens em fluxos com grafo, SQL e dados pesados.
Os benchmarks são confiáveis ou são marketing?
Vale separar. A tabela de dez avaliações veio do Google, com a metodologia publicada no model card em deepmind.google/models/evals-methodology/gemini-4-hydrogen. Os números do Artificial Analysis são medidos de forma independente, e batem com a tabela do Google nos pontos que ambos publicam. Já os depoimentos de parceiro são claims de terceiros, não medições reproduzíveis, e devem ser lidos como tales. O dado mais sólido do anúncio é o Artificial Analysis, porque é medido fora de casa.
Referências consultadas
- Introducing Gemini 4 Hydrogen for Agentic Workflows (Google DeepMind)
- Gemini 4 Hydrogen Model Card (Google DeepMind)
- Gemini 4 Hydrogen and Orchestrator (Google Antigravity Blog)
- Gemini 4 Hydrogen: everyday coding and agentic workflows for developers
- Google Search gets a major upgrade with Gemini 4 Hydrogen
- Artificial Analysis LLM Leaderboard, Índice de Inteligência v5.0.1
- Google announces Gemini 4 Hydrogen with significant leaps in speed, intelligence (9to5Google)
- Google Releases Gemini 4 Hydrogen, Beats Sonnet 5.5 On Most Benchmarks
- Techmeme: Google launches Gemini 4 Hydrogen at US$ 1,50/1M input and US$ 7,50/1M output
Posts relacionados: Gemini 4 Carbon: o modelo mais forte do mundo que ninguém pode comprar, Anthropic lança Claude Fable 5.2 e Mythos 5.2 e MiniMax H3-Image: 16 megapixels em 10 segundos com pesos abertos.