
21 de novembro de 2026, Cinco notícias de IA na semana de 14 a 21 de novembro. Só duas delas realmente merecem espaço na sua mesa de segunda-feira. Uma é o Google entregando um assistente que faz compras por você. A outra é a Microsoft mostrando tecnologia de ponta não precisa custar preço de tecnologia de ponta. O resto é ruído caro, mas o ruído que você precisa conhecer para não deixar dinheiro na mesa.
Em uma frase: a semana foi dividida entre quem virou de verdade e quem só ganhou manchete. Do lado do que funciona, o Google transformou o Gemini em um agente que liga para concessionária, marca consulta e paga conta. Do lado do que é barato, a Microsoft lançou sete modelos MAI e o Code 2 chega a 98% da qualidade do GPT-6.1 por 40% do preço. No meio, a OpenAI lançou o GPT-6.2, a Anthropic abriu o capital na Nasdaq e o Claude Code mudou o modo padrão para modo automático.
As 5 notícias e a conta
Vamos por partes, com o veredito de cada uma. A régua é simples: isso muda o que você faz na segunda-feira, ou só muda o que você comenta no almoço?
- Gemini Tasks, destaque. Assistente que age de verdade, com cartão de crédito, agenda e ligação.
- Microsoft MAI Code 2, destaque. 98% do GPT-6.1 Sol por 40% do preço, dentro do Copilot.
- GPT-6.2 Astra e Sol, segundo plano. Preço bom, inteligência no topo, mas não revolucionário.
- Claude Code em modo automático, segundo plano. O padrão mudou, mas a reversão é um sinal de alerta.
- Anthropic na bolsa, descarte. IPO de 1 trilhão de dólares que já perdeu 12% no primeiro dia.
Gemini Tasks: o Google finalmente entregou o assistente que liga, marca e paga
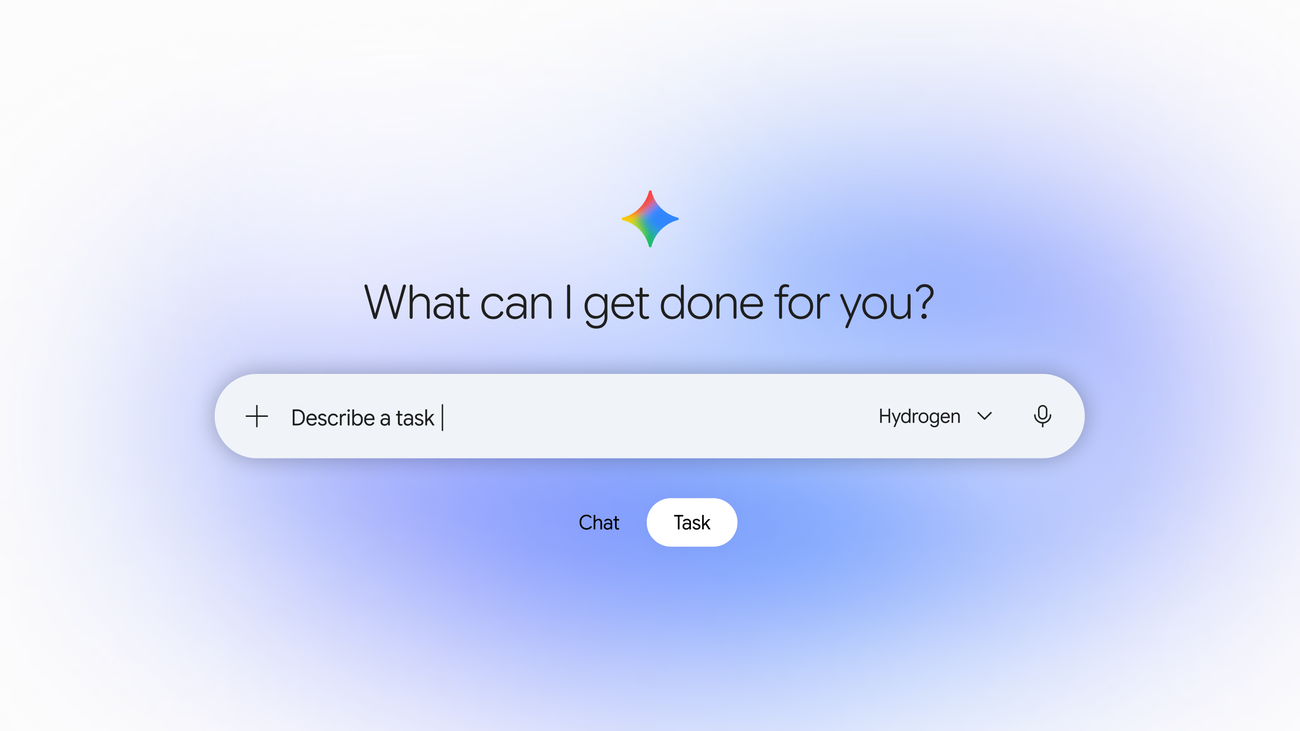
Essa é a notícia que muda a segunda-feira. Em 17 de novembro, o Josh Woodward, vice-presidente do Gemini app, anunciou o Tasks: um modo em que o Gemini deixa de responder e passa a executar. Você abre o app, muda o interruptor de Chat para Task, e pede.
Os exemplos do próprio Woodward não são de demo de showroom:
- A luz do motor da minivan acendeu. Ele pediu: “Nossa minivan está atrasada para uma revisão. Por favor, ligue para as duas concessionárias mais próximas e descubra como marcar um horário para sexta-feira cedo”. O Gemini encontrou as duas concessionárias no Maps, ligou para as duas ao mesmo tempo, esperou a música de espera no lugar dele, marcou o horário disponível na agenda e deixou o compromisso à sua disposição. Menos de cinco minutos.
- Conta de luz de US$ 389. Ele deu ao Gemini acesso ao portal da concessionária via Gerenciador de Senhas e pediu para analisar as faturas antigas. O culpado era a bomba de calor ligando às 16h, bem no horário de tarifa de pico. Ele e a esposa jamais teriam descoberto isso vasculhando PDFs.
- Comprou carregador USB-C com o Google Shopping Graph, o Gemini perguntou potência e cor, comparou, encontrou um cupom de US$ 10 e finalizou pelo Google Pay.
- Despensa: mandou “Adicione lasanha, morangos, pepinos e sorvete de baunilha ao nosso pedido no Instacart” por RCS, fotografou a caixa de cereais vazia e mandou “Adicione este também”. Chegou em casa e as compras estavam na porta.
- Encaminhou e-mails da escola para gemini@google.com. Em menos de um minuto todas as datas estavam na agenda com a esposa convidada, e ele percebeu um conflito no treino de basquete e se ofereceu para mandar mensagem a outro pai para trocarem a escala da carona.
A parte que importa: como o Google segura o dinheiro
Um assistente que liga para uma concessionária e marca consulta é uma demo. Um assistente que paga com o seu cartão precisa de arquitetura de segurança, e é aqui que o Tasks fica interessante:
- Máquina virtual isolada por hardware. Cada tarefa roda em uma VM dedicada à sua conta, nunca compartilhada, isolada em sandbox e testada pelos red teams do Google. É o Agent Compute Engine do Google Cloud.
- Protocolo de pagamento, não jeitinho. O Tasks usa o Agent Payments Protocol (AP2), com American Express (em breve), Mastercard e Visa, token digital no cartão. Você continua ganhando milhas, cashback e proteção do seu cartão.
- Teto de gasto. Você define o limite antes e o Gemini é desenhado para ficar dentro dele. Nada de compra surpresa.
- Confirmação antes do irreversível. O Gemini pede confirmação ou pré-aprovação antes de clicar “Buy” e faz pergunta de esclarecimento quando o pedido é ambíguo. Para o que você já confia, tipo adicionar cereal no carrinho, existe “Always allow”.
- Filtro de prompt injection. As buscas e páginas que o Gemini abre passam por filtro, junto com o Safe Browsing.
- Recibos no Google Wallet, que agora expande para iOS.
São mais de 60 aplicativos conectados, e o Google está abrindo a plataforma Connected Apps para desenvolvedores. O Advanced roll sai só nos EUA. O Tasks em si, de graça, sai nos EUA, Japão, Coreia, Canadá, Austrália e Índia, rodando no Gemini 4 Hydrogen.
O próprio Google admite a limitação: em alguns sites o Gemini chega quase até o fim e devolve a tela para você clicar no botão. Assistente pessoal exige que a web evolua para não tratar todo bot como malicioso. O Google está conversando com os sites grandes e provedores de segurança sobre isso, e o programa de bug bounty do AI Vulnerability Reward Program está aberto.
Para quem vai usar: o veredito é mesa, com uma ressalva. Se seus e-mails, agenda, senhas e cartões já estão no ecossistema Google, o Tasks é o assistente pessoal mais útil que existe hoje. Se não estão, você vai ter que conectar tudo isso antes de o agente valer alguma coisa. E a disponibilidade real ainda está restrita a seis países.
Microsoft MAI Code 2: 98% do GPT-6.1 Sol por 40% do preço
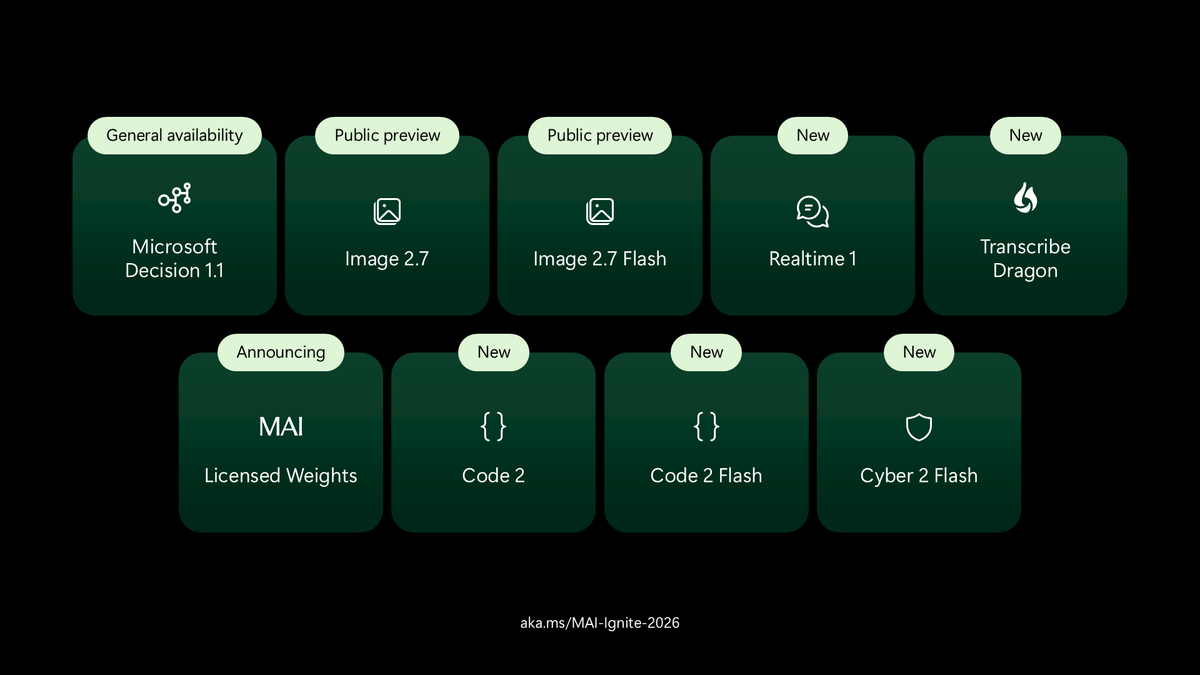
A Microsoft lançou sete modelos MAI no Ignite 2026. O que interessa é o Code 2 e o Code 2 Flash, o par de programação, mas o lineup inteiro dá contexto: MAI Decision 1 (roteamento), MAI Cyber 2 Flash (segurança), MAI Image 2.7 e 2.7 Flash (imagem), MAI Realtime 1 (voz), MAI Transcribe (transcrição) e os dois de código.
| Modelo | Claim da Microsoft | Onde roda |
|---|---|---|
| MAI Code 2 | 98% do GPT-6.1 Sol por ~40% do preço; 96% do Claude Opus 5.5 por 5% do preço | GitHub Copilot |
| MAI Code 2 Flash | Iguala o GPT-6 Luna por 65% do preço; Claude Haiku 5.5 por 20% | Copilot, preview limitado no Foundry |
| MAI Cyber 2 Flash | 92,3% no CyberGym-E2E contra 91,5% do GPT-6 Astra, a menos de 2% do custo por tarefa; janela de 1 milhão de tokens | US$ 0,10 entrada / US$ 0,50 saída por milhão; só produtos de segurança da Microsoft |
| MAI Image 2.7 | Nº 1 no Artificial Analysis de edição de imagem, a 1/5 do preço do GPT Image 2.6 Sunburst | US$ 34,82; preview público no Foundry |
| MAI Image 2.7 Flash | Mesma posição na fronteira qualidade-preço | Cerca de US$ 10 por 1.000 imagens contra ~US$ 35 do modelo completo |
| MAI Decision 1 | 10x mais rápido e 200x mais barato que um modelo geral | Foundry, OpenRouter e outros |
O número que importa não é o 98%. É o “5% do preço do Claude Opus 5.5”. A Microsoft está medindo em DeepSWE 1.1, Terminal Bench 2.1, SWE-Atlas e FrontierCode v1.1, e a própria empresa avisa que o Code 2 não foi afinado para pesquisa científica nem para tarefas agentic de horizonte longo. Ou seja: bom para o trabalho diário de front-end e empresa, exatamente onde o volume de tokens paga a conta.
Já escrevemos o post completo sobre o MAI Code 2, com a aritmética de custo por tarefa e as nove limitações que a Microsoft escreveu no próprio model card. O que fica aqui é o ângulo de panorama: entre as cinco notícias da semana, é a que muda o custo marginal de rodar código em produção.
GPT-6.2 Astra e Sol: preço menor, inteligência no topo, zero revolução
OpenAI lançou o GPT-6.2 Astra e Sol em 17 de novembro, disponível no ChatGPT Work e no Codex para Plus, Pro, Enterprise e Edu, e na API como gpt-6.2-astra e gpt-6.2-sol.
| Modelo | Preço por milhão de tokens | Artificial Analysis Intelligence Index |
|---|---|---|
| GPT-6.2 Astra | US$ 8 entrada / US$ 40 saída (20% abaixo do GPT-6 Astra); entrada em cache US$ 0,40 (era US$ 1,00) | 62 |
| GPT-6.2 Sol | US$ 2 entrada / US$ 10 saída | 57,3 |
| Claude Fable 5.2 (referência) | Referência do Artificial Analysis | 65 |
A Astra está cinco pontos acima do GPT-6 Astra e a 2,3 pontos atrás do Claude Fable 5.2 no índice de inteligência, que combina nove testes de raciocínio, trabalho científico, código e conhecimento. No Agents’ Last Exam, que mede trabalho profissional de múltiplos passos, ela fica 5,2 pontos acima do GPT-6 Astra com menos de um terço do custo, e 5,5 pontos à frente do Fable 5.2 com 5% do preço. No AA-3D, é a primeira com 1.318 Elo, contra 1.271 do Fable 5.2 e 1.259 da Sol.
O que a OpenAI está construindo bem: planilhas, slides e documentos que seguem templates e convenções de direito, vendas, finanças e contabilidade, casando layout, cor, tipografia e até o tamanho da fonte, mesmo a partir de uma captura de tela. E o uso de computer use mais preciso chega em partes específicas de ferramentas de CAD e simulação.
O que ela não fez: melhorar o desempenho de agente de programação. Os testes independentes não mostraram avanço em performance de agente de código, e a Astra é o primeiro modelo público da OpenAI avaliado como Alto em autoaperfeiçoamento de IA, o que traz revisão mais rigorosa. Uma empresa que corta preço e sobe no índice ao mesmo tempo é uma empresa disputando por volume de tarefa, não por conquista de capacidade.
Veredito: gaveta, com uma ressalva importante. O desconto de 20% e o preço de entrada em cache caindo para US$ 0,40 tornam a Astra muito atraente para quem roda agente em volume. Mas a Sol a 57,3 no índice repete o desempenho do Astra original (62) por cerca de 15% do custo por tarefa avaliada. E ao mesmo tempo o Qwen 4 Max da Alibaba, que entrou na semana cobrando US$ 1,50 de entrada e US$ 4,50 de saída, muda a conta para quem não está preso no ecossistema OpenAI.
Se você quer o detalhe do lançamento, com a comparação completa contra o Claude Opus 5.5 e o cálculo de custo por tarefa, o post dedicado do GPT-6.2 cobre o que aqui cabe em uma linha.
Claude Code em modo automático: o padrão virou permissivo, e dá para voltar
Essa é a que muita gente não viu porque não é anúncio. No changelog do Claude Code de 16 de novembro, a Anthropic mudou o padrão de inicialização: sessões de terminal e VS Code sem modo definido agora começam em auto mode, e não mais em Manual mode, quando a política da organização ainda não carregou.
Na prática, o que mudou na semana:
- 16/nov: sessões sem modo definido passam a iniciar em auto mode. Sessões em organizações com configuração HIPAA do Claude Code + Cowork também entram em auto mode por padrão, com
disableAutoModedesligando. - 16/nov: o auto mode passa a ignorar regras de allow curinga que não nomeiam programa ou que começam com
$HOME, para que a checagem de segurança decida essas chamadas. - 17/nov: o auto mode ignora mais regras de allow que rodam qualquer pacote, como
Bash(pnpm dlx *)e/usr/bin/npm run:*. - 17/nov: o aviso de fallback para requisições de classificador faturadas avisa que uma versão próxima remove o fallback: cada ação que seria checada passa a ser perguntada ou negada.
- 19/nov: auto mode disponível para Claude Opus 4.6 e Sonnet 4.6 na Amazon Bedrock, Google Cloud Agent Platform, Microsoft Foundry e Claude apps gateway.
- 20/nov: tarefas agendadas recorrentes e
/looppassam a rodar por até 30 dias, em vez de 7, enquanto a sessão estiver viva.
O que é o auto mode, na prática: é um nível de permissão intermediário em que o Claude Code decide sozinho se cada ação passa, com um classificador local no seu computador (que conta como uso) ou, em conexão direta com a API da Anthropic, um classificador no servidor. O ponto de equilíbrio da Anthropic é claro no desenho: para ações destrutivas, como rm em diretório raiz, o código agora pergunta e recusa quando não há ninguém para responder.
Veredito: gaveta, com o pé atrás. O padrão mudou na direção de menos atrito, e isso é ótimo para produtividade e péssimo para quem trabalha em repositório sensível sem olhar o que o agente fez. O dado que quebra o consenso de “tudo piorou” é o de 17 de novembro: o fallback para classificador local, que é o que permitia a ação sem verificação, está sendo removido. Cada ação passa a ser checada de verdade.
Anthropic na bolsa: 1 trilhão de dólares que perdeu 12% no primeiro dia
A Anthropic abriu o capital na Nasdaq sob o código ANT em 19 de novembro. O IPO foi precificado a US$ 83 por ação em 18 de novembro, acima da faixa de US$ 70 a US$ 78 do prospecto de 17 de novembro. Foram 980 milhões de ações vendidas.
| Marco | Valor |
|---|---|
| Preço do IPO | US$ 83 por ação |
| Primeiro negócio (11h48, leilão de abertura) | US$ 111,50, 34,3% acima do IPO |
| Fechamento (16h00) | US$ 97,17, 17,1% acima do IPO |
| Último negócio after hours (19h59) | US$ 92,60 |
| Valor de todas as ações a US$ 83 | US$ 1,10 trilhão (13,2 bilhões de ações, se a venda lateral de US$ 26 bilhões a sete empresas de tecnologia fechar) |
| Valor de todas as ações a US$ 97,17 | US$ 1,28 trilhão |
Veredito: lixo, do ponto de vista do que muda na segunda-feira. Um valuation de US$ 1,10 trilhão para uma empresa cuja receita não foi divulgada no material do prospecto final é uma aposta sobre o futuro da computação, não um fato do presente. O que interessa para quem usa as ferramentas é o que a receita da Anthropic faz com o preço dos tokens, e sobre isso a bolsa não diz nada.
Um detalhe que é informação de verdade: o IPO aconteceu na semana em que o Claude Code mudou de padrão para modo automático e o Fable 5.2 saiu a US$ 65 no índice de inteligência, batendo a Astra. A empresa que vale US$ 1,10 trilhão está competindo com a OpenAI exatamente no terreno em que a OpenAI mais é usada, e a Anthropic chegou com preço maior. Isso tem consequência prática para quem decide com qual provedor fechar contrato.
Rumores: Gemini 4 Neon e Fable 5.5 sem anúncio oficial
Dois nomes apareceram circulando na semana sem anúncio oficial: o Gemini 4 Neon, da Google, e o Claude Fable 5.5, da Anthropic. Trato os dois como rumor e não como lançamento, porque sem anúncio oficial não há preço, nem data, nem model card, e sem os três não há o que comparar.
O Fable 5.5 tem uma data de referência: a Fable 5.2, lançada na semana anterior, já pontuou 65 no Artificial Analysis e 1.271 Elo no AA-3D. Então a régua para o 5.5 é alta. O Neon tem a referência da família: o Gemini 4 Hydrogen, que segura a casa no Artificial Analysis e responde o Gemini Tasks que descrevemos lá em cima.
Veredito: lixo, até alguém publicar o model card. Mas é o tipo de rumor que vale o bookmark, porque os dois caem exatamente nas lacunas que os lançamentos da semana deixaram: um frontier multimodal mais forte e um Claude mais barato que o Opus.
A mesa de segunda-feira
O resumo executivo de quem vai usar o quê a partir de segunda-feira:
- Se seus dados estão no Google: ative o modo Task do Gemini. É a única novidade da semana que entrega trabalho feito, não promessa. Comece por uma tarefa de baixo risco: marcar consulta, comparar preço, organizar conta.
- Se você roda código em produção: teste o MAI Code 2 no GitHub Copilot com o seu repositório real. 98% do GPT-6.1 Sol por 40% do preço só interessa se o seu código é parecido com o código que a Microsoft mediu. E o MAI Image 2.7 a US$ 34,82 é o primeiro a pagar atenção em geração de imagem com preço de campanha.
- Se você usa Claude Code: confira em qual modo suas sessões estão iniciando. O padrão virou auto mode, e a checagem de segurança ficou mais agressiva com regras curinga. Se você depende de uma regra
allowampla para rodar, ela pode estar sendo ignorada. UsedisableAutoModepara voltar ao manual, e confira o que o classificador local está barrando. - Se você paga por token em volume: a conta mudou. Entrada em cache da Astra a US$ 0,40, Sol a US$ 2, e o Qwen 4 Max a US$ 1,50 de entrada. Dependendo do seu mix, o fornecedor mais barato da semana pode não ser o da moda.
- Se você acompanha a bolsa: a ANT é a maior aposta já feita em modelo de linguagem. Trate como o que é: uma aposta.
O que isso significa
Cinco notícias, e elas contam uma história só: a semana em que a vantagem competitiva deixou de ser o modelo mais inteligente e passou a ser quem entrega mais trabalho acabado por dólar.
- O agente vira produto, não recurso. O Tasks não é um chat melhor, é uma interface nova com a mesma promessa do Claude Code em modo automático: o modelo age, e você só vê o resultado. A Anthropic normalizou o padrão permissivo, o Google normalizou o agente de consumo, e a Microsoft normalizou o preço. Quem ficar no paradigma do “meu chatbot responde bem” vai ficar para trás.
- Preço por tarefa vira a métrica, e ela é claramente contrária à OpenAI. A Microsoft mediu 96% do Claude Opus 5.5 por 5% do preço. A OpenAI baixou 20% e o cache de entrada caiu pela metade. O Qwen 4 Max entrou cobrando US$ 1,50. Em 2025 a discussão era qual modelo era o mais inteligente; em novembro de 2026 é quanto custa fechar a tarefa.
- Quem perde é a camada intermediária. Quando a OpenAI, a Microsoft, a Google e a Alibaba vendem tecnologia de ponta com desconto simultâneo, qualquer empresa que vendia “o GPT-6.1 com 30% de desconto” não tem mais proposta de valor. O mesmo vale para revenda de API e para camadas de orquestração que cobram pela inteligência.
- Segurança virou funcionalidade, e isso é bom. O Google isolar a tarefa em máquina virtual dedicada, exigir confirmação antes de comprar e tokenizar o cartão não é burocracia, é o que permite o produto existir. O Claude Code fazendo o mesmo com classificadores e regras de permissão mais estritas segue a mesma lógica. Quem reclama disso está reclamando do preço da funcionalidade.
- A Anthropic na bolsa é o capítulo final de uma história sobre risco. US$ 1,10 trilhão de avaliação de mercado para uma empresa de US$ 26 bilhões em venda lateral, a 12% de distância do preço de abertura de capital no primeiro dia. O mercado está precificando a hipótese de que computação é o novo petróleo. Se a receita não acompanhar, o ajuste vem rápido. E se vier, todo mundo que compra token da Anthropic vai pagar por um acerto de avaliação de risco.
No meio disso tudo, uma constatação que o resumo semanal esconde: a Anthropic está cobrando mais caro que a OpenAI exatamente no modelo que a OpenAI usa para competir em volume. A Sol a US$ 2 de entrada e US$ 10 de saída, com cache a US$ 0,40, é difícil de bater quando o seu uso é o mesmo do Fable 5.2 em tarefas de produção. A aposta da bolsa ajuda a explicar por que a Anthropic vai tentar o Fable 5.5 com força. E também por que o rumor importa.
As fontes
Todos os números deste post vêm das fontes primárias, com uma ressalva explícita: os números de desempenho da Microsoft e da OpenAI são das próprias empresas, exceto onde marcado como medido externamente pelo Artificial Analysis.
- Google: Tasks no Gemini, por Josh Woodward, 17/11/2026.
- TestingCatalog: sete modelos MAI no Ignite 2026, 17/11/2026.
- Decrypt: GPT-6.2 medido externamente, 17/11/2026.
- TestingCatalog: lançamento do GPT-6.2 Astra e Sol, 17/11/2026.
- Changelog do Claude Code, versões de 16 a 20/11/2026.
- StockTitan: cobertura do IPO da Anthropic, 19/11/2026, com dados do prospecto final (Form 424B4).
Para acompanhar o que muda de semana em semana com o mesmo critério, o Baita Site traz o panorama completo de lançamentos. E se a pergunta é o que fazer com isso na sua máquina, o RodarIA traz o recorte do que roda local, com os custos por hardware.