
Em quatro meses, Anthropic, Google, xAI, Alibaba e DeepSeek lançaram 19 modelos de fronteira. Só em novembro, o Google sozinho lançou o Gemini 4 Carbon, o Gemini 4 Argon e o Gemini 4 Hydrogen em 25 dias. Isso não é mais ciclo de produto, é ciclo de atualização de modelo, e a consequência prática é que qualquer comparação que você faça hoje vale por semanas, não por trimestres.
O efeito colateral mais concreto está nas APIs. Quando o DeepSeek lançou o V4.1-Flash em 10 de setembro, aposentou o próprio V4-Pro: a partir de 14 de setembro, toda requisição para o V4-Pro passou a ser servida pelo V4.1-Flash, e cobrado no preço mais barato. Seu código não quebrou, mas o modelo que responde por trás do seu código mudou de um dia para o outro, sem aviso no changelog da sua aplicação. O mesmo mecanismo está no Qwen, que mantém aliases que apontam para a versão mais recente, e na xAI, que promete explicitamente nunca rebaixar a inteligência de forma silenciosa.
Este conteúdo tem caráter informativo. Decisões técnicas devem ser tomadas com profissional especializado.
O calendário: 19 modelos em 4 meses
Vamos listar o que saiu, na ordem cronológica, com as datas oficiais de anúncio. Isso já responde a pergunta mais concreta: com que frequência o cenário muda.
| Data | Laboratorio | Modelo | Contexto | Peso aberto | Entrada / Saida (US$ por milhão) |
|---|---|---|---|---|---|
| 10/set | DeepSeek | V4.1-Flash | 1M | Sim, MIT | 0,15 / 0,60 (fora de pico) |
| 21/set | xAI (SpaceXAI) | Grok 4.7 | 500 mil | Não | 2,00 / 6,00 |
| 22/set | Anthropic | Claude Opus 5.5 | 1M | Não | 4,00 / 20,00 |
| 28/set | Anthropic | Claude Sonnet 5.5 | 1M | Não | 2,00 / 10,00 |
| 30/set | Gemini 4 Argon (preview) | 1M | Não | 2,00 / 10,00 (promocional) | |
| 2/out | Alibaba | Qwen3.8-Max-0902 | 1M | Não | n/d |
| 13/out | Gemini 4 Argon (geral) | 1M | Não | 2,00 / 10,00 (até 30/nov) | |
| 17/out | Alibaba | Qwen3.8-Omni-Flash | 1M | Não | n/d |
| 28/out | Gemini 4 Carbon (Fairwind) | 1M | Não | n/d | |
| 9/nov | Anthropic | Claude Fable 5.2 e Mythos 5.2 | 1M | Sim, 33,1B | 5,00 / 25,00 |
| 12/nov | Gemini 4 Hydrogen | 1M | Não | 1,50 / 7,50 |
São 11 eventos em 64 dias, de 5 laboratórios. E olha que essa tabela deixa de fora os modelos que saíram com menos ruído: o Qwen3.8-Flash, o Qwen3.8-27B, o Qwen3.8-2.4T-A95B aberto, o DeepSeek-V4-Flash e o V4-Pro, o Claude Haiku 5.5, o Gemini 3.8 Flash e o Claude Sonnet 5.1. Contando esses, o número passa de 19.
O padrão mais forte é o do Google: três modelos da mesma família em 15 dias, com o preview do Argon em 30 de setembro, abertura ao público em 13 de outubro, e o Carbon em 28, com acesso restrito pelo Programa Fairwind. Depois o Hydrogen em 12 de novembro, liberado para todo mundo. Nenhum outro laboratório fez três versões da mesma geração nesse intervalo.
Por que isso importa para quem integra
O problema prático do modelo que muda embaixo da sua aplicação tem nome no jargão: model drift silencioso. Você escrevera o prompt, o agente vai funcionar, e em três semanas o comportamento mudou. O caso do DeepSeek é o mais limpo porque foi documentado, mas é justamente por isso que é instrutivo: a documentação oficial diz que o V4-Pro foi aposentado e o V4.1-Flash assumiu, com o V4-Pro roteado para o V4.1-Flash e cobrado no preço do V4.1-Flash.
As saídas para quem depende disso são três, e todas cuestam:
- Fixe a versão, não o alias. A xAI é explícita: use o identificador fixo quando precisar de reprodutibilidade, e o alias só quando quiser a última versão. O Qwen e o Gemini 3.8 seguem a mesma prática, com sufixos
-latestseparados dos identificadores fixos. - Versione o prompt e o resultado. Se o modelo muda, o prompt que funcionava em outubro pode falhar em novembro sem que ninguém tenha mexido no seu código.
- Tenha um modelo de reserva que não seja do mesmo fornecedor. Se sua aplicação inteira depende da API do Google, o dia em que o Google trocar o modelo por trás do alias, você não tem para onde correr.
E tem um quarto ponto, mais ingrato: a janela de comparação está encolhendo. O Artificial Analysis recalcula o índice de inteligência v5.0.1 com modelo novo quase toda semana, e os modelos que eram topo em setembro já não estão. O Gemini 4 Argon, lançado em 13 de outubro com 50 pontos, estava na mesma faixa do Claude Sonnet 5.5. Doze dias depois, o Hydrogen marca 51 no nível padrão e 54 no xhigh, e o Sonnet 5.5 continua em 52.
Google: três modelos, trêsStrategies
A família Gemini 4 no Google não é uma lista de modelos incrementais, é uma divisão explícita de trabalho. Vale reconstruir a lógica porque ela define o resto do mercado.
O Argon é o de uso geral, com acesso aberto. Lançado em preview em 30 de setembro para um grupo selionado de defensores de segurança via Fairwind, e aberto ao público em 13 de outubro a US$ 2 por milhão de tokens de entrada e US$ 10 de saída, com entrada em cache a 95% de desconto. O preço sobe para US$ 4 e US$ 20 depois de 30 de novembro.
O Carbon é a fronteira, com trava. Anunciado em 28 de outubro, o Carbon marcou 59 pontos no Índice de Inteligência v5.0, o primeiro lugar, com 88,2% no SEC-bench Pro e 54,8% no ExploitGym. Mas o acesso foi só para profissionais de cibersegurança selecionados, e o preço de dezembro dobra.
O Hydrogen é a execução em massa. Lançado em 12 de novembro a US$ 1,50 e US$ 7,50, com preço plano na janela de 1 milhão de tokens. O model card diz que é adaptado do Carbon, com a mesma arquitetura. É a prova de que o Google sintetizou as três estratégias num so mes: um modelo para pensar fundo, um para todo mundo e um para escalar execução. E o preco de cada um cai conforme o escopo aumenta.
| Modelo | Papel | Preco (entrada / saída) | Nota |
|---|---|---|---|
| Gemini 4 Carbon | Fronteira, raciocínio profundo | Acesso restrito (Fairwind) | 1º lugar no índice v5.0, com 59 pontos |
| Gemini 4 Argon | Uso geral | 2,00 / 10,00 (4,00 / 20,00 em dez) | Aberto ao público em 13/out |
| Gemini 4 Hydrogen | Execucao rapida em massa | 1,50 / 7,50 | Adaptado do Carbon, 4 níveis de thinking |
Anthropic: a familia 5.5 inteira em seis dias
A Anthropic fez o lançamento mais bem orquestrado do período. Claude Opus 5.5 saiu em 22 de setembro, Claude Sonnet 5.5 em 28 de setembro, e a empresa anunciou na mesma ocasião que o Haiku 5.5 viria nas semanas seguintes. Três dias de diferença entre o topo e o meio da linha.
O argumento de venda do Opus 5.5 foi duplo: performance no nível do Claude Fable 5.1 na maior parte do trabalho, com 40% menos custo de execução que o Opus 5. O preço caiu de US$ 5 e US$ 25 para US$ 4 e US$ 20, a leitura de cache caiu 60% para US$ 0,20 por milhão, e a geração ficou mais de 30% mais rápida. É o mesmo playbook do Google: modelo mais barato no mesmo slot.
Em 9 de novembro veio o Fable 5.2 e o Mythos 5.2, com 33,1 bilhões de parâmetros abertos, e o diferenciação foi técnica: o Fable formaliza provas matemáticas, incluindo o último teorema de Fermat, e o Mythos faz trabalho de nível de doutorado em ciências da vida. O Anthropic descreve o Opus 5.5 como comparável ao Mythos em biologia e cibersegurança, o que sujeita ele às mesmas salvaguardas restritivas.
Vale notar a mudança de postura: o Opus 5.5 foi o primeiro lançamento depois de a Anthropic pedir publicamente para desacelerar a fronteira. E ainda assim saiu. O ritmo não diminuiu, a forma mudou: a empresa trocou frequência por escopo de modelo.
xAI: mesma velocidade, metade do preco
O Grok 4.7 saiu em 21 de setembro com uma proposta que é sobre o preço tanto quanto sobre a inteligência: mesmo preço e mesma velocidade do Grok 4.6, com uma base maior e um treino de reinforcement learning mais longo em problemas que levam horas.
| Benchmark | Grok 4.7 xHigh | Grok 4.6 High | GPT-5.6 Sol Max | Fable 5.1 Max |
|---|---|---|---|---|
| Entrada (US$/milhão) | 2 | 2 | 4 | 10 |
| Saida (US$/milhão) | 6 | 6 | 20 | 50 |
| CursorBench 4.0 | 46,3% | 40,4% | 41,7% | 51,8% |
| DeepSWE v1.1 | 71,0% | 65,2% | 72,7% | 70,0% |
| EEBench | 64,0% | 53,0% | 39,4% | 56,4% |
| Terminal-Bench 4.0 | 37,6% | 20,3% | 37,3% | 57,9% |
| HealthBench Professional | 56,7% | 48,5% | 60,5% | 62,1% |
A tabela da xAI deixa claro o posicionamento: o Grok 4.7 não ganha em quase nada, mas custa uma fração. US$ 2 contra US$ 4 do GPT-5.6 Sol e US$ 10 do Fable 5.1 na entrada. Onde ele realmente se destaca é no EEBench, com 64,0% contra 39,4% do Sol, e no Harvey Legal Agent, com 19,6% contra 2,5% do Sol.
Dois detalhes técnicos que valem atenção: a janela é de 500 mil tokens, metade da concorrência, e há um variante Fast com o dobro da velocidade de saída ao dobro do preço, disponível apenas dentro do Cursor e do Grok Build, não na API pública. E a xAI foi a única do grupo a declarar explicitamente que nunca rebaixa a inteligencia de forma silenciosa nem faz fallback para outro modelo.
DeepSeek: o unico que abre os pesos e ainda ganha
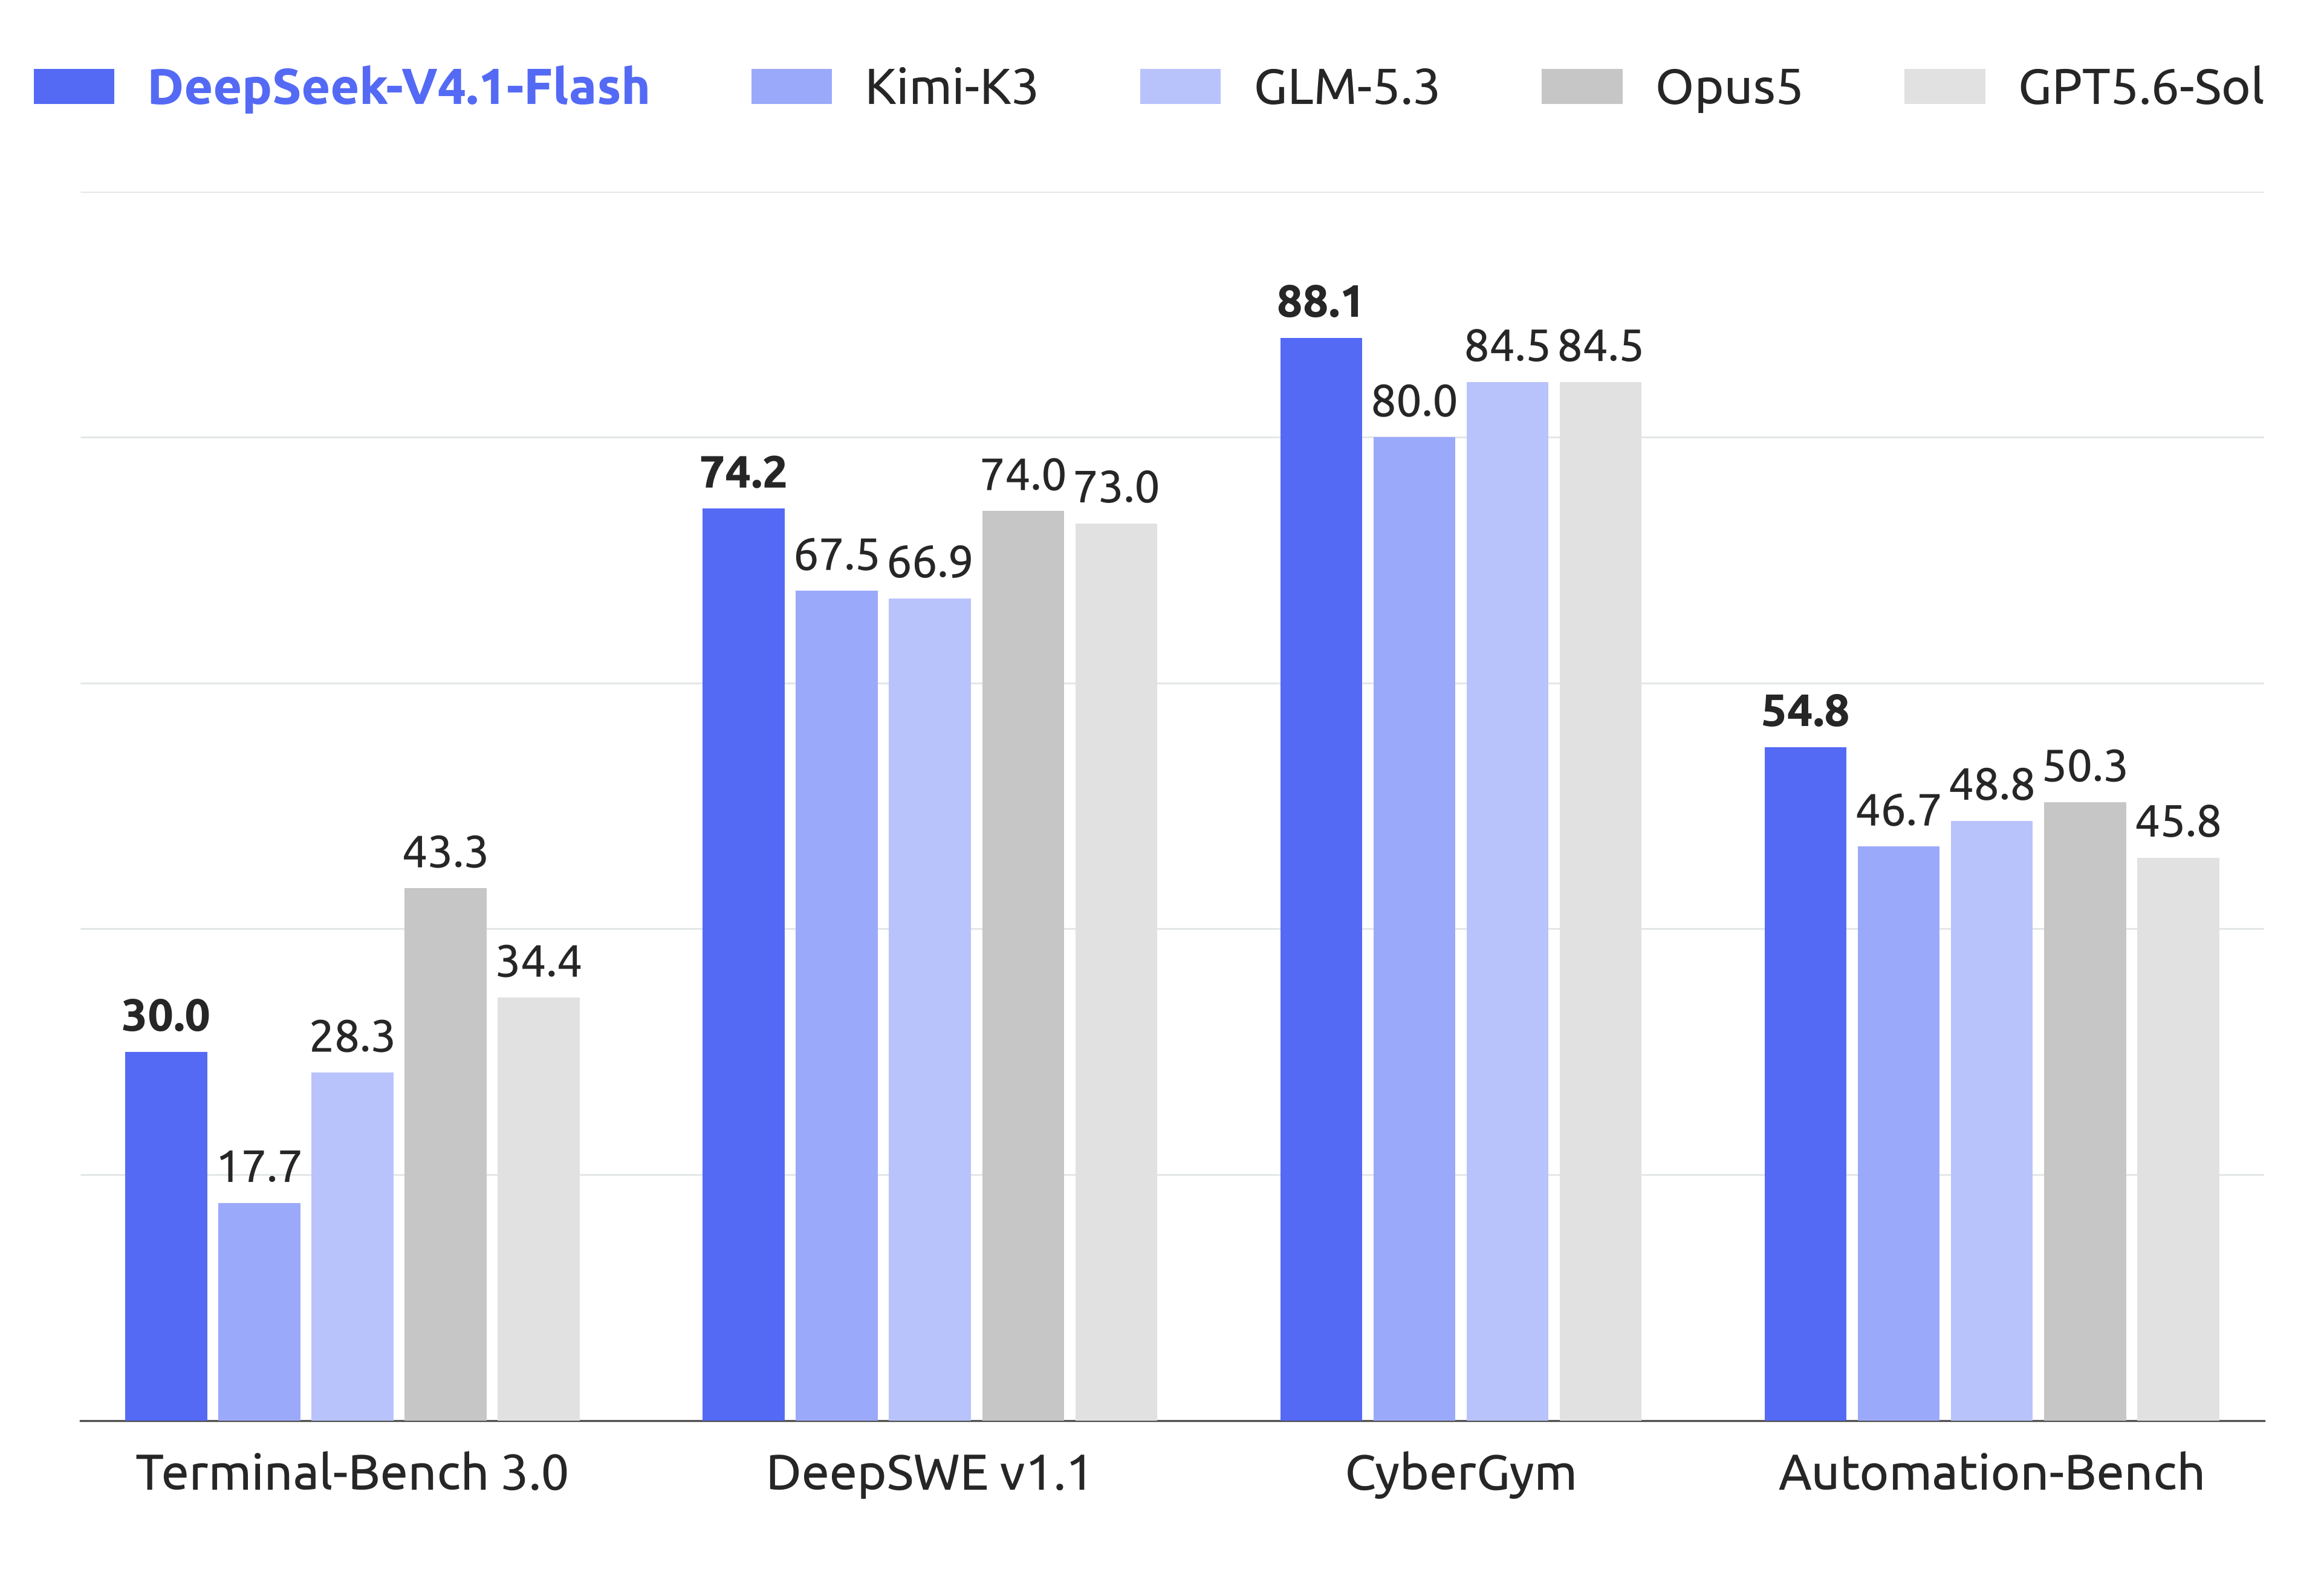
O DeepSeek V4.1-Flash, lançado em 10 de setembro, é o caso mais interessante do grupo por um motivo que não é preço: os pesos abertos sob licença MIT. Isso significa download, modificação e uso comercial sem restrição, o que nenhum dos outros quatro fez em 2026 nesse nível.
| Benchmark | DeepSeek V4.1-Flash | Kimi-K3 | GLM-5.3 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 3.0 | 30,0 | 17,7 | 28,3 | 43,3 | 34,4 |
| DeepSWE v1.1 | 74,2 | 67,5 | 66,9 | 74,0 | 73,0 |
| CyberGym | 88,1 | 80,0 | 84,5 | 84,5 | n/d |
| Automation-Bench | 54,8 | 46,7 | 48,8 | 50,3 | 45,8 |
O V4.1-Flash ganha em DeepSWE (74,2 contra 74,0 do Opus 5), em CyberGym (88,1 contra 84,5 dos dois melhores concorrentes) e em Automation-Bench (54,8 contra 50,3 do Opus 5). Perde em Terminal-Bench 3.0, com 30,0 contra 43,3 do Opus 5. O mesmo padrão do Hydrogen: ganha em volume de agente e perde em terminal.
E onde o DeepSeek realmente corre, e o motivo do título, é o preço. A API custa US$ 0,15 por milhão de entrada e US$ 0,60 por milhão de saída fora de pico, com US$ 0,003 no cache hit. De madrugada, o cached input e o preco mais barato que já se viu em modelo de fronteira com esse nível de intelligence.
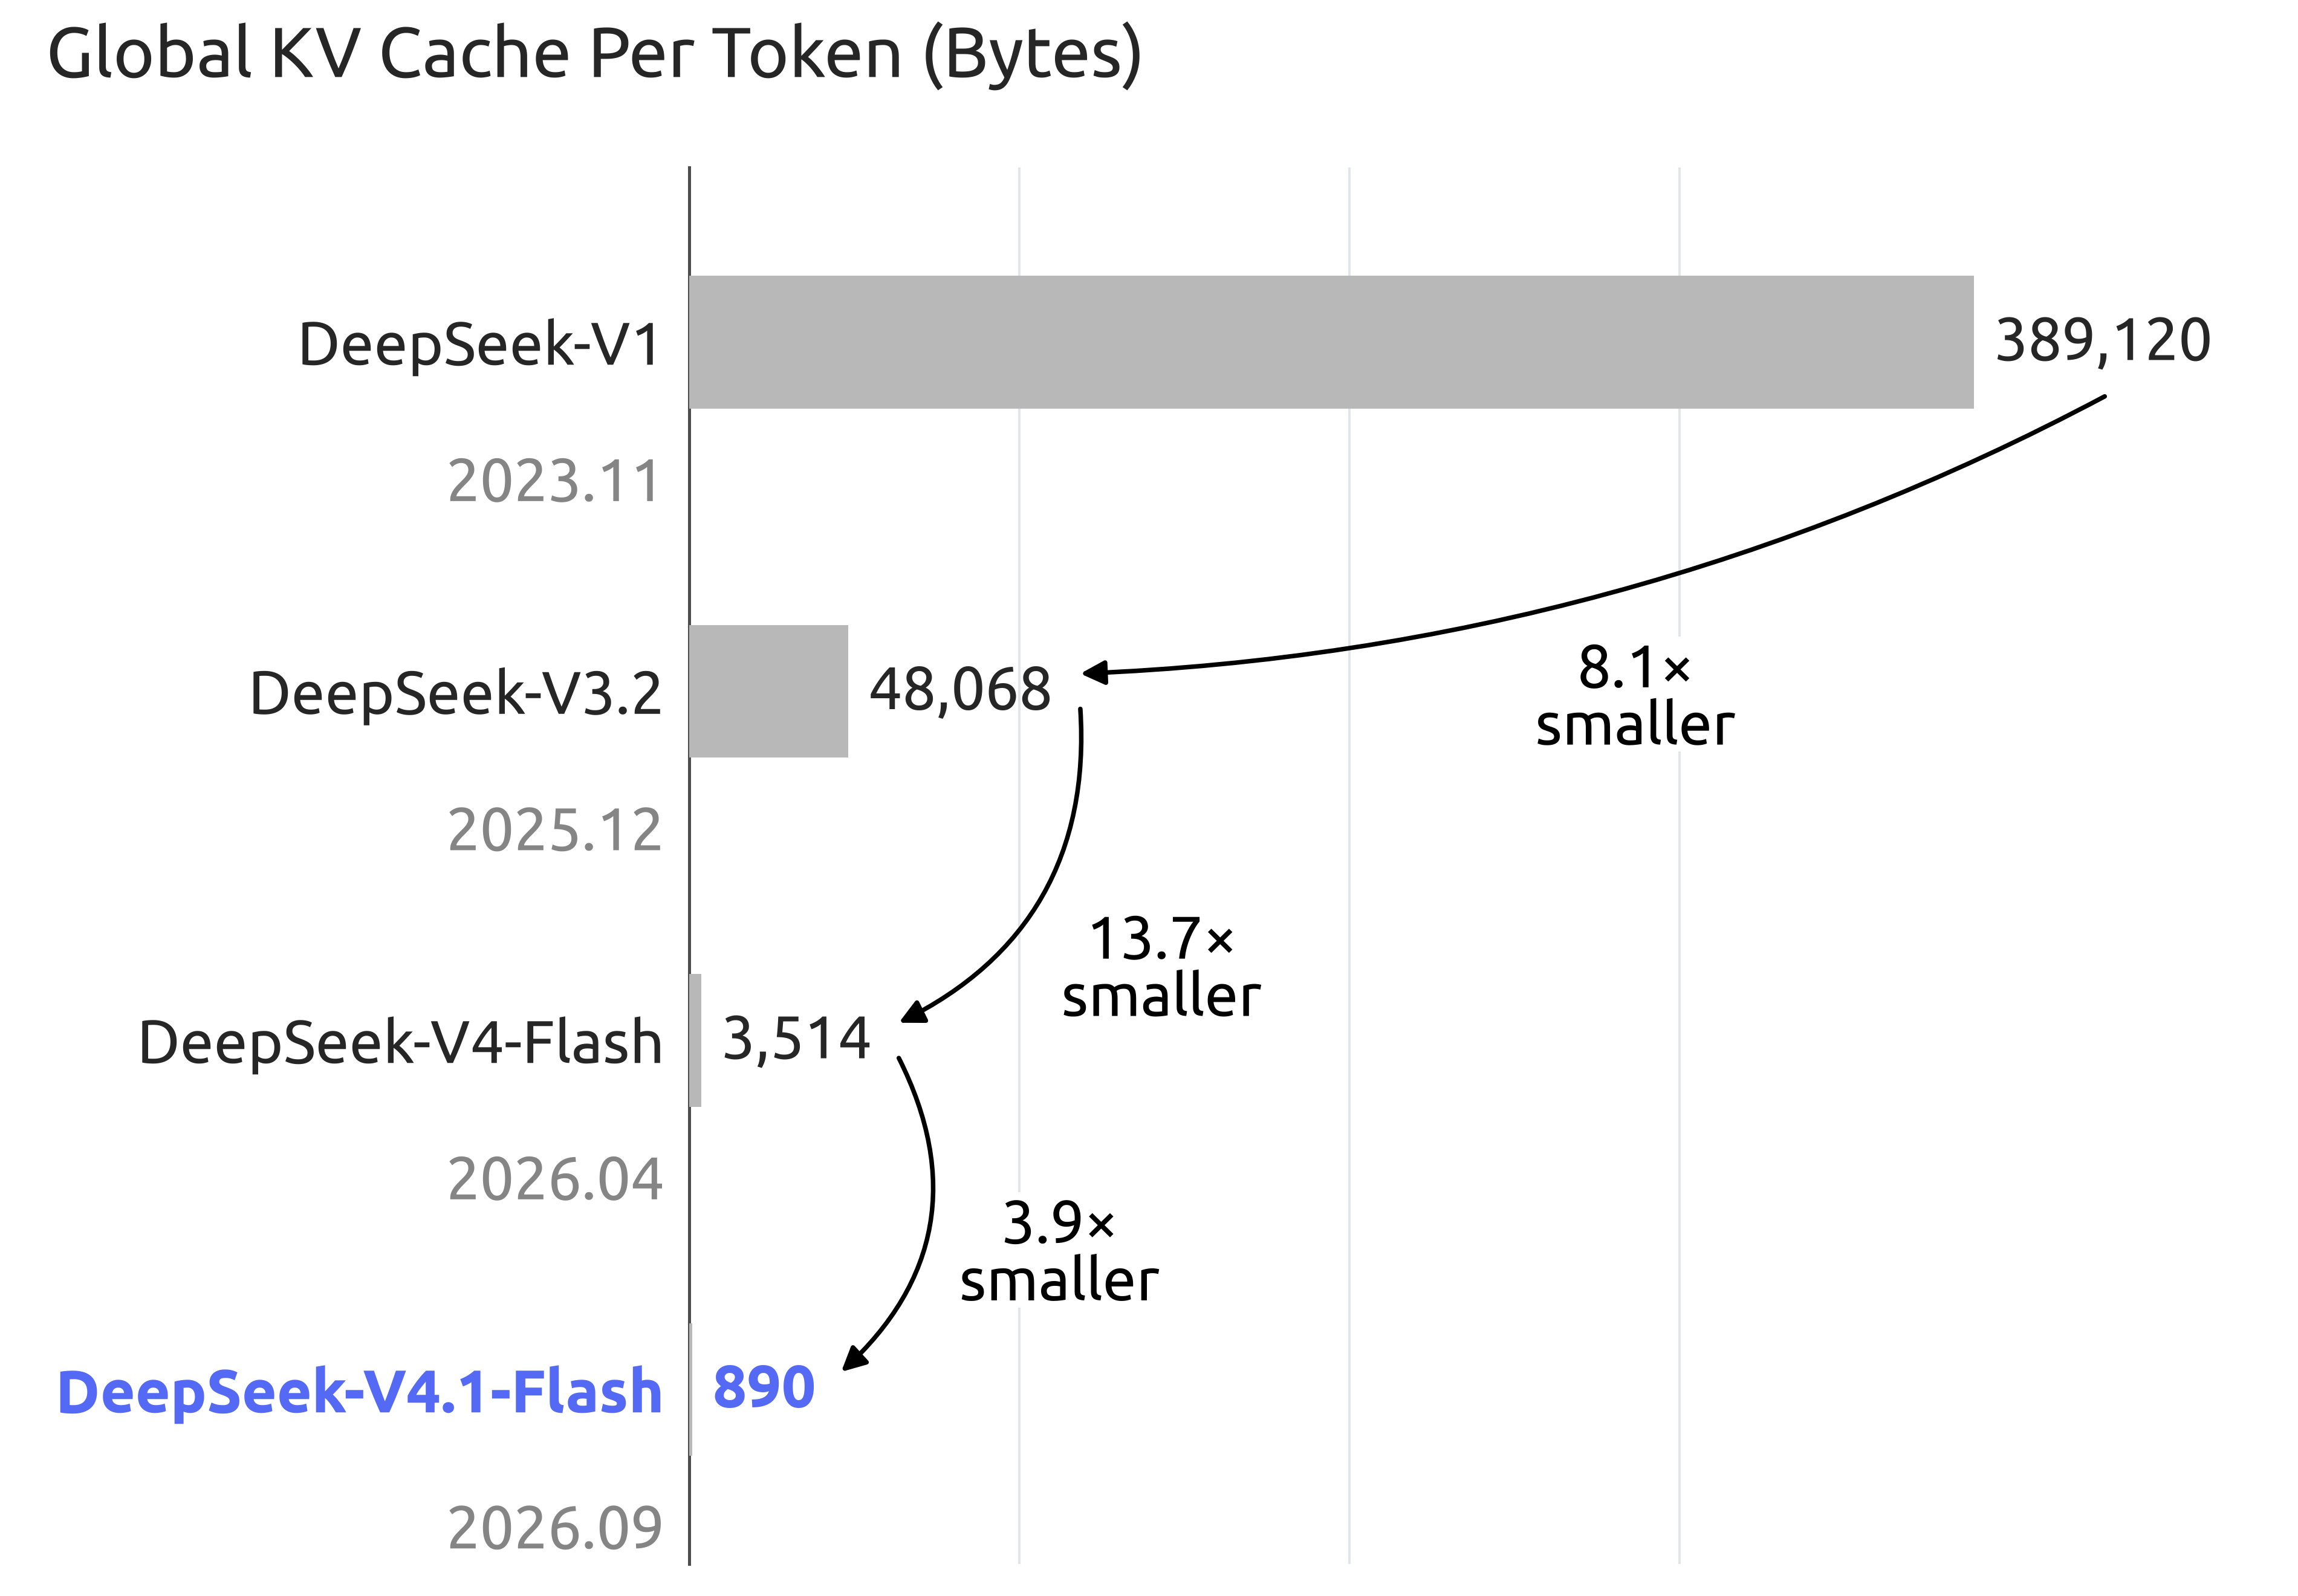
A figura do cache KV explica o preco. O DeepSeek fez a memória de contexto cair de 389.120 bytes por token no V1 para 890 bytes no V4.1-Flash, um fator de 437. Com 1 milhão de tokens, são 890 MB de cache em vez de 389 GB. Isso e o que torna a janela de 1 milhão de tokens viavel em produção, e o motivo de o preco de saída ser US$ 0,60.
Depois do lancamento veio o boom: o V4-Pro foi aposentado e todas as requisicoes passaram a ser roteadas para o V4.1-Flash, com o preco do novo. E a arquitetura mudou de familia: o V4.1-Flash usa um encoder causal de 20 camadas mais um decoder de 20, com 552 bilhões de parâmetros de backbone e 196 bilhões de memória Engram, ativando 8 bilhões no prefill e 16 bilhões no decode.
Alibaba: a unica que abriu a arquitetura antes do modelo
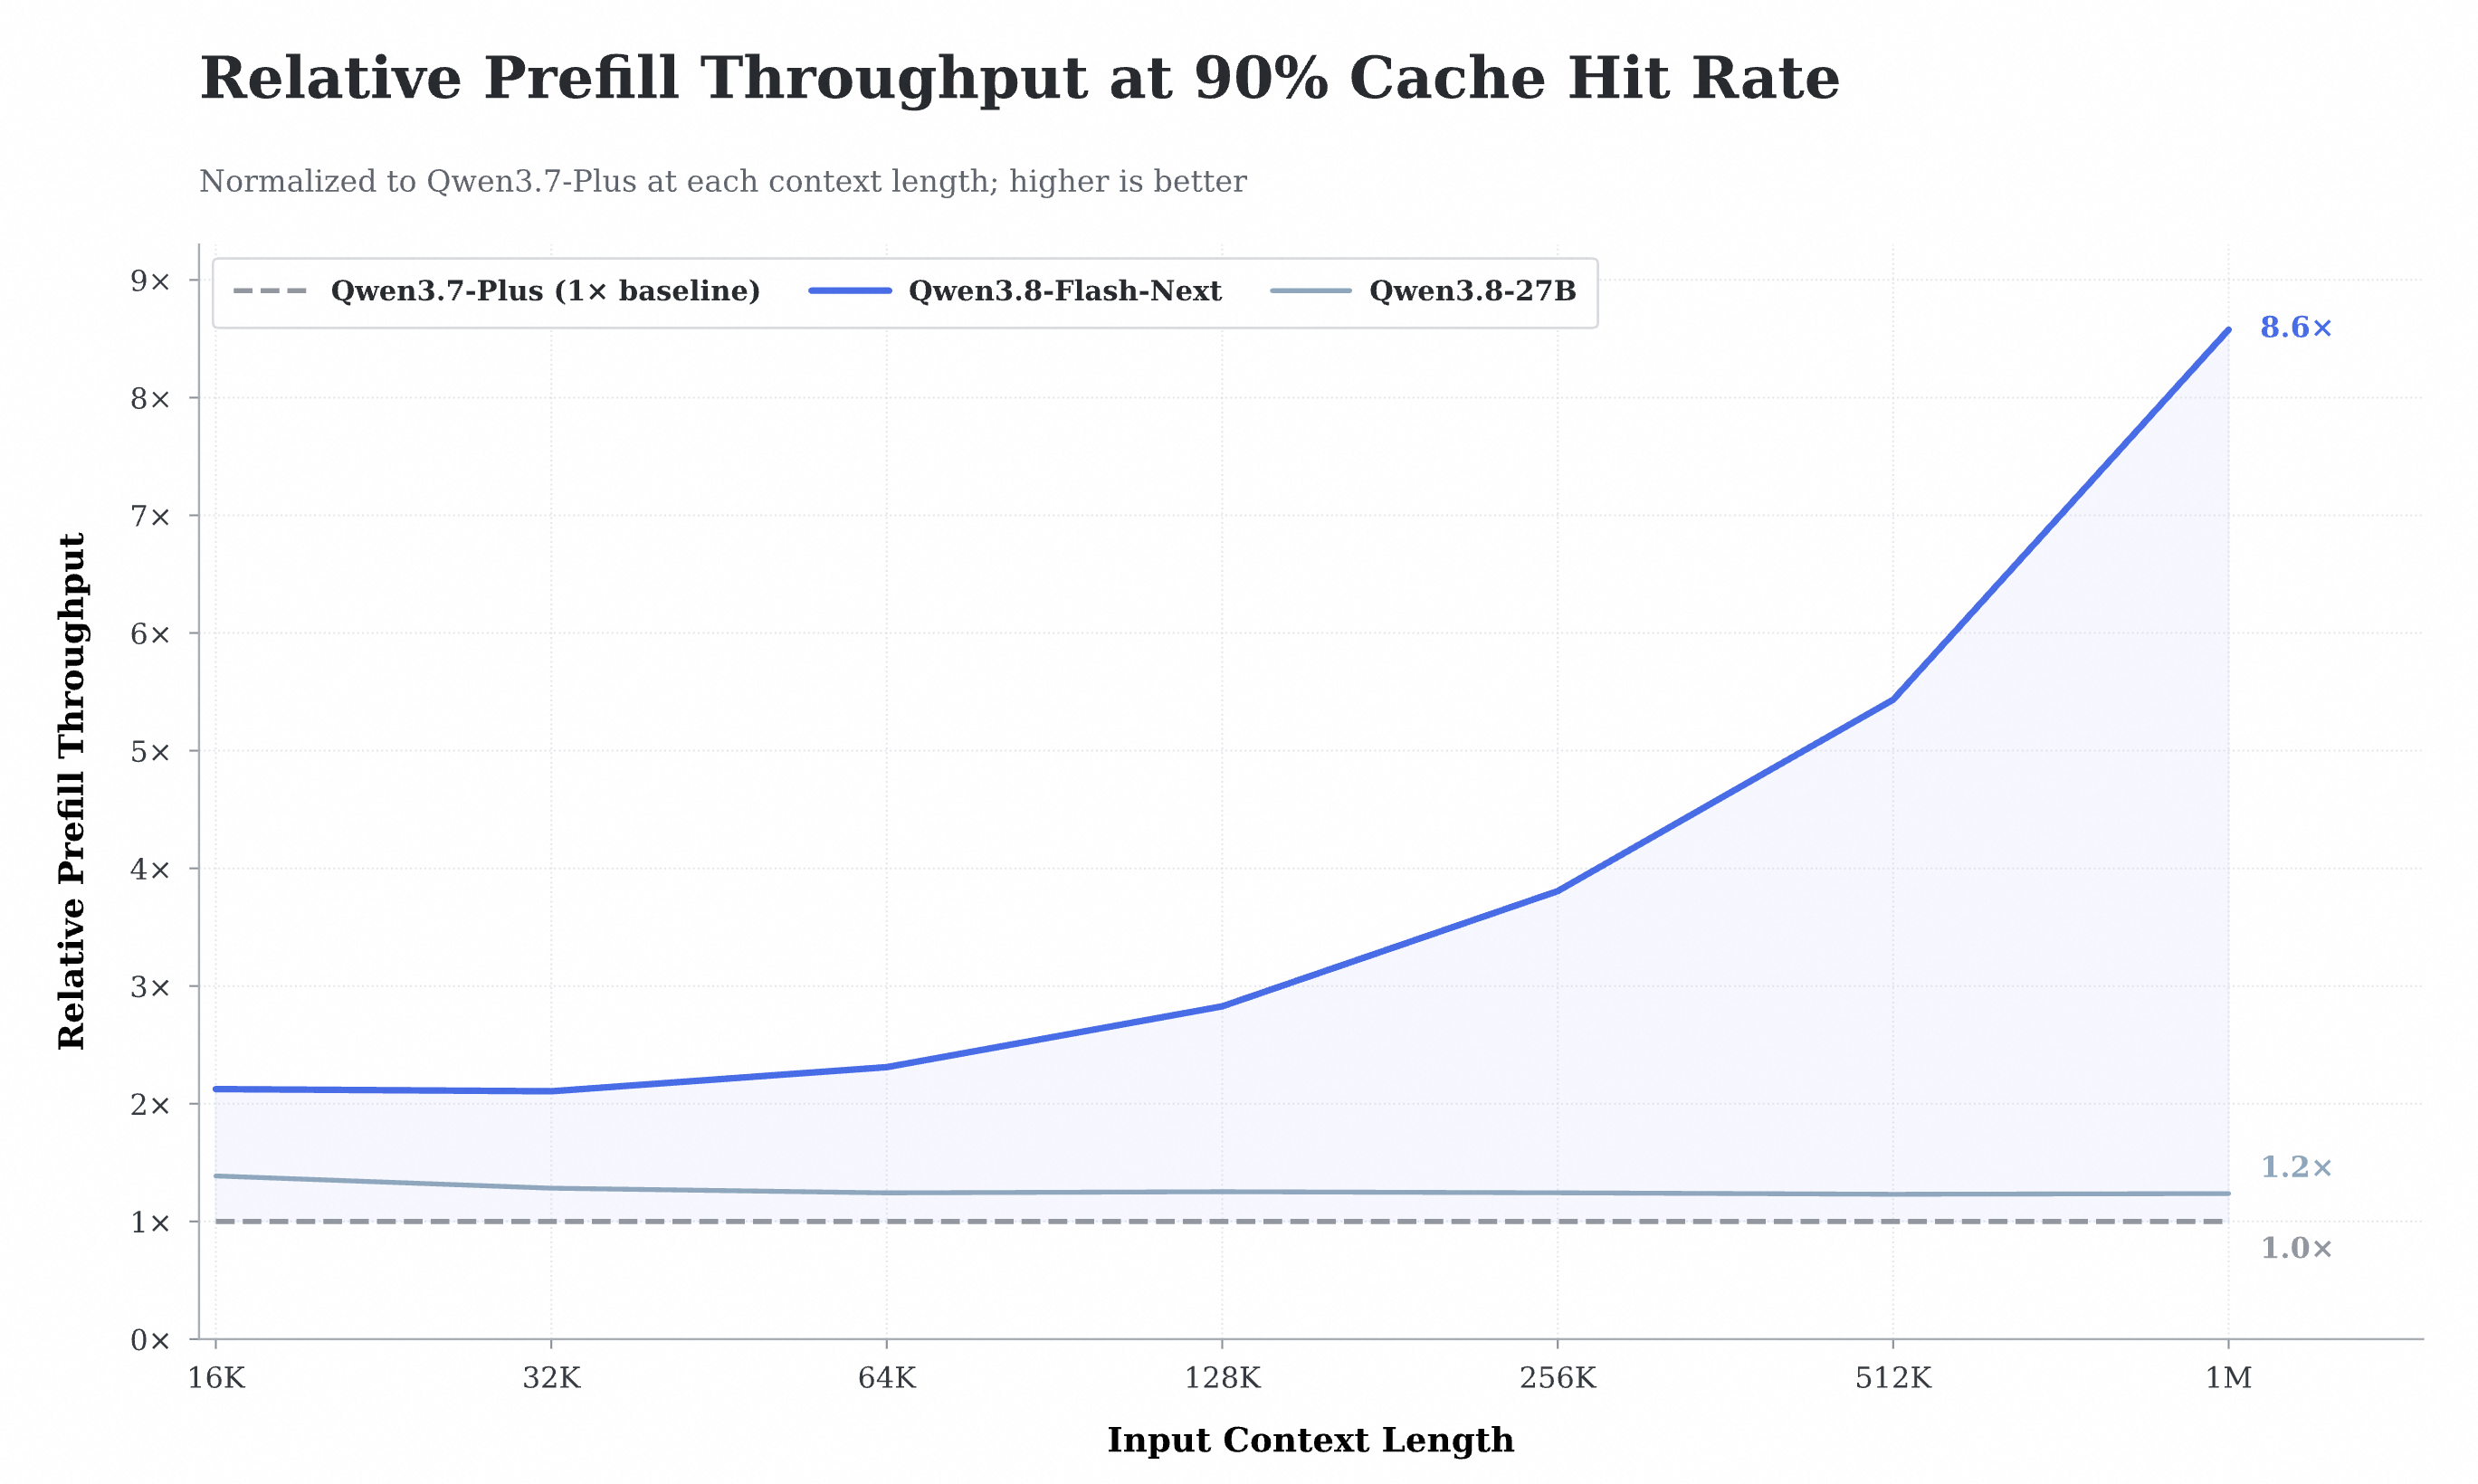
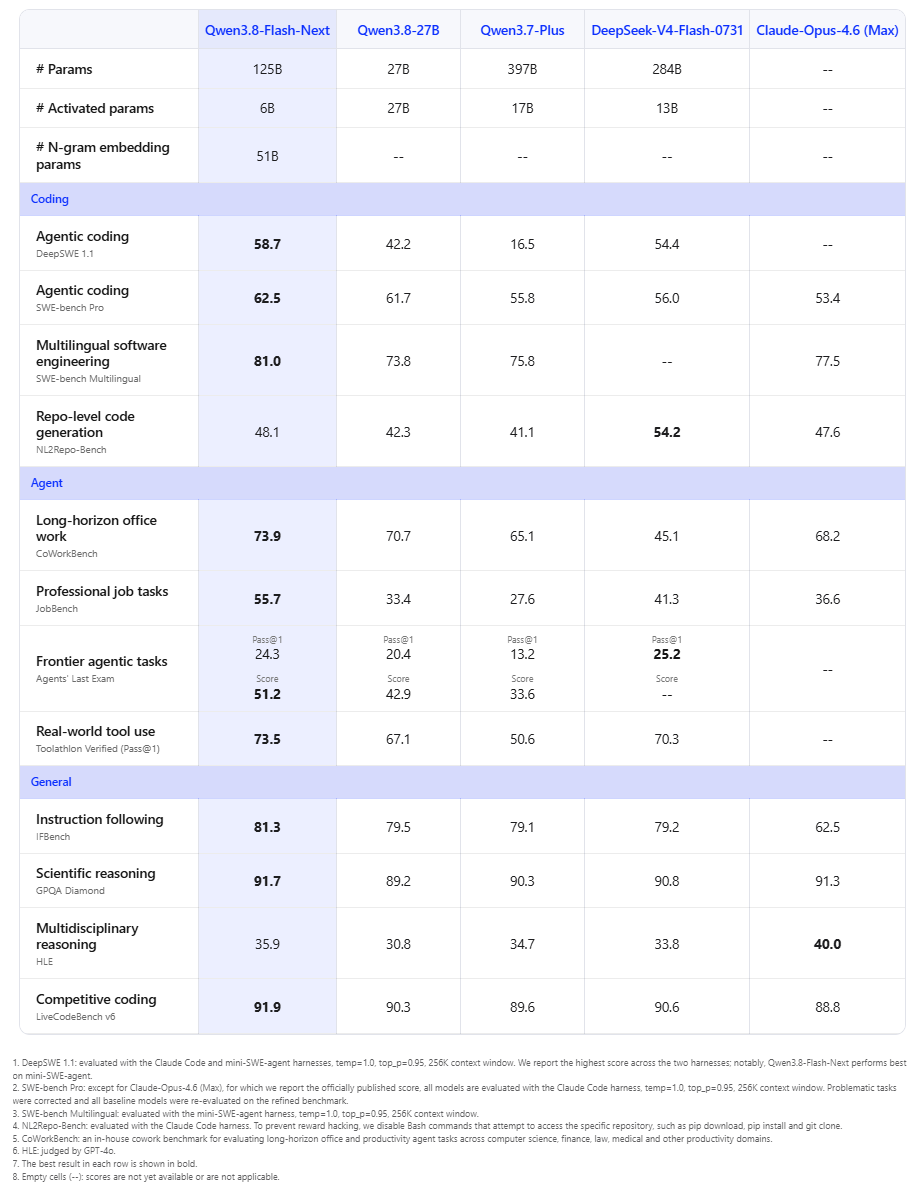
A Alibaba fez a jogada mais interessante do ponto de vista de engenharia. Em vez de lançar so o modelo, o Qwen3.8-Flash-Next abriu os pesos como preview da arquitetura do Qwen4. O blog oficial diz: lancam as mudancas de arquitetura cedo para que a comunidade possa examinar antes de a familia Qwen4 ser construida em cima delas.
Em 11 de novembro, dois dias antes do fim da janela deste post, a mesma empresa abriu o Qwen4-Max-Preview, e o contraste com tudo o que veio antes e didatico. O modelo mais novo da Alibaba saiu sem pesos, sem benchmarks, sem model card e sem preco por token, acessivel apenas pela assinatura Token Plan, com uma janela de previa que termina em 25 de novembro, quando ele sera descontinuado. E um slide da conferencia Apsara mostrou Qwen4-Max, Qwen4-Plus, Qwen4-Flash e Qwen4-27B como “Coming Soon”. Quem quiser o detalhamento completo esta no post dedicado ao Qwen4-Max-Preview.
Quatro mudancas estruturais: atenção GDN + QSA, com Gated DeltaNet comprimindo o histórico e Qwen Sparse Attention selecionando contexto relevante em granularidade de micro-bloco; residual Gated Residual, que abre o fluxo residual em 4 ramos com portao dinamico; N-gram Embedding, que consulta uma tabela usando contexto local e pode ser descarregada na memória do host; e o otimizador Muon, refit around da escala para a nova arquitetura.
| Modelo | Parametros | Ativos | Contexto | Preço (US$/milhão) |
|---|---|---|---|---|
| Qwen3.8-Max | 2,4 trilhões (MoE) | ~95 bilhões | 1M | n/d |
| Qwen3.8-Max-0902 | 2,4 trilhões (MoE) | ~95 bilhões | 1M | n/d |
| Qwen3.8-Flash-Next (aberto) | 125 bilhões + 51B de embedding | 6 bilhões | 262 mil (1M com YaRN) | 0,16 / 0,47 |
| Qwen3.8-27B (aberto) | 27 bilhões, denso | 27 bilhões | 1M | n/d |
Nos benchmarks oficiais da Alibaba, o Qwen3.8-Flash-Next ganha em 10 das 12 comparações contra o Claude Opus 4.6, com 125 bilhões de parâmetros e apenas 6 bilhões ativos por token. O preco de US$ 0,16 de entrada e US$ 0,47 de saída coloca o Qwen3.8-Flash entre o DeepSeek e o Gemini Hydrogen no custo, e abaixo do Claude em ordem de grandeza.
O que impressiona e a eficiencia: 6 bilhões de parâmetros ativos entregando 58,7 no DeepSWE 1.1, contra 54,4 do DeepSeek-V4-Flash com 13 bilhões ativos. Para quem roda agente em volume, essa e a conta que importa.
A tabela que resume tudo
Precos de entrada e saída, contexto e disponibilidade dos pesos, lado a lado. Todos os valores são de lista publica, em dolares por milhão de tokens.
| Modelo | Entrada | Saida | Cache hit | Contexto | Pesos abertos |
|---|---|---|---|---|---|
| DeepSeek V4.1-Flash | 0,15 | 0,60 | 0,003 | 1M | Sim, MIT |
| Qwen3.8-Flash | 0,16 | 0,47 | n/d | 1M | Sim |
| Gemini 4 Hydrogen | 1,50 | 7,50 | 0,075 | 1M | Não |
| Grok 4.7 | 2,00 | 6,00 | 0,50 | 500 mil | Não |
| Gemini 4 Argon | 2,00 | 10,00 | 0,10 | 1M | Não |
| Claude Sonnet 5.5 | 2,00 | 10,00 | 0,20 | 1M | Não |
| Claude Opus 5.5 | 4,00 | 20,00 | 0,20 | 1M | Não |
| Claude Fable 5.2 / Mythos 5.2 | 5,00 | 25,00 | n/d | 1M | Sim, 33,1B |
Existe uma diferença de 33 vezes entre o mais barato e o mais caro na entrada, e a mesma proporcao mais apertada na saída. O Fable 5.2 a US$ 5 e o DeepSeek a US$ 0,15 não são o mesmo produto. O que mudou em 2026 e que essa faixa de precos agora cobre modelos que, no comeco do ano, eram o topo absoluto.
Tres leituras do cenario
1. A competencia se deslocou do topo para o meio. O Anthropic não lancou um modelo mais inteligente em novembro, lancou um mais barato. O Google não lancou um modelo mais inteligente, lancou um mais barato. O xAI lancou o mesmo preco com uma base maior. O argumento comercial das três empresas mais grandes sobre o discurso da fronteira foi mesmo poder, menos dinheiro, não mais poder.
2. Quem abriu os pesos ganhou o preco, e o preco virou o novo topo. O DeepSeek e o Qwen estao duas ordens de grandeza abaixo da Anthropic e do Google em custo por token, e o DeepSeek ainda ganha em CyberGym e DeepSWE. Quem mantem a API fechada agora vende intelligence a US$ 1,50 ou US$ 2 por milhão, e um open-weight chega a US$ 0,15. A assimetria se inverteu: o modelo aberto virou a opcao barata e o fechado virou a opcao cara.
3. O Google está usando a familia para segmentar, os outros estao usando para iterar. Tres modelos em 15 dias, com papeis definidos (fronteira, uso geral, execução), e preços que cobrem três. A Anthropic lancou a familia 5.5 inteira com um dia de intervalo. A xAI lancou uma versão. A Alibaba lancou uma familia inteira e abriu a arquitetura antes do modelo. Ninguem mais tao no modelo de lancamento rapido.
O que fazer com isso na prática
Se você integra API, três regras economizam dor de cabeca:
- Trave o identificador do modelo. Use o ID fixo, nunca o alias. Se quiser o último, troque de proposito e registre a mudanca.
- Reavalie o custo por tarefa, não o preco por token. O Artificial Analysis mede custo por tarefa e tempo por tarefa, e a ordem de grandeza e diferente. O Sonnet 5.5 e caro por token e muito mais caro por tarefa, porque consome muitos tokens.
- Escolha o nível de thinking por etapa do fluxo, não por padrão. O Hydrogen em medium custa US$ 0,80 por tarefa e em xhigh custa US$ 3,16. Sao quatro valores, e o erro comum e deixar o máximo ligado o tempo todo.
E se você ainda não sabe o que comparar, o Artificial Analysis recalcula o índice de inteligência v5.0.1 toda semana, com avaliacoes publicas e metodologia aberta. A classicao de hoje e a de hoje, não a de daqui a um mes. Dado o ritmo, isso já e uma forma de acompanhar o setor.
Perguntas Frequentes (FAQ)
Quantos modelos de IA foram lancados em 2026?
So entre 10 de setembro e 12 de novembro, o grupo formado por Anthropic, Google, xAI, Alibaba e DeepSeek lancou 11 modelos de fronteira em 64 dias. Contando os lancamentos de menor repercussao, como o Qwen3.8-27B, o Qwen3.8-Flash-Next, o DeepSeek-V4-Flash, o Claude Haiku 5.5 e o Gemini 3.8 Flash, o total passa de 19. O número e quase o dobro do que o Google sozinho lancou na mesma janela.
Por que o DeepSeek aposentou o V4-Pro?
Porque o V4.1-Flash o superou em desempenho, custo e velocidade. A documentacao oficial diz que o V4.1-Flash “compreensivamente superou o V4 Pro em desempenho, custo, velocidade e tempo total”. A partir de 14 de setembro de 2026, todas as chamadas para deepseek-v4-pro passaram a ser servidas pelo V4.1-Flash e cobradas no preco do V4.1-Flash, até a chegada de um V4.1-Pro, para o qual não foi anunciada data.
Qual e o preco mais barato de entrada em um modelo de fronteira?
US$ 0,15 por milhão de tokens no DeepSeek V4.1-Flash fora de pico, caindo para US$ 0,003 no cache hit. O Qwen3.8-Flash vem logo atras, a US$ 0,16. No outro extremo, o Claude Fable 5.2 e o Mythos 5.2 custam US$ 5 por milhão, o que faz o barato ser 33 vezes mais barato que o caro. O preco de saída tem amplitude menor, de US$ 0,60 a US$ 25.
Quais modelos tem pesos abertos e podem rodar local?
No periodo analisado, três: o DeepSeek V4.1-Flash sob licenca MIT, o Qwen3.8-Flash-Next e o Qwen3.8-27B da Alibaba, e o Claude Fable 5.2 e o Mythos 5.2 da Anthropic com 33,1 bilhões de parâmetros. O DeepSeek e o Qwen abriram como estratégia de produto, com documentacao técnica e arquitetura publicadas. O Anthropic abriu so dois modelos especificos, com foco em pesquisa matematica e ciencias da vida, não como política geral de abertura.
Como o preco do Gemini 4 Argon muda em dezembro?
O Argon foi lancado em 13 de outubro a US$ 2 por milhão de tokens de entrada e US$ 10 de saída, com entrada em cache a 95% de desconto. Depois de 30 de novembro de 2026 o preco sobe para US$ 4 e US$ 20, o mesmo patamar do Carbon. Se sua planilha assume o preco de lancamento, atualize antes do dia 1º de dezembro.
Qual modelo está no topo do Artificial Analysis Intelligence Index hoje?
Na versão 5.0.1, o Claude Fable 5.2 no max marca 65 pontos, seguido do Claude Fable 5.2 no xhigh com 62 e o Gemini 4 Carbon no high com 60. O Claude Opus 5.5 marca 59, o GPT-6 Astra 57 e o Claude Fable 5.2 no medium 56. O indice e recalculado com frequencia e a ordem muda entre semanas, então vale checar a fonte antes de citar qualquer número.
Usar alias de modelo e perigoso?
Depende do que você quer. O alias existe para receber a última versão automaticamente, e isso e util quando você quer o melhor modelo sem se preocupar com versionamento. O risco e quando o modelo muda embaixo da sua aplicação sem você pedir: o caso do DeepSeek aposentar o V4-Pro e o exemplo mais claro, com código quebrado em uma mudanca de modelo feita pelo fornecedor. A prática segura e fixar o identificador e registrar o que você usa.
O que significa saída unificada e por que a janela de 1 milhão virou padrão?
Saida unificada e o esquema em que entrada, raciocínio e saída somam na mesma janela de tokens, em vez de janelas separadas. Com 1 milhão de tokens unificados, o total disponivel e a soma das três, o que permite entrada grande com saída grande. Em 2026 isso virou padrão entre Anthropic, Google, Alibaba e DeepSeek. A xAI ficou em 500 mil tokens, a unica do grupo a ficar abaixo.
Por que o cache de contexto importa tanto no preco?
Porque agente le contexto o tempo todo. Ler a mesma informação de novo e o trabalho principal de um agente, e o preco do cache hit e uma fraccao do preco de entrada normal. No DeepSeek V4.1-Flash, o cache hit custa US$ 0,003 por milhão, mil vezes menos que a entrada comum. E compressao de cache e o que torna a janela de 1 milhão viavel: o DeepSeek caiu de 389.120 bytes por token no V1 para 890 bytes no V4.1-Flash.
Com qual modelo eu comeco se nunca usei uma API de fronteira?
Com o nível de raciocínio mais baixo que resolve a tarefa, nunca com o máximo ligado. O Gemini 4 Hydrogen em medium custa US$ 0,80 por tarefa e o Qwen3.8-Flash custa US$ 0,16 por milhão de entrada. Se a tarefa e de agente com volume alto, comece no mínimo e suba so onde a qualidade extra pagar. O erro mais comum não e escolher o modelo errado, e deixar o nível de raciocínio máximo ligado em toda chamada.
Referencias consultadas
- Artificial Analysis LLM Leaderboard, índice de inteligência v5.0.1
- Introducing Gemini 4 Hydrogen for Agentic Workflows (Google DeepMind)
- Introducing Gemini 4 Argon (Google DeepMind)
- Introducing Gemini 4 Carbon (Google DeepMind)
- Introducing Claude Opus 5.5 (Anthropic)
- Claude Opus 5.5, documentacao oficial (Anthropic)
- Introducing Grok 4.7 (SpaceXAI)
- Release Notes da API do SpaceXAI
- DeepSeek Research and News
- DeepSeek-V4.1-Flash, model card e relatorio técnico (Hugging Face)
- Qwen3.8-Flash-Next: A New Architecture (Alibaba Cloud)
- Ciclo de vida e atualizacoes de modelos do Alibaba Cloud Model Studio
Posts relacionados deste site: Gemini 4 Hydrogen: o primeiro Gemini 4 liberado para todo mundo, Gemini 4 Carbon: o modelo mais forte do mundo que ninguem pode comprar, Anthropic lanca Claude Fable 5.2 e Mythos 5.2 e MiniMax H3-Image: 16 megapixels em 10 segundos com pesos abertos.