
O Google DeepMind acaba de lançar o EmbeddingGemma 2, um modelo de embeddings nativamente multimodal com 740 milhões de parâmetros que cabe no celular, é open-source sob Apache 2.0 e roda texto, código, imagens, vídeo e áudio num único espaço vetorial de 768 dimensões. Tudo isso com ~191 MB de RAM ativa para o subconjunto só-texto e ~567 MB no Pixel 11 Pro para o modelo multimodal completo.
Um modelo de 740M que entrega 78.68 no MTEB Code e só perde para o Qwen3-Embedding-8B, que é dez vezes maior. A nova versão também destrói o antecessor em +9.92 pontos nessa mesma métrica, e mantém o legado de texto multilíngue intacto. Foi de 300M com 2K de contexto para 740M com 8K, e ainda assim foi pensado para rodar dentro do seu bolso.
O que é EmbeddingGemma 2, afinal
Embedding é a função que transforma qualquer coisa, texto, código, imagem, vídeo, áudio, em um vetor de números que captura o significado daquela coisa. Itens parecidos ficam com vetores parecidos no espaço geométrico, e é isso que alimenta busca semântica, recomendação, clustering e o passo de “retrieval” em qualquer pipeline de RAG.
EmbeddingGemma é a família open-weight do Google DeepMind focada em embeddings pequenos e eficientes. A primeira versão saiu em 2025 com 300M, só texto, 2K de contexto, e bateu 20 milhões de downloads em pouco mais de um ano. A comunidade usou em tudo: extensões de navegador que recuperam páginas, busca semântica em apps mobile, RAG privado em laptops. O lançamento de hoje é a segunda geração, e o salto é brutal.
O EmbeddingGemma 2 é construído por cima da arquitetura Gemma 4, usa a mesma tecnologia dos modelos Gemini Embedding e é distribuído sob Apache 2.0, uso comercial liberado, sem a letra miúda do Gemma Terms da v1.
Os 5 números que importam
- 740 milhões de parâmetros totais, 270M de backbone de texto, +170M para visão, +300M para áudio. Você só carrega o que precisa.
- 8K tokens de contexto, 4x maior que a v1. Cabe 5.5 minutos de áudio, 29 imagens, 58 frames de vídeo, ou uma mistura interleaved.
- Saída nativa de 768 dimensões, truncável via Matryoshka para 512, 256 ou 128. Até 6x de redução de storage no vector DB.
- ~191 MB de RAM ativa no modo só-texto e ~567 MB para multimodal completo no Pixel 11 Pro, com quantização.
- 78.68 no MTEB Code, 9.92 pontos acima da v1 e só atrás do Qwen3-Embedding-8B, que tem 8B de parâmetros.
Como ele é construído
O design é modular por princípio, não por acidente. Um Gemma 4 decompõe em três blocos que você pode carregar ou não, e todos projetam no mesmo espaço vetorial compartilhado de 768 dimensões.
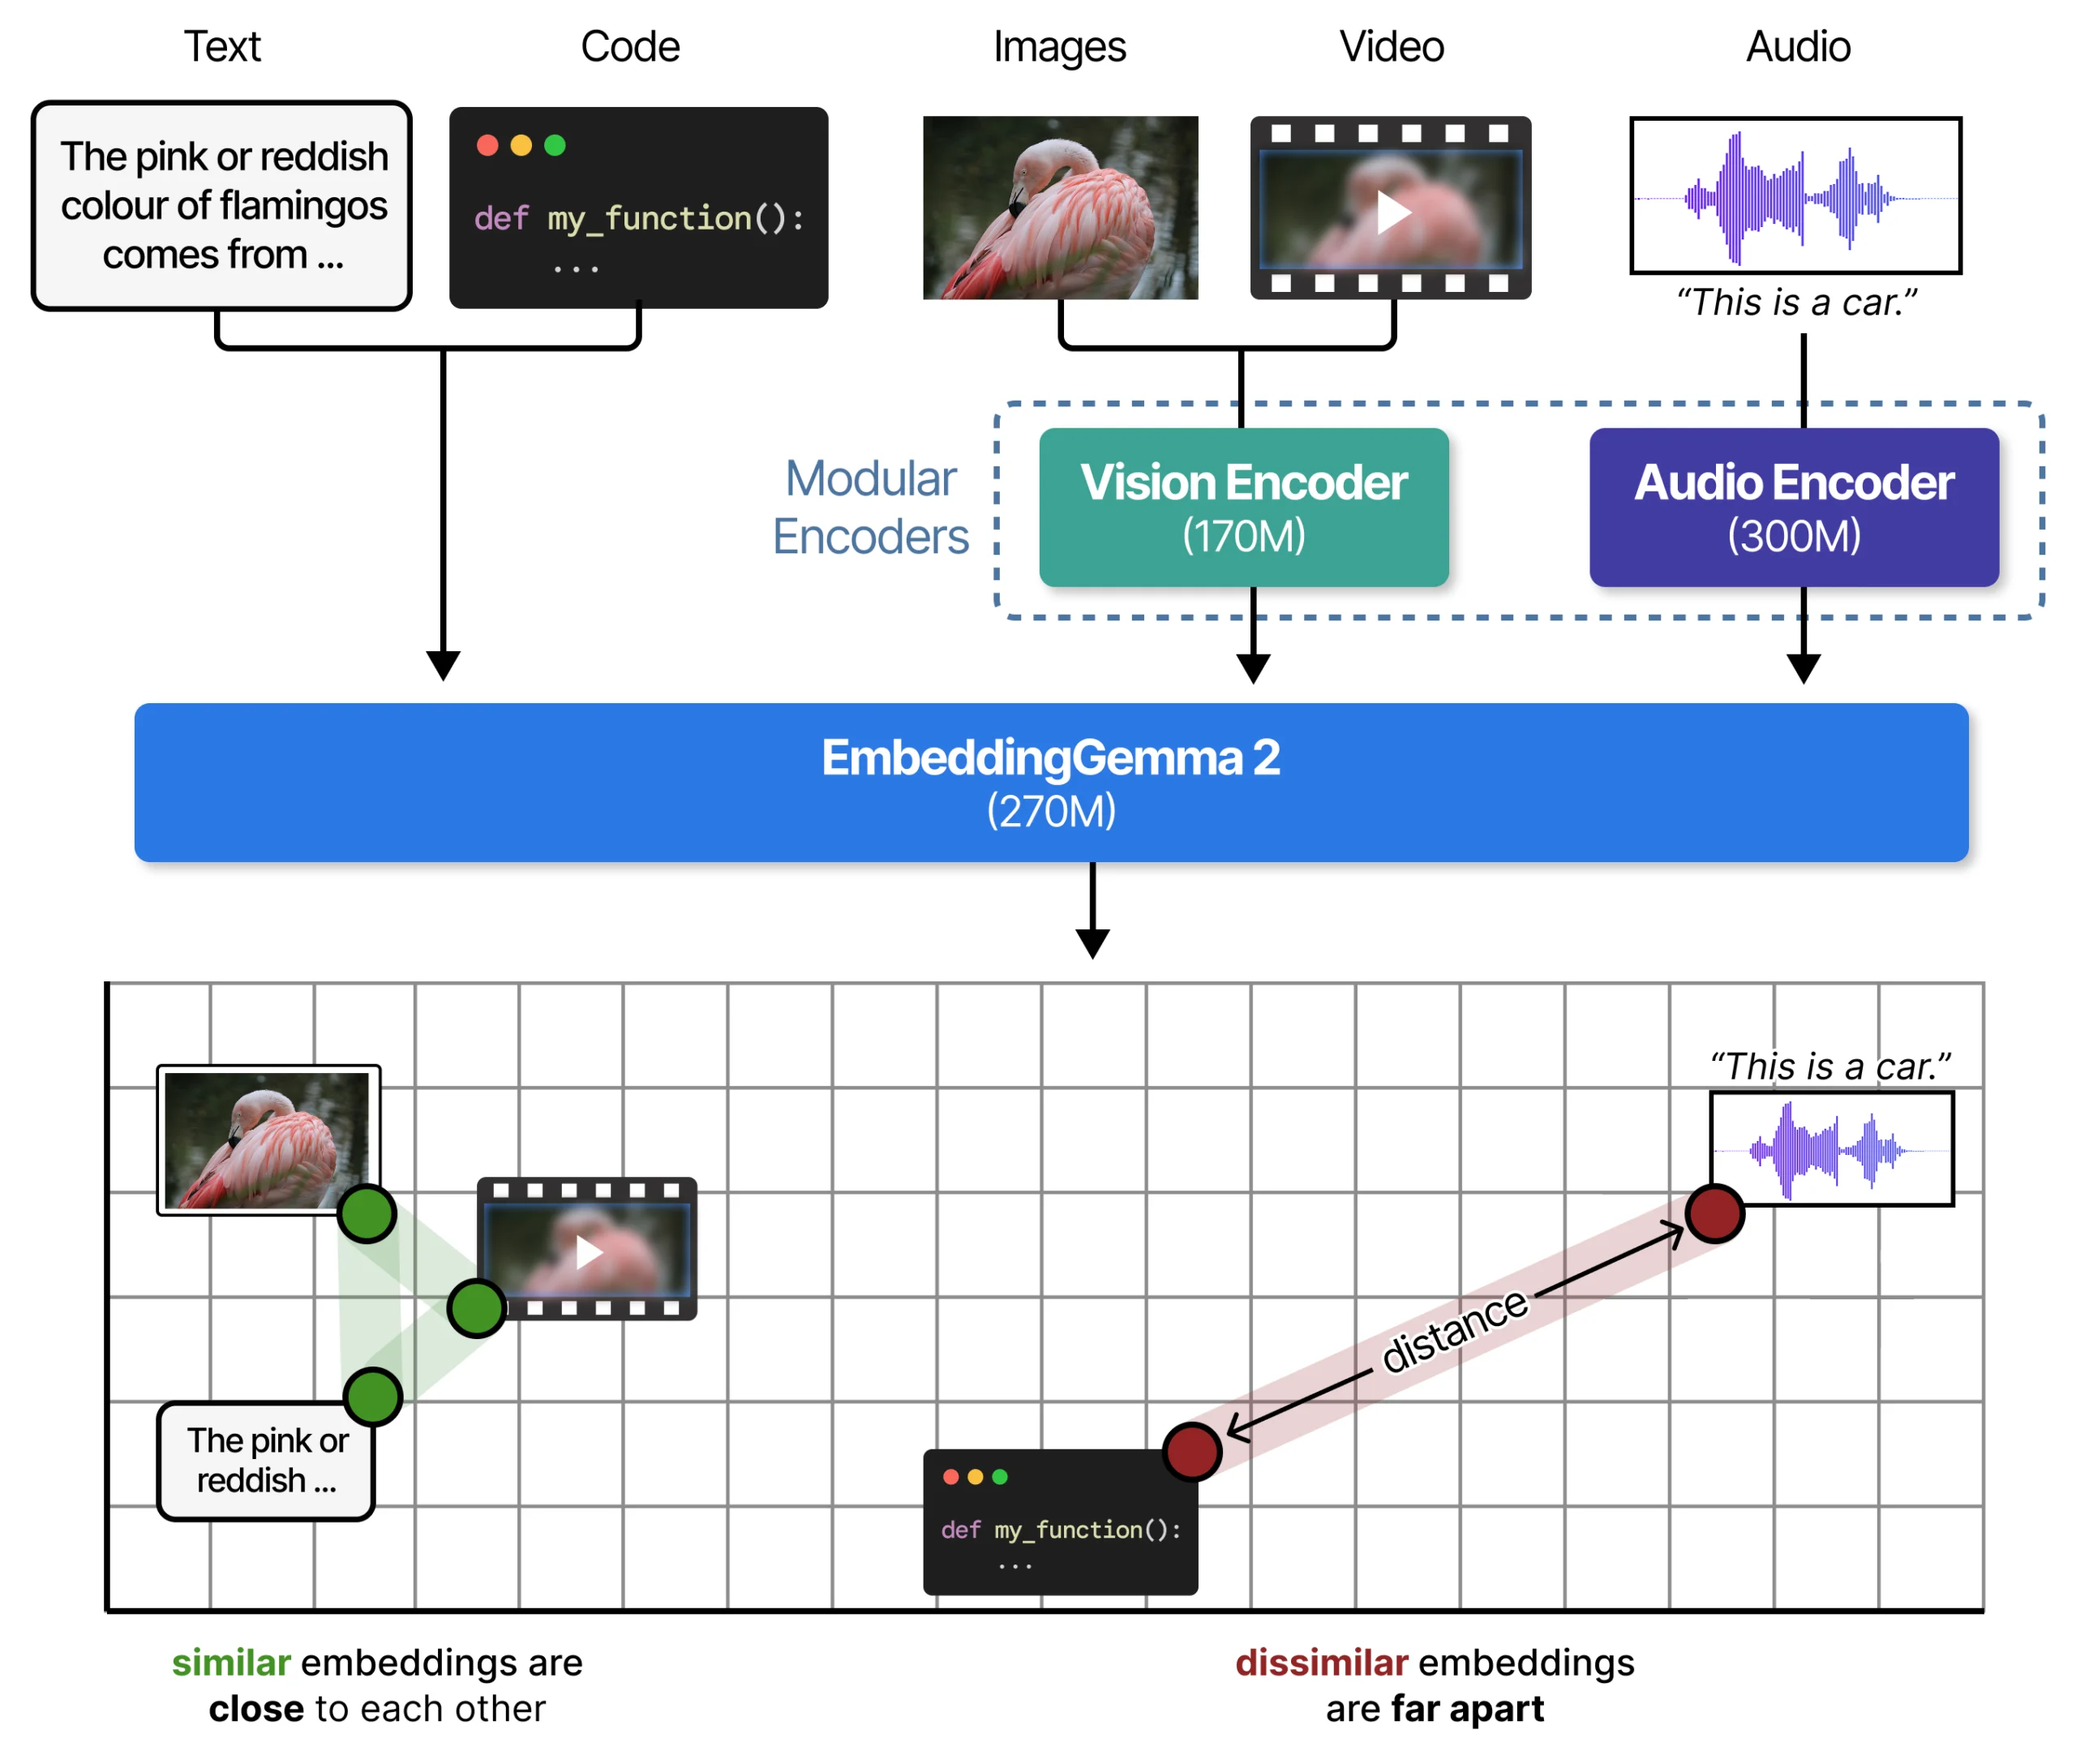
- Backbone texto/código (270M), Gemma 4 decoder adaptado, contexto de 8.192 tokens, projeção 512→768. Cobre texto e código diretamente.
- Vision Encoder (+170M), processa imagens, documentos visuais (PDFs, slides, gráficos) e frames de vídeo.
- Audio Encoder (+300M), encoder dedicado que recebe áudio cru, sem precisar de ASR intermediário.
- Tokenizer e encoder de áudio compartilhados com Gemma 4, quando você empilha EmbeddingGemma 2 + Gemma 4 num pipeline RAG local, o footprint total cai porque os dois modelos compartilham peças.
Configurações modulares
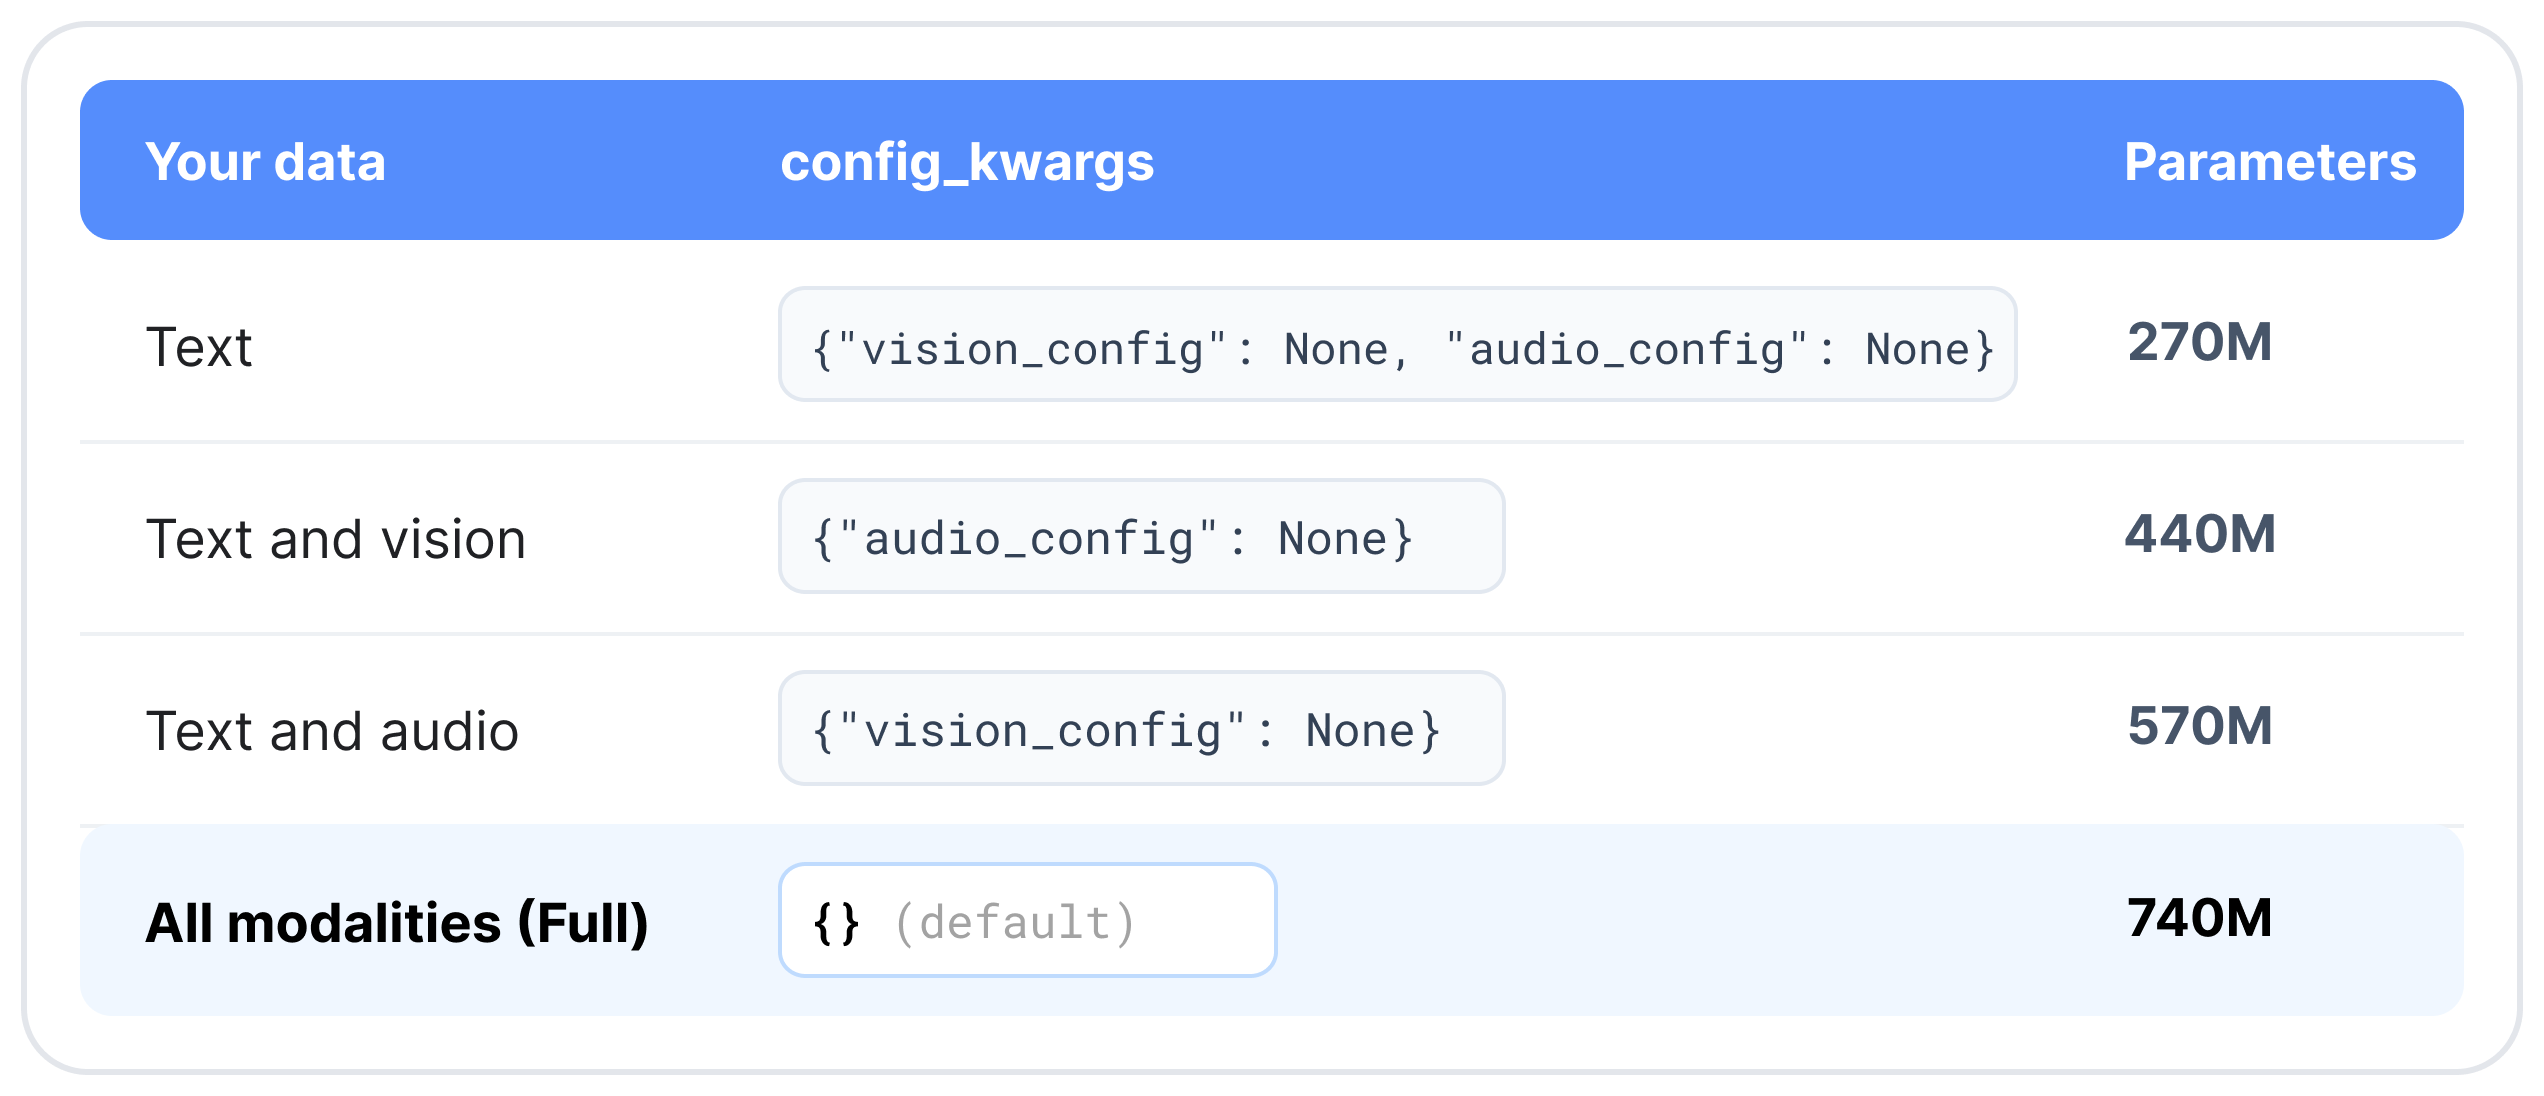
A flexibilidade de carregar só os encoders que você precisa é o que torna EmbeddingGemma 2 viável em hardware de consumidor. Quer busca só em texto de código? São 270M. Quer busca em fotos do celular com query em texto? 440M. Quer um sistema que responde áudio com áudio? 570M. O modelo completo é 740M.
Benchmarks
EmbeddingGemma 2 foi avaliado em 8 benchmarks cobrindo texto, código, imagem, vídeo e áudio. Todos os números abaixo são com checkpoint full-precision em 768d, reportados pela própria equipe no model card.
Tabela geral: vs EmbeddingGemma 1
| Modalidade | Benchmark | Métrica | EmbeddingGemma 2 | EmbeddingGemma 1 |
|---|---|---|---|---|
| Text | MTEB (multilingual, v2) | Mean(Task) | 61.36 | 61.15 |
| Text | MTEB (code, v1) | Mean(Task), NDCG@10 | 78.68 | 68.76 |
| Image | MIEB (lite) | Mean(TaskType) | 64.64 | — |
| Image | MMEB v2 (Image) | Mean(Task), Hit@1 | 57.28 | — |
| Image | MMEB v2 (VisDoc) | Mean(Task), NDCG@5 | 67.84 | — |
| Video | MMEB v2 (Video) | Mean(Task), Hit@1 | 50.67 | — |
| Audio | MSEB (Retrieval) | Mean(Task), MRR@10 | 69.54 | — |
| Audio | MAEB (Hugging Face) | Mean(Task) | 49.39 | — |
O salto mais visível é no código. Em MTEB Code o modelo passa de 68.76 para 78.68, um ganho de 9.92 pontos num benchmark que normalmente anda de poucos décimos por geração. A Google destaca esse número como o carro-chefe e com razão: indexação local de codebase, busca semântica em repositórios e retrieval para coding agents são três casos de uso que acabam de ficar viáveis em hardware pequeno.
MTEB Code: onde o EmbeddingGemma 2 brilha
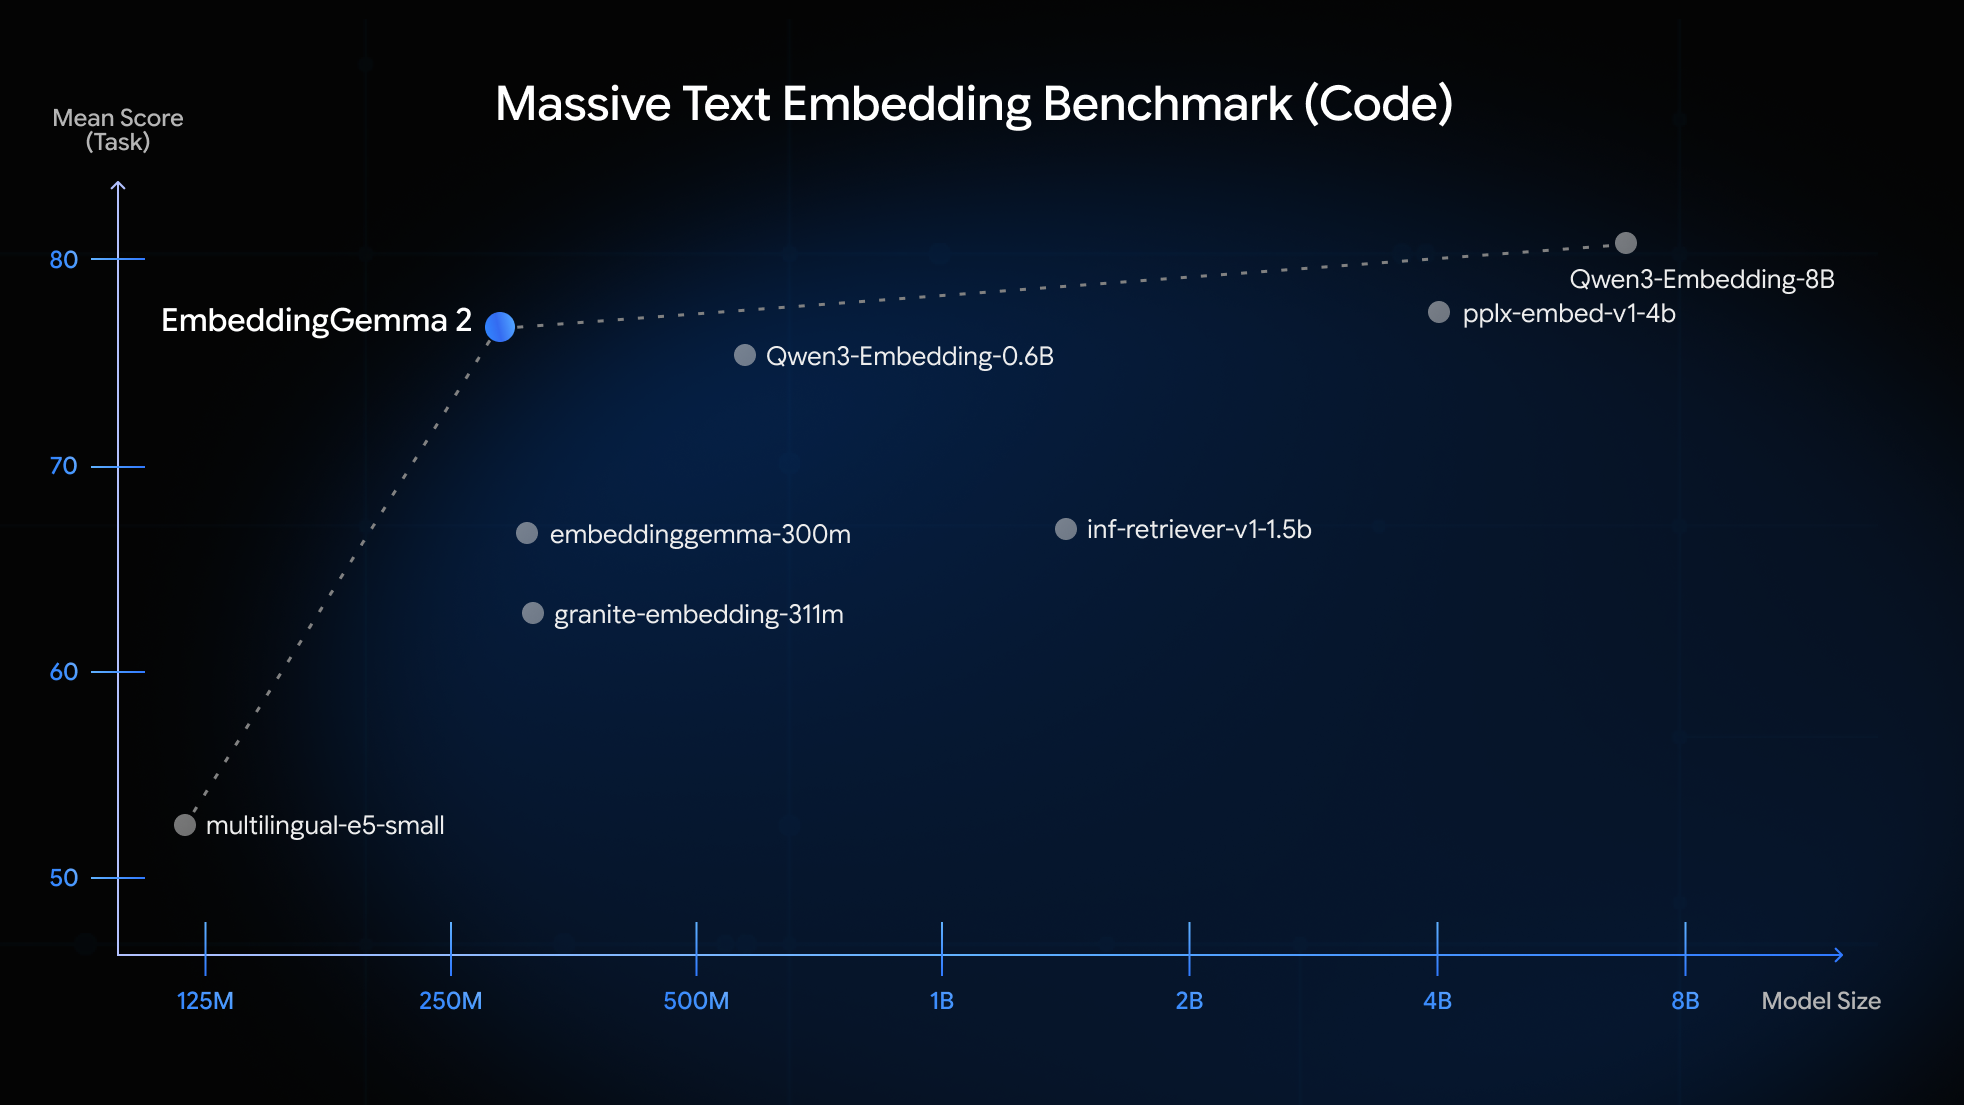
Esse é o gráfico que resume tudo. No eixo X, tamanho do modelo em escala log de 125M até 8B. No eixo Y, score MTEB Code. A linha tracejada é a fronteira aproximada de Pareto. EmbeddingGemma 2 está sentado lá no canto esquerdo superior, em ~300M, com score próximo dos modelos de 4B e 8B. Qwen3-Embedding-0.6B entrega ~75 com 600M; o EmbeddingGemma 2 entrega ~77 com 300M. O único que consistentemente bate ele em code é o Qwen3-Embedding-8B, que tem dez vezes mais parâmetros.
MTEB Multilingual: status quo, não salto
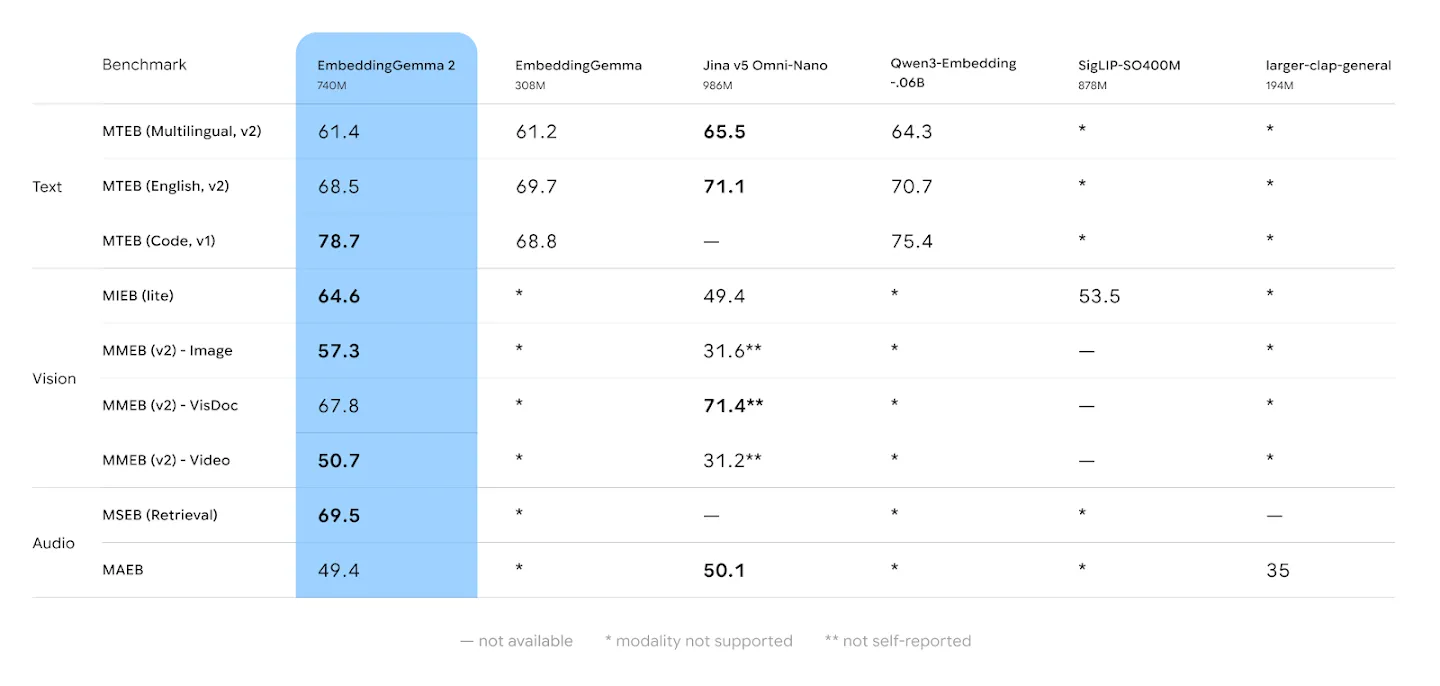
Aqui a história é diferente. EmbeddingGemma 2 marca 61.36 contra 61.15 da v1. Ou seja, +0.21 pontos em MTEB multilingual. A Google segurou a mão da v1 e focou os ganhos em multimodalidade e code. Se você só precisa de busca semântica em texto e tem GPUs sobrando no servidor, o Qwen3-Embedding-8B ainda pontua mais alto. O argumento de venda do EmbeddingGemma 2 não é substituir servidores, é colocar embeddings competentes em hardware que antes não rodava.
Onde perde: áudio
Embeddings de áudio ainda é uma categoria jovem, e o EmbeddingGemma 2 não lidera nela. No MAEB (Massive Audio Embedding Benchmark), o modelo marca 49.39, mas passa atrás de:
| Modelo | Tamanho | MAEB |
|---|---|---|
| EmbeddingGemma 2 | 740M | 49.39 |
| jina-embeddings-v5-omni-nano | ~0.5B | ~51 |
| BidirLM-Omni-2.5B | 2.5B | ~53 |
| LCO-Embedding-Omni-7B | 7B | ~56 |
| e5-omni-3B | 3B | ~48 |
| Qwen2-Audio-7B | 7B | ~35 |
| Qwen2.5-Omni-3B | 3B | ~24 |
A reclamação de marketing da Google é “leading scores among sub-1B multimodal embedders for its size”, e isso é verdade, entre modelos de até 1B, o EmbeddingGemma 2 é o melhor em MAEB. Mas no chart completo, modelos omni maiores (BidirLM-Omni-2.5B, LCO-Omni-7B) ainda lideram. Pra áudio, o EmbeddingGemma 2 é bom pra classe dele, não pra categoria.
Truncar o vetor: Matryoshka em ação
Matryoshka Representation Learning (MRL) deixa o modelo emitir o vetor em qualquer uma das quatro dimensões, 768d, 512d, 256d, 128d, sem perder muita qualidade. A ideia é simples: as informações mais úteis vão no começo do vetor, as menos úteis no final, então você corta onde faz sentido pro seu budget de storage.
| Dim | Compressão | MTEB multilingual | MTEB eng | MTEB code | MIEB | MMEB v2 | MSEB | MAEB |
|---|---|---|---|---|---|---|---|---|
| 768d (Full) | 1:1 | 61.36 | 68.46 | 78.68 | 64.64 | 59.01 | 69.54 | 49.39 |
| 512d | 1:1.5 | 61.17 | 68.41 | 77.24 | 64.32 | 58.38 | 69.18 | 49.21 |
| 256d | 1:3 | 60.41 | 67.78 | 76.18 | 63.13 | 56.24 | 66.76 | 48.91 |
| 128d | 1:6 | 57.89 | 65.68 | 71.41 | 59.06 | 45.65 | 56.71 | 46.92 |
Tradução direta: até 256d você perde < 2 pontos em quase tudo, e o MMEB v2 (multimodal) cai ~3 pontos. É 3x menos storage com custo de qualidade mínimo. Em 128d a coisa aperta, multimodal cai pra 45.65, áudio pra 56.71, e só vale a pena para índices de texto puro onde você precisa de 6x de compressão.
Número concreto: em bfloat16, 1 milhão de vetores 768d = 1.5 GB. Os mesmos 1 milhão em 128d = 250 MB. É a diferença entre caber num SSD de Raspberry Pi e exigir um servidor.
Onde o EmbeddingGemma 2 realmente roda
A Google publicou números de latência e memória para Pixel 11 Pro, S26 Ultra, iPhone 18 Pro, MacBook Pro M5, Dell XPS 16, Raspberry Pi 5 16GB, Jetson Orin Nano, Arduino VENTUNO Q e RTX 4090. Cobrindo todas as combinações de modalidade (text, text+vision, text+audio, text+vision+audio) em CPU, GPU e NPU. Resumo:
| Dispositivo | Backend | Text latency | Text+Vision | Text+Audio | Text+V+A |
|---|---|---|---|---|---|
| Pixel 11 Pro | TPU | 8.3 ms | 49 ms | 193.5 ms | 149 ms |
| S26 Ultra | CPU | 27.1 ms | 175 ms | 305 ms | 322 ms |
| S26 Ultra | GPU | 25.9 ms | 119 ms | 350 ms | 324 ms |
| iPhone 18 Pro | CPU | 41.8 ms | 191 ms | 445 ms | 400 ms |
| iPhone 18 Pro | GPU | 11.6 ms | 69.8 ms | 165 ms | 150 ms |
| MacBook Pro M5 | CPU | 31.3 ms | 151 ms | 314 ms | 432 ms |
| MacBook Pro M5 | GPU | 9.5 ms | 37.3 ms | 195 ms | 131 ms |
| Dell XPS 16 (Intel Core Ultra 3) | NPU | 13.3 ms | 49.8 ms | 124.3 ms | 108.6 ms |
| RTX 4090 | GPU | 7.6 ms | 23.9 ms | 169 ms | 112 ms |
| Arduino VENTUNO Q | NPU | 13.6 ms | 135 ms | — | — |
| Raspberry Pi 5 16GB | CPU | 161 ms | 1761 ms | 946 ms | 2304 ms |
| Jetson Orin Nano | GPU | 88 ms | 485 ms | 1195 ms | 1069 ms |
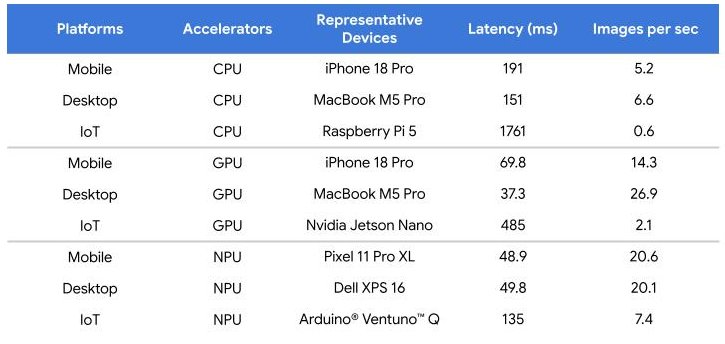
Texto embedado em 8.3 ms no Pixel 11 Pro. Em 11.6 ms no iPhone 18 Pro GPU. Em 7.6 ms na RTX 4090. Isso é tempo suficiente para sugerir enquanto o usuário digita, sem precisar de round-trip pra servidor. Em multimodal completo (text + vision + audio), o Pixel ainda responde em 149 ms, abaixo do limite de percepção humana para feedback visual.
O uso de memória ativa segue a mesma lógica: 112 MB no Pixel para text-only via TPU, 334 MB no S26 Ultra em CPU, 528 MB na RTX 4090. O Raspberry Pi 5 usa 282 MB só pra texto, o Jetson Orin Nano 523 MB. Nada disso é absurdo pro hardware alvo.
Como o contexto multimodal é compartilhado
A janela de 8.192 tokens é compartilhada entre todas as modalidades. Cada uma consome tokens a uma taxa fixa:
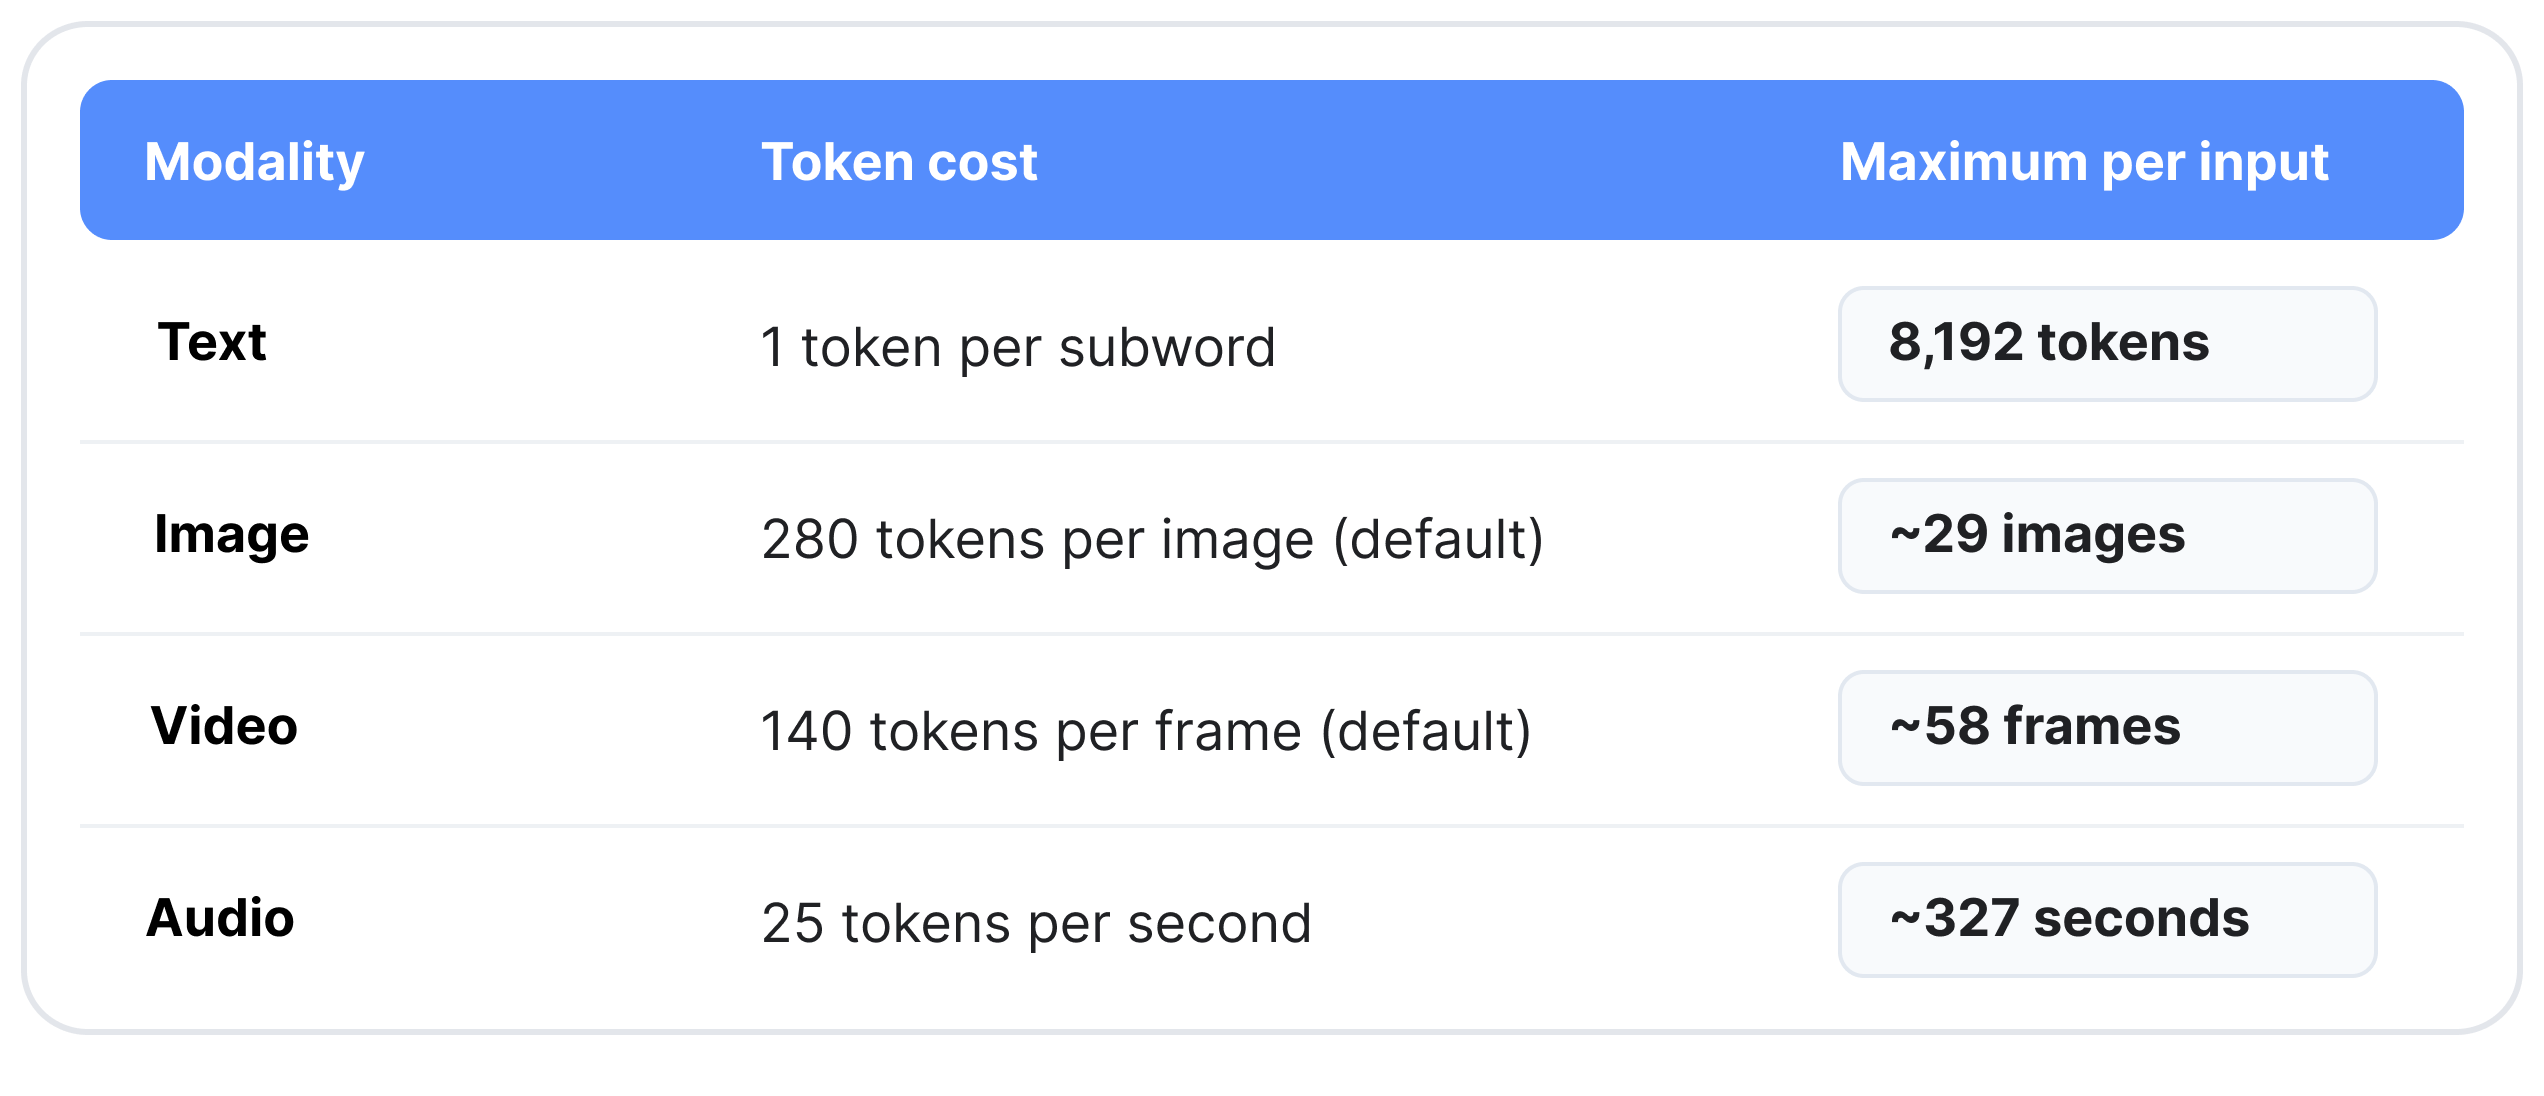
Os números são lineares e acumuláveis. Você pode mixar: 10 imagens (2.800 tokens) + 30 segundos de áudio (750 tokens) + 4.000 tokens de texto dá 7.550 tokens, dentro do budget de 8.192. Esse design abre portas pra “embeddings intercalados”, tipo um anúncio de produto com foto + texto + vídeo embutido num único vetor.
Três demos que mostram o que dá pra fazer
1. Instant Media Search (Google AI Edge Gallery)
O AI Edge Gallery adicionou duas demos powered por EmbeddingGemma 2. A primeira é Instant Media Search: você digita “Katze” em alemão e a grade re-ranqueia todas as fotos do seu celular que tenham gatos, sem mandar nada pra nuvem. Conforme você continua digitando (“Katze schläft auf Tastatur”), o grid re-ordena em tempo real até a foto do gato dormindo no teclado aparecer no topo. Latência: keystroke-by-keystroke.
Também funciona com imagem como query, você seleciona uma foto da sua galeria, e o sistema retorna fotos visual e semanticamente similares. Tudo local via MediaPipe UniversalEmbedder + SemanticRetriever, com ANN search em single-digit milissegundos.
2. Video Moments Finder
A segunda demo é Video Moments Finder. Você seleciona um vídeo longo (tipo reunião de família, jogo de futebol), o app indexa localmente vision+audio em chunks, e quando você digita “kids laughing” ou “dog catching a frisbee” o sistema retorna os momentos exatos com timestamp. Sem ASR, sem captions intermediárias, sem enviar o vídeo pra servidor. O embedding direto do áudio elimina o pipeline tradicional de transcrever→embedar→buscar.
3. AI Edge Foresight (Mac)
Para macOS a Google lançou o Google AI Edge Foresight, um companheiro de reunião que roda local. Captura áudio do sistema + microfone, integra com qualquer plataforma de call, e usa EmbeddingGemma 2 para retrieval + Gemma 4 para geração de respostas contextuais. Tudo offline. Casos de uso: anotar tópicos enriquecendo anotações manuais com contexto recuperado em tempo real; responder perguntas detectadas na reunião ao vivo; encontrar arquivos, imagens e transcrições antigas via query em linguagem natural.
Hardwares e plataformas suportadas
O modelo já está disponível em Hugging Face e Kaggle, com integração nativa em:
- LiteRT, runtime oficial cross-platform da Google para edge devices.
- MediaPipe Tasks, Embedder + SemanticRetriever + Decision Task para iOS, macOS, Windows, Linux e Web.
- ML Kit, chegando em breve no Android com NPU acceleration automática.
- transformers.js e WebGPU, para rodar direto no browser.
- Hugging Face transformers, sentence-transformers, MLX, vLLM, llama.cpp, SGLang, Ollama, LMStudio, para servidores.
- Qdrant, vector database recomendado para armazenar os embeddings.
- Unsloth, fine-tuning eficiente para adaptar o modelo a domínios específicos.
O arquivo .litertlm é o build cross-platform que roda tanto em CPU quanto em GPU sem modificação. Em Android, ML Kit vai usar LiteRT por baixo com aceleração NPU automática nos dispositivos compatíveis.
Trecho de código: embedando multimodal
Do developer guide, o jeito mais limpo de usar EmbeddingGemma 2 hoje é via sentence-transformers 6.1+:
from sentence_transformers import SentenceTransformer

MODEL_ID = "google/embeddinggemma-2"

# Full model: 740M, todas as modalidades
model = SentenceTransformer(MODEL_ID)

# Text-only: 270M, descarta encoders de vision e audio
text_only = SentenceTransformer(
    MODEL_ID,
    config_kwargs={"vision_config": None, "audio_config": None},
)

# Query em texto contra embedding de imagem
image_emb = model.encode({"image": "sunset_beach.jpg"})
query_emb = model.encode("ocean waves at sunset", prompt_name="SearchQuery")
print(model.similarity(query_emb, image_emb))

# MRL truncation: 768d -> 256d
query_emb = model.encode(
    "ocean waves",
    prompt_name="SearchQuery",
    truncate_dim=256,
    normalize_embeddings=True,
)
Os 6 takeaways
- Apache 2.0 muda tudo. A v1 estava sob Gemma Terms, que exigia aceite de política e tinha restrições comerciais para apps grandes. Apache 2.0 é uso comercial livre, sem strings. EmbeddingGemma 2 vira o default em produtos que precisam de embedding multimodal privado e em escala.
- O salto real foi em código, não em texto. MTEB multilingual ficou em +0.21 pontos. MTEB Code deu +9.92. Se seu caso de uso é busca em código (IDE agent, retrieval em codebase), o EmbeddingGemma 2 é o novo estado da arte em modelos abaixo de 1B.
- Audio embeddings ainda estão verdes. O modelo ganha em MAEB na classe sub-1B, mas perde no chart completo para BidirLM-Omni-2.5B (~53) e LCO-Omni-7B (~56). Pra áudio de produção, modelos omni maiores ainda são referência.
- Pixel 11 Pro com TPU roda text embedding em 8.3 ms. Isso é a metade de um keystroke típico. Significa que dá pra sugerir busca semântica antes do usuário terminar de digitar, sem排队 perceptível. Apple Silicon GPU e NPU Intel também entregam abaixo de 15 ms para texto.
- Matryoshka em 256d é o sweet spot. Você perde ~1 ponto em quase tudo e ganha 3x de compressão. 128d só vale pra índices de texto puro e first-stage shortlisting, multimodal cai demais.
- O ecossistema de tooling é o que mata a concorrência. LiteRT, MediaPipe, ML Kit, transformers.js, MLX, vLLM, llama.cpp, Ollama, Unsloth, Qdrant. Qwen3-Embedding-8B pontua mais em texto, mas exige que você monte toda a sua stack em volta dele. EmbeddingGemma 2 funciona onde você já está rodando.
Onde pegar tudo
- Model card no Hugging Face, pesos + benchmarks completos.
- LiteRT Community build, versão otimizada para on-device com latência medida em 9 dispositivos.
- Anúncio oficial no Google Blog, visão geral do lançamento.
- Developer Guide no Google Developers Blog, tutorial passo-a-passo com código.
- AI Edge blog, detalhes de AI Edge Gallery, Foresight e MediaPipe Tasks.
- Página oficial do modelo, visões, capacidades e links de download.
Benchmarks self-reported pelo Google DeepMind no model card oficial. Onde o EmbeddingGemma 2 perde, está dito. Onde ganha, também.