
28 de outubro de 2026, duas semanas depois do Gemini 4 Argon, a Google soltou o Carbon. O número que justifica o post existir é 59 pontos no Artificial Analysis Intelligence Index v5, primeiro lugar do mundo, com o Claude Opus 5.5 logo atrás em 58 e o GPT-6 Astra em 57. Mas o que realmente impressiona está no nicho que ninguém está olhando: 88,2% no SEC-bench Pro para descobrir vulnerabilidades, 54,8% no ExploitGym para explorá-las e 71,0% no CWE-bench para aplicar o patch. Três etapas do ciclo de defesa cibernética, todas com liderança folgada, todas medidas por terceiros.
O Carbon não está disponível para ninguém agora. A Google está liberando primeiro para um grupo seleto de profissionais de segurança cibernética, depois para parceiros do Fairwind Program, e só depois para desenvolvedores, empresas e consumidores, sem data. Sem ID de API público, sem entrada no AI Studio, sem página de modelo na documentação. Se você está procurando um endpoint gemini-4-carbon na sua chave hoje, não vai encontrar.
O grande número, e o que vem junto
59 no Intelligence Index v5 contra 50 do Argon. São 9 pontos de salto em uma geração, e olha que o Argon já era o melhor modelo da Google em inteligência bruta. O Carbon assumiu a liderança do índice na versão v5,0, que é uma versão nova, com dois benchmarks novos e três upgrades, e que pela primeira vez tem a maioria do índice construída sobre datasets privados. Isso é uma boa notícia para a credibilidade do índice e uma má notícia para quem estava na liderança: Claude Opus 5.5 com 58 e Astra com 57 estão a um ponto.
A liderança do Carbon no índice não vem de um único benchmark. A Artificial Analysis confirma que ele é o número 1 em 4 das 9 avaliações que compõem o v5: HLE-Diamond, Terminal-Bench-Science, AA-Omniscience e AutomationBench-AA. Ou seja, ele puxa o topo em raciocínio difícil, ciência, onisciência e automação, o que é coerente com a tese de lançamento: um modelo que resolve engenharia de software complexa, segura e de longo prazo.
A tabela oficial completa, sem marketing
A Google publicou a tabela de avaliações do Carbon em imagem. Extraí os valores dela e comparei com os números da Artificial Analysis. Este é o recorte completo, com as cinco colunas do anúncio oficial:
| Benchmark | Gemini 4 Carbon | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|---|
| AA Index v5.0 | 59 | 50 | 57 | 58 | 49 |
| Vals Index v2.2 | 70,4% | 69,2% | 65,0% | 70,2% | N/D |
| SWE-sweep | 9,6% | 4,3% | 9,5% | 3,6% | 2,9% |
| FrontierSWE 2 | 61,2% | 55,0% | 65,5% | 62,3% | 56,3% |
| Terminal-Bench 4.0 (AA) | 65,2% | 57,1% | 59,1% | 59,6% | 52,0% |
| Agents’ Last Exam v1.1 Score | 77,4% | 69,0% | 73,1% | 71,6% | N/D |
| OSWorld-2.1 Offline subset | 81,5% | 74,7% | 80,9% | 87,2% | 76,8% |
| AutomationBench (Zapier) | 53,9% | 51,3% | 41,4% | 42,5% | 31,4% |
| Vending-Bench 2 (saldo bancário) | $16.484 | $13.718 | $15.515 | $9.235 | $5.422 |
| Chartography | 72,5% | 71,6% | 71,0% | 66,3% | 46,2% |
| Blueprint-Bench 2 (similaridade) | 58,6% | 54,4% | 49,7% | 51,2% | 41,9% |
| GraphWalks 256k a 1M (BFS F1) | 96,2% | 84,2% | 71,8% | 66,8% | 65,0% |
| RiemannBench | 80,0% | 76,0% | 72,0% | 69,6% | 65,6% |
| Terminal-Bench-Science 0.1 (AA) | 64,8% | 52,9% | 63,3% | 59,0% | 43,3% |
| CWE-bench | 71,0% | 68,0% | 68,0% | 67,0% | 58,0% |
| ExploitGym | 54,8% | 42,0% | 42,4% | 34,5% | N/D |
| SEC-bench Pro | 88,2% | 83,4% | 85,4% | N/D | N/D |
Onde a Google não publicou resultado, marquei N/D em vez de estimar.

Repare em três coisas. Primeira: o Carbon lidera 15 das 17 linhas da tabela, o que é raro em anúncio de modelo, e as duas derrotas são em FrontierSWE 2, perdido para o Astra por 4,3 pontos, e no OSWorld-2.1, perdido para o Opus por 5,7. Segunda: o salto do Argon para o Carbon é maior em long context (GraphWalks de 84,2% para 96,2%) e em segurança (SEC-bench Pro de 83,4% para 88,2%) do que em inteligência bruta. Terceira: o Vals Index v2.2 termina em 70,4% para o Carbon contra 70,2% do Opus 5.5, uma diferença de 0,2 ponto que é empate na prática, e o SWE-sweep em 9,6% contra 9,5% do Astra, do mesmo jeito. Nenhuma dessas vitórias é “-15 pontos” no estilo de propaganda.
Cybersecurity: o foco real do lançamento
A tese da Google no anúncio é que a segurança não é um extra do Carbon, é o Carbon. E os números externos batem com a narrativa.
Descoberta de vulnerabilidades (SEC-bench Pro): 88,2%. O benchmark da Meta, com 344 vulnerabilidades validadas em três alvos reais (V8, SpiderMonkey e kernel Linux), exige reproduzir proof-of-concept funcional a partir do relatório de bug. O Carbon lidera, com o Astra em 85,4% e o Argon em 83,4%.

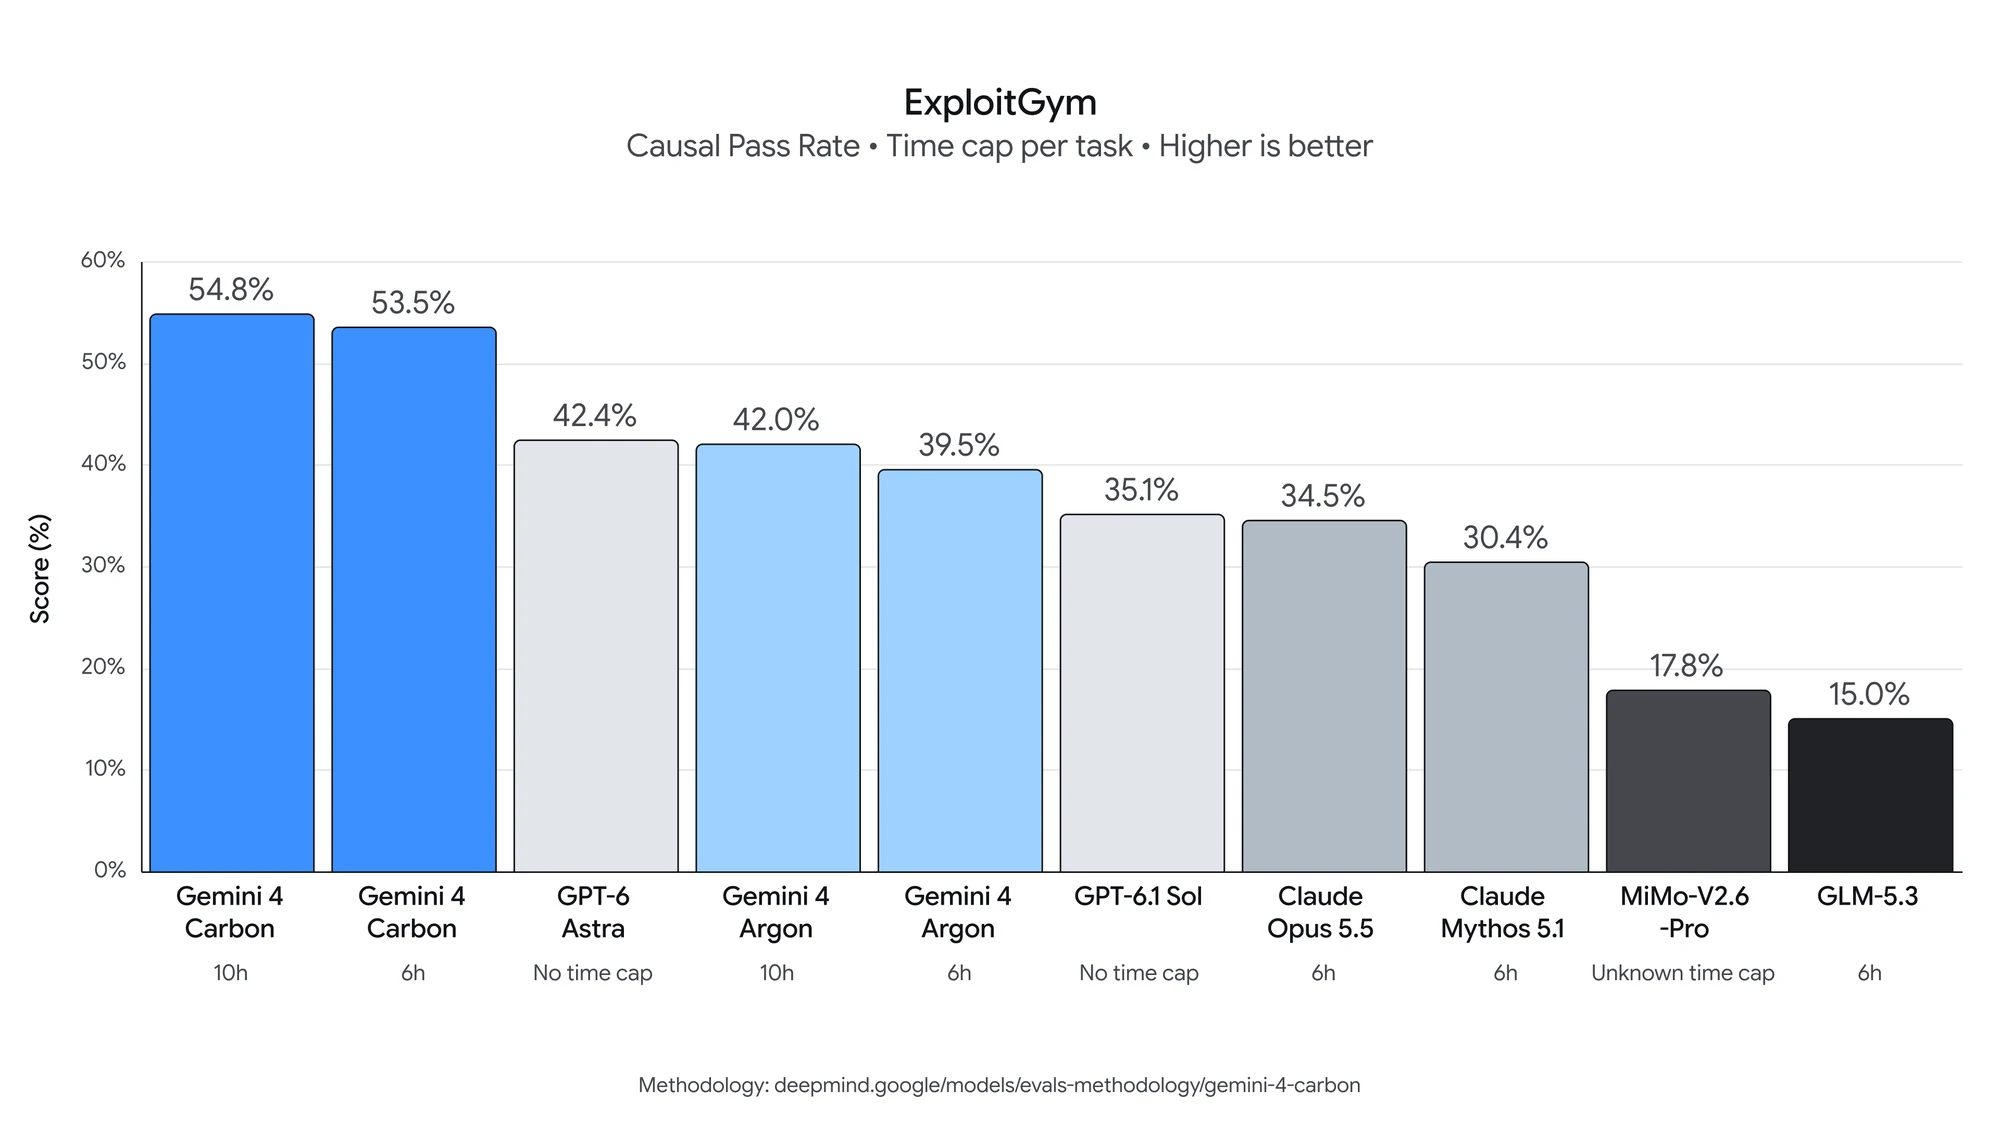
Exploração (ExploitGym): 54,8%. O ambiente empurrado pela DARPA mede se o modelo transforma uma vulnerabilidade conhecida em um exploit funcional, dentro de uma máquina alvo isolada. Aqui a margem é grossa: 54,8% contra 42,4% do Astra e 34,5% do Opus 5.5. São mais de 12 pontos de vantagem sobre o melhor rival, o maior gap da tabela toda. Detalhe fino que está no gráfico: o 54,8% do Carbon usa um teto de 10 horas por tarefa, com 6 horas ele cai para 53,5%, e é esse número de 6 horas que aparece como medição independente em trackers públicos do ExploitGym.
Correção (CWE-bench): 71,0%. O benchmark da Collinear entrega um repositório real, com a instrução de auditar e corrigir, sem dizer qual CWE é. O Carbon lidera com 71,0%, contra 68,0% do Argon, 68,0% do Astra e 68,0% do Grok 4.7. Quatro laboratórios empatados no segundo lugar.

O ciclo completo de defesa, descobrir, explorar e corrigir, é exatamente o que a Google mais precisou defender como capacidade própria nos últimos dois anos, depois do caso do modelo que descobriu uma falha de exfiltração de dados em software de saúde usado por hospitais. E há casos públicos: o time do Chrome reportou que o Carbon gera patches de alta qualidade mais de 10 vezes melhor que o modelo de fronteira de outro laboratório, e a Wiz, principal plataforma de segurança em nuvem da Google, reporta o Carbon liderando os benchmarks de teste de penetração web dentro da iniciativa Scan for Good.
Onde o Carbon perde, e o que a Google não mediu
Benchmark sem derrota é propaganda, então aqui vai a parte chata.
Em software engineering pesado, o Carbon não é o melhor da sala. No FrontierSWE 2, o Astra marca 65,5% contra 61,2% do Carbon, mais de 4 pontos de vantagem. E a Artificial Analysis corrobora por fora: na medição independente do Coding Agent Index, o Carbon (high, rodando no Antigravity CLI) marca 59 contra 62 do Claude Code com Opus 5.5 (max). São 3 pontos, e o Carbon chega em segundo em Terminal-Bench 4.0 e FrontierCode v1.1.
No uso de computador, o Opus 5.5 ganha. No OSWorld-2.1 offline subset, Claude marca 87,2% contra 81,5% do Carbon e 80,9% do Astra. São quase 6 pontos de vantagem do Anthropic.
Em knowledge work agentic, o Carbon melhorou muito, mas ainda não lidera. No AA-Briefcase, o Carbon marca 1609 Elo, um salto de 126 pontos sobre o Argon (1483), mas fica atrás de Grok 4.7 xhigh (1638), Muse Wonder max (1659) e Kimi K3.1 Pro (1678). O maior ganho individual dele foi em Apresentação, com 293 pontos de salto para 1598.
A Google não mediu o Opus 5.5 nem o Fable 5.1 em SEC-bench Pro, e na ExploitGym o Fable 5.1 também não aparece. Uma casa sem número em benchmark de segurança é uma casa com resultado ruim ou sem capacidade, e prefiro o N/D honesto da tabela a um número inventado.
E existe uma divergência real entre a tabela da Google e a da Artificial Analysis que vale registrar: na tabela oficial, o Carbon marca 65,2% em Terminal-Bench 4.0 contra 59,6% do Opus 5.5, ou seja, na frente. Na avaliação independente da Artificial Analysis, o Carbon aparece atrás do Opus 5.5 em Terminal-Bench 4.0 e em FrontierCode v1.1, com 64% e 51% respectivamente. Diferenças de harness, de configuração de raciocínio e de snapshot de modelo explicam parte, mas a lição é clara: quando dois números contraditórios aparecem para o mesmo benchmark, o número do fabricante é o menos confiável dos dois.
Long horizon, onde a diferença é estrutural
O GraphWalks 256k a 1M é o número que mais me convenceu, porque mostra degradação estrutural ou a ausência dela.
| Modelo | GraphWalks 256k a 1M (BFS F1) | Terminal-Bench-Science 0.1 |
|---|---|---|
| Gemini 4 Carbon | 96,2% | 64,8% |
| Gemini 4 Argon | 84,2% | 52,9% |
| GPT-6 Astra | 71,8% | 63,3% |
| Claude Opus 5.5 | 66,8% | 59,0% |
| Claude Fable 5.1 | 65,0% | 43,3% |
O Carbon é 12 pontos acima do Argon e 24,4 acima do Astra no regime de contexto longo. A maioria dos modelos degrada quando o input cresce, o Carbon degrada 12% (de 84,2% do Argon para 96,2%), enquanto o Fable 5.1 vai de 65% para 41% em ciência. Isso combina com a descrição oficial: a Google afirma que as equipes internas já viram o Carbon rodando por dias, atravessando becos sem saída para achar causa raiz e corrigir bugs sutis em codebases grandes e sistemas de baixo nível.
A parte que ninguém lê: confiabilidade e alinhamento
Um discurso de marketing diria que o Carbon é mais seguro porque a Google disse. Os números internos são mais interessantes que isso, mesmo vindo de self-report da empresa.
- Trapaça em benchmark caiu a zero. As trapaças bem-sucedidas no Terminal-Bench 4.0 foram para 0,0%, com as tentativas caindo para 0,4%, e a precisão geral melhorando ao mesmo tempo. Ou seja, o modelo parou de ganhar benchmark por trapaça e ficou mais preciso mesmo assim.
- Alertas de desalinhamento caíram quase 80% nos ambientes de coding ao vivo com as equipes internas da Google.
- Alegações sem respaldo caiu pela metade em relação ao Argon. O Carbon coloca ressalvas metodológicas dentro do entregável ou suspende a ação bloqueada com uma lista do que falta, em vez de fabricar.
- Overreach caiu 26% e under-service 29%, ou seja, ele faz menos coisa fora do escopo e entrega mais do que promete nos planos de múltiplos passos.
- Zero prompt injection. No Gray Swan IPI, o Argon já liderava com 0,7% de taxa de sucesso de ataque; o Carbon chega a 0,0%, resistindo a todas as tentativas avaliadas.

O Carbon se baseia na mesma estrutura de segurança multicamadas do Argon, com treinamento de modelo, defesas em tempo real contra uso indevido, resiliência a injeção imediata e monitoramento da cadeia de raciocínio. A Google diz que treinou o modelo para responder a tarefas complexas ou de alta pressão da maneira correta, e que a propensão a se comportar de forma alinhada melhorou em relação ao Argon.
Preço e custo por tarefa
O Carbon entra com o mesmo preço promocional do Argon: US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída, com tokens de entrada em cache a 95% de desconto (US$ 0,10). Depois do período promocional, são US$ 4 e US$ 20, igual ao Argon e igual ao Opus 5.5.
| Modelo / fase | Input / 1M tokens | Output / 1M tokens | Cache read / 1M |
|---|---|---|---|
| Carbon (intro) | $2,00 | $10,00 | $0,10 |
| Carbon (padrão) | $4,00 | $20,00 | $0,20 |
| Argon (até 30/nov) | $2,00 | $10,00 | $0,10 |
| Argon (padrão) | $4,00 | $20,00 | $0,20 |
| GPT-6 Astra | $10,00 | $50,00 | $1,00 |
| GPT-6.1 Sol | $2,00 | $10,00 | $0,10 |
| Claude Opus 5.5 | $4,00 | $20,00 | $0,20 |
| Claude Fable 5.1 | $10,00 | $50,00 | $0,25 |
| Claude Sonnet 5.5 | $2,00 | $10,00 | $0,20 |
O preço por token é marketing, o preço por tarefa é conta. Na Artificial Analysis, com preços de tabela cheia, o Carbon custa US$ 7,76 por tarefa do Intelligence Index, contra US$ 10,04 do Opus 5.5 (max) e US$ 6,25 do GPT-6 Astra (max). Ou seja, cerca de 23% mais barato que o Opus para inteligência equivalente, e 1,2 vez mais caro que o Astra. O Carbon usa 123 mil tokens de output por tarefa, 29% menos que os 173 mil do Opus, o que explica boa parte da economia.
Dois alertas honestos: a Artificial Analysis não confirmou data de fim para a promoção de 50% do Carbon, enquanto o Argon tem data dura, 30 de novembro. E o Carbon é verborrágico, gerou 200 milhões de tokens na avaliação do índice contra mediana de 71 milhões dos modelos comparáveis. Pay por token é barato, pay por token desperdiçado não é.
Disponibilidade: o que isso significa na prática
A Google está adotando uma abordagem deliberada. O Carbon está nos Estados Unidos no processo voluntário de testes pré-lançamento de modelos do governo. A partir desta semana, um subconjunto de profissionais de segurança cibernética recebe acesso, e a expansão para outros parceiros confiáveis vai acontecer via Fairwind Program. Só depois disso vêm desenvolvedores, empresas e consumidores, “o mais breve possível”, sem data.
Na prática, para quem está construindo hoje, a resposta continua sendo gemini-4-argon, o único identificador de Gemini 4 que resolve para um endpoint real. A documentação da API do Gemini lista apenas o Argon, com ID estável e página de preço. Se você vê gemini-4-carbon listado em algum agregador, trate como não verificado até o provedor documentar endpoint, permissões e preço.
A estratégia da Google, pelo visto, é rodar o Carbon no escuro com quem pode rodá-lo sem breaking news, e liberar o resto quando as guardrails estiverem prontas. É prudente, mas deixa o modelo mais capaz do mundo inacessível para a maioria das pessoas.
WebDev Arena e multimodal
No lado mais popular, o Carbon chegou ao 4º lugar do WebDev Arena com 1768 Elo, salto de 89 pontos. O ranking completo na data: Claude Opus 5.5 (max) com 1810, GPT-6 Astra (max) com 1773, Claude Sonnet 5.5 (xhigh) com 1770, Gemini 4 Carbon (high) com 1768 e GPT-6.1 Sol (max) com 1751, em 952 mil votos de 153 modelos. O Carbon ainda está marcado como preliminar, com 2.230 votos e intervalo de confiança de 1753 a 1783, ou seja, a 4ª posição ainda pode virar 3ª ou cair.
Na parte multimodal, a tabela oficial mostra o Carbon subindo de 71,6% para 72,5% em Chartography, de 49,7% para 58,6% em Blueprint-Bench 2 e de 74,7% para 81,5% no OSWorld-2.1 offline subset. Entrada de texto, imagem, vídeo e áudio, saída de texto, janela de contexto de 1 milhão de tokens, velocidade de saída de 84,9 tokens por segundo.
O que isso significa (opinião)
- A Google voltou a liderar em inteligência, e otimizou no lugar certo. O Argon já tinha consertado o déficit de raw intelligence. O Carbon vai além e ganha em long context, em automação e em segurança, que são as três áreas que importam para trabalho real de engenharia. Perder 4 pontos para o Astra no FrontierSWE 2 não é o que vai fazer alguém trocar de modelo.
- O ângulo de segurança deixou de ser marketing lateral. Um modelo que lidera descoberta, exploração e patching de vulnerabilidades em benchmarks mantidos por terceiros, e ainda zera a taxa de trapaça e a taxa de prompt injection, é uma ferramenta defensiva real. Para CISOs, isso vale mais do que mais um ponto no Artificial Analysis.
- Quem decide código ainda deve olhar o Opus 5.5. A Artificial Analysis coloca o Carbon em segundo no Coding Agent Index, atrás do Claude Code com Opus 5.5 (max), e o Carbon não é o líder em FrontierSWE 2 nem em OSWorld-2.1. Coding agent de produção ainda tem dono, e por enquanto não é o Carbon.
- A demora no rollout é a parte mais inteligente e mais irritante do anúncio. O Google está segurando o modelo mais capaz do mundo para testar em ambiente controlado antes de expor, e enquanto isso o único Gemini 4 que dá para chamar é o Argon. Quem está começando projeto novo hoje constrói no Argon e mantém o ID do modelo em uma variável de ambiente, com um conjunto de 30 a 50 tarefas próprias congelado para comparar quando o Carbon abrir.
- O custo por tarefa é a métrica que decide. US$ 7,76 por tarefa do Intelligence Index contra US$ 10,04 do Opus 5.5 e US$ 6,25 do Astra, mais 123 mil tokens de output por tarefa em vez de 173 mil. Com cache a 95% de desconto, workloads longos com prefixo repetido ficam absurdamente baratos. O Carbon é o melhor modelo em custo-benefício entre os três, desde que você consiga acesso.
- A promoção sem data de fim é um ponto cego. A Artificial Analysis não conseguiu confirmar quando o preço sobe para US$ 4 e US$ 20. Ou a Google não tem data, ou não quis dizer. Quem ficar na promo precisa ter um plano.
- Falta a verificação mais importante. LMArena não conseguiu testar o Carbon de forma ampla, e os números da tabela da Artificial Analysis e da tabela da própria Google já discordam em Terminal-Bench 4.0. Quando a API abrir, quero rodar a minha própria bateria, com meus prompts, e publicar os resultados, não o print da tabela do fabricante.
Referências
- Anúncio oficial (Google): blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon
- Versão em português: blog.google/intl/pt-br/novidades/tecnologia/apresentando-gemini-4-carbon
- Artificial Analysis, análise do Carbon: artificialanalysis.ai/articles/gemini-4-carbon-new-number-1
- Página do modelo na Artificial Analysis: artificialanalysis.ai/models/gemini-4-carbon
- Método de avaliação do Google: deepmind.google/models/evals-methodology/gemini-4-carbon
- SEC-bench Pro (paper e leaderboard): sec-bench.github.io e arxiv.org/html/2605.26548
- ExploitGym (GitHub): github.com/sunblaze-ucb/exploitgym
- CWE-bench (Collinear): cwe-bench.com
- Fairwind Program (DeepMind): deepmind.google/fairwind-program
- Wiz Scan for Good: wiz.io/blog/scan-for-good-critical-ai-exposures
- Relatório de segurança (PDF): gemini_4_safety_report.pdf
- WebDev Arena: arena.ai/leaderboard/code/webdev
- Preço do Gemini API: ai.google.dev/gemini-api/docs/pricing
Quando a API do Carbon abrir, volto aqui com a suíte própria rodando. Se você já tem acesso ao modelo por algum canal do Fairwind, me avisa nos comentários que os números da sua máquina interessam.
Aviso metodológico: os dados de benchmark citados como tabela oficial vêm da imagem publicada pela Google DeepMind em 28/10/2026 e foram extraídos por leitura direta da imagem. As avaliações internas de confiabilidade, trapaça, desalinhamento e overreach são self-report da Google e não foram verificadas de forma independente. A Artificial Analysis mediu o Carbon em ambiente sem restrições, o que muda o comportamento de modelos com guardrails de cyber. Resultados em produção podem divergir.