
18 de novembro de 2026. O Google lançou o Gemini 4 Neon, o quarto modelo da família Gemini 4 em sete semanas. Ele marca 61 pontos no Artificial Analysis Intelligence Index, um ponto à frente do Gemini 4 Carbon, e é vendido a US$ 3 por milhão de tokens de entrada e US$ 15 por milhão de saída. Parece ótimo no papel. Só que o Carbon, hoje, está cobrando metade disso, e o Neon é o terceiro colocado do Artificial Analysis gastando mais dinheiro por tarefa do que o primeiro colocado.
Esse é o resumo honesto: o Neon é o melhor modelo da família Gemini 4 no quesito inteligência, mas a conta não fecha do jeito que o anúncio sugere, e ele é absurdamente verborrágico. Vamos aos números.
Para contexto, o Google já tinha publicado posts sobre o Gemini 4 Carbon e o Gemini 4 Hydrogen. O Neon é o elo que faltava: o modelo intermediário que entrega qualidade de Carbon rodando na velocidade de um modelo rápido. E, como todo modelo intermediário que existe, ele ocupa exatamente o espaço onde o dinheiro fica feio.
O número que resume o lançamento
O Artificial Analysis mediu o Neon em quatro níveis de raciocínio. O gráfico oficial do Google mostra o caminho completo:
| Nível | Índice de Inteligência | Custo por tarefa | Tempo por tarefa |
|---|---|---|---|
| Low | 44 | US$ 0,70 | 3,7 min |
| Medium | 55 | US$ 1,90 | 8,3 min |
| High (padrão) | 60 | US$ 3,80 | 14,8 min |
| Xhigh | 61 | US$ 6,40 | 21,5 min |
Olha o que a tabela mostra: cada degrau de raciocínio custa mais que o dobro do anterior em tempo, e o ganho de inteligência quase não existe no topo. Do Medium (55 pontos, US$ 1,90) para o Xhigh (61 pontos, US$ 6,40) você triplica a conta para ganhar 6 pontos. Isso não é um bug, é o desenho: o Xhigh existe para os casos em que errar custa caro demais para esperar.
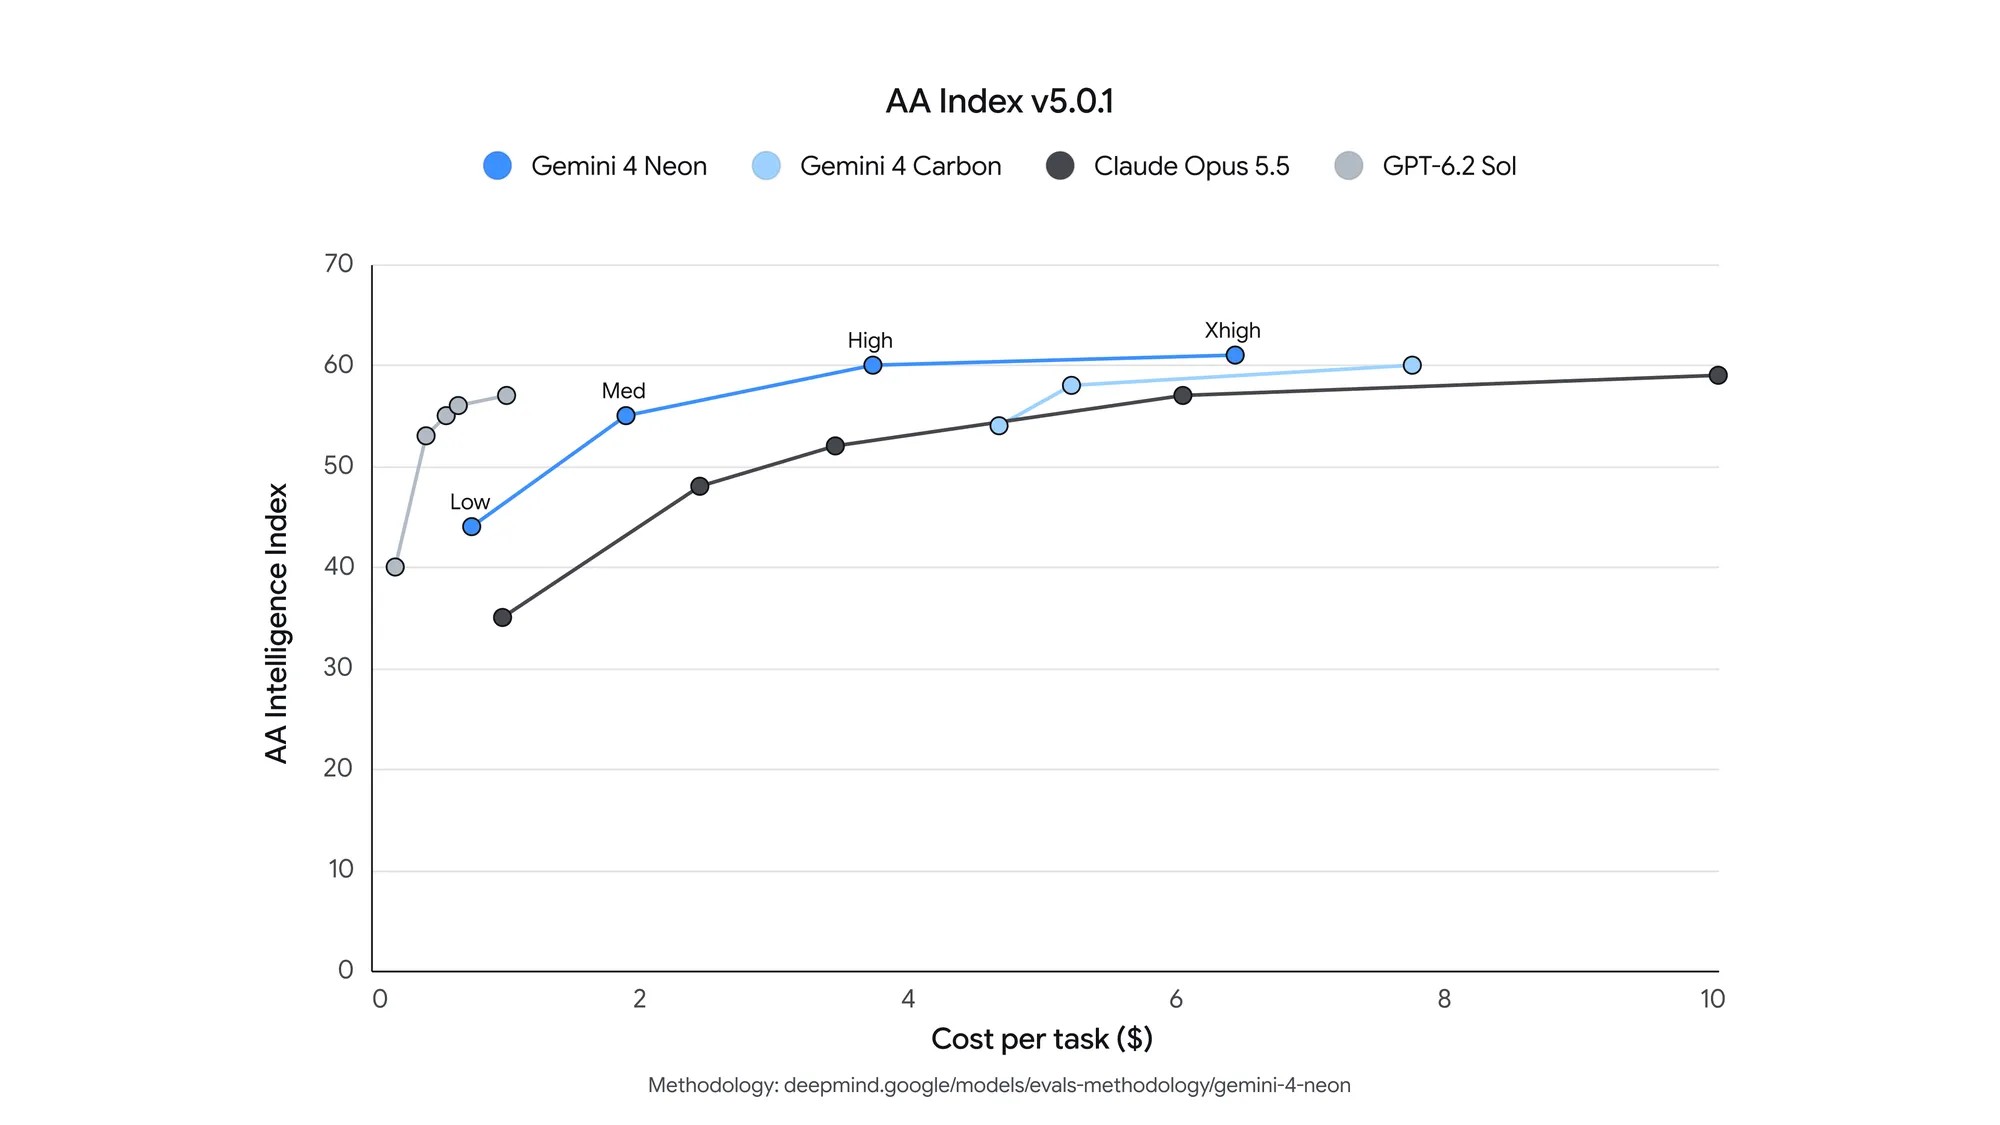
O gráfico oficial do Google é uma curva de Pareto: quanto mais à direita, mais caro. O Neon (xhigh) fica em US$ 6,40 por tarefa com 61 pontos. O GPT-6.2 Astra, que lidera o índice com 62 pontos, custa US$ 4,00. Ou seja: o modelo da OpenAI é mais inteligente e 60% mais barato por tarefa. Isso não aparece no comunicado do Google, mas é o que a Artificial Analysis mediu.
A tabela completa, com as perdas
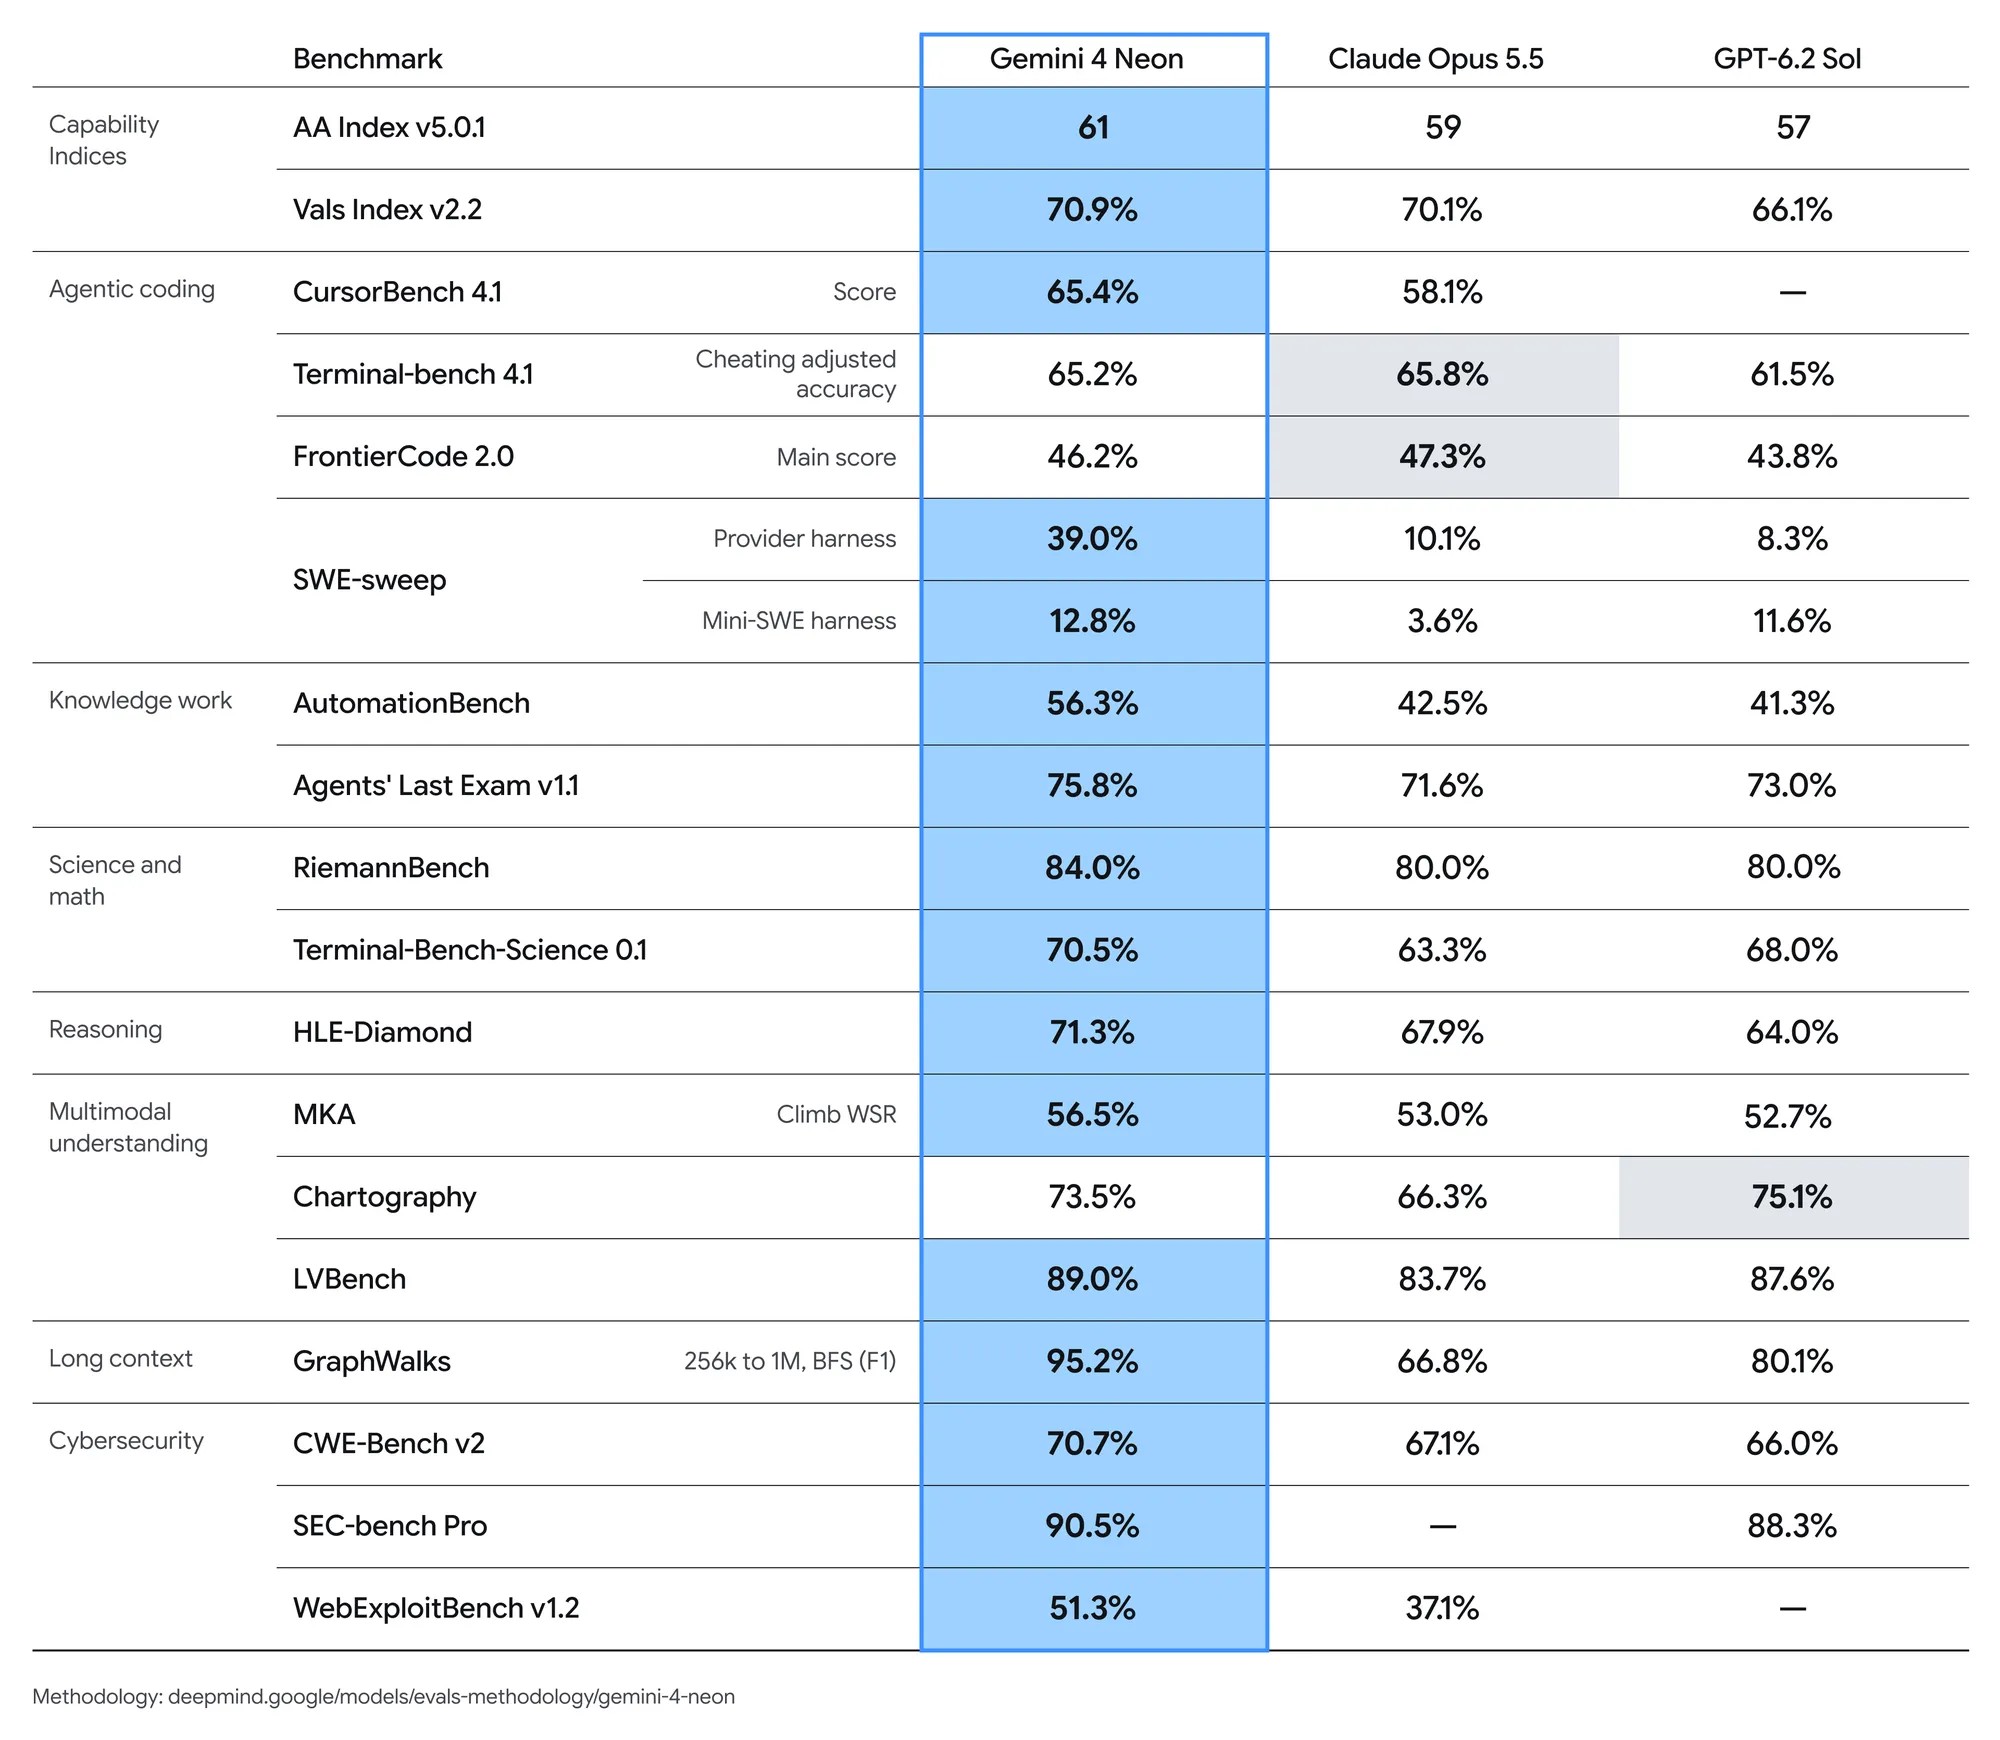
O Google publicou a comparação contra o Claude Opus 5.5 e o GPT-6.2 Sol. Aqui está a tabela oficial, transcrita do material do Google (imagem, não texto), para você ver onde o Neon ganha e onde ele apanha:
| Benchmark | Gemini 4 Neon | Claude Opus 5.5 | GPT-6.2 Sol |
|---|---|---|---|
| AA Index v5.0.1 | 61 | 59 | 57 |
| Vals Index v2.2 | 70,9% | 70,1% | 66,1% |
| CursorBench 4.1 | 65,4% | 58,1% | não listado |
| Terminal-bench 4.1 | 65,2% | 65,8% | 61,5% |
| FrontierCode 2.0 | 46,2% | 47,3% | 43,8% |
| SWE-sweep (harness Antigravity) | 39,0% | 10,1% | 8,3% |
| SWE-sweep (harness Mini-SWE) | 12,8% | 3,6% | 11,6% |
| AutomationBench | 56,3% | 42,5% | 41,3% |
| Agents’ Last Exam v1.1 | 75,8% | 71,6% | 73,0% |
| RiemannBench | 84,0% | 80,0% | 80,0% |
| Terminal-bench-Science 0.1 | 70,5% | 63,3% | 68,0% |
| HLE-Diamond | 71,3% | 67,9% | 64,0% |
| MKA (Climb WSR) | 56,5% | 53,0% | 52,7% |
| Chartography | 73,5% | 66,3% | 75,1% |
| LVBench | 89,0% | 83,7% | 87,6% |
| GraphWalks (256k a 1M) | 95,2% | 66,8% | 80,1% |
| CWE-Bench v2 | 70,7% | 67,1% | 66,0% |
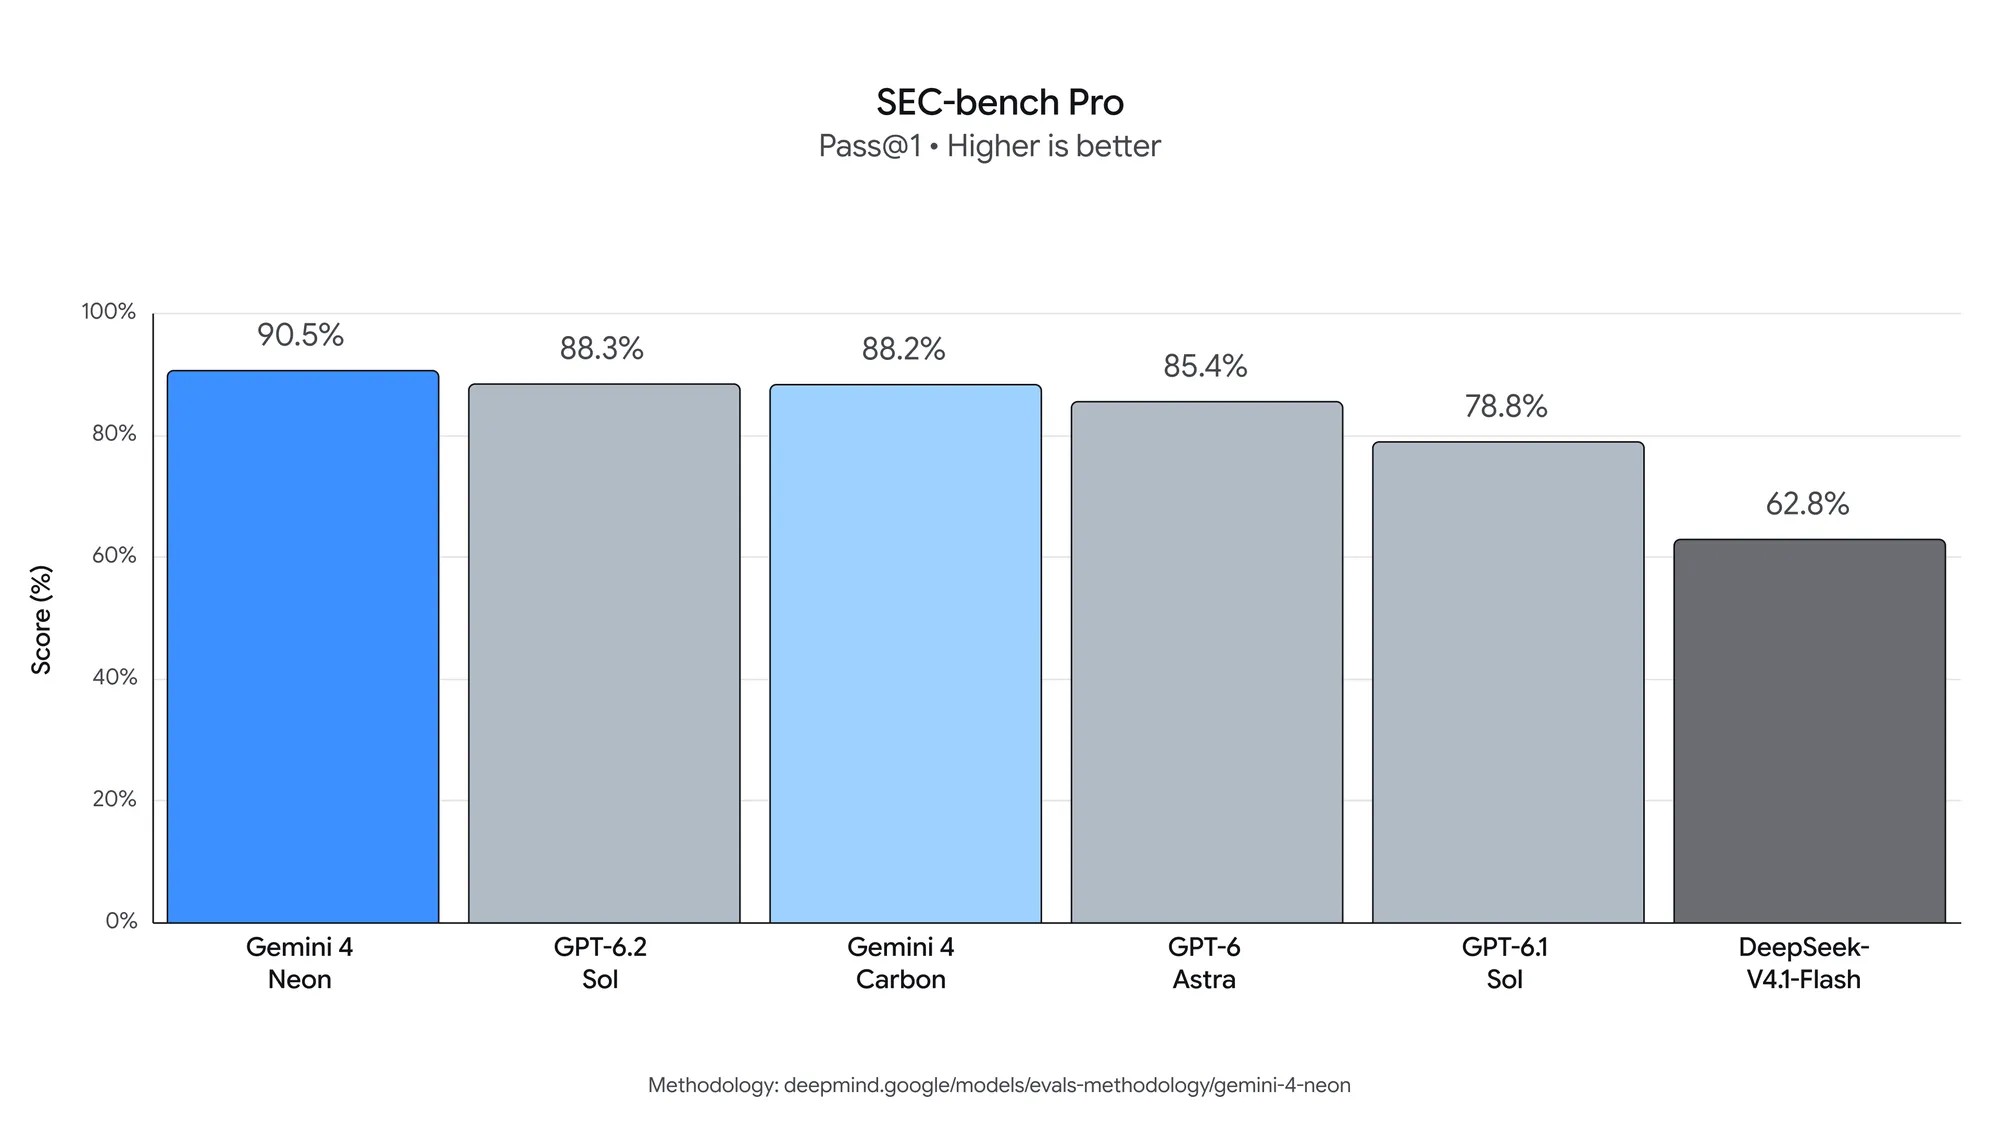
| SEC-bench Pro | 90,5% | não listado | 88,3% |
| WebExploitBench v1.2 | 51,3% | 37,1% | não listado |
As perdas estão na tabela e valem ser ditas: o Claude Opus 5.5 ganha no Terminal-bench 4.1 (65,8% contra 65,2%) e no FrontierCode 2.0 (47,3% contra 46,2%), dois dos benchmarks maispesados de programação. O GPT-6.2 Sol ganha no Chartography (75,1% contra 73,5%), que é leitura de gráficos densos. No SWE-sweep com o harness Mini-SWE, o GPT-6.2 Sol (11,6%) fica perto do Neon (12,8%) e muito acima do Claude (3,6%).
Onde o Neon destrói os concorrentes: CursorBench 4.1 (65,4% contra 58,1% do Claude), SWE-sweep no harness do Antigravity (39,0% contra 10,1% e 8,3%), AutomationBench (56,3% contra 42,5%) e GraphWalks em contexto longo (95,2% contra 66,8% do Claude). Essa última é impressionante: em caminhadas de grafo com 256 mil a 1 milhão de tokens, o Opus 5.5 desanda para 66,8%.
Onde o Neon apanha: o problema da verbosidade
Este é o detalhe que o comunicado do Google não menciona e que a Artificial Analysis grita em letras vermelhas. O Neon (xhigh) gerou 283 milhões de tokens de saída durante a avaliação do índice de inteligência. A mediana dos modelos da mesma faixa de preço é 65,1 milhões. O Neon escreveu 4,3 vezes mais que a mediana.
| Nível | Tokens de saída no índice | Mediana da faixa |
|---|---|---|
| Low | 28,3 milhões | 65,1 milhões |
| Medium | 62,9 milhões | |
| High | 123 milhões | |
| Xhigh | 283 milhões |
E tem mais. O Artificial Analysis classifica o Neon como o modelo mais verborrágico entre os 95 avaliados, na 93ª posição. O tempo até o primeiro token de resposta é de 56,51 segundos. Isso explica a contradição que a página do modelo mostra: 110 tokens por segundo de velocidade de saída, quase o dobro dos 57 do Carbon, mas 21,5 minutos por tarefa contra 12,4 minutos da mediana. Token sai rápido, mas o modelo fala demais e leva 21 minutos para terminar.
Traduzindo para quem vai usar na prática: o Neon não é lento no sentido de “demora para começar”. É lento no sentido de “quando você olha a conta no final do mês, ela te surpreendeu”.
O detalhe do preço que o Google enterra no rodapé
Este é o ponto que quase todo mundo passou batido. O Carbon está em preço promocional até 30 de novembro: US$ 2 por entrada e US$ 10 por saída. A partir de 1º de dezembro, dobra para US$ 4 e US$ 20.
| Modelo | Entrada | Saída | Cache | Até 30/11 | Desde 1º/12 |
|---|---|---|---|---|---|
| Gemini 4 Hydrogen | US$ 1,50 | US$ 7,50 | US$ 0,075 | igual | igual |
| Gemini 4 Neon | US$ 3,00 | US$ 15,00 | US$ 0,15 | igual | igual |
| Gemini 4 Carbon / Argon | US$ 2,00 | US$ 10,00 | US$ 0,10 | promocional | US$ 4 / US$ 20 |
Traduzindo: até 30 de novembro, o Neon custa 50% mais por token que o Carbon, o modelo mais forte do Google. Depois de 1º de dezembro, quando o Carbon dobra de preço, o Neon fica 25% mais barato. Ou seja, quem está escolhendo entre os dois por preço puro deveria rodar o Carbon neste mês e refazer a comparação no dia 1º de dezembro.
Existem ainda as opções Batch e Flex, que custam metade: US$ 1,50 de entrada e US$ 7,50 de saída no Batch. E o Google não tem tier gratuito para o Neon, ao contrário do Hydrogen. Todo token é cobrado, incluindo os tokens de raciocínio.
As especificações técnicas, sem marketing
| Item | Especificação |
|---|---|
| ID do modelo | gemini-4-neon |
| Contexto | 1.048.576 tokens (unificado entre entrada e saída) |
| Saída máxima por segmento | 65.536 tokens |
| Decodificação longa | até 1.048.576 tokens via continuation_token |
| Níveis de raciocínio | low, medium, high (padrão), xhigh |
| Entrada | texto, imagem, vídeo, áudio, PDF, Office, OpenDocument |
| Saída | apenas texto |
| Caching | implícito apenas (mínimo de 4.096 tokens), sem cache explícito |
| Parâmetros de amostragem | fixos: temperature 1.0, topP 0.95, topK 64 |
| Data de corte do conhecimento | março de 2026 |
| APIs | GenerateContent, Interactions, Chat Completions, Count Tokens |
| Não suporta | Gemini Live API, ajuste fino, RAG Engine, resposta em áudio |
Dois detalhes práticos que quase ninguém lê: o temperature, o top_p e o top_k são ignorados, você não controla a aleatoriedade. E o cache é só implícito, sem cache explícito, o que significa que você não tem controle sobre o que fica guardado nem por quanto tempo. O cache explícito com TTL chega em 12 de janeiro de 2027.
Já o lado bom: aceita 3.000 imagens ou documentos por prompt, 10 vídeos de até 45 minutos, 1.000 arquivos de áudio de até 8,4 horas cada, e funciona com Google Search, Google Maps, execução de código, chamada de função e uso de computador. É um modelo com apoio de ferramentas de primeira linha.
Cibersegurança: o Neon como defensor
O Googlereleased uma variante focada em segurança, o Gemini 4 Neon for cyber, com proteções em tempo real. Os números de defesa são bons:
| Benchmark de segurança | Neon for cyber | Observação |
|---|---|---|
| AutoBaxBench (nível difícil) | 76% | estado da arte, melhor que o Carbon |
| SEC-bench Pro | 90,5% | estado da arte, metade do custo por desafio |
| WebExploitBench v1.2 | 51,3% | metade do custo dos modelos grandes concorrentes |
| CWE-bench v2 | 70,7% | +3,4 pontos sobre o Carbon |
| ExploitGym | frente | usando metade dos tokens do Carbon |
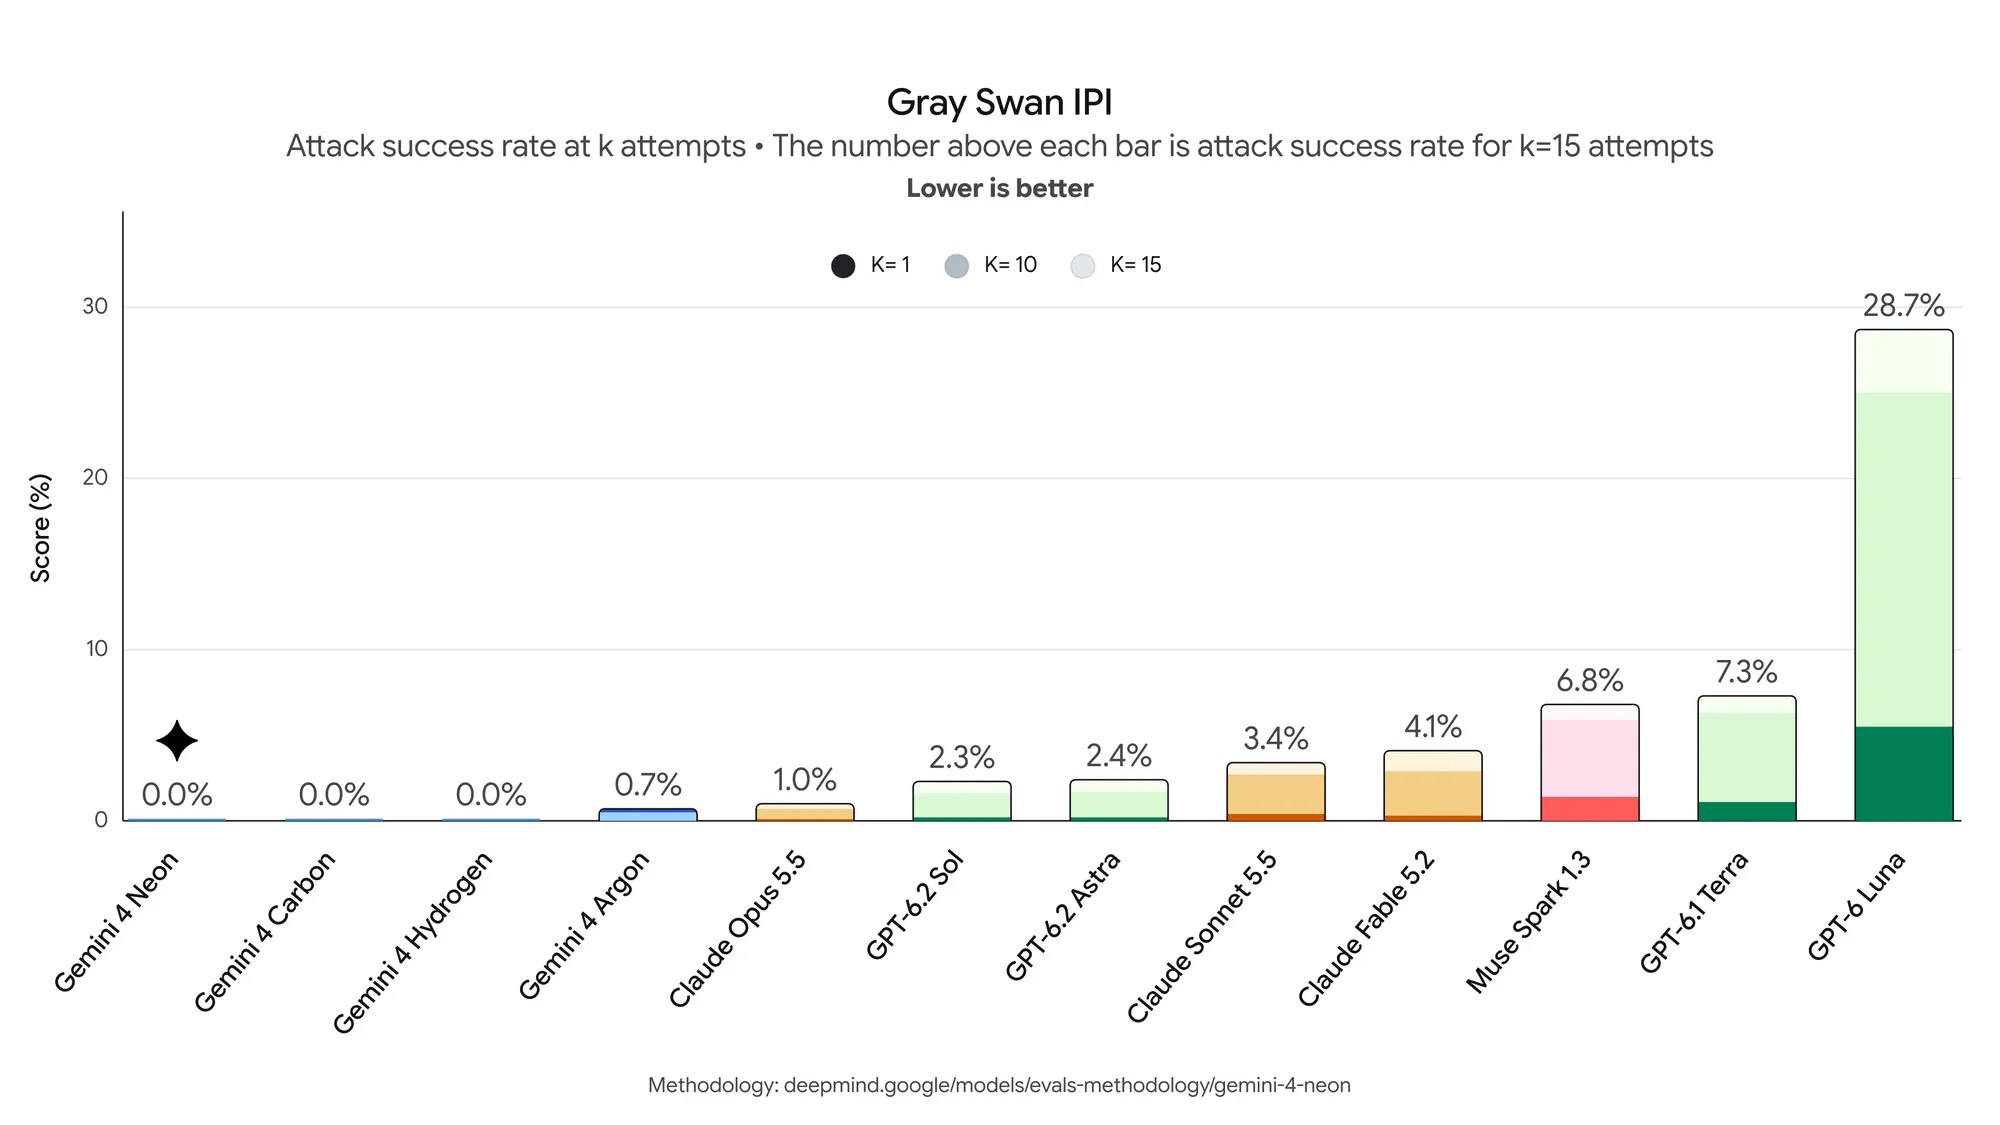
E o lado oposto, o mais interessante: proteção contra injeção indireta de prompt. No benchmark IPI da Gray Swan, o Neon resistsu a todos os ataques, com taxa de sucesso de ataque de 0,0%, contra 2,3% do GPT-6.2 Sol, 2,4% do GPT-6.2 Astra e 4,1% do Claude Fable 5.2. Se sua agente lê páginas web, e-mails e documentos, isso é o número mais importante do lançamento.
As dostas que o Google não mostra na tabela
Um usuário do r/GoogleGeminiAI rodou revisão de código com o Gemini 4 em modo alto contra o GPT-6.1 Sol e o Opus 5.5, e escreveu que os três achados reais do revisor do Gemini duplicavam os dos outros, enquanto os números de inventário e uma afirmação sobre um classificador foram fabricados. A pessoa abandonou o Gemini para revisão de código por causa disso antes mesmo do 4. O Google diz que o Neon tem a menor taxa de fabricação já registrada nos testes internos do Antigravity. A reclamação é de um usuário, mas aponta para a tensão real do modelo: ele escreve muito, e escrever muito dá mais espaço para inventar detalhe.
Outro dado do Artificial Analysis: no GDP.pdf, que mede leitura de documento denso, o Neon em nível alto marca 33,4%, cinco pontos acima do Carbon (28,4%), mas o Neon em xhigh marca 28,0%. O nível mais caro é o pior em leitura de PDF. Isso é o tipo de detalhe que só aparece quando você mede em vez de confiar no comunicado.
O que isso significa na prática
1. O Neon é o melhor modelo do Google, não o mais barato. Ele bate o Carbon em inteligência, em agentes de código com Antigravity (59 pontos no Coding Agent Index contra 55 do Carbon) e em trabalho de conhecimento. Se você está no Google Cloud e quer o melhor que a casa oferece sem pagar o preço do Carbon, é ele.
2. Fora do Google, o Neon perde no custo-benefício. O GPT-6.2 Astra entrega inteligência maior (62 contra 61) por US$ 4,00 por tarefa, contra US$ 6,44 do Neon. Se a sua decisão for puramente “qual modelo eu uso para um agente que roda o dia inteiro”, a resposta honesta é que o Neon é o segundo colocado em inteligência e o mais caro da linha do topo. O post completo sobre o GPT-6.2 Astra e o Sol tem os números de preço por token que dá para comparar com calma.
3. O nível default high é o ponto sweet spot. 60 pontos a US$ 3,80 por tarefa é o melhor equilíbrio da tabela. O Xhigh só se justifica quando errar custa mais que US$ 2,60 de diferença por tarefa, o que em auditoria, segurança e pesquisa científica é verdade com frequência.
4. Decisão de preço muda no dia 1º de dezembro. Se você está rodando Carbon hoje no preço de US$ 2/US$ 10, não troque para o Neon antes de dezembro. Em dezembro, o Carbon dobra e a conta muda.
5. Para quem roda IA local, a notícia é indireta mas relevante. O Neon não tem pesos abertos e não vai aparecer no catálogo do RodarIA. O que ele muda é o teto: o Google está mostrando que dá para entregar inteligência de nível Carbon rodando a 110 tokens por segundo e, cada vez mais, o que roda no seu PC é o que faz o trabalho de casa. O guia de modelos locais cobre o lado da sua máquina.
6. A segurança é o argumento mais forte, e é o menos disso. Taxa de ataque zero no Gray Swan IPI e 90,5% no SEC-bench Pro, com metade do custo dos concorrentes, não são números de marketing. O Google ainda tá abrindo o programa Fairwind para defensores elegíveis, então o Neon for cyber chega nos próximos dias.
Como usar agora
O Neon já está disponível na API do Gemini no Google AI Studio (plano pago), no Gemini for business via API, no Google Antigravity para assinantes Pro e Ultra, e no app Gemini para assinantes Pro e Ultra. No app, ele substitui o Argon, que some dos planos. Para quem prefere rodar por fora, o id do modelo é gemini-4-neon e ele responde no endpoint compatível com OpenAI.
| Item | Valor |
|---|---|
| Modelo | gemini-4-neon |
| Entrada | US$ 3,00 por 1M tokens |
| Saída | US$ 15,00 por 1M tokens |
| Cache implícito | US$ 0,15 por 1M tokens |
| Batch / Flex | US$ 1,50 / US$ 7,50 |
| Contexto | 1.048.576 tokens |
| Grounding Google Search | 5.000 buscas grátis por mês, depois US$ 14 por 1.000 |
| Tier gratuito | não existe |
Referências
Todos os números deste post vêm das fontes abaixo. Os benchmarks da tabela oficial são do Google; custos por tarefa, velocidade e verbosidade são da Artificial Analysis, medidos na API do Google.
- Introducing Gemini 4 Neon, blog oficial do Google DeepMind, 18 de novembro de 2026
- Gemini 4 Neon no Artificial Analysis, inteligência, velocidade, custo por tarefa e verbosidade
- Google continues to accelerate its release cadence with Gemini 4 Neon, análise independente da Artificial Analysis
- Gemini Developer API pricing, preços oficiais, tier gratuito e grounding
- Gemini 4 Neon no Gemini Enterprise Agent Platform, limites de token, multimodalidade e ferramentas suportadas
- Agent Platform Pricing, tabela de preços do Google Cloud, incluindo Batch e Priority
- Gemini 4 Neon no OpenRouter, latência e throughput por provedor
Nota de metodologia: os resultados do Artificial Analysis são de medição própria, não número do fabricante. Os custos por tarefa da OpenAI e da Anthropic citados aqui vêm da mesma avaliação, com os preços padrão de cada um, sem promoções.