
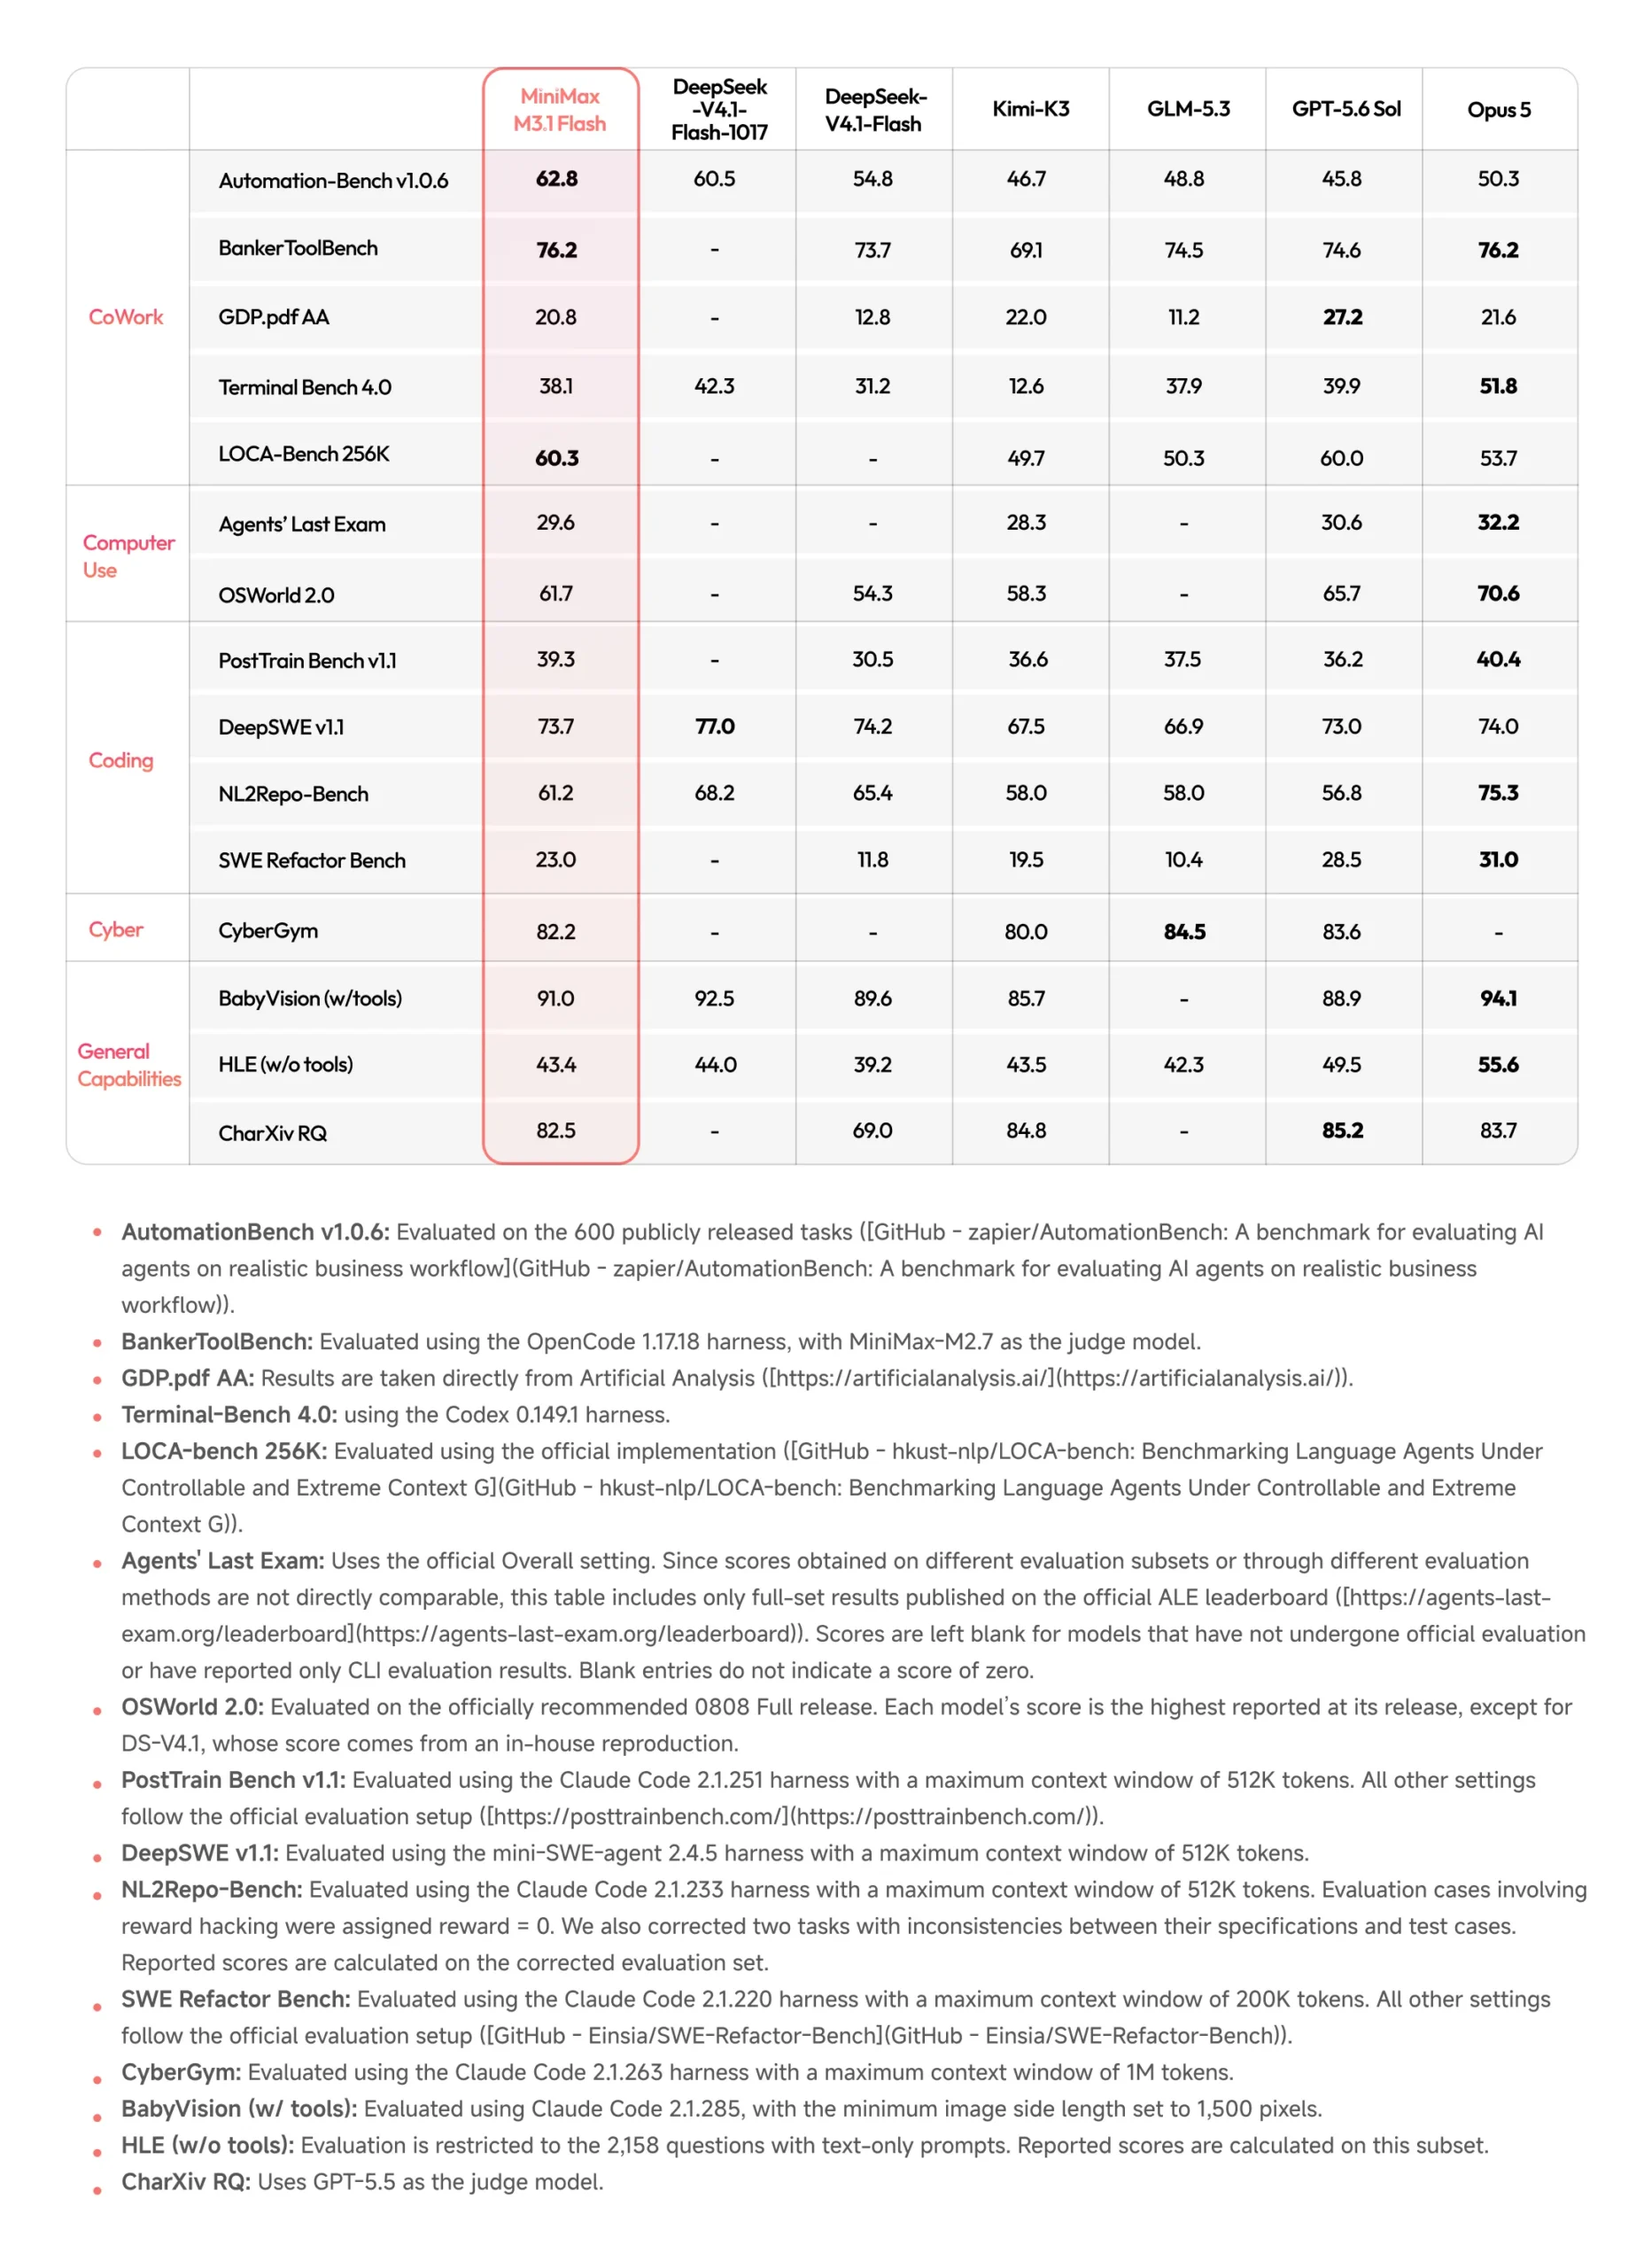
19 de outubro de 2026 – A MiniMax revelou hoje que o MiniMax M3.1 Flash, lançado oficialmente hoje, era o mesmo modelo que apareceu anônimo em setembro como Space Bunny e consumiu mais de 200 trilhões de tokens em arenas públicas antes da divulgação. É o primeiro modelo Flash da MiniMax desde o M3 e entrega 73.7% no DeepSWE v1.1 (mesma marca do Claude Opus 5 max), 61.7% no OSWorld 2.0 (à frente de qualquer modelo chinês) e 82% no CyberGym, tudo isso cobrando $0.15 por milhão de tokens de input e $0.60 por milhão de output.
O número que importa
O M3.1 Flash custa $0.15 por milhão de tokens de entrada. O Claude Sonnet 4.5 cobra $3.00. Isso é 20x mais barato por token de input. No agregado (blend 3:1 input/output), o Flash sai 22.9x mais barato que o Claude Sonnet 4.5 segundo o LLM Stats Score. Para um agente de código que faz dezenas de chamadas por sessão, isso muda a economia do produto inteiro.
A MiniMax também diz que o custo total de uso em tarefas agentic caiu 70% em relação ao M3, e a inferência online ficou quase 3x mais rápida. Em uso diário, a velocidade de output passa de 200 TPS com mediana (P50) de 170+ TPS.
O caso Space Bunny
Por quase três semanas, o nome Space Bunny dominou leaderboards anônimos e roteadores como OpenRouter e OpenCode. O modelo ficou em primeiro lugar por 10 dias consecutivos no OpenRouter, processou 56.7 trilhões de tokens lá (recorde histórico de qualquer deploy anônimo na plataforma) e o tráfego total pré-reveal passou de 200 trilhões de tokens entre arenas globais. Foi a maior operação stealth já registrada por um modelo chinês.
Hoje a MiniMax confirmou: Space Bunny era um build de pré-avaliação do M3.1 Flash. O modelo foi testado em produção real antes mesmo de ganhar nome. O OpenRouter chegou a oferecer o M3.1 Flash grátis por 72 horas no lançamento.
A linha-up e o que muda
| Spec | MiniMax M3.1 Flash | MiniMax M3 (anterior) |
|---|---|---|
| Tipo | Flash (agente/coding) | Frontier completo |
| Contexto | 1.000.000 tokens | 1.000.000 tokens |
| Modalidade input | texto, imagem, vídeo | texto, imagem, vídeo |
| Input / M tokens | $0.15 | $0.30 |
| Output / M tokens | $0.60 | $1.20 |
| Cache read / M tokens | $0.015 | $0.06 |
| Throughput | 200+ TPS (P50 170+) | 110 TPS |
| Latência (P50) | 0.50s | 1.08s |
| TTFT (end-to-end) | 19.24s | 34.35s |
| Pesos | Liberados em 23 de outubro | Já abertos |
| Licença | MiniMax Community (comercial OK) | MiniMax Community |
O preço é exatamente o mesmo do DeepSeek V4.1-Flash-1017 em horário off-peak. Para referência, Gemini 3.7 Flash cobra $0.75/$3.75 — 5x mais caro no input, 6x no output. Claude Sonnet 4.5 cobra $3.00/$15.00.
Arquitetura e raciocínio
O M3.1 Flash mantém o esqueleto MoE do M3 mas aplica sparsity mais agressiva para empurrar throughput. O modelo ativa o raciocínio por padrão (reasoning_content no protocolo OpenAI, bloco thinking no Anthropic) e o parâmetro effort aceita low, medium, high, xhigh e max. Omitir o campo assume max automaticamente — é o oposto da convenção OpenAI onde “sem thinking” é o default.
A profundidade de raciocínio é ajustável em quatro APIs distintas (Anthropic, OpenAI Chat, OpenAI Responses e a nativa da MiniMax), todas com base URL em api.minimax.io. O modelo aceita contexto de até 1 milhão de tokens e é multimodal nativo — texto, imagem e vídeo entram no mesmo endpoint.
Benchmarks
Os números abaixo vêm da MiniMax no post de lançamento. Onde há leitura independente de terceiro, eu anoto. Harness não foi divulgado pela MiniMax para o DeepSWE; o DeepSeek V4.1-Flash reportou Mini-SWE-V2 como harness, então comparações diretas entre os dois vendors merecem cautela.
Coding

| Modelo | DeepSWE v1.1 | Harness | Notas |
|---|---|---|---|
| MiniMax M3.1 Flash | 73.7% | mini-swe-agent 2.4.5 (vendor self report) | thinking=max |
| Claude Opus 5 | 73.7% | mini-swe-agent (Datacurve) | thinking=max, $11.84/task |
| DeepSeek V4.1 Flash 1017 | 77.0% (lab-internal) / 74.2% (Datacurve) | mini-swe-agent | M3.1 perde no self-report, mas ganha em custo |
| GPT-6 Astra | 74.1% | mini-swe-agent (Datacurve) | $4.43/task |
| Gemini 3.8 Flash | 73.8% | mini-swe-agent (Datacurve) | $2.36/task |
| Claude Sonnet 4.5 | 69.7% (max) | mini-swe-agent | $5-6/task |
No DeepSWE 1.1, M3.1 Flash empata com Claude Opus 5 no top effort (73.7% ambos), fica à frente de Sonnet 4.5 e do Gemini 3.8 Flash e atrás do GPT-6 Astra por 0.4 ponto. O DeepSeek V4.1 Flash 1017 reportou 77.0% no model card oficial — 3.3 pontos acima. Diferença de harness, mas o argumento da MiniMax de “top performer” fica comprometido nesse teste específico.
Computer Use

| Modelo | OSWorld 2.0 (binary) | Posição |
|---|---|---|
| GPT-6 Astra | 72.6% | #1 |
| Claude Opus 5 | 70.6% | #2 |
| Gemini 4 Argon | 69.2% | #3 |
| Muse Spark 1.3 | 66.9% | #4 |
| GPT-5.6 Sol | 62.6% | #5 |
| MiniMax M3.1 Flash | 61.7% | #6 |
| GPT-6 Sol | 60.5% | #7 |
| Gemini 3.8 Flash | 59.0% | #8 |
Aqui o M3.1 Flash brilha: #6 no mundo, #1 entre modelos chineses, à frente do GPT-5.6 Sol e empatado em faixa com GPT-6 Sol e Gemini 3.8 Flash. A leitura do post original diz “OSWorld V2”, mas o leaderboard consolidado da BenchLM mostra que o número bate exatamente com a métrica binary do OSWorld 2.0 (108 tarefas long-horizon).
Agents’ Last Exam (ALE)

| Modelo | ALE | Notas |
|---|---|---|
| MiniMax M3.1 Flash | 29.6 | #1 entre modelos chineses (vendor self report) |
| DeepSeek V4.1 Flash 1017 | 35.4 | self report DeepSeek |
| Gemini 3.7 Flash | 26.3 | independente |
Aqui a MiniMax também reivindica o topo chinês, mas o DeepSeek self-reportou 35.4, 5.8 pontos acima. Os dois vendors não divulgaram o harness, então a comparação é ruidosa. Por enquanto, o número da MiniMax é o que está em jogo.
CyberGym e segurança
82% no CyberGym, benchmark de descoberta e validação de vulnerabilidades. O score é o mais alto já reportado publicamente nessa suite. Avaliações internas da MiniMax (não independentes) apontam performance forte em code auditing, vulnerability patching, penetration testing, malware analysis e reverse engineering.
BankerToolBench
76.2 no BankerToolBench, benchmark de workflows financeiros com compliance, chained tool calls, planejamento multi-step e consistência entre documentos. É um nicho, mas é o número mais alto que já vi reportado nessa suite.
AutomationBench
62.2 no AutomationBench (BenchLM agregou; MiniMax não publicou número exato no post original, só disse “ranks among the top performers”). Workflows SaaS reais em vendas, marketing, operações, customer service, finanças e RH.
LMSYS Code Arena: WebDev
Não reportado no post, mas o Kilo Leaderboard e a cobertura do LLMs Blog registraram: 1588 Elo no debut, +106 pontos sobre o M3, #12 entre modelos abertos, com saltos expressivos em Gaming (+179), Reference Design (+155), Simulations (+122) e Content Creation Tools (+113). Foi o suficiente para colocar a MiniMax no top 12 mundial de research labs abertos.
Preço e a conta que ninguém quer fazer
| Modelo | Input / M | Output / M | Cached input / M | Ratio vs M3.1 Flash |
|---|---|---|---|---|
| MiniMax M3.1 Flash | $0.15 | $0.60 | $0.015 | 1x |
| MiniMax M3 | $0.30 | $1.20 | $0.06 | 2x |
| DeepSeek V4.1 Flash (off-peak) | $0.15 | $0.60 | $0.015 | 1x |
| DeepSeek V4.1 Flash (peak) | $0.27 | $1.10 | $0.027 | ~1.8x |
| GPT-5.6 Sol | ~$3.45 | ~$13.80 | — | 23x |
| Claude Sonnet 4.5 | $3.00 | $15.00 | — | 20x |
| Gemini 3.7 Flash | $0.75 | $3.75 | — | 5x |
Cenário real: um agente de coding que gasta 500k tokens de input e 200k de output por sessão de 30 minutos. No Claude Sonnet 4.5, essa sessão custa $4.50. No M3.1 Flash custa $0.195. Em 10 mil sessões/mês (volume típico de um SaaS de coding agent em produção), a economia anualizada é $517k. Esse é o ponto.
Open weights e self-hosting
A MiniMax disse que os pesos saem em 23 de outubro, quatro dias após o lançamento. Serão liberados sob MiniMax Community License, a mesma do M3 que permite uso comercial sem restrições (diferente da licença anterior non-commercial do M2.7).
A arquitetura é MoE, mantém o MSA (MiniMax Sparse Attention) introduzido no M3 e a base multimodal nativa. Sem o model card público ainda, não dá para cravar os números exatos de total/active params, mas a conta do M3 anterior (428B total, 23B ativos) é o ponto de partida provável — possivelmente com active params menor para empurrar o throughput acima de 200 TPS.
Para self-hosting sério, espere o mesmo perfil do M3: GPU cluster H100/H200 ou single-node B200/MI300X para inferência, VRAM mínimo de ~80GB para quantização INT4. Para produção, multi-node com Tensor Parallel + Expert Parallel. O preço de API é tão agressivo que o self-hosting só se justifica em escala muito alta (>100M tokens/mês).
Use cases
A MiniMax empurrou três áreas como foco: agentes enterprise, computer use e coding agentic. O stack recomendado é o MiniMax Code, o agente de desktop da empresa (download em agent.minimax.io/download) atualizado para casar com o M3.1 Flash. O Agent Team do MiniMax Code permite rodar múltiplos agentes em paralelo com harness adversarial Producer+Verifier.
Em workflows reais, a MiniMax destaca:
- Cowork / office automation — planilhas, e-mails, CRM updates, tarefas repetitivas com 30+ passos encadeados. O número do AutomationBench (62.2) coloca o M3.1 Flash 2x acima do Gemini 3.7 Flash (30.4) nessa categoria.
- Long-horizon coding — sessões que iteram sobre múltiplos arquivos, debug, refactor.
- Cybersecurity — análise de CVE, patch de vulnerabilidades conhecidas, auditoria de código sob demanda. 82% no CyberGym é o número que sustenta isso.
- Pesquisa financeira — workflows com compliance e chained tool calls. BankerToolBench 76.2 sustenta isso.
O que isso significa
- A guerra de preço do Flash chegou a um patamar novo. $0.15/$0.60 com cache read a $0.015 era o DeepSeek. Agora é o default chinês. Modelos fechados a $3/$15 vão ter que justificar o premium com qualidade absoluta, não com lock-in. O Gemini 3.7 Flash a $0.75/$3.75 ficou sem espaço entre o chinês barato e o Claude caro.
- Stealth deploy em escala industrial funciona. Space Bunny consumiu 200T tokens antes do reveal. Isso é feedback real de produção, não benchmark de laboratório. O M3.1 Flash foi testado por 10 dias no OpenRouter como se fosse modelo anônimo e aguentou. É a primeira vez que um modelo chinês roda em produção em escala global sem ser identificado, e a MiniMax capitaliza isso como selo de robustez.
- Os pesos saem em 4 dias. 23 de outubro. Pesos abertos com licença comercial OK para um modelo que bate Opus 5 em DeepSWE e GPT-5.6 Sol em OSWorld é um evento sísmico. Esperem forks, fine-tunes e versões destiladas pipocando na semana seguinte.
- DeepSeek V4.1-Flash-1017 continua à frente no ALE (35.4 vs 29.6) e no DeepSWE (77.0 vs 73.7) em self-report. Mas cobra o mesmo preço off-peak. A corrida entre os dois Flash chineses agora é por benchmark e harness, não por centavos.
- O Agent Team da MiniMax Code é o produto estratégico, não o modelo isolado. O M3.1 Flash sozinho é commodity em 6 meses. O harness adversarial Producer+Verifier rodando em cluster é o moat.
- O mix é presente envenenado para quem fechou contrato anual com Claude ou GPT-5 em julho. Quem assinou $3/$15 achando que era o piso de 2026 agora tem um concorrente 20x mais barato com 73.7% no DeepSWE. Renegociação vai ser inevitável.
Rodapé
- API:
https://api.minimax.io/v1(OpenAI-compatible) ouhttps://api.minimax.io/anthropic(Anthropic-compatible) - Modelo:
MiniMax-M3.1-Flash - Pesos: Hugging Face em 23 de outubro de 2026 (a confirmar repo)
- MiniMax Code desktop:
https://agent.minimax.io/download - Preços oficiais: platform.minimax.io/docs/pricing/overview
- Thinking depth field:
output_config.effort(Anthropic) oureasoning_effort(OpenAI); default émaxse omitido
Todos os benchmarks acima são vendor self-report. Comparações entre vendors diferentes merecem cautela por diferenças de harness, prompt e contagem de tokens. Em benchmarks de terceiro independentes (BenchLM, DeepSWE Tracker, LLM Stats, LiveBench) o M3.1 Flash ainda não tinha leitura validada na data de publicação deste post.