
Gemini 4 Argon: a Google voltou pra briga de verdade, 1 milhão de tokens de output e empate com GPT-6 Astra custando 60% menos
30 de setembro de 2026, depois de quase um ano só com Flash, a Google finalmente soltou um flagship de verdade. O Gemini 4 Argon é o primeiro modelo proprietário acima da classe Flash em 7 meses, marca 53 no Artificial Analysis Intelligence Index, empata com GPT-6 Astra (53) e abre 1 ponto sobre o GPT-6.1 Sol (52). E custa, na promoção de lançamento, $1,99 por tarefa do Intelligence Index, ou seja, 60% do preço do Astra pelo mesmo nível de inteligência. O Argon não está disponível publicamente ainda: o rollout começa pelo Fairwind Program para trusted defenders de cybersecurity, com expansão gradual para developers, enterprises e consumidores depois.
A cereja do bolo técnico é um número absurdo: o Argon aumenta o teto de output tokens para 1 milhão, contra os 64K do limite anterior. É o maior teto de geração de qualquer modelo frontier hoje, e foi pensado especificamente para deixar o modelo “pensar por horas” em uma única trajetória de raciocínio. A Google também publicou números novos em knowledge work, long-horizon software engineering, defesa cibernética e raciocínio multimodal.
O grande número
53 pontos no Artificial Analysis Intelligence Index. Para efeito de comparação, o melhor modelo da Google até então era o Gemini 3.8 Flash (high) com 41, e o antecessor Gemini 3.1 Pro Preview marcava apenas 30. Argon é um salto de +23 pontos sobre o Pro Preview e +12 sobre o Flash. Em termos práticos, a Google voltou ao top 3 de laboratórios por capacidade bruta de inteligência, lugar que vinha perdendo para OpenAI, Anthropic e dois laboratórios chineses desde o lançamento do Gemini 3.5 Pro (cancelado em maio).
O segundo número absurdo é o de 1 milhão de tokens de output. GPT-6 Astra e Fable 5.1 documentam 128K de output. Claude Opus 5.5 documenta 128K com um beta de 300K para Message Batches. Argon não é 8x maior, é quase 8x maior que o teto padrão de qualquer concorrente direto. Tradução: dá pra pedir pro Argon gerar uma codebase inteira, um relatório de due diligence de 200 páginas ou um exploit chain completo em uma única chamada, sem precisar emendar respostas.
O treinamento que o mundo não assistiu (mas o Google usou)
Diferente da Xiaomi com o MiMo ou da DeepSeek com o V4, a Google não documentou treinamento público dessa vez. O que a empresa contou foram três vitórias internas em produção que servem como vitrine:
- Otimização quântica: Argon ajudou pesquisadores de quantum computing a otimizar o “spacetime resource” (qubits × gates) de subrotinas que travavam aplicações importantes. Em um caso, superou o baseline publicado em 40% em minutos.
- Eficiência de memória: agentes Argon analisaram telemetria de profiling de toda a frota de data centers da Google, identificaram e aplicaram otimizações de memória autonomamente. Resultado: 300 TiB liberados na primeira rodada, com estimativa de 500 TiB a 1 PiB no total.
- Migração de C/C++ para Rust em escala: agentes Argon estão migrando partes do Google de C/C++ para Rust, variando de dezenas de milhares de linhas em bibliotecas como re2 e libgav1, até 800K+ linhas do kernel Zircon do Fuchsia OS. No caso do libgav1 (decodificador de vídeo open source), os agentes pegaram um port em Rust e substituíram 32K linhas de código SIMD rodando várias rodadas de experimentos profile-guided, estudando o output do compilador e produzindo Rust safe que o compilador vetoriza automaticamente. O decoder final roda 2.7x mais rápido que o port original, com output de vídeo idêntico.
Esse último caso é especialmente relevante: o Argon não só reescreveu 32K linhas de código SIMD crítico de performance, como melhorou o resultado. É o tipo de tarefa que humanos Sênior de kernel passam semanas afinando.
Especificações e preços
A linha de produto segue enxuta. Argon é um único modelo (não há “Argon Pro” ou “Argon Flash” ainda), com preços que dobram depois do período promocional:
| Modelo / Fase | Input / 1M tokens | Output / 1M tokens | Cache read / 1M |
|---|---|---|---|
| Argon (intro) | $2,00 | $10,00 | $0,10 (95% off) |
| Argon (pós-promo) | $4,00 | $20,00 | $0,20 |
| GPT-6 Astra | $10,00 | $50,00 | $1,00 |
| GPT-6.1 Sol | $2,00 | $10,00 | $0,10 |
| Claude Opus 5.5 | $4,00 | $20,00 | $0,20 |
| Claude Fable 5.1 | $10,00 | $50,00 | $0,25 |
| Claude Sonnet 5.5 | $2,00 | $10,00 | $0,20 |
| Gemini 3.8 Flash | $0,75 | $3,75 | $0,075 |
A Google não divulgou data de fim da promoção. Comparando com GPT-6 Astra no período promocional, Argon é 5x mais barato no input e 5x mais barato no output. Mesmo depois da promoção, Argon fica 60% mais barato que Astra nos dois lados.
Specs principais que aparecem no anúncio e em cards de modelo:
| Spec | Valor | Observação |
|---|---|---|
| Output máximo | 1.000.000 tokens | Subiu de 64K. Maior teto de qualquer frontier hoje. |
| Context window | Multimodal evaluations até 1M | Limite de input na API pública ainda não totalmente confirmado. |
| Modalidades de input | Texto, imagem, vídeo, arquivo | Mesmas do Gemini 3.8 Flash. |
| API ID pública | Não confirmado no anúncio | Google ainda não publicou o ID de produção. |
| Reasoning | Thinking effort “max” usado na maioria dos evals | Controles de API pública pendentes. |
| Pesos | Privados | Sem plano de open-weight anunciado. |
Benchmarks: vitórias, derrotas e onde “empate” não é vitória
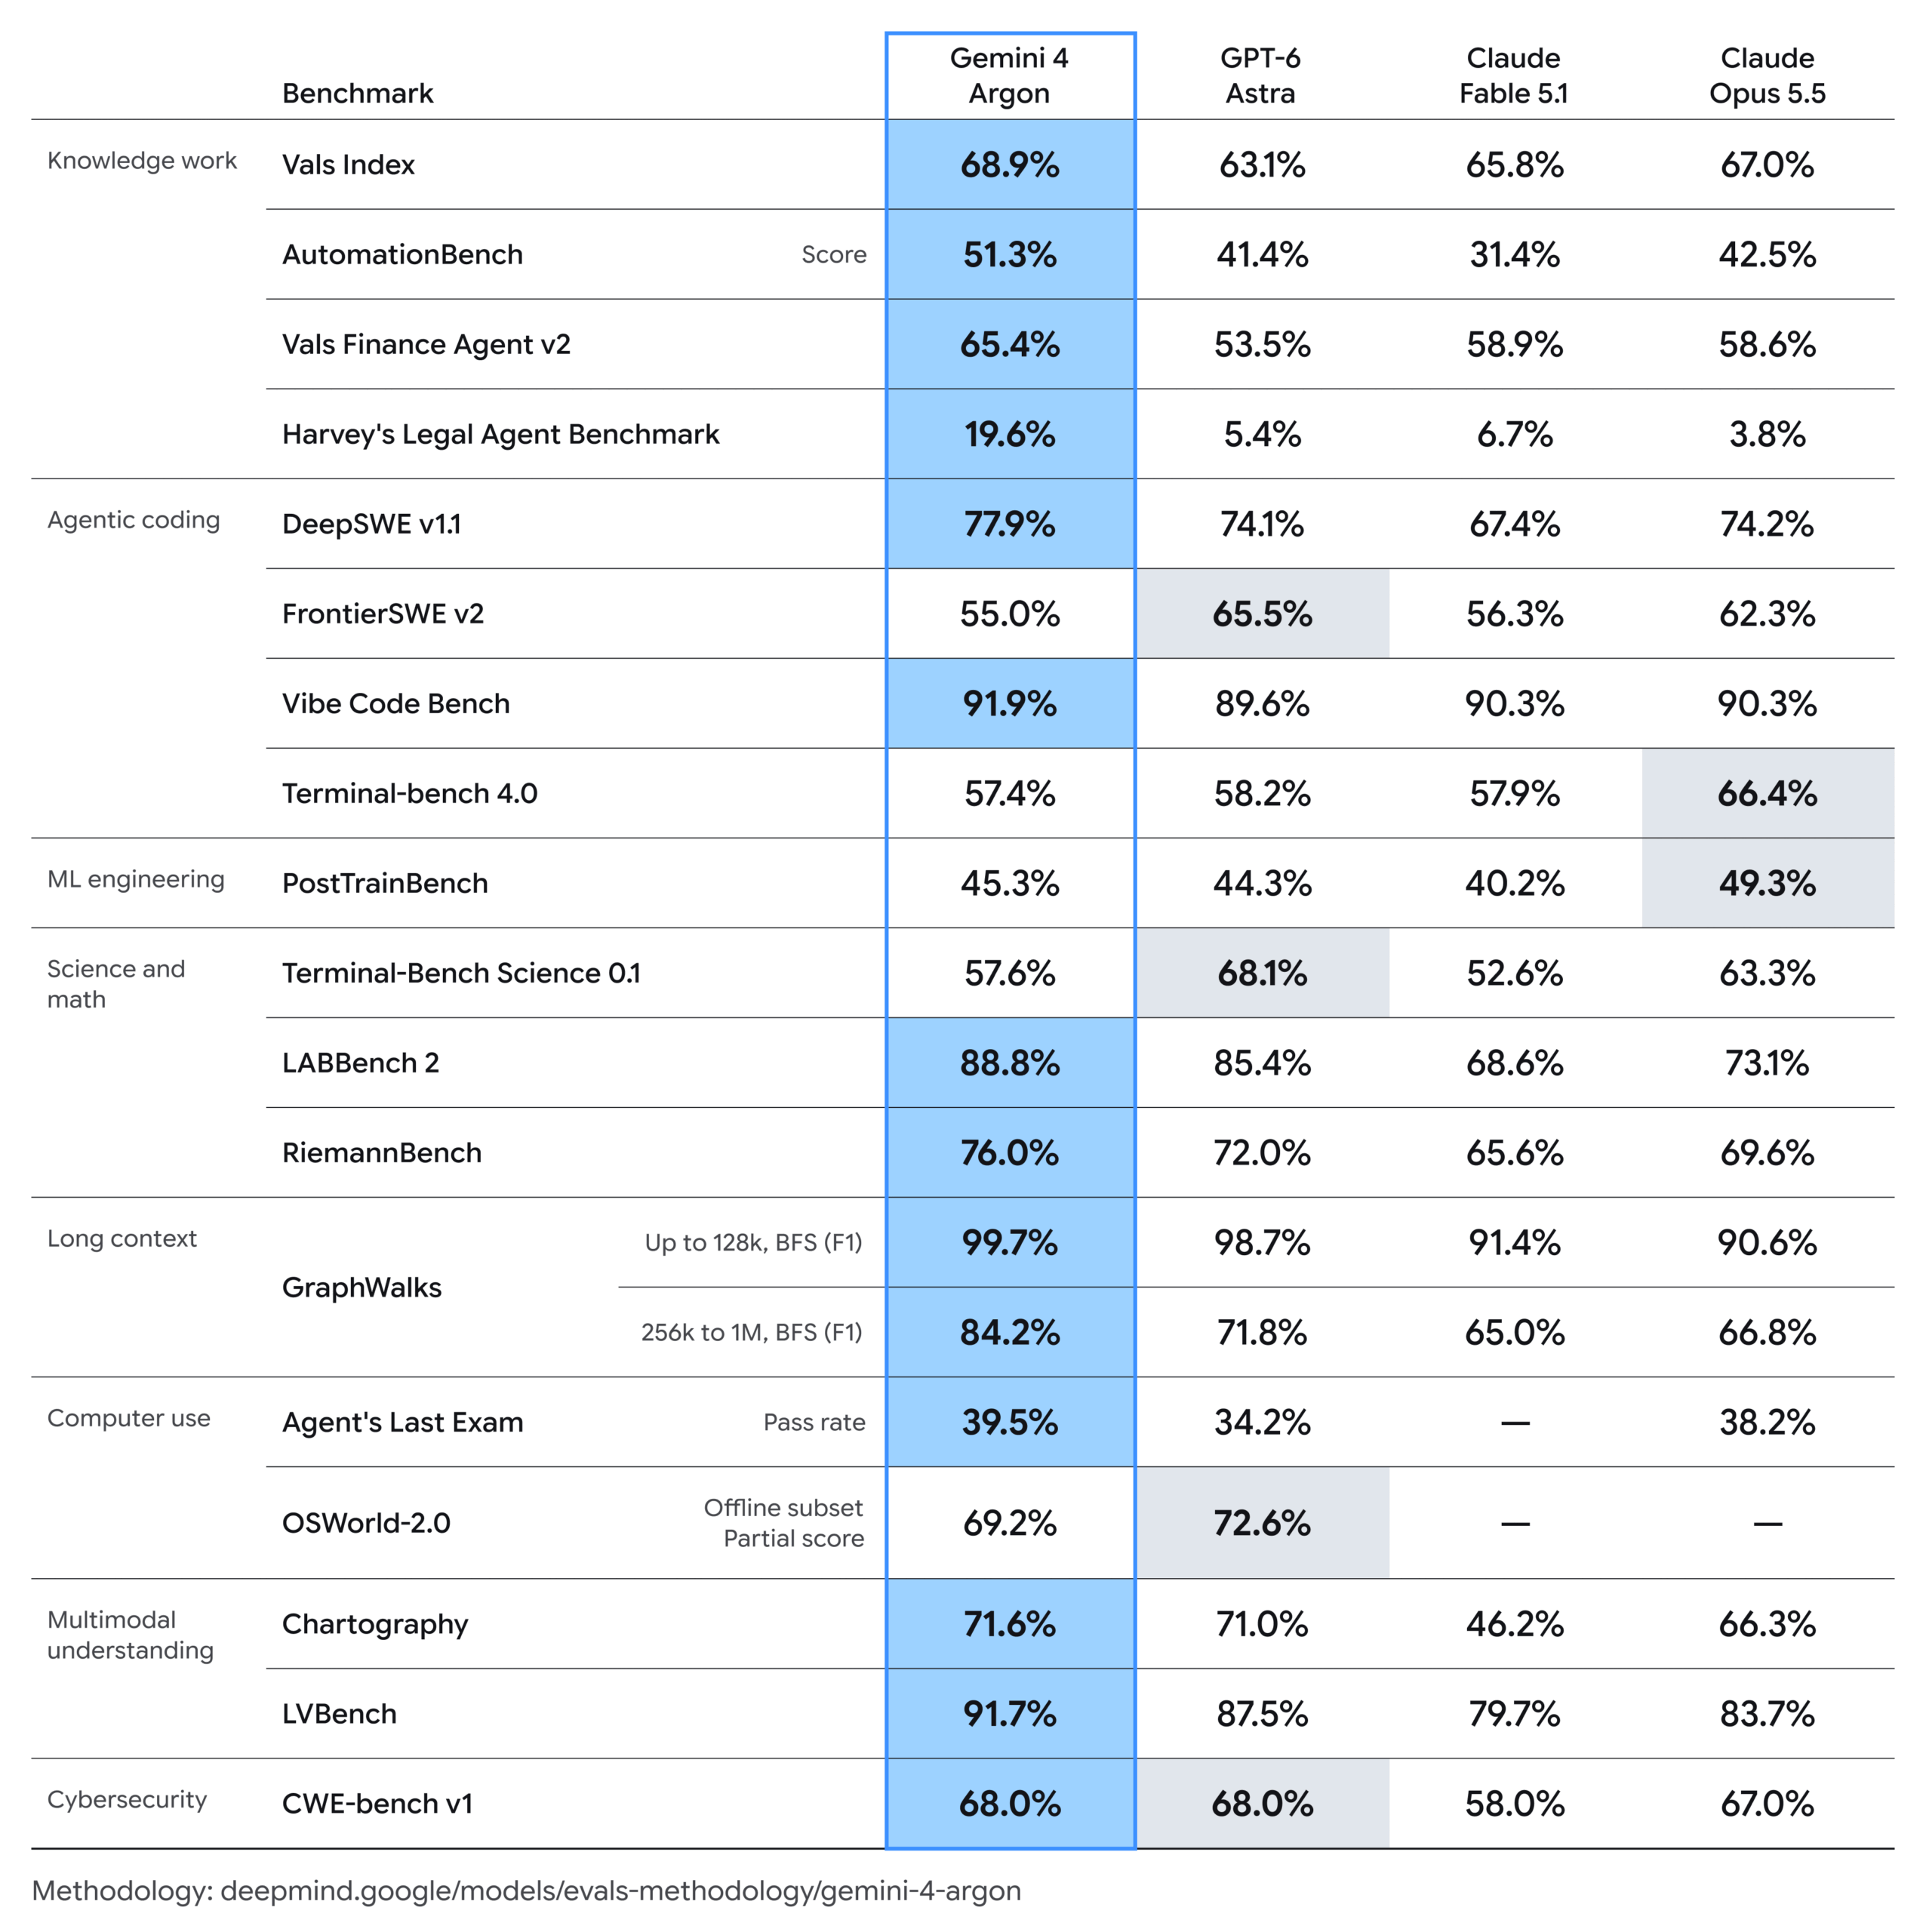
Aqui é onde o post fica honesto. Os números abaixo são da tabela oficial da Google, comparando Argon com GPT-6 Astra, Claude Fable 5.1 e Claude Opus 5.5. O Google usou configuração “highest thinking” e geralmente tentativa única. Onde o Google omitiu o resultado de um rival, marquei com N/D.
Knowledge work e enterprise
| Benchmark | Argon | GPT-6 Astra | Fable 5.1 | Opus 5.5 |
|---|---|---|---|---|
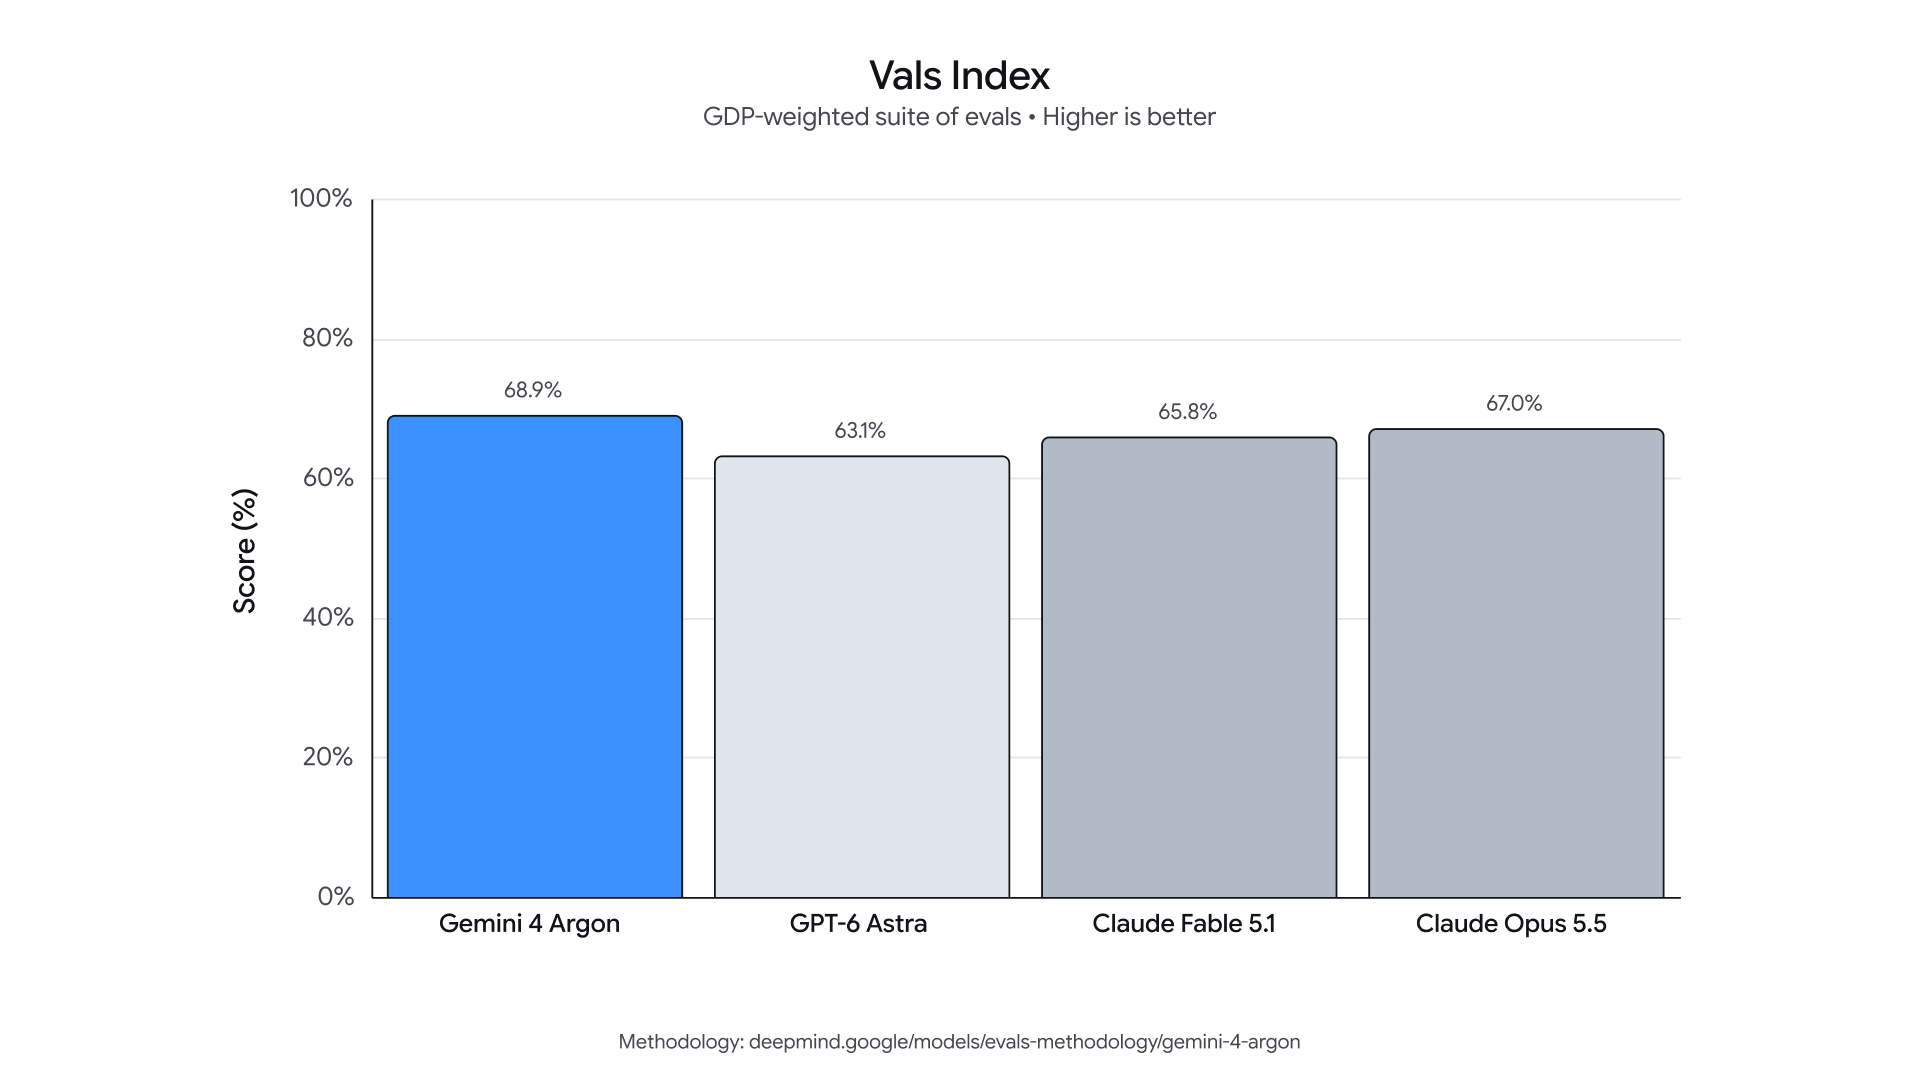
| Vals Index (impacto econômico) | 68,9% | 63,1% | 65,8% | 67,0% |
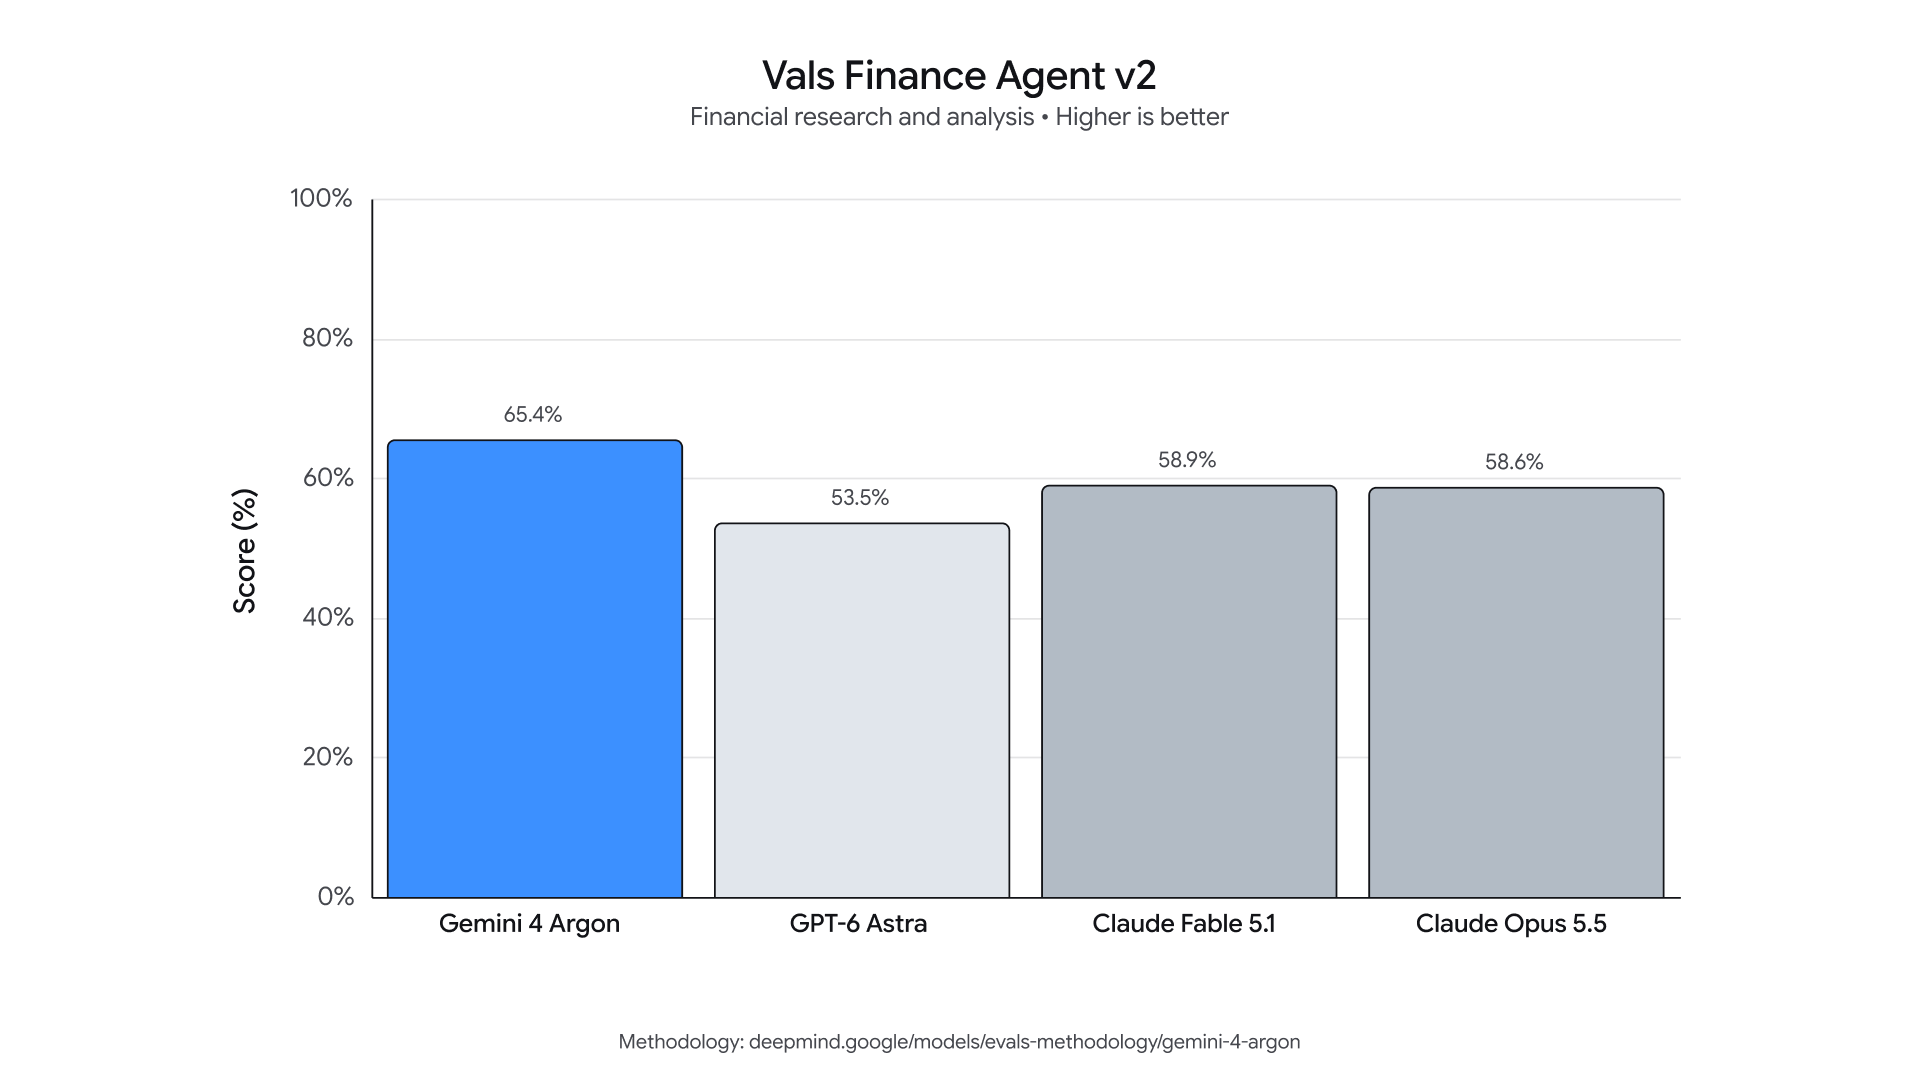
| Vals Finance Agent v2 | 65,4% | 53,5% | 58,9% | 58,6% |
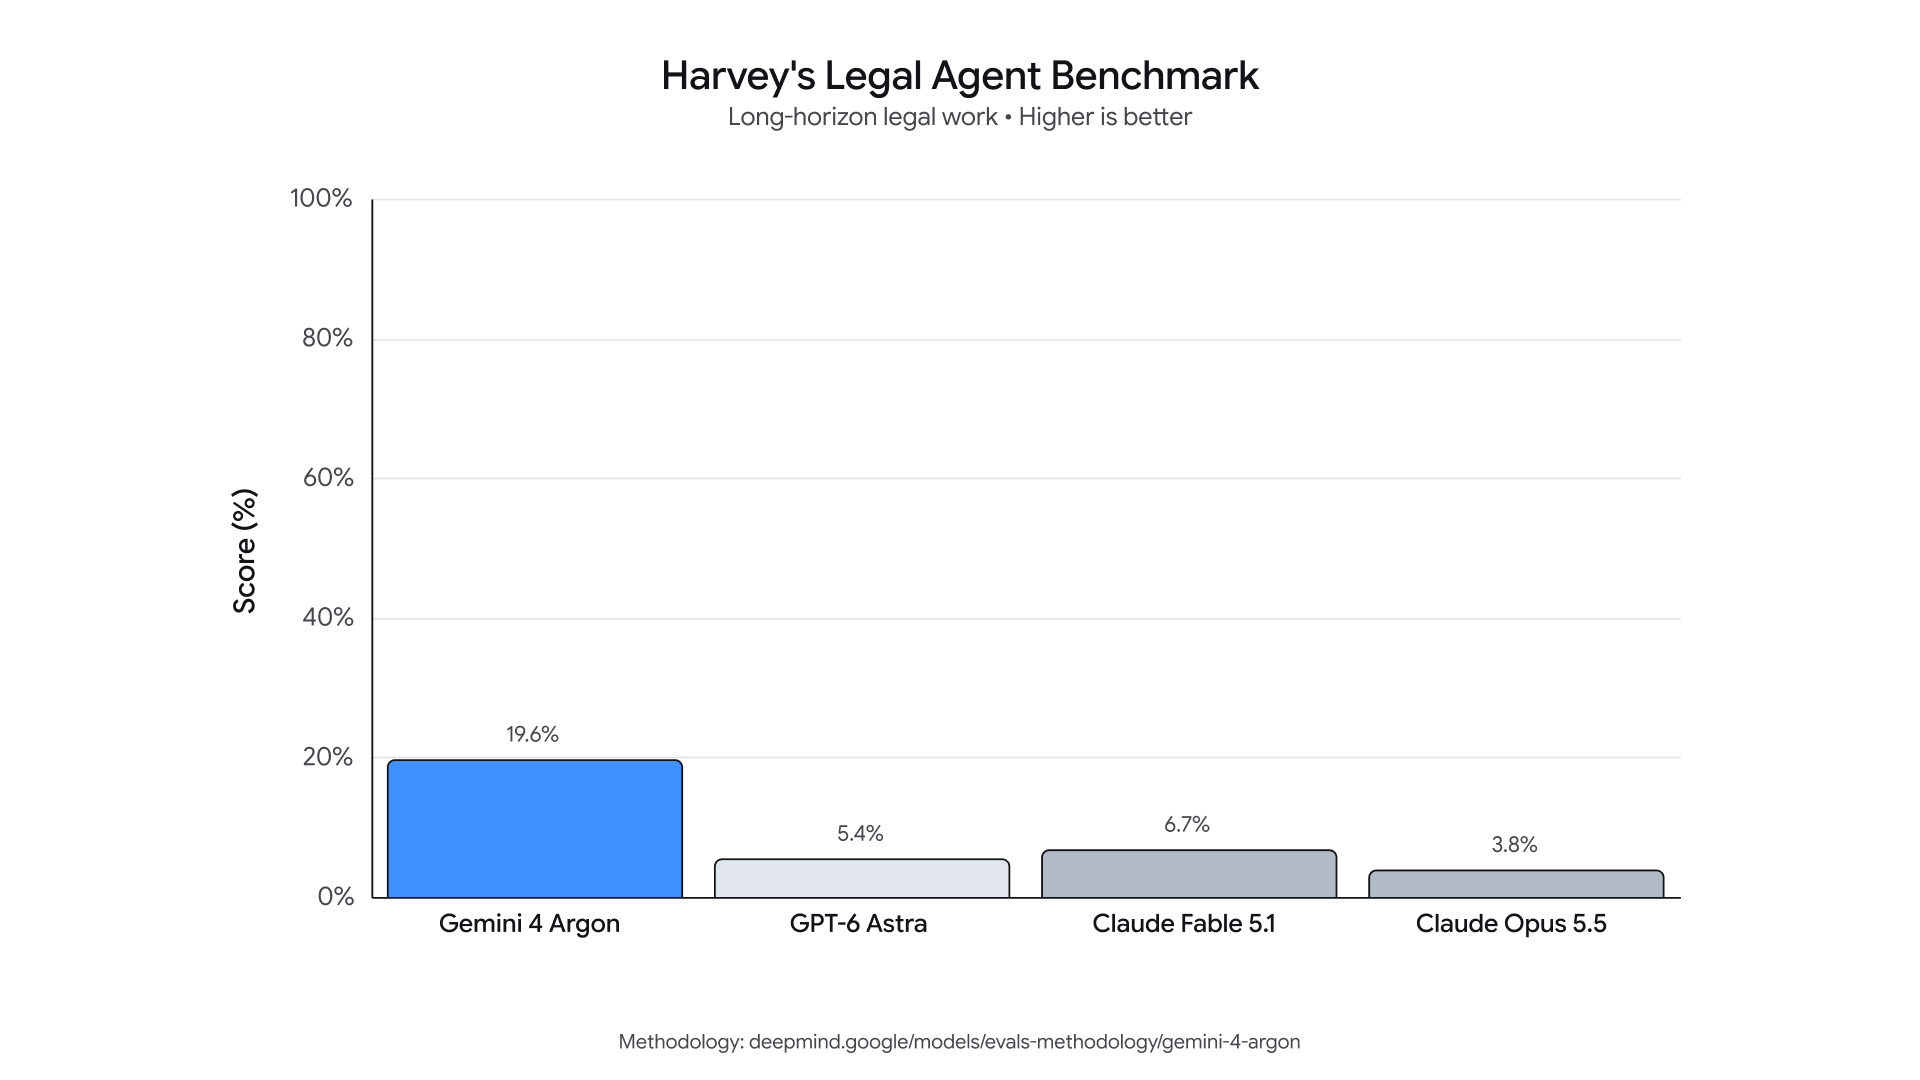
| Harvey’s Legal Agent Benchmark | 19,6% | 5,4% | 6,7% | 3,8% |
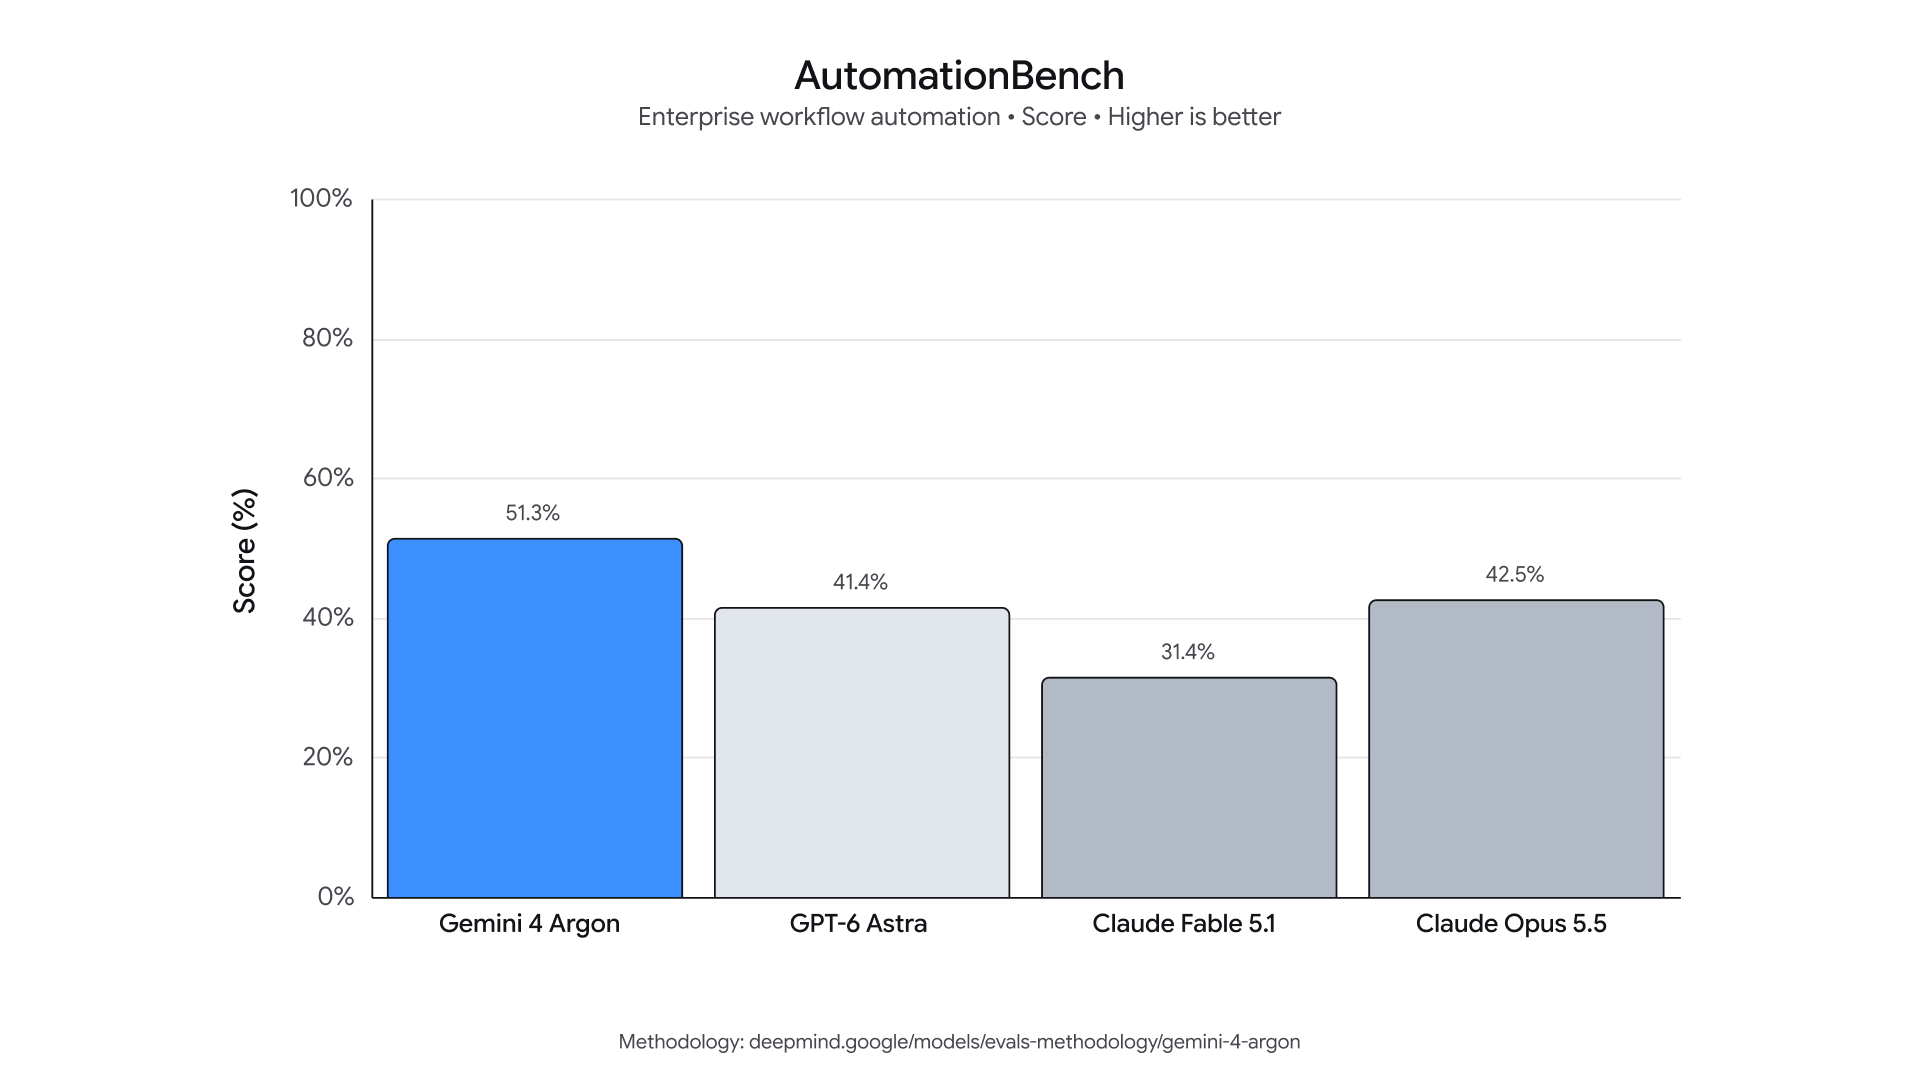
| AutomationBench (Zapier) | 51,3% | 41,4% | 31,4% | 42,5% |
| PostTrainBench | 45,3% | 44,3% | 40,2% | 49,3% |
Aqui o Argon varre: lidera 4 de 5 benchmarks. Margem mais gorda no Harvey’s Legal (3,6x mais que o Fable) e no AutomationBench (+8,8 pontos sobre o Opus). A ressalva honesta: PostTrainBench o Opus 5.5 ainda lidera, então Argon não é dominador absoluto em conhecimento profissional.
Software engineering
| Benchmark | Argon | GPT-6 Astra | Fable 5.1 | Opus 5.5 |
|---|---|---|---|---|
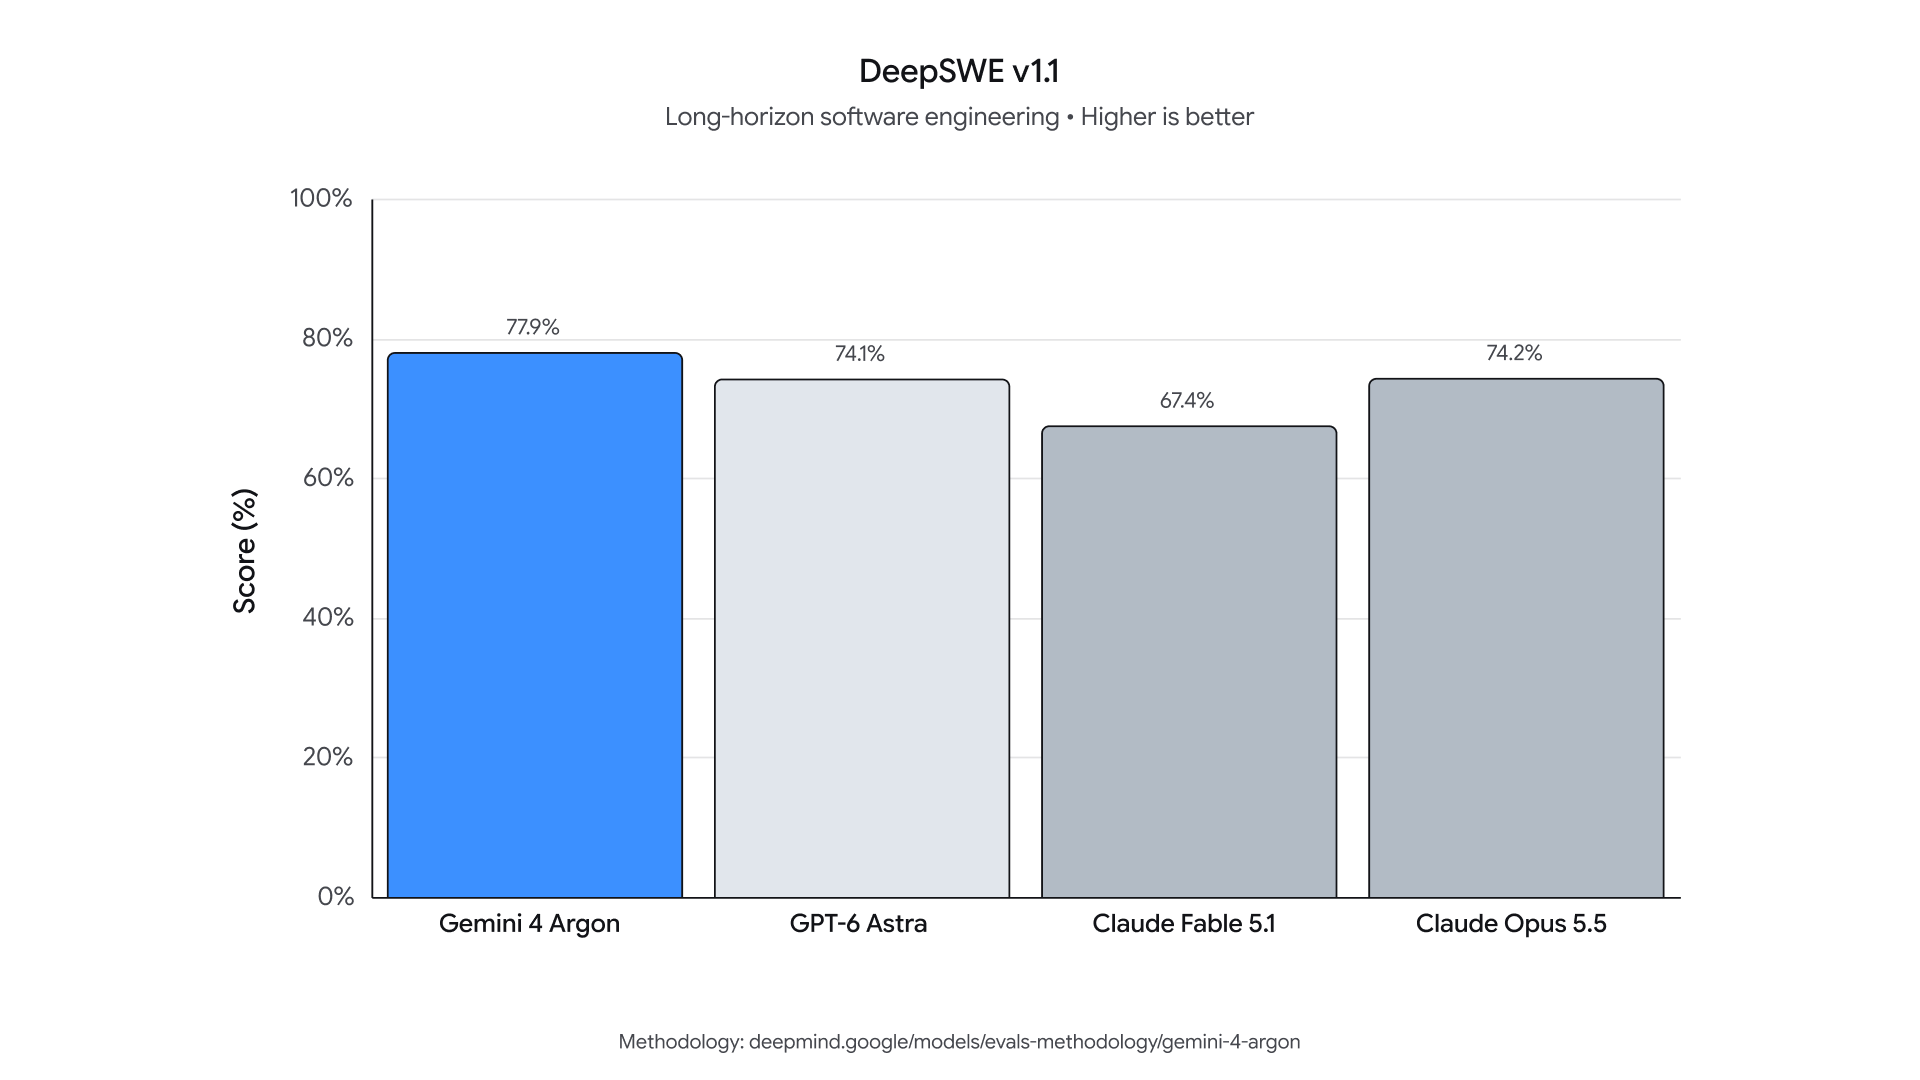
| DeepSWE v1.1 (long-horizon eng) | 77,9% | 74,1% | 67,4% | 74,2% |
| FrontierSWE v2 | 55,0% | 65,5% | 56,3% | 62,3% |
| Vibe Code Bench | 91,9% | 89,6% | 90,3% | 90,3% |
| Terminal-bench 4.0 | 57,4% | 58,2% | 57,9% | 66,4% |
| Terminal-Bench Science 0.1 | 57,6% | 68,1% | 52,6% | 63,3% |
Aqui a história muda. Argon lidera DeepSWE e Vibe Code Bench, mas perde feio em FrontierSWE v2 (Astra +10,5 pontos), Terminal-bench 4.0 (Opus +9 pontos) e Terminal-Bench Science 0.1 (Astra +10,5 pontos). Em três dos cinco benchmarks de engenharia mais pesados, Argon está atrás. Isso é informação importante porque derruba a narrativa “Argon domina coding”: ele domina um benchmark específico de software engineering long-horizon (DeepSWE), mas em testes de execução real no terminal e em ciência ele apanha.
Raciocínio e ciência
| Benchmark | Argon | GPT-6 Astra | Fable 5.1 | Opus 5.5 |
|---|---|---|---|---|
| LABBench 2 | 88,8% | 85,4% | 68,6% | 73,1% |
| RiemannBench | 76,0% | 72,0% | 65,6% | 69,6% |
| Agent’s Last Exam (pass rate) | 39,5% | 34,2% | N/D | 38,2% |
Argon lidera todos os três, com vantagem bem gorda em LABBench 2 (+15,7 sobre Opus). Em Agent’s Last Exam, Argon finalmente ultrapassa os 38,2% do Opus 5.5, que era o teto dos modelos anteriores para a avaliação.
Multimodal e visão
| Benchmark | Argon | GPT-6 Astra | Fable 5.1 | Opus 5.5 |
|---|---|---|---|---|
| LVBench (long video) | 91,7% | 87,5% | 79,7% | 83,7% |
| Chartography | 71,6% | 71,0% | 46,2% | 66,3% |
| OSWorld-2.0 (offline subset) | 69,2% | 72,6% | N/D | N/D |
Argon lidera LVBench e Chartography, mas perde para Astra em OSWorld-2.0 por 3,4 pontos. Importante: o Google rodou OSWorld com no máximo 3 tentativas no subset offline, o que limita a comparabilidade direta.
Long-context reasoning (GraphWalks)
| Condição | Argon | GPT-6 Astra | Fable 5.1 | Opus 5.5 |
|---|---|---|---|---|
| Até 128K; breadth-first search, F1 | 99,7% | 98,7% | 91,4% | 90,6% |
| 256K a 1M; BFS F1 | 84,2% | 71,8% | 65,0% | 66,8% |
Esse é talvez o resultado mais importante do anúncio. No regime de 256K a 1M tokens de contexto, Argon é 12,4 pontos acima de Astra, 17,4 acima de Opus e 19,2 acima de Fable. A maioria dos modelos “degrada” em raciocínio conforme o input cresce. Argon degrada muito menos. Isso é evidência forte de que o teto de output de 1M tokens é genuíno, não marketing.
Cybersecurity: o foco real do lançamento
Argon foi explicitamente treinado para defesa cibernética, e a Google está lançando-o sem guardrails de cyber para trusted defenders e para times internos da Google. O case público mais marcante é com a Wiz, através do programa Scan for Good (que usa o Red Agent da Wiz em cima de modelos Gemini):
“Em uma demonstração inicial de impacto, o modelo descobriu uma vulnerabilidade crítica expondo informações pessoais sensíveis em software de saúde usado por hospitais no mundo todo, identificando um risco severo que modelos frontier anteriores tinham deixado passar.”
A Wiz adquiriu participação da Google no início do ano por $32 bilhões, então não é parceria casual. Os números reportados em cyber:
| Benchmark | Argon | Notas |
|---|---|---|
| CWE-bench v1 | 68,0% (empata com GPT-6 Astra) | Remediação de vulnerabilidades conhecidas. |
| CyberGym (interno) | Supera 3.8 Flash Cyber | Argon supera o Flash Cyber e modelos maiores. |
| Wiz black-box pentest (interno) | Supera 3.8 Flash Cyber | Análise de sistemas web sem source code. |
| Gray Swan IPI (prompt injection) | Líder da categoria | Mais resiliente do que qualquer modelo anterior a prompt injection indireta. |
| Internal vuln discovery (20 linguagens) | Cobre amplo espectro | Sucesso em descobrir exposições em 20 linguagens diferentes. |
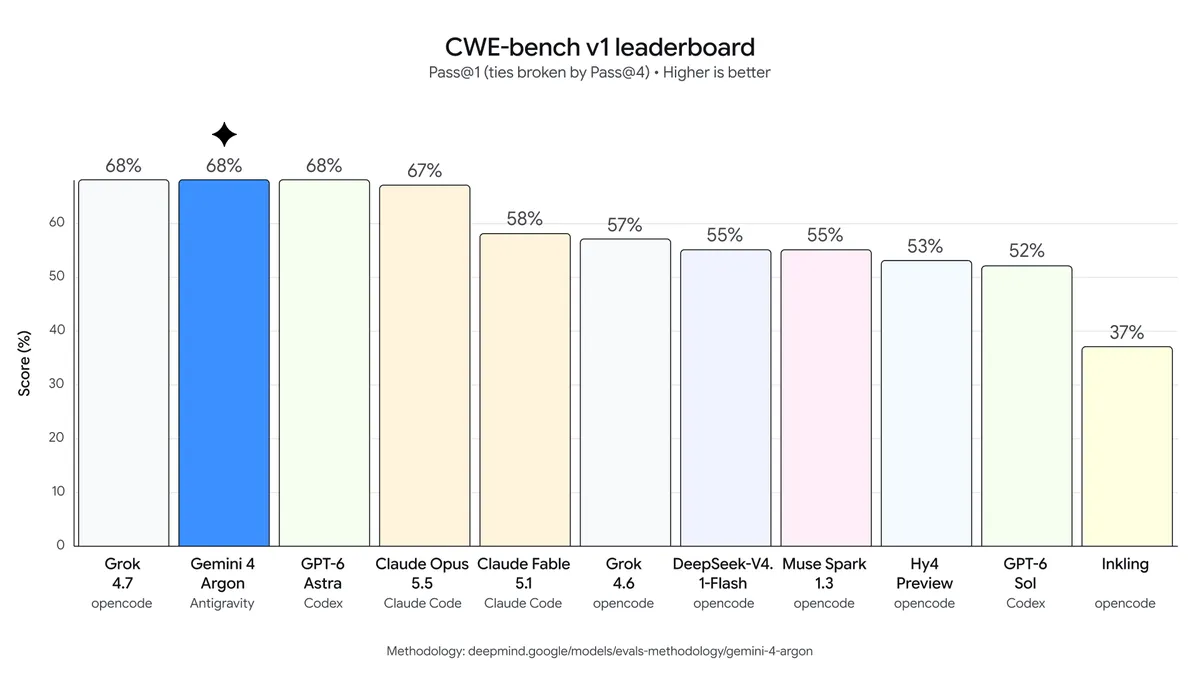
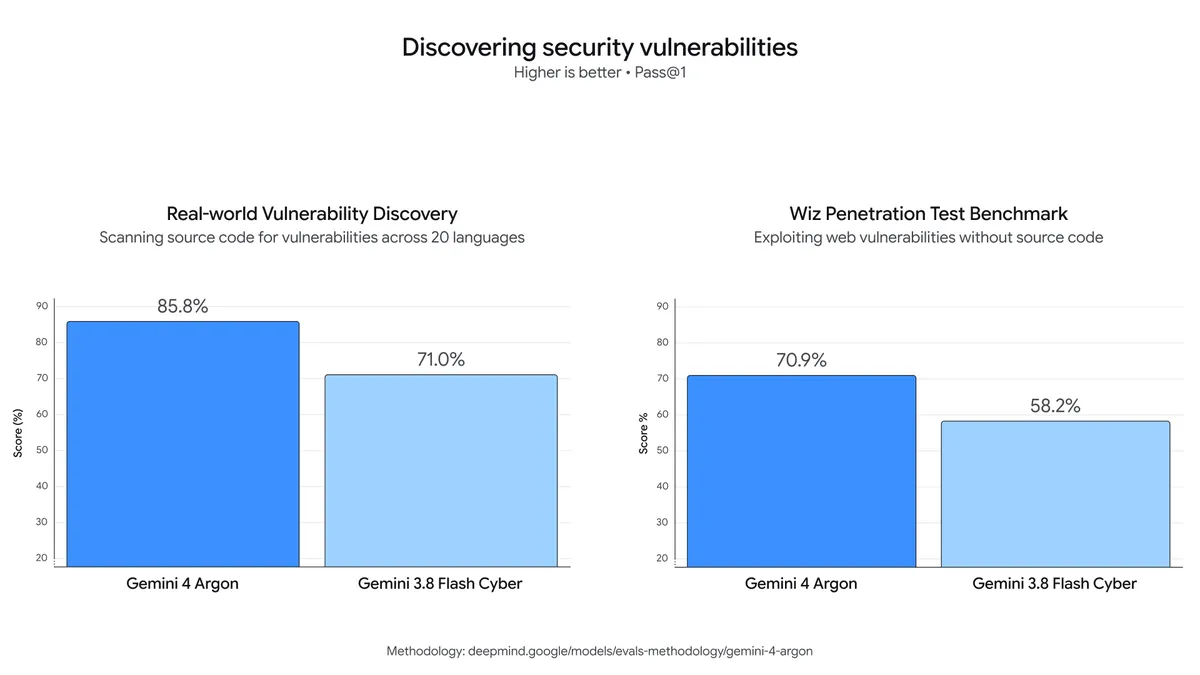
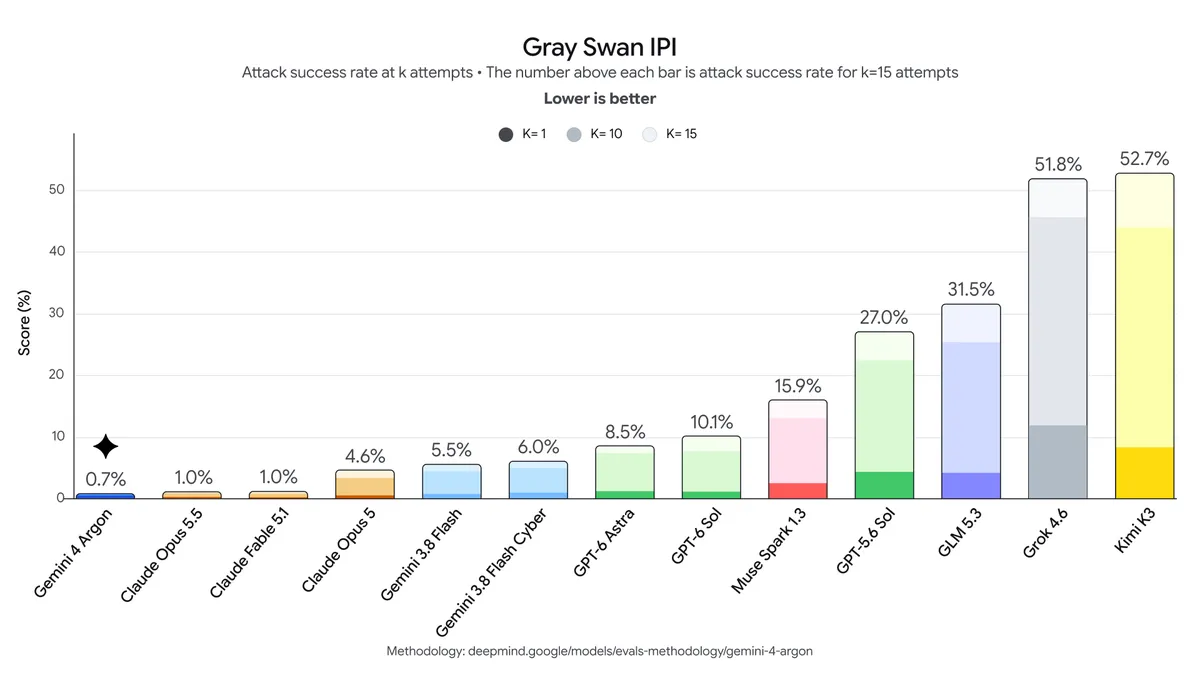
Detalhes do CWE-bench valem destaque: 68,0% pass@1 empata com GPT-6 Astra, e Grok 4.7 também marca 68,0% segundo o índice independente da Vals. Ou seja, Argon lidera junto com dois modelos de laboratórios completamente diferentes. O real concorrente em cyber agora é o próprio ecossistema.
Safeguards e o rollout
A Google enfatiza que Argon passou por red teaming interno e externo com métodos manuais e automatizados, e está implantando:
- Monitoramento de activations internas do modelo para detectar misuse (algo que apareceu no report técnico do Gemini 2.5 Pro e que agora está expandido para cyber e CBRN).
- Defesa contra prompt injection indireta, com testes via Gray Swan IPI benchmark (onde lidera).
- Mitigação de misalignment, monitorando o chain-of-thought e as ações do Argon durante a execução e parando quando ele tenta sair do escopo.
- Sandbox hardening: isolamento dos ambientes de avaliação de alto risco, alinhado com o agent control roadmap.
A Google também encorajou a indústria a preservar transparência de raciocínio (“model thoughts remain helpful in identifying and diagnosing misalignment”). Isso é jab direto contra fornecedores que escondem CoT por motivos de IP.
Custos por tarefa: a comparação que importa
O preço por token é marketing. O que importa é preço por tarefa completa. Aqui a conta muda bastante, e tem um gráfico independente da Vals que vale reproduzir:
| Modelo | Vals Index score | Custo por teste (Vals) | Base |
|---|---|---|---|
| Gemini 4 Argon | 68,90% | $15,68 | Taxas $4/$20 (pós-promo) |
| Claude Sonnet 5.5 (max) | 67,04% | $21,34 | Com fallback |
| Claude Opus 5.5 (max) | 66,97% | $32,14 | Com fallback |
| Claude Fable 5.1 | 65,83% | $28,71 | Com fallback |
| GPT-6 Astra | 63,13% | $18,46 | Suite Vals |
| GPT-6.1 Sol | 61,15% | $3,24 | Suite Vals |
O detalhe importante: o custo por teste do Argon foi calculado pela Vals usando a tarifa pós-promo ($4 input / $20 output). Na tarifa intro, esse número cai para cerca de $7,84, metade do Astra. Mas mesmo no pior cenário (tarifa cheia), Argon é 15% mais barato que Astra no mesmo nível de inteligência.
E pela Artificial Analysis: $1,99 por tarefa do Intelligence Index no período promocional, 60% do Astra. Quando a promoção acabar, vai pra $3,98, 1,2x Astra. Para chamadas com cache hit, a economia é brutal: cache a $0,10 / 1M de tokens é praticamente de graça.
O que isso significa (opinião)
- A Google voltou pro jogo de verdade. Depois de 7 meses só com Flash e um Pro Preview capenga, Argon coloca a Google empatada com OpenAI em Intelligence Index bruto e acima em knowledge work (Vals Index), long-context reasoning e defensiva cyber. A defasagem de 17 pontos do 3.1 Pro Preview era vexame. Os 23 pontos de salto em uma geração são correção agressiva de rota.
- O ângulo de cyber é sério. Argon não é só mais um modelo com CWE-bench alto. É o primeiro modelo lançado pela Google sem guardrails de cyber para trusted defenders, integrado com Wiz/Red Agent, com case público em saúde. A Wiz pagou $32 bi pra Google e já está mostrando ROI. Para CISOs, isso importa mais do que mais um benchmark de coding.
- Knowledge work é o novo campo de batalha. O salto em Harvey’s Legal Agent Benchmark (19,6% vs. 5,4% do Astra, 3,6x) e Vals Index sugere que Argon é o melhor modelo atual para trabalho jurídico e financeiro de fato, não de demo. Para um modelo que custa metade do Opus, é argumento de venda fortíssimo em firmas de advocacia, fundos e consultorias.
- Os números de coding são mais mistos do que o marketing diz. Argon lidera DeepSWE e Vibe Code Bench, mas perde feio em FrontierSWE v2, Terminal-Bench 4.0 e Terminal-Bench Science 0.1. Quem escolher modelo só por “DeepSWE = coding champion” vai ter surpresa. Em coding agentic sério, Opus 5.5 e GPT-6 Astra ainda são apostas mais seguras para casos específicos.
- O teto de 1M output muda workflows, mas com asterisco. A Google não documentou se isso é teto duro da API ou se vira cobrança diferenciada acima de certo threshold. O detalhe de o Google não ter publicado a API ID pública no anúncio sugere que o contrato de produção ainda está sendo finalizado. Esperar para workflows críticos.
- O Independent Verification está vindo. A Artificial Analysis já marcou 53 (empate com Astra). Vals marcou 68,9% no Index. Falta LMArena/Chatbot Arena, que não conseguiu testar porque Argon não está acessível. Quando sair, vai ser interessante ver se a vitória em knowledge work se sustenta em preferência humana.
- A promoção acaba (e ninguém sabe quando). Google não disse data. Comparando com Gemini 3.8 Flash (intro até 31/12/2026), o padrão é promoção de ~3 meses. Quem quiser economia de 50%, melhor não dormir.
- O caso libgav1 é a melhor propaganda. Reescrever 32K linhas de SIMD crítico e ainda melhorar 2,7x é o tipo de coisa que engenheiro de kernel veterano faz em semanas. Argon fez em “rodadas de experimentos profile-guided”. É sinal de que, pelo menos em tarefas onde há telemetria rica, o modelo está genuinamente útil para otimização agressiva.
Linha do tempo e referências
- Anúncio oficial (Google blog): blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- Fairwind Program (DeepMind): deepmind.google/fairwind-program/
- Wiz Scan for Good: wiz.io/blog/scan-for-good-critical-ai-exposures
- Vals AI (live card): vals.ai/models/google_gemini-4-argon
- Artificial Analysis: artificialanalysis.ai/leaderboards/models
- Kingy.ai spec deep-dive: kingy.ai/blog/gemini-4-argon-specs-benchmarks-pricing/
- Análise do Gemini 3.8 Flash e Flash Cyber (base de comparação): blog.google/innovation-and-ai/models-and-research/gemini-models/3-8-flash-and-3-8-flash-cyber/
Quando a API pública abrir, volta aqui. Vou rodar Argon em DeepSWE, Vibe Code Bench, FrontierSWE e Terminal-Bench com a minha suíte e publicar resultados de verdade, não print de tabela oficial. Se a API ID for confirmada até lá, vai no próximo post.
Aviso metodológico: todos os benchmarks comparativos acima são da tabela oficial publicada pela Google DeepMind em 30/09/2026, exceto onde explicitamente como Vals ou Artificial Analysis. A Google usou reasoning “max” para Argon e configurações equivalentes para rivais, mas detalhes de harness variam por benchmark. Resultados em produção podem divergir.