
Qwen-Image 2.1: o modelo open-weight que gera transparência nativa, edita até 10 imagens de uma vez e roda na sua GPU
22 de setembro de 2026. O time Qwen da Alibaba acaba de lançar o Qwen-Image 2.1, um modelo de geração e edição de imagens open-weight que faz algo que nenhum outro modelo aberto faz: gera canal alpha de verdade. Quatro canais, RGBA, saída pronta pra composição, sem nó de remoção de fundo, sem modelo de matting, sem limpeza de borda.
E ele já roda nativo no ComfyUI.
O modelo tem só 7 bilhões de parâmetros no componente visual (32 camadas Single-Stream DiT), cabe em GPU de consumidor, gera em 2K nativo (2048×2048) e aceita até 10 imagens de referência numa única inference. Um checkpoint só faz geração e edição.
O que torna esse modelo diferente
Não é mais um modelo de imagem. O Qwen-Image 2.1 ataca três pontos onde a competição open-source ainda apanha:
1. Transparência nativa (RGBA)
Isso é o verdadeiro diferencial. O VAE do modelo é um autoencoder RGBA de 64 canais com compressão espacial 16×. Ele gera o canal alpha junto com o RGB: sprites, logos, ícones, cutouts de produto saem do sampler prontos pra composição. Nenhum outro modelo aberto relevante faz isso. O prompt é ridiculamente simples:
This is an RGBA image with transparency. A cute cartoon dragon sticker.
The image has alpha channel and the background is transparent.
E você recebe um PNG com alpha de verdade, não uma imagem com fundo branco que parece ter alpha.
2. Edição com até 10 imagens de referência
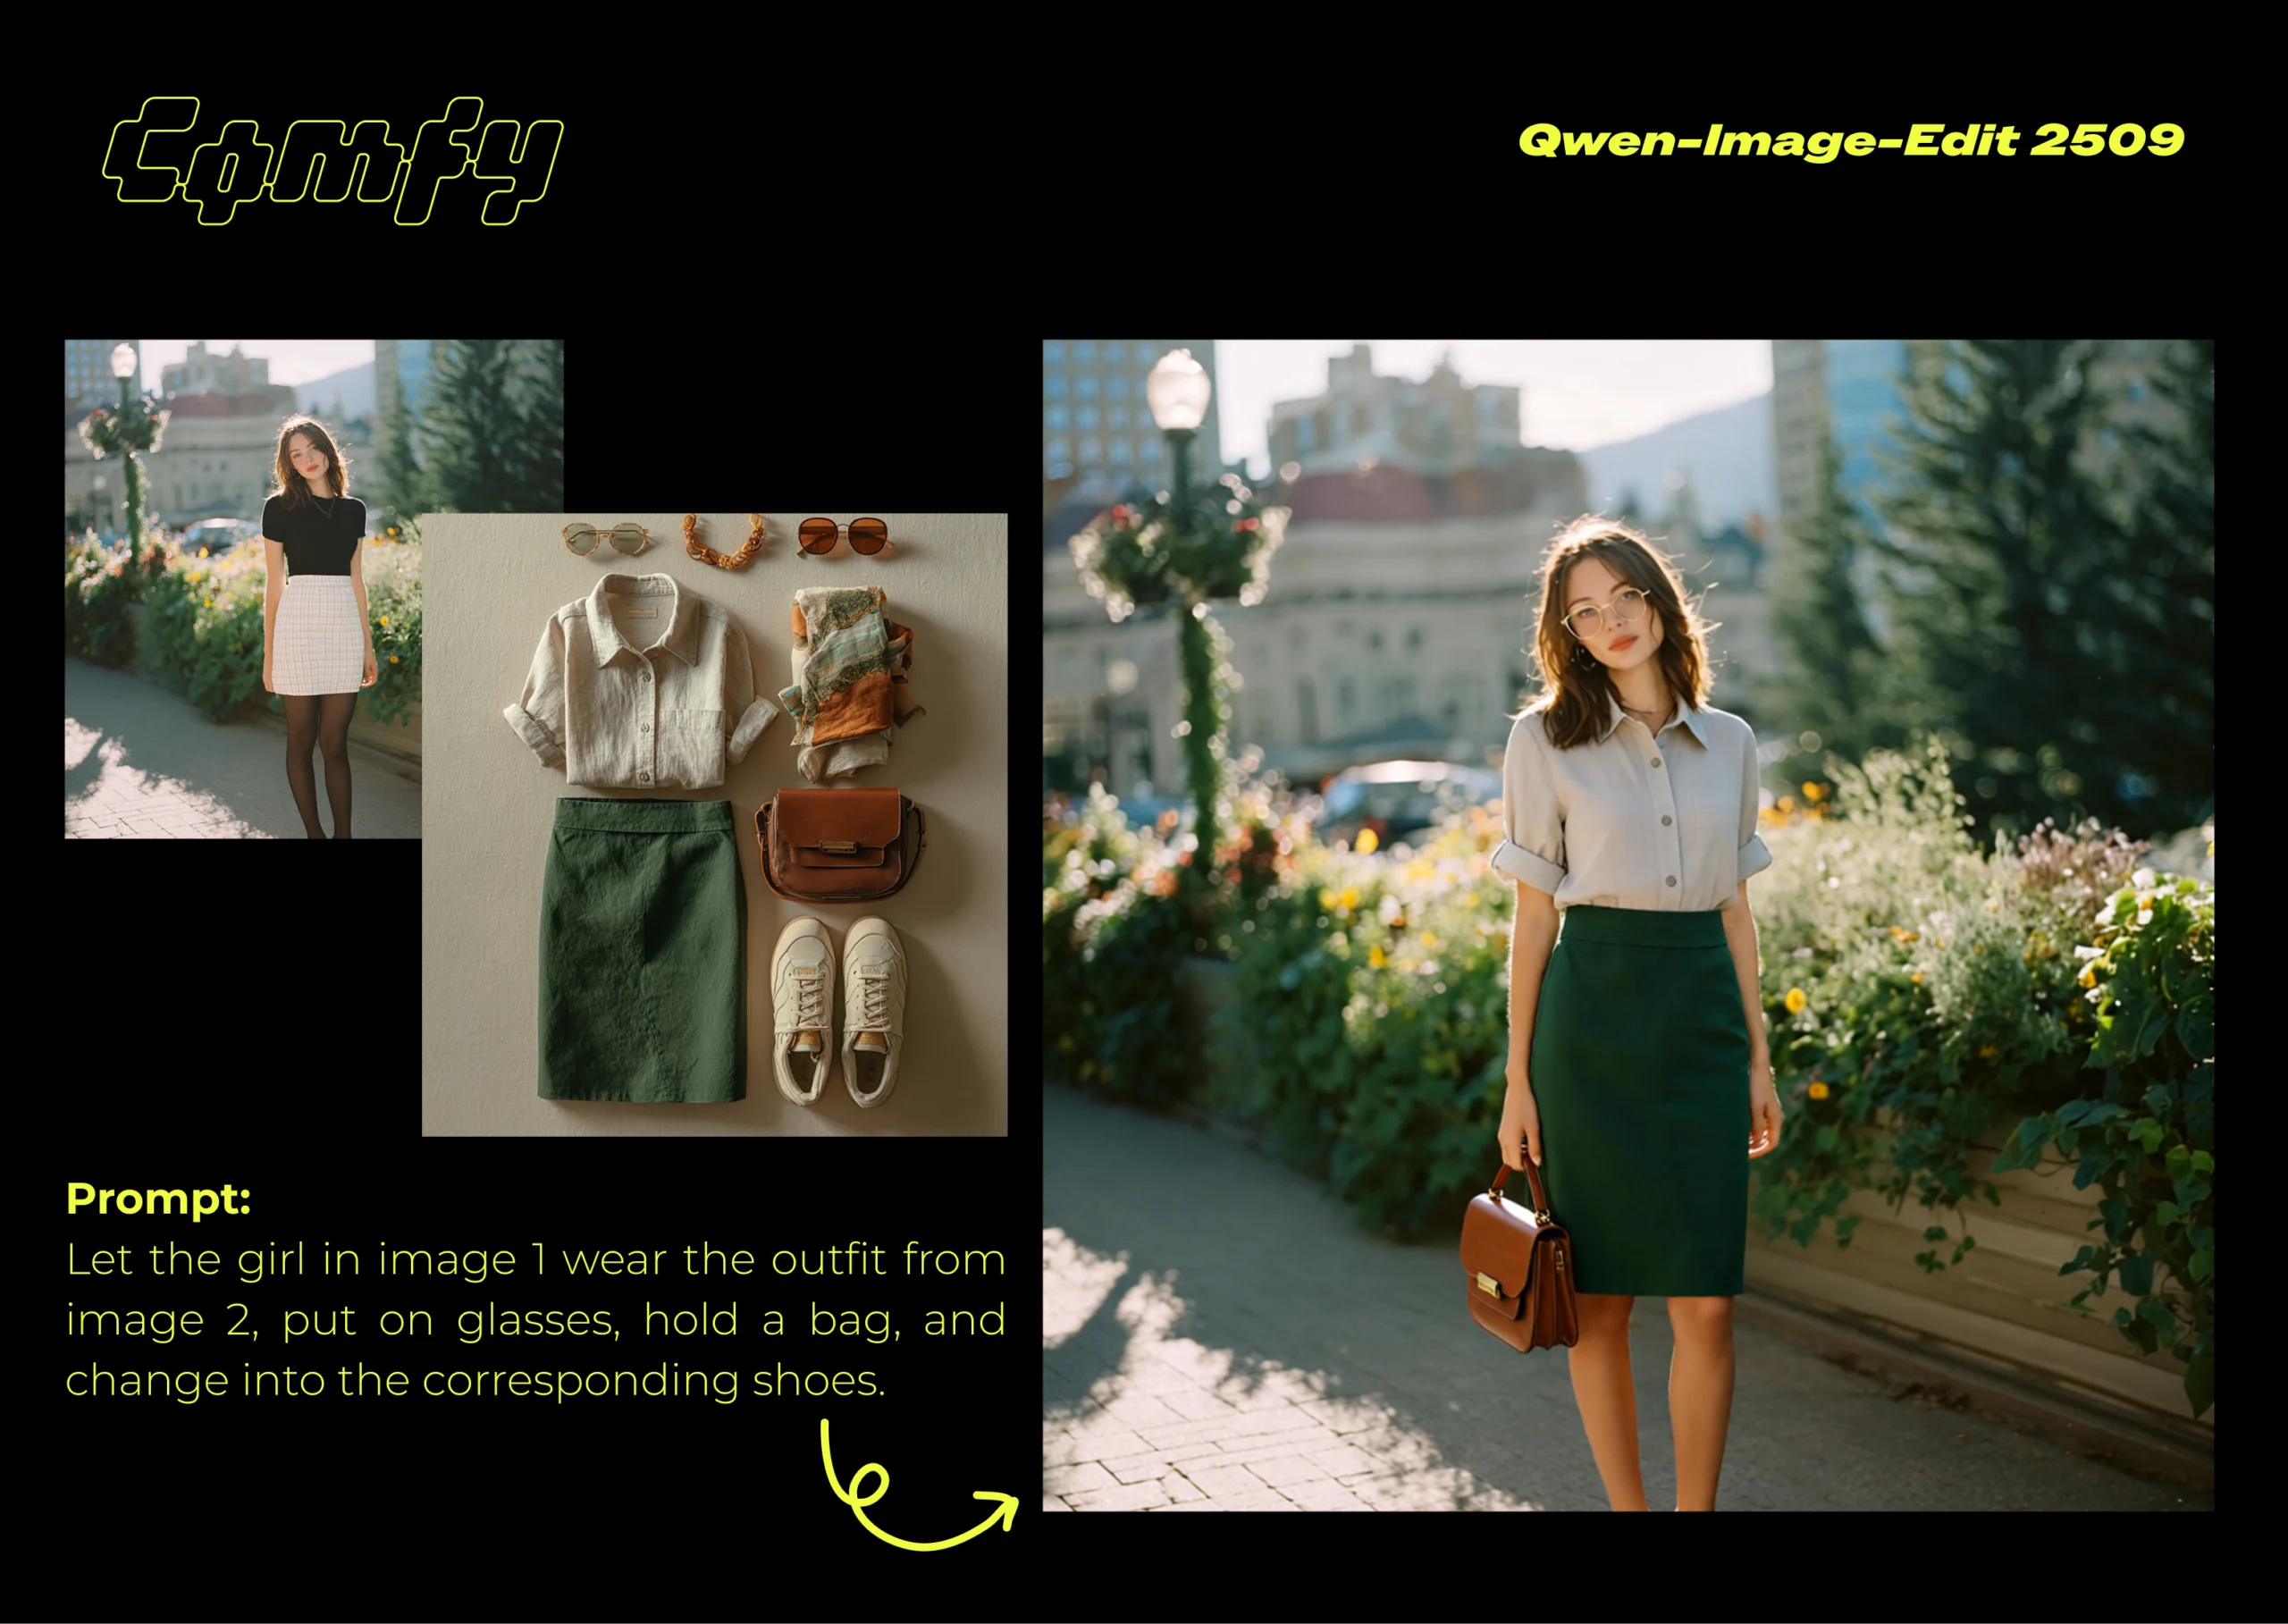
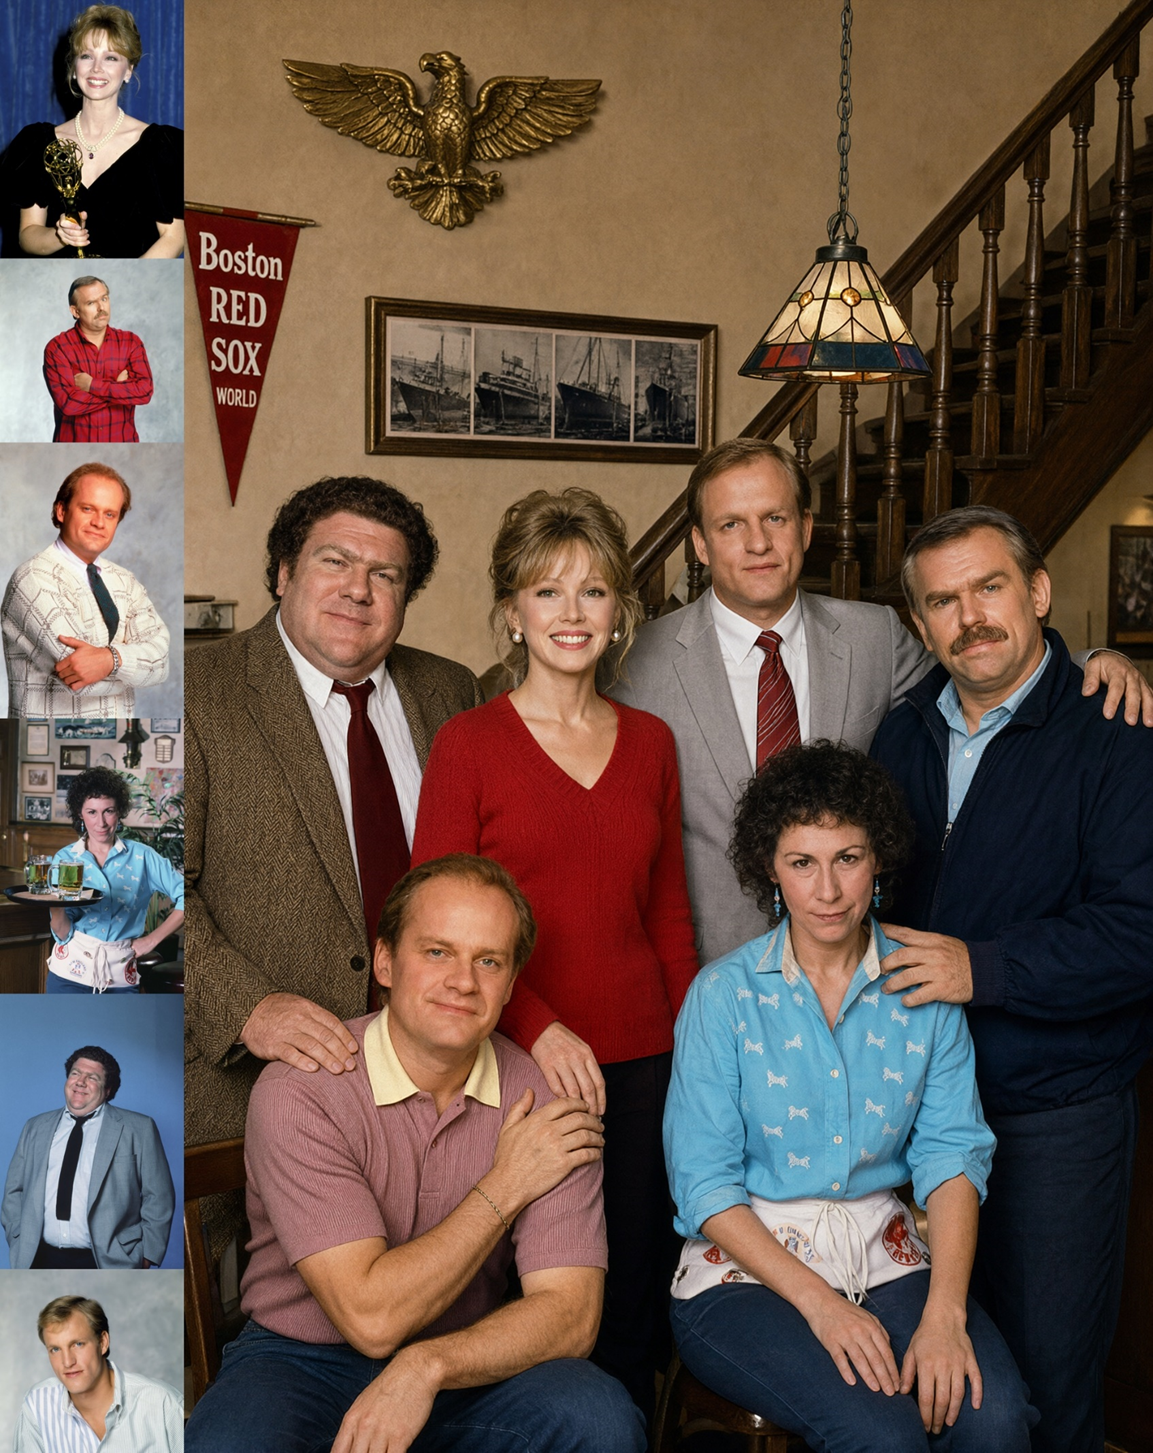
O nó Text Encode Qwen Image 2.1 no ComfyUI vai abrindo inputs de imagem conforme você preenche, até 10. Personagem, produto, placa de fundo, referência de estilo, tudo é lido pelo text encoder (um Qwen3-VL 8B) e injetado na sequência como latents do VAE.
Dá pra fazer group photo com 6 retratos individuais, outfit completo com 5 referências (modelo, roupa, sapato, bolsa, chapéu), ou preservar identidade de pessoa e produto com precisão.
3. Edição local com círculos e máscaras
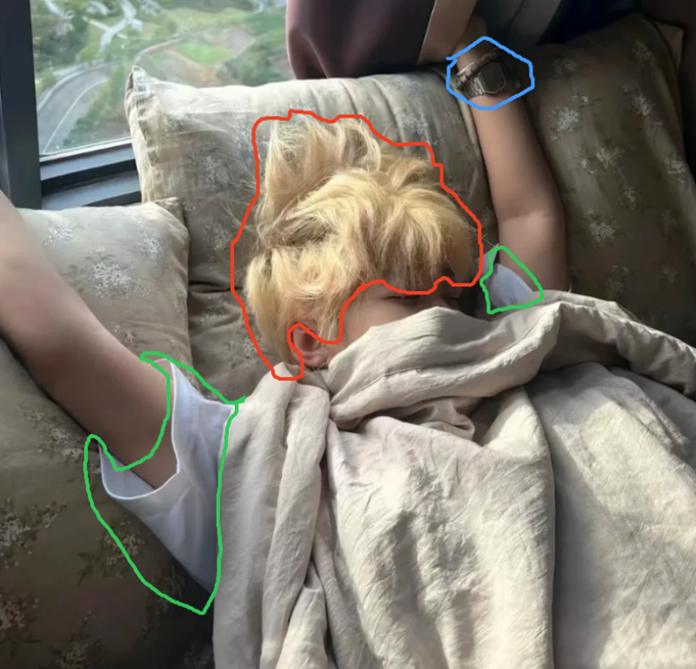
Você desenha círculos na imagem, passa anotações pintadas ou máscaras separadas, e o modelo edita só aquela região. Remove relógio, muda cor de cabelo, troca roupa, tudo na mesma passada, sem regenerar a imagem inteira.
Arquitetura: Single-Stream DiT com prefix KV cache
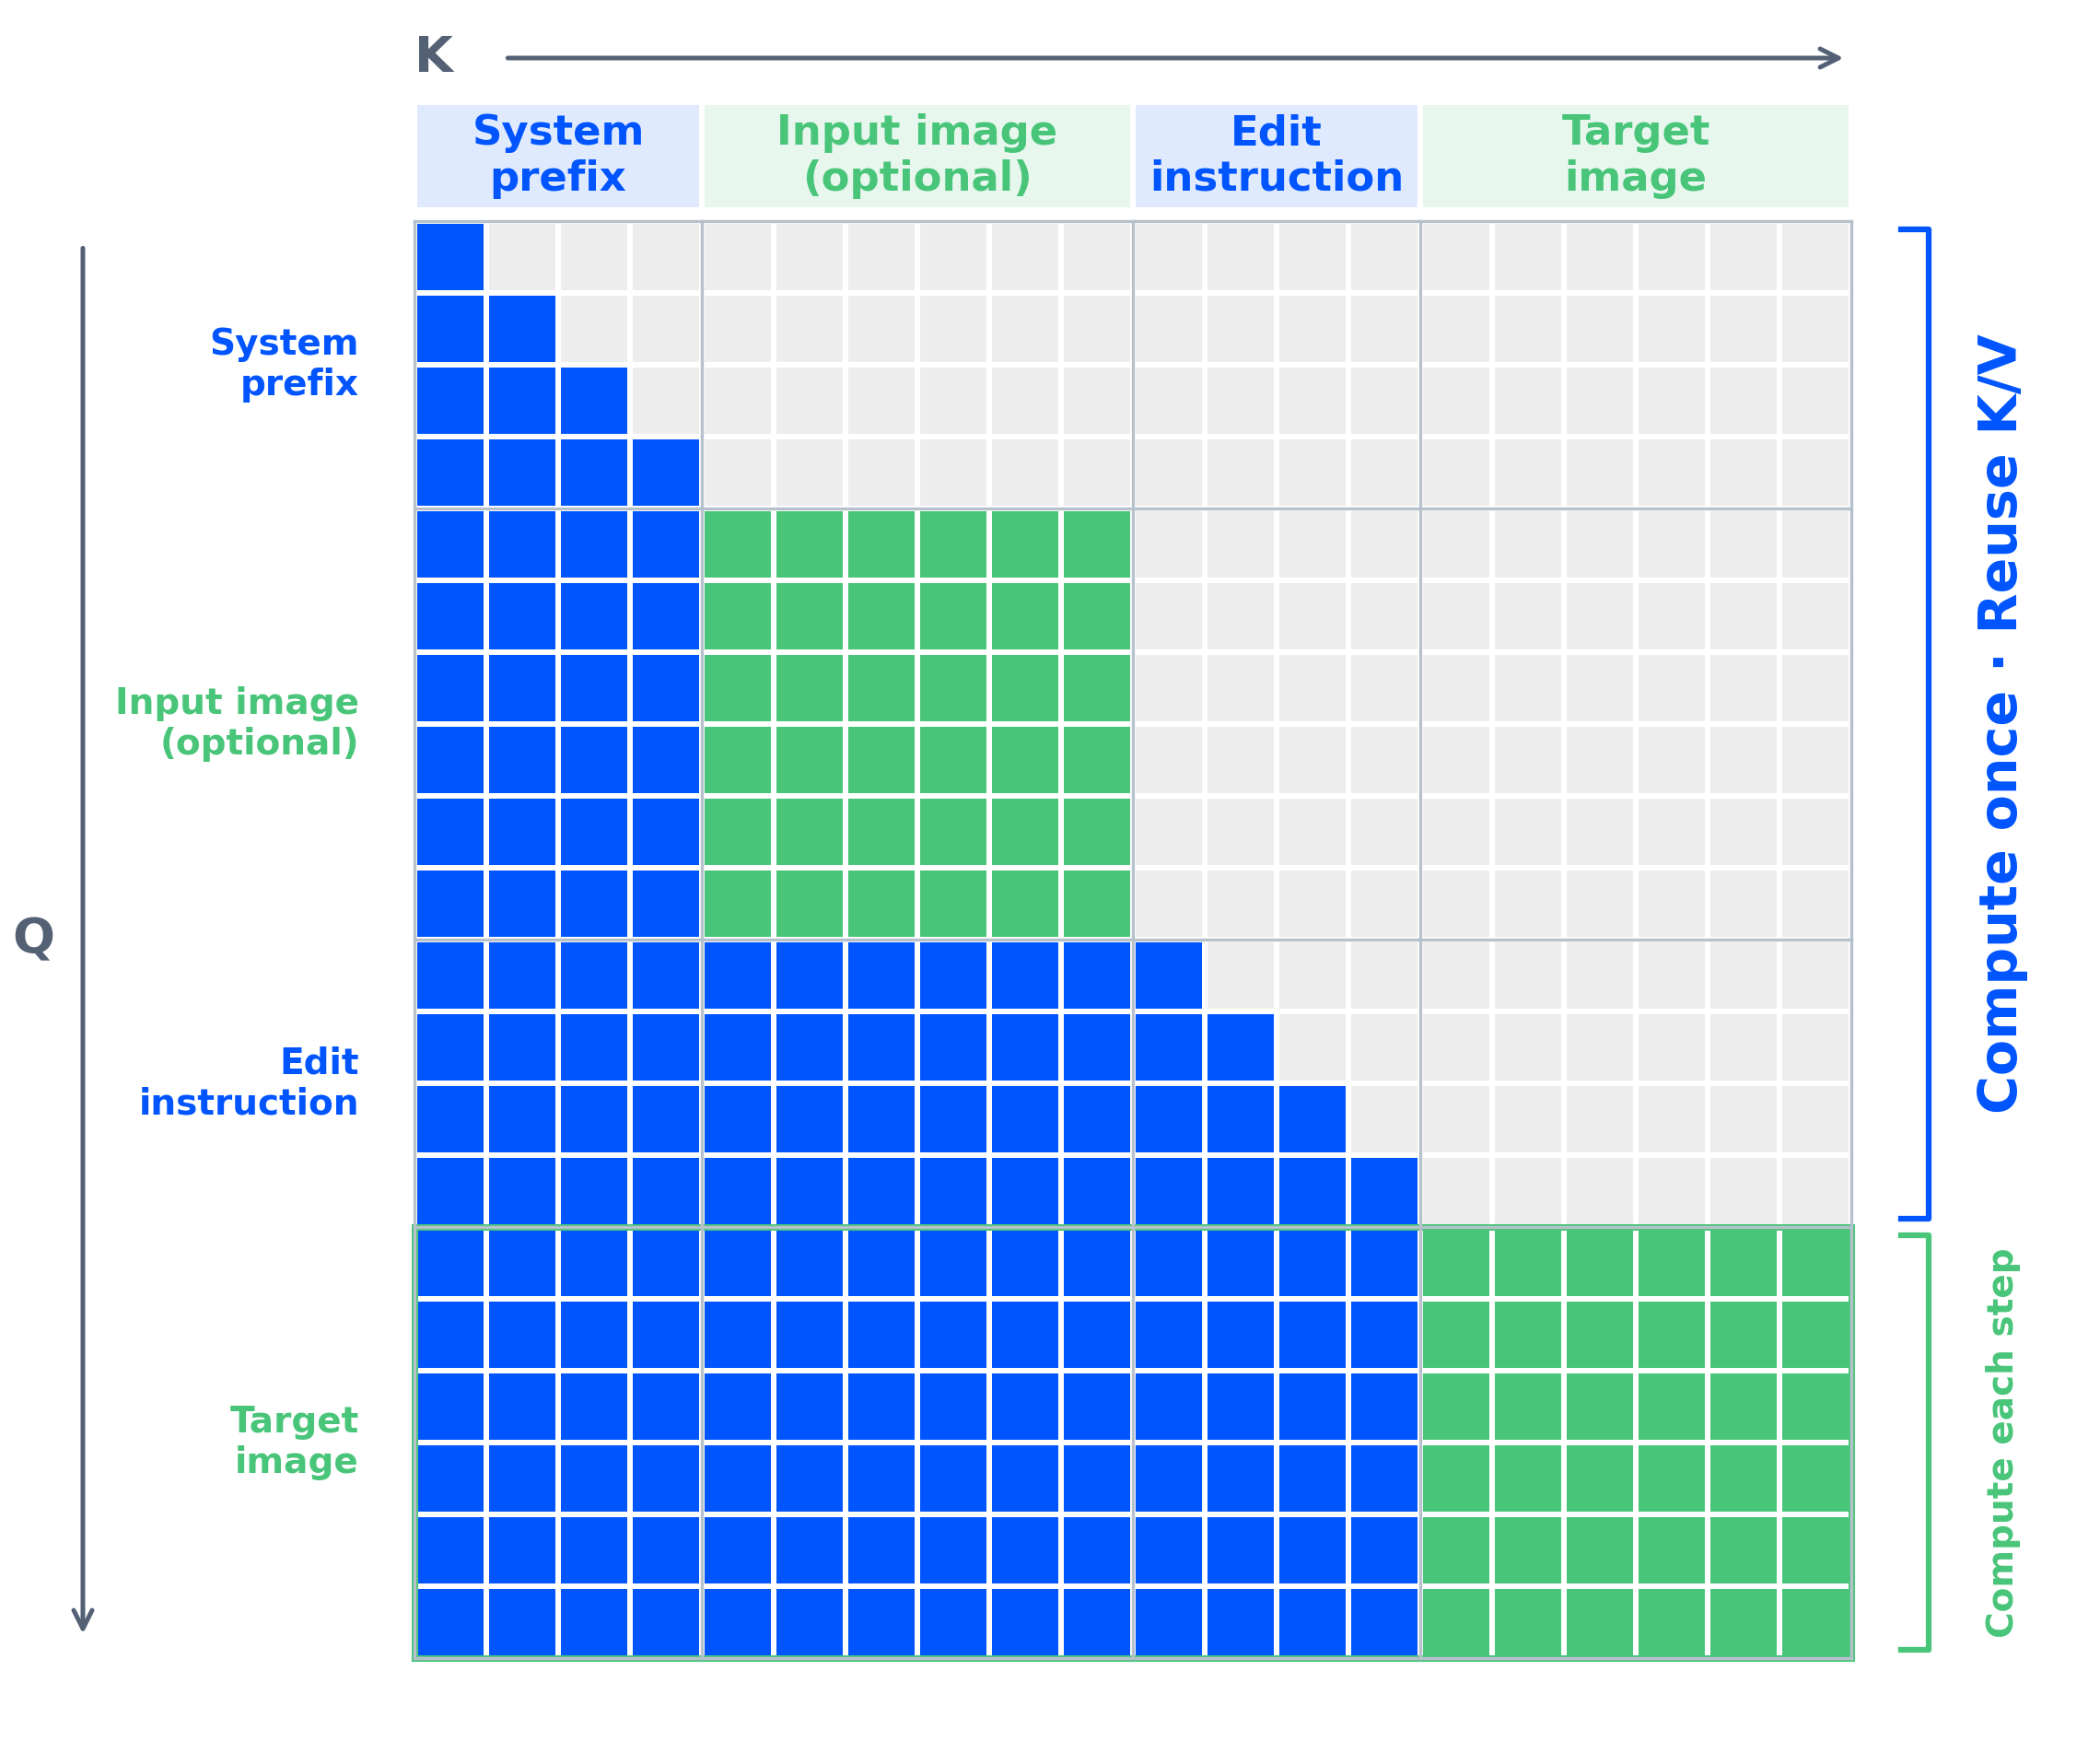
O Qwen-Image 2.1 usa uma arquitetura single-stream DiT (Diffusion Transformer) com atenção block-causal. A ideia é simples e eficiente:
- Transformer: 32 camadas, 7B parâmetros, single-stream com block-causal attention
- Text Encoder: Qwen3-VL 8B, um vision-language model que codifica tanto texto quanto imagens de condição numa representação unificada
- VAE: 64 canais RGBA, compressão 16×
- Scheduler: Flow Matching com Euler discrete e dynamic shifting
O truque de performance está na atenção mixed-granularity: texto usa máscara causal token-level, imagens usam máscara bidirecional chunk-level. Isso permite prefix KV cache reuse: as imagens de entrada e instruções de texto são computadas uma vez no primeiro passo de denoising e cacheadas pra todos os passos seguintes. Em edição com múltiplas imagens de condição, isso dá um speedup significativo.
Showcase: o que esse modelo entrega na prática
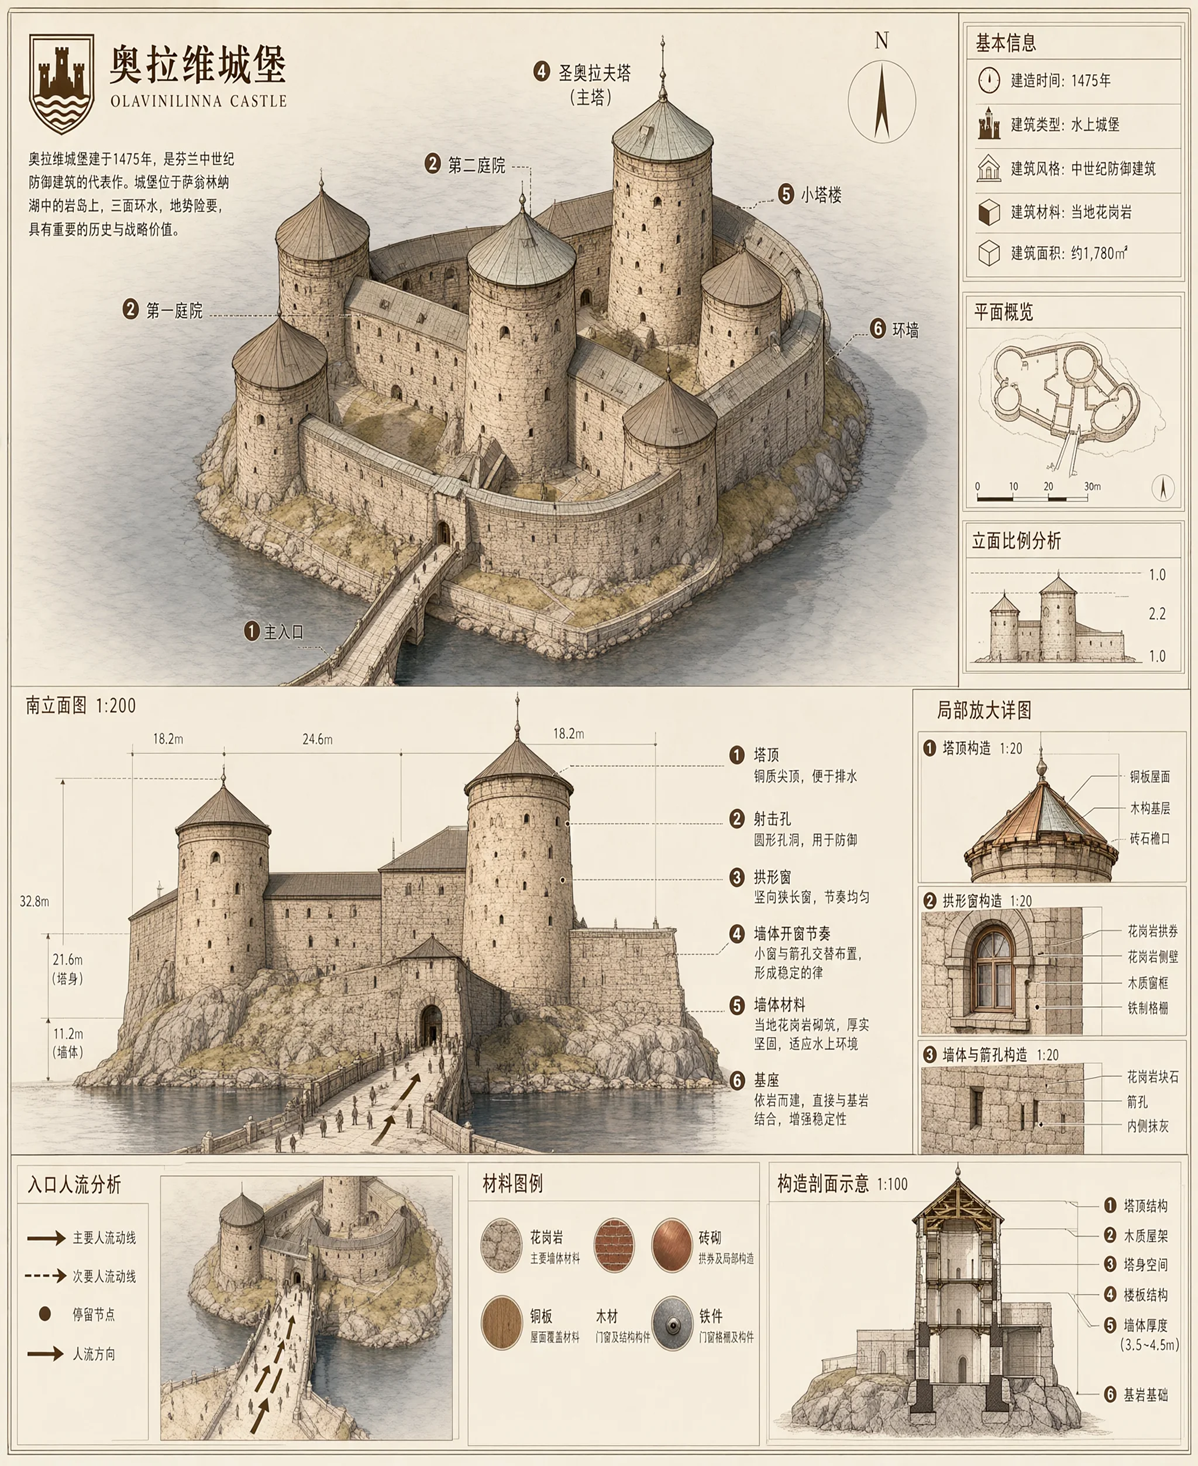
Renderização de texto
Tipografia sempre foi o calcanhar de Aquiles de modelos de imagem. O Qwen-Image 2.1 acerta texto longo, fontes variadas e integração com a cena:
Fidelidade de retrato e produto
Identidade preservada mesmo em reenquadramentos agressivos:


Panorama e storyboard
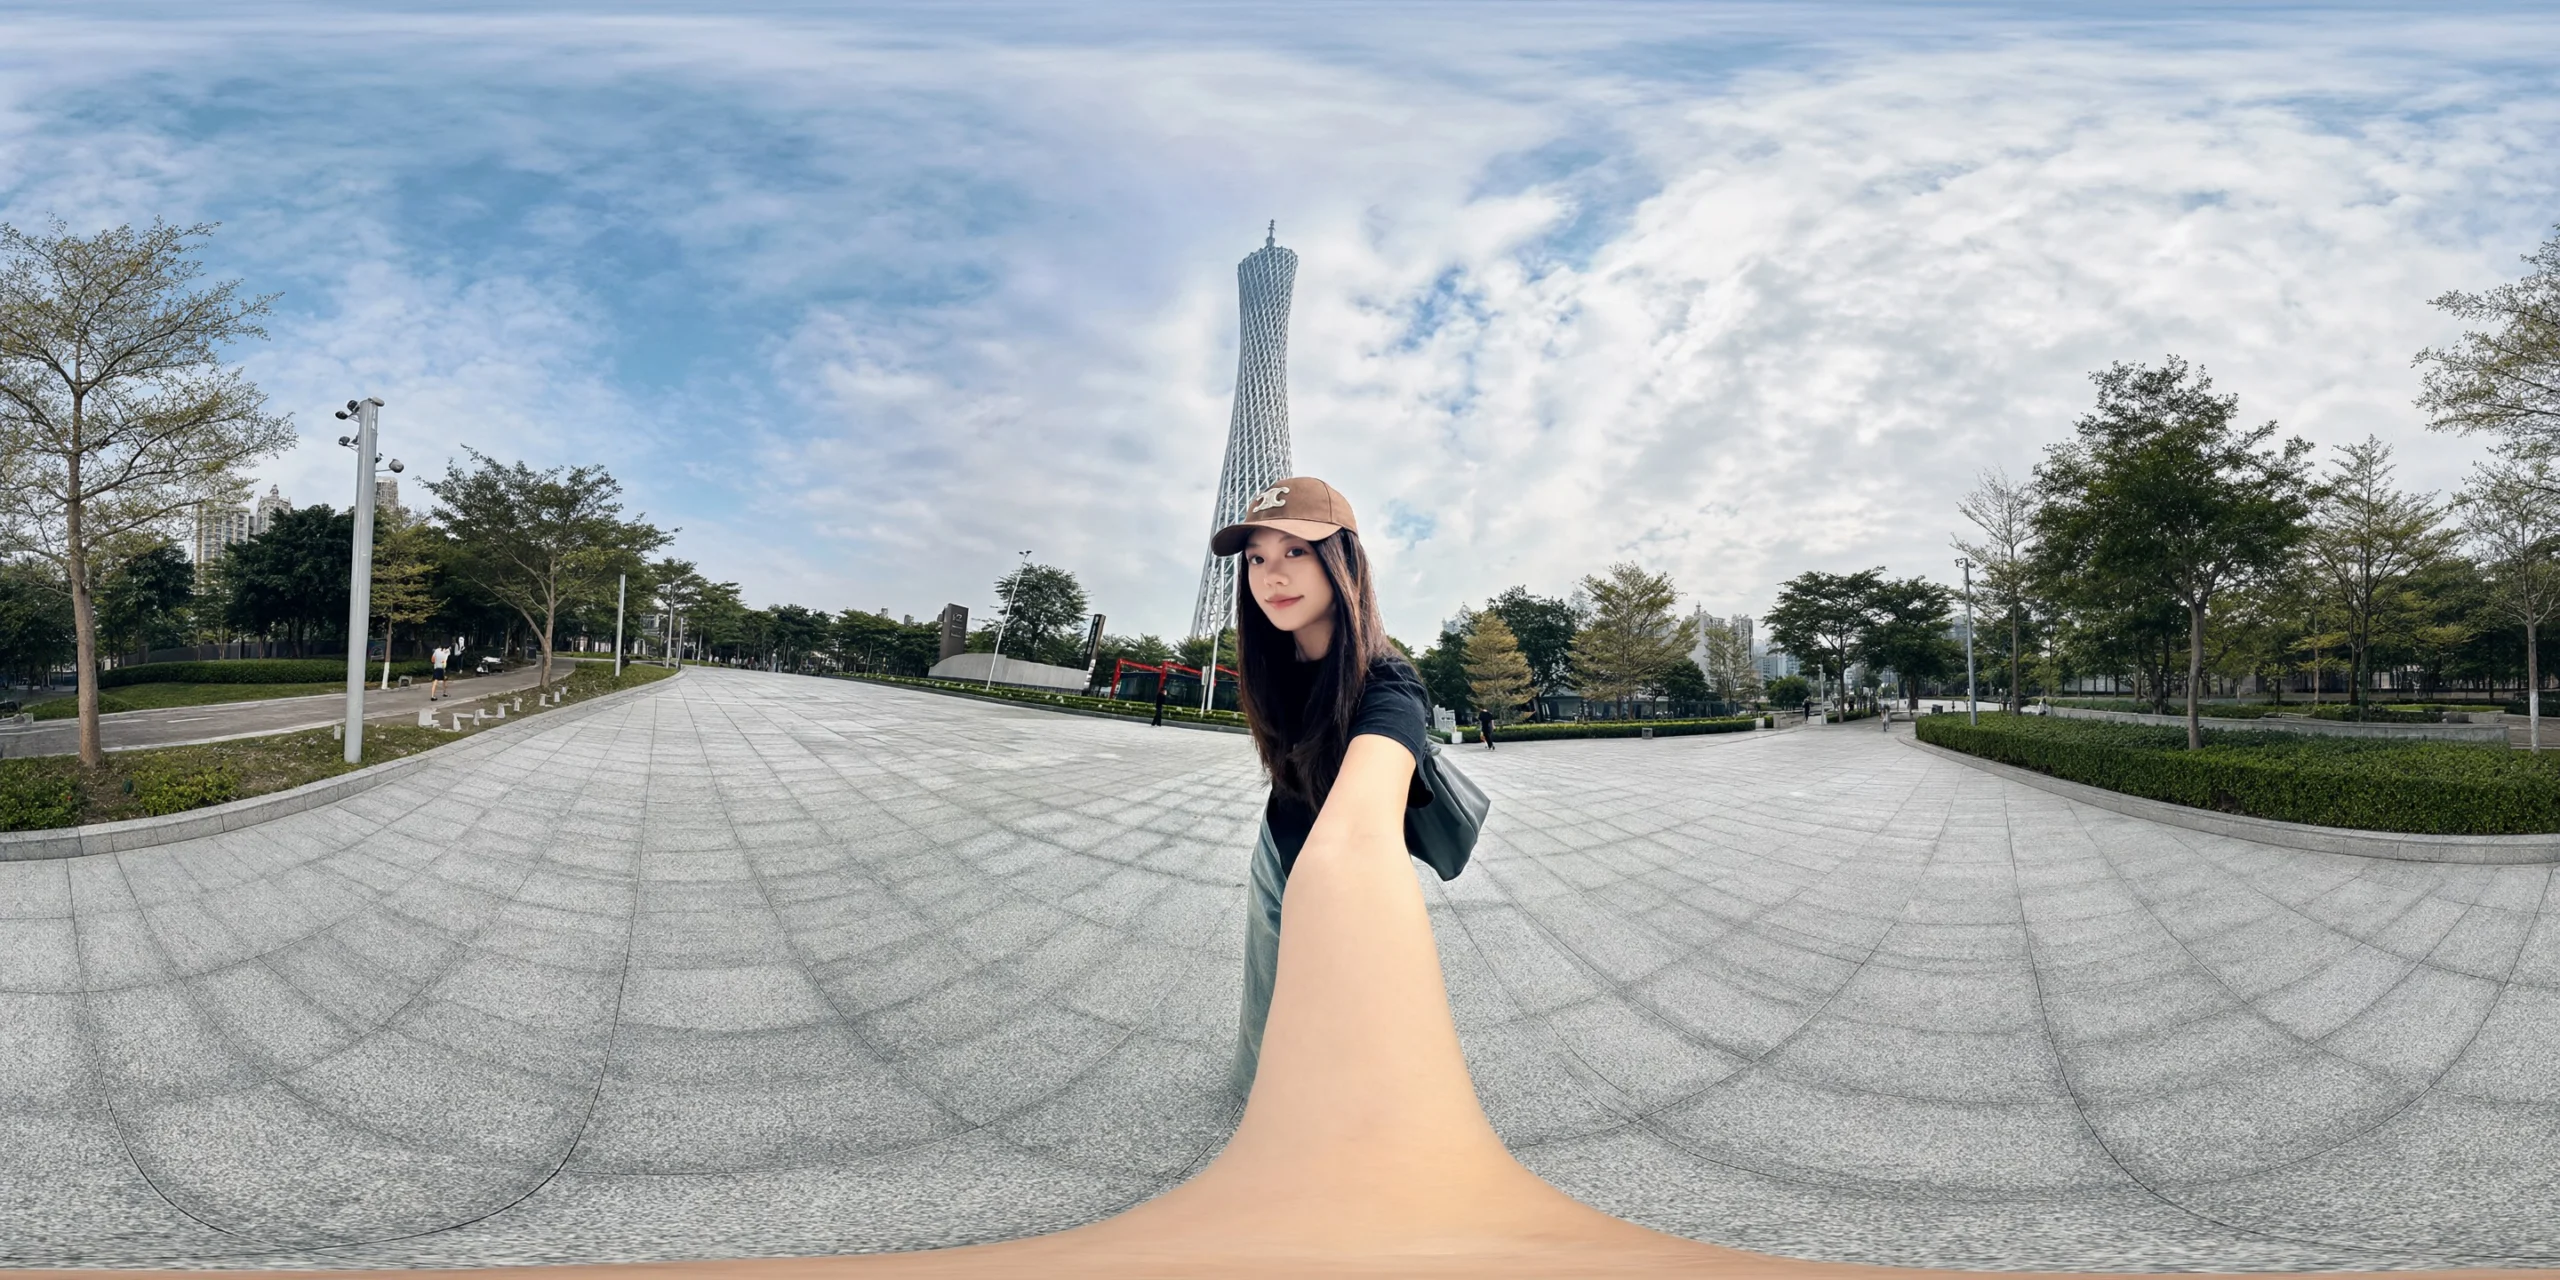
Dá pra gerar panorama a partir de uma selfie ou storyboard com três ângulos de personagem:
Inference: roda em tudo que você imagina
O lançamento veio com suporte Day 0 em praticamente todos os engines relevantes:
| Engine | Detalhes |
|---|---|
| Diffusers | QwenImage21Pipeline, texto e edição no mesmo pipeline |
| ComfyUI | Suporte nativo, templates T2I e image edit, weights em Comfy-Org |
| vLLM-Omni | Prefix KV caching, CUDA Graph decode, FP8 quantization, TP/Ulysses parallelism |
| SGLang | Prefix caching, Cache-DiT, CUDA graphs, multi-GPU, component offload |
| LightX2V | Aceleração otimizada pra GPUs consumer e datacenter |
Exemplo rápido com Diffusers
from diffusers import QwenImage21Pipeline
import torch

pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1", torch_dtype=torch.bfloat16
).to("cuda")

image = pipe(
    prompt='A neon shop sign that reads "QWEN IMAGE 2.1", rainy night',
    num_inference_steps=40,
    generator=torch.Generator("cuda").manual_seed(42),
).images[0]
Memory optimization pra GPUs menores
pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1", torch_dtype=torch.bfloat16
)
pipe.enable_model_cpu_offload()
Edição com múltiplas referências
images = [Image.open(f"ref_{i}.png") for i in range(3)]

result = pipe(
    prompt="These three characters are sitting around a campfire",
    image=images,
    num_inference_steps=40,
).images[0]
Prompt Rewriting: o truque que o Qwen recomenda
Pra extrair o máximo do modelo, o time disponibilizou dois checkpoints de reescrita de prompt baseados no Qwen3.5-VL 9B, um pra T2I e um pra edição:
O rewriter expande prompts curtos em descrições detalhadas e até escolhe o aspect ratio ideal. Roda com vLLM em batch ou transformers local:
python run_vllm.py --task t2i \
    --ckpt Qwen/Qwen-Image-2.1-PE-T2I \
    --input data/t2i_example.jsonl --output out.jsonl
Hardware: não é só NVIDIA
AMD Radeon entra no jogo com ROCm + PyTorch + Diffusers. E via FlagOS, o modelo roda em 8 plataformas de chip diferentes com precisão alinhada à implementação oficial e zero mudança de código.
Licença e pesos
- Licença: Qwen Research License (não é Apache 2.0, leia as letras miúdas)
- Pesos no HuggingFace: Qwen/Qwen-Image-2.1
- Pesos compatíveis com ComfyUI: Comfy-Org/Qwen-Image-2.1
- Demo: HuggingFace Space
- Workflows ComfyUI: T2I e Image Edit
O que isso significa
- RGBA nativo muda o jogo pra criadores de conteúdo. Spritesheets, logos, overlays, UI elements, product mockups, tudo que precisa de transparência não depende mais de pipeline separado de background removal. É um passo a menos, uma ferramenta a menos, um modelo a menos.
- Edição multi-imagem com preservação de identidade é o santo graal que estava faltando. 10 imagens de referência numa passada só, com o text encoder entendendo a relação entre elas. Isso não é “inpaint numa região”, é composição semântica. A diferença é brutal pra moda, produto e personagens.
- 7B parâmetros é o sweet spot. Cabe em 16 GB VRAM com offload, gera rápido, não precisa de datacenter. É o tamanho certo pra adoção em massa por criadores independentes.
- O ecossistema Qwen está se tornando um dos mais coesos. O time lança com Day 0 support em Diffusers, ComfyUI, vLLM, SGLang, LightX2V, mais rewriters especializados, mais suporte multi-chip. Não é só “toma os pesos e se vira”, é um ecossistema pensado.
- A competição em imagem open-source esquentou de vez. O Qwen-Image 2.0 de fevereiro já era bom. Esse 2.1 adiciona features que modelos fechados cobram caro pra entregar (transparência, edição multi-referência). E é de graça.
- Falta benchmark quantitativo. O release não inclui tabelas de comparação numérica (ELO, preference rate, FID). Os showcases são impressionantes, mas avaliação qualitativa sem números é propaganda. Quero ver Artificial Analysis ou independentes metendo esse modelo contra Flux Pro, SD3.5 e Ideogram nos benchmarks padrão.
Modelo: Qwen-Image-2.1
Parâmetros: 7B (componente visual), Qwen3-VL 8B (text encoder)
Resolução nativa: 2048×2048, aspect ratios até 16:9
Preço: Gratuito (open-weight, Qwen Research License)
Links: Blog oficial · HuggingFace · Demo · ComfyUI weights