
A Alibaba lançou o Qwen4-Max nesta segunda-feira, 16 de novembro, cinco dias depois da prévia que eu cobri na quinta. É o modelo mais capaz da família Qwen até agora, com 2,4 trilhões de parâmetros, visão nativa e janela de 1 milhão de tokens. E ele chega com uma news que muda a leitura do mercado: mais barato que o modelo que ele substitui.
Os preços na tabela internacional do QwenCloud caem de US$ 2,00 para US$ 1,50 por milhão de tokens de entrada e de US$ 6,00 para US$ 4,50 na saída. A leitura de cache despenca de US$ 0,25 para US$ 0,075. Uma geração mais nova custando menos que a anterior é raro o bastante para ser o eixo do anúncio, e é o que a Alibaba emphasises no benchmark Work360, onde o custo médio por tarefa desce de US$ 4,43 para US$ 1,67.
Mas a mesma release que traz o preço para baixo mantém os pesos fechados. Depois de abrir o Qwen3.8-2.4T-A95B sob licença própria em agosto, a Alibaba voltou a fechar a flagship. A promessa é de que modelos menores da família Qwen4 virão abertos, sem data. Vamos aos números, porque o gráfico de lançamento é misto e vale ler com atenção.
Os gráficos de lançamento da Alibaba são compilados pelo próprio fabricante, e alguns números citados vêm de leaderboards de terceiros sem reprodução independente. A leitura honesta é: o Qwen4-Max ganha de verdade em trabalho agentivo de longo horizonte e em trabalho jurídico, e perde de verdade em terminal e em replicação de software.
O que o modelo é
| Parâmetro | Valor |
|---|---|
| Model ID | qwen4-max |
| Arquitetura | MoE esparso, nova arquitetura Qwen4 |
| Parâmetros totais | 2,4 trilhões |
| Ativos por token | 71 bilhões, 25% menos que o Qwen3.8-Max na mesma escala |
| Contexto | 1.000.000 de tokens |
| Entrada | Texto, imagem e vídeo |
| Raciocínio | Suportado, com resumo e criptografia do thinking |
| Ferramentas | Function Calling, busca na web, chamadas paralelas, ferramentas integradas |
| Compatibilidade | OpenAI Chat Completions, Responses, Anthropic Messages, DashScope |
| Saída estruturada | JSON Object e JSON Schema |
| Cache | Explícito e implícito |
| Pesos | Fechados, sem model card público |
| Data | 16 de novembro de 2026 |
As três regiões de deploy são China em Pequim, Global (Alemanha, Frankfurt), Internacional (Singapura) e China (Pequim). Batch inference e fine-tuning não são suportados, e o deploy dedicado do modelo também não. A cota gratuita é de 1 milhão de tokens, válida por 90 dias, apenas na região de Singapura.
O que explica parte da economia é a arquitetura. A mesma escala de 2,4 trilhões do Qwen3.8-Max, mas com 71 bilhões de parâmetros ativados por token contra 95 bilhões, uma redução de 25%. A mudança não está só na contagem: a arquitetura Qwen4 mexe em atenção, conexões residuais e embeddings, que era exatamente o que o Qwen3.8-Flash-Next tinha antecipado como prévia pública um mês antes.
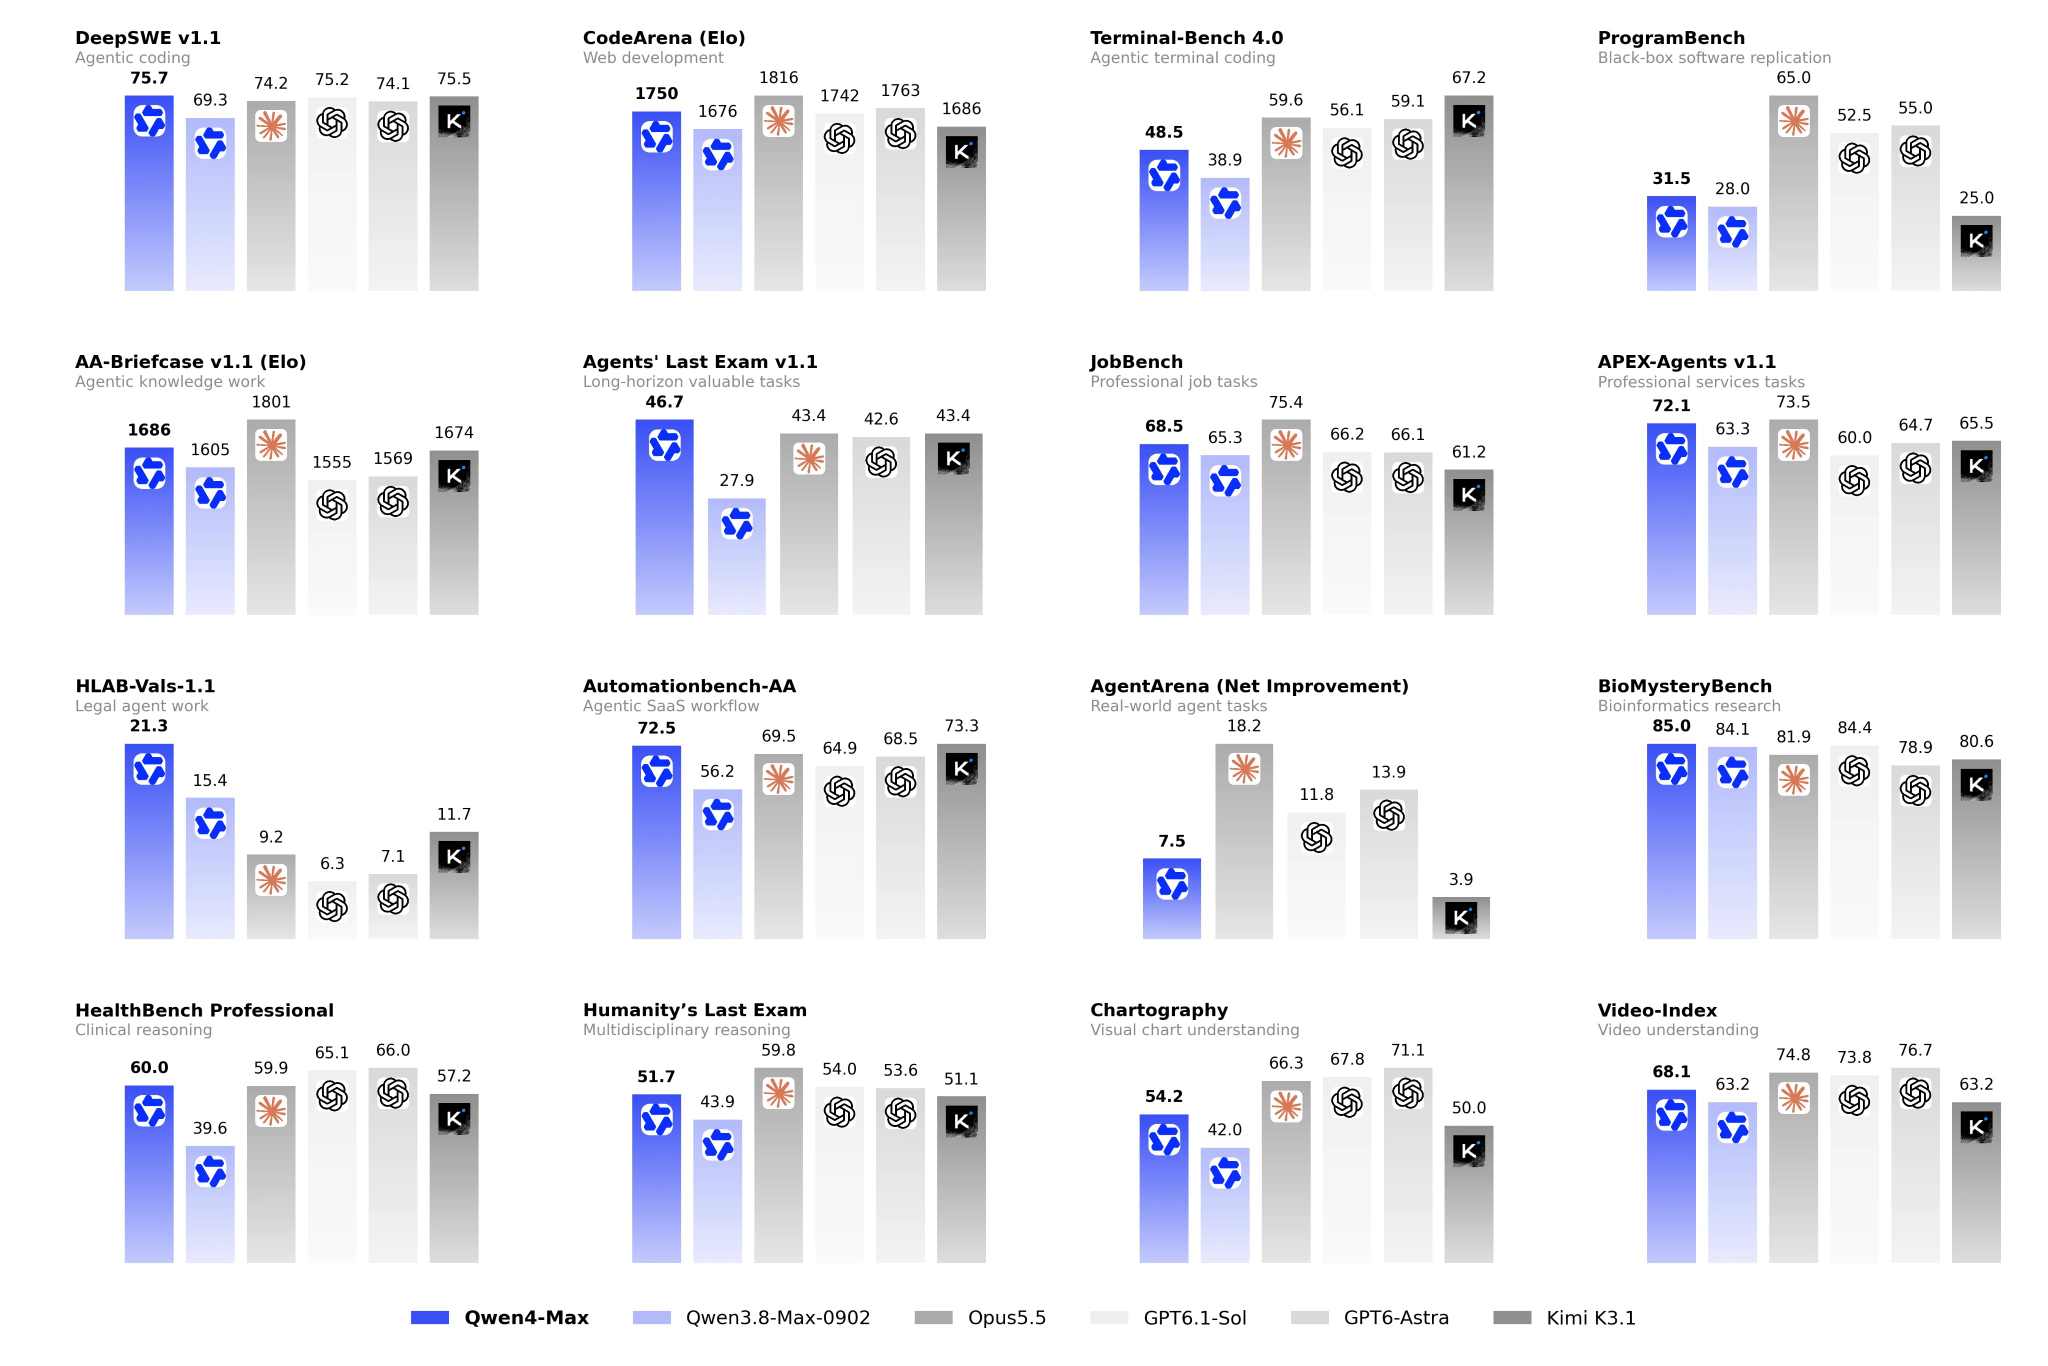
O gráfico completo, sem cortar as perdas
Estes são os 16 benchmarks do gráfico oficial. A ordem das colunas é Qwen4-Max, Qwen3.8-Max-0902, Opus 5.5, GPT-6.1 Sol, GPT-6.2 Astra e Kimi K3.1.
| Benchmark | Qwen4-Max | Qwen3.8-Max | Opus 5.5 | GPT-6.1 Sol | GPT-6.2 Astra | Kimi K3.1 |
|---|---|---|---|---|---|---|
| DeepSWE v1.1, codificacao com agentes | 75,7 | 69,3 | 74,2 | 75,2 | 74,1 | 75,5 |
| CodeArena Elo, desenvolvimento web | 1750 | 1676 | 1816 | 1742 | 1763 | 1686 |
| Terminal-Bench 4.0, codificacao agentiva em terminal | 48,5 | 38,9 | 59,6 | 56,1 | 59,1 | 67,2 |
| ProgramBench, replicacao de software em caixa-preta | 31,5 | 28,0 | 65,0 | 52,5 | 55,0 | 25,0 |
| AA-Briefcase v1.1 Elo, trabalho do conhecimento com agentes | 1686 | 1605 | 1801 | 1555 | 1569 | 1674 |
| Agents’ Last Exam v1.1, tarefas de longo horizonte | 46,7 | 27,9 | 43,4 | 42,6 | 43,4 | n/d |
| JobBench, tarefas profissionais de trabalho | 68,5 | 65,3 | 75,4 | 66,2 | 66,1 | 61,2 |
| APEX-Agents v1.1, tarefas de servicos profissionais | 72,1 | 63,3 | 73,5 | 60,0 | 64,7 | 65,5 |
| HLAB-Vals-1.1, trabalho juridico com agentes | 21,3 | 15,4 | 9,2 | 6,3 | 7,1 | 11,7 |
| AutomationBench-AA, workflow SaaS com agentes | 72,5 | 56,2 | 69,5 | 64,9 | 68,5 | 73,3 |
| AgentArena, melhoria liquida | 7,5 | n/d | 18,2 | 11,8 | 13,9 | 3,9 |
| BioMysteryBench, pesquisa bioinformatica | 85,0 | 84,1 | 81,9 | 84,4 | 78,9 | 80,6 |
| HealthBench Professional, raciocinio clinico | 60,0 | 39,6 | 59,9 | 65,1 | 66,0 | 57,2 |
| Humanity’s Last Exam, raciocinio multidisciplinar | 51,7 | 43,9 | 59,8 | 54,0 | 53,6 | 51,1 |
| Chartography, compreensao de graficos | 54,2 | 42,0 | 66,3 | 67,8 | 71,1 | 50,0 |
| Video-Index, compreensao de video | 68,1 | 63,2 | 74,8 | 73,8 | 76,7 | 63,2 |
A leitura honesta desse quadro dá quatro coisas.
O Agents’ Last Exam é a vitória real. 46,7 contra 43,4 do Opus 5.5 e 27,9 do Qwen3.8-Max. São 18,8 pontos de salto em uma geração, num benchmark de tarefas longas e valiosas. É o único resultado que eu apontaria como побе clara, e o mais relevante para quem quer um modelo que trabalha sozinho por horas.
O HLAB-Vals-1.1 também, e por muito. 21,3 contra 11,7 do Kimi K3.1, o segundo colocado. Quase o dobro do próximo. Em trabalho jurídico com agentes, o modelo da Alibaba está num patamar que nenhum dos rivais do gráfico alcança.
Em terminal e em replicação de software, ele perde feio. Terminal-Bench 4.0 dá 48,5 contra 67,2 do Kimi K3.1 e 59,6 do Opus 5.5. ProgramBench dá 31,5 contra 65,0 do Opus 5.5, metade da nota. São exatamente os dois benchmarks de engenharia de software mais práticos do conjunto, e é onde o modelo está mais distante da liderança.
E o padrão no resto é irregular. Ele fica em segundo em AA-Briefcase, APEX-Agents, AutomationBench e JobBench. Cai para perto do fim no AgentArena, onde os 18,2 do Opus 5.5 são mais que o dobro dos 7,5 do Qwen4-Max. Em Chartography e Video-Index, que medem compreensão visual, os modelos americanos vão bem à frente: 71,1 contra 54,2 no primeiro, 76,7 contra 68,1 no segundo. Num modelo que se anuncia como multimodal nativo, esses dois números merecem atenção.
O Work360 e a economia de tokens
O Work360 é o benchmark próprio da Alibaba, com 26 dominios de topo e 721 campos especializados. Nele o Qwen4-Max marca 52,69 contra 47,74 do Qwen3.8-Max. É um número do fornecedor, medido no ambiente dele, e serve mais como sinal de eficiência do que como ranking de capacidade.
A economia de tokens é a parte mais concreta. No raciocínio em nível alto, o modelo usa cerca de 35% menos tokens que o antecessor. No nível xhigh, cerca de 24% menos. No Terminal-Bench 4.0, a redução chega a 48% e 49%. Somado às tarifas menores, o custo médio por tarefa no Work360 despenca de US$ 4,43 para US$ 1,67, uma queda de 62%.
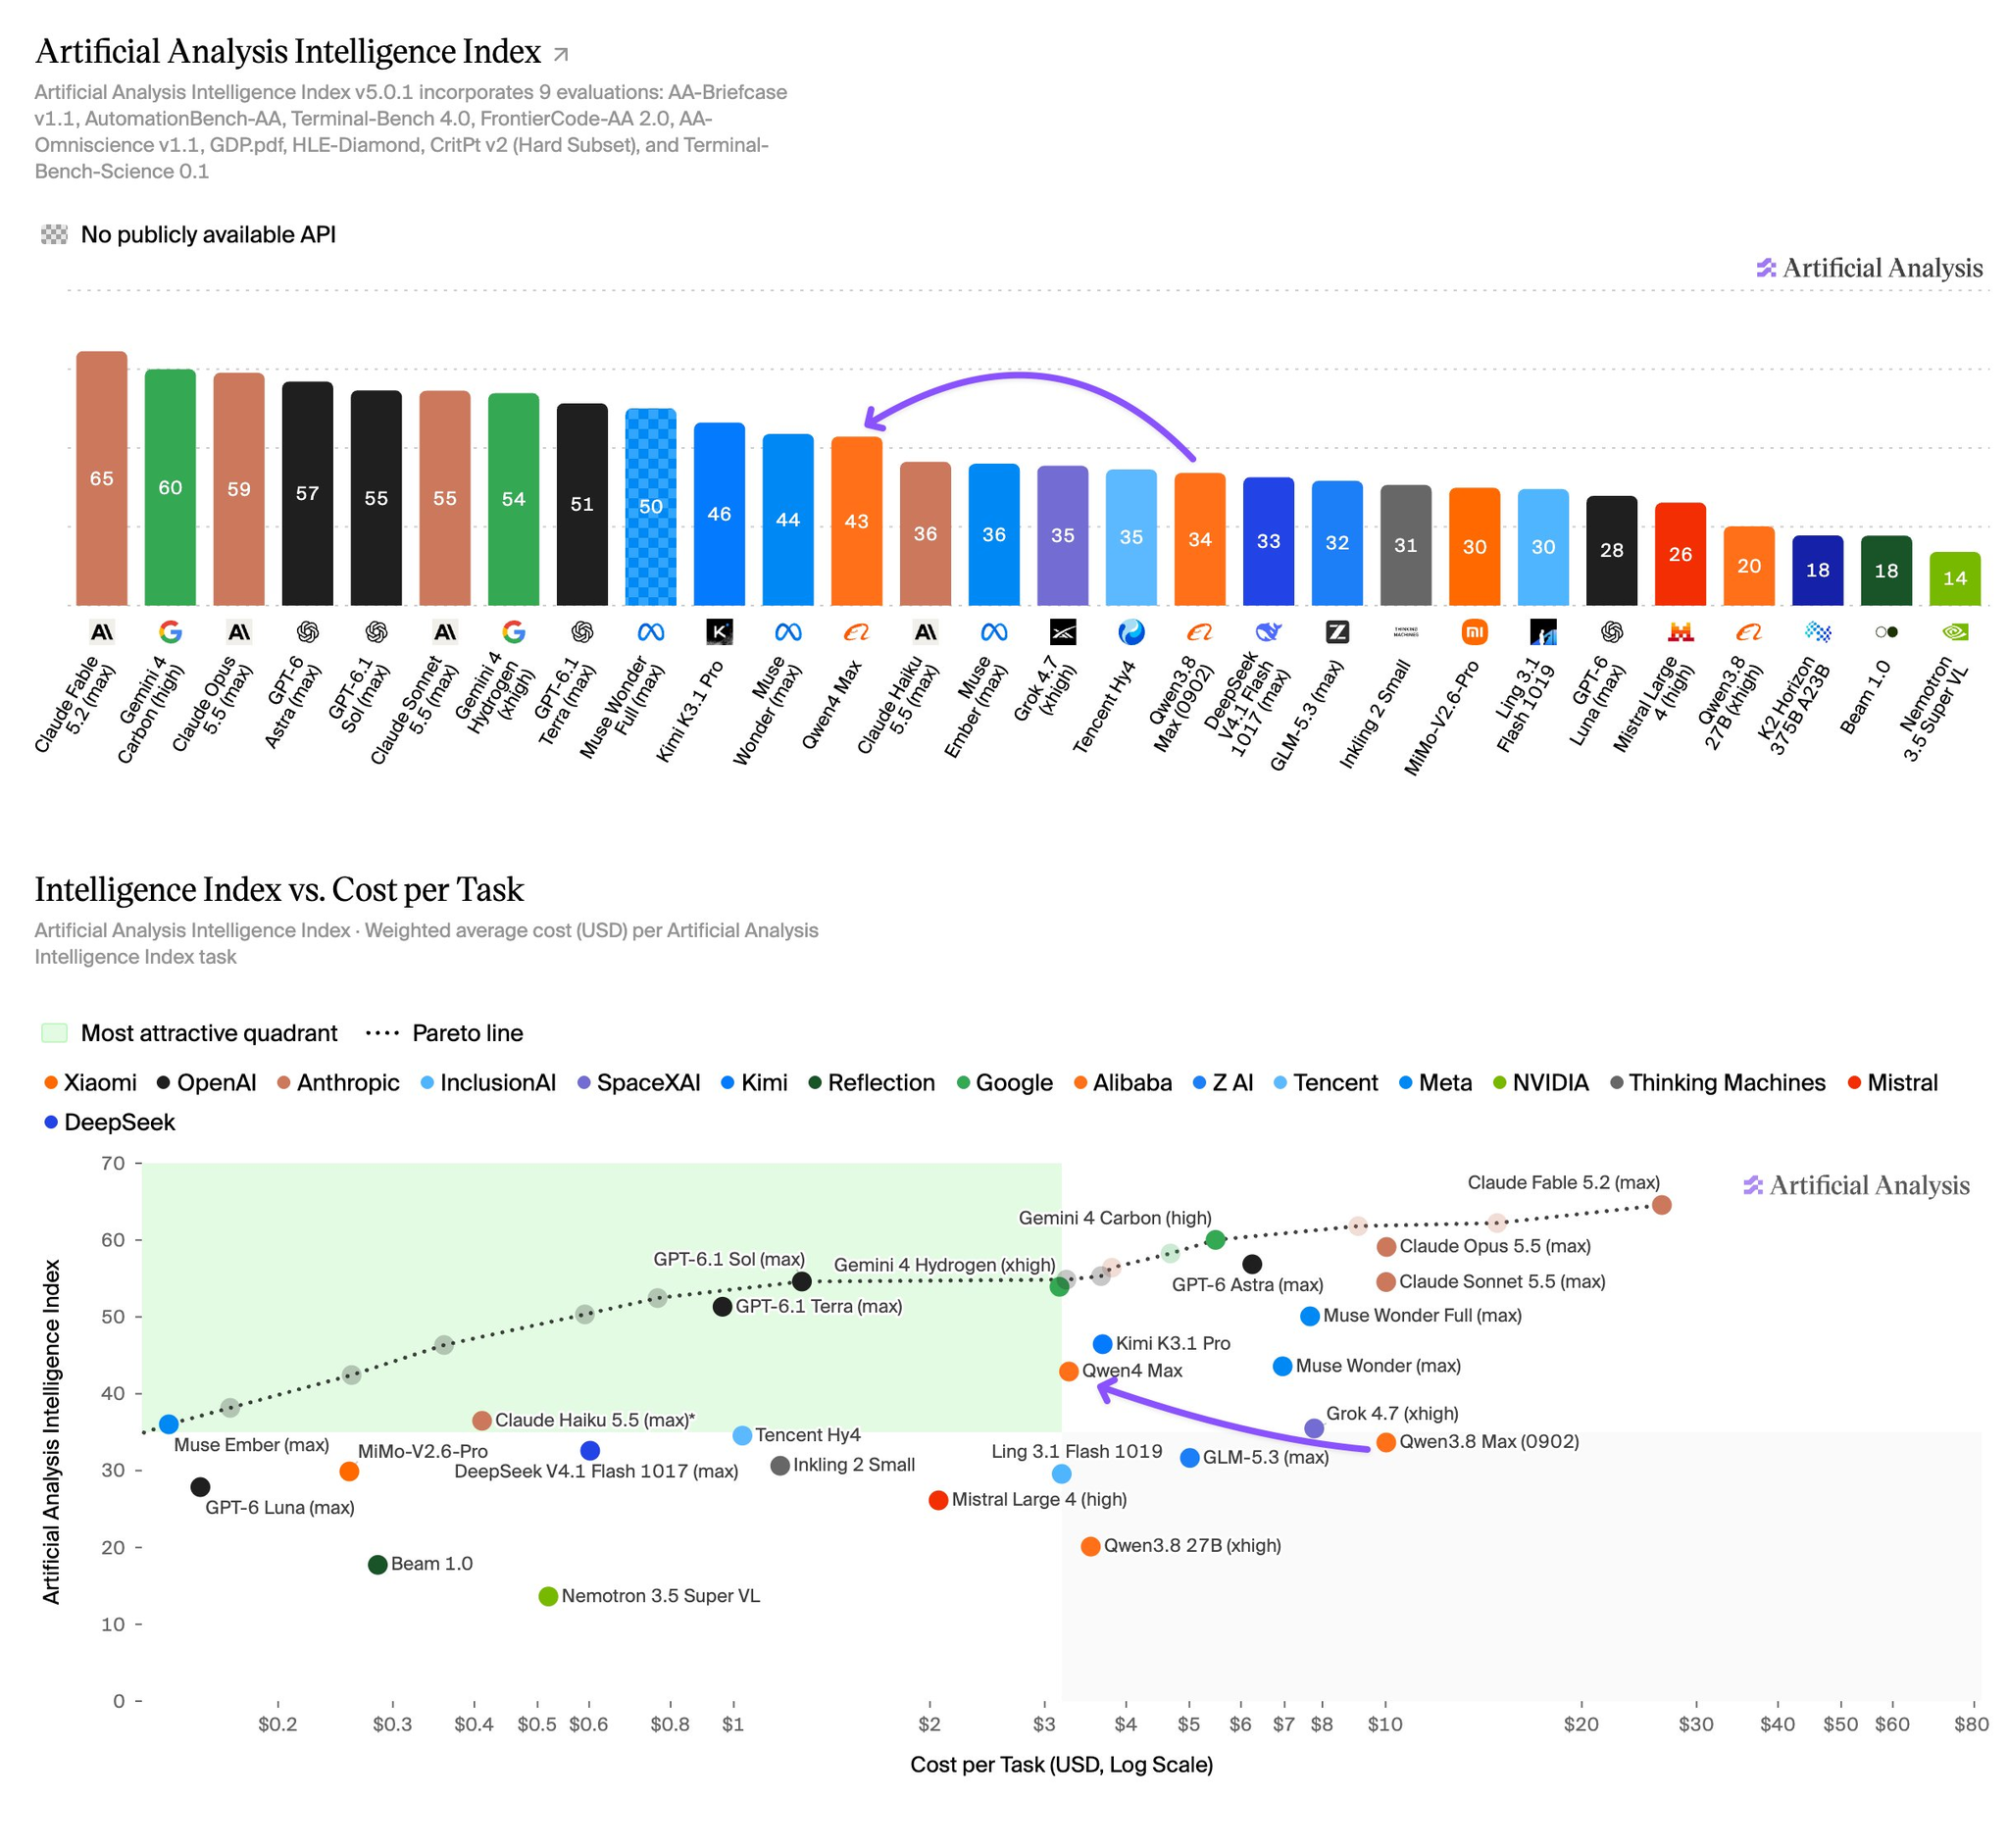
Essa combinação explica o resultado contra o Kimi K3.1 na Artificial Analysis: o Qwen4-Max marca 43 no Intelligence Index, nove pontos acima do Qwen3.8-Max, três pontos atrás do Kimi K3.1 Pro, com cerca de 11% menos custo por tarefa. Num índice onde os dois se equiparam em inteligência, o desempate pelo preço é o argumento de venda, e é um argumento forte. Mas é uma única medição no primeiro dia, não uma avaliação completa.
Preços: a tabela completa
| Item | Qwen4-Max | Qwen3.8-Max |
|---|---|---|
| Entrada por 1M de tokens | US$ 1,50 | US$ 2,00 |
| Saida por 1M de tokens | US$ 4,50 | US$ 6,00 |
| Leitura de cache implicito | US$ 0,075 | US$ 0,25 |
| Escrita de cache explicito, 5 min | US$ 1,875 | n/d |
| Escrita de cache explicito, 1 hora | US$ 3,00 | n/d |
Nas regiões China e Global, os preços são um pouco menores: US$ 1,413 de entrada e US$ 4,24 de saída. Raciocínio e não raciocínio custam o mesmo. A cota gratuita de 1 milhão de tokens vale por 90 dias, só em Singapura.
Colocado ao lado dos rivais, o argumento fica claro. O Claude Fable 5.2 está em US$ 8 de entrada e US$ 40 de saída. O GPT-6 Astra, em US$ 10 e US$ 50. O Gemini 4 Carbon, em US$ 2 e US$ 10. O Opus 5.5, em US$ 4 e US$ 20. Contra esses, a saída do Qwen4-Max a US$ 4,50 é cerca de um décimo do Astra e 22% do Opus 5.5. Entre os modelos que a própria Alibaba usa como comparação, o Opus 5.5 a US$ 4 e US$ 20 e o Kimi K3.1 e o GPT-6.1 Sol a US$ 2 e US$ 10, a diferença é de 45%.
Uma observação de método: tarifa menor por token não garante custo menor por tarefa. É o que separa o Qwen4-Max, que ganha em eficiência de tokens, dos modelos que ganham em capacidade bruta.
Onde usar
O modelo está disponível na API do QwenCloud pelo ID qwen4-max, no Token Plan, no Qwen Studio, no QwenWork e no Qoder. A prévia qwen4-max-preview, que abriu em 11 de novembro e nunca teve preço por token, continua até 25 de novembro e depois é aposentada. A partir de hoje existe preço público, que é a diferença entre esta release e a prévia.
O Qwen4-Max também chegou de dia um na Novita AI e na AI Gateway da Vercel, que estima 384 mil tokens de saída e está disponível para modelagem 3D e desenvolvimento de jogos.
O que isso significa para quem roda local
Para quem quer rodar IA local, o catálogo de modelos de IA local do RodarIA mostra o que cabe em cada hardware hoje, enquanto a família Qwen4-Max segue atrás da API.
A notícia aberta continua sendo a mesma de 11 de novembro: os pesos do Qwen4-Max estão fechados. Quem mantém servidor local não vai baixar esse modelo. A Alibaba diz que modelos menores da família Qwen4 virão abertos, sem data, construídos na mesma linhagem e técnicas de treino do flagship.
Para quem usa API, a conta muda. O Qwen4-Max chega 25% mais barato em entrada e saída e 70% mais barato em cache que o Qwen3.8-Max, que era o topo de linha da família. E é mais barato que o Gemini 4 Hydrogen, que está em US$ 1,50 e US$ 7,50 na mesma janela de 1 milhão de tokens: o Alibaba ganha na entrada, que é onde fica a maior parte do volume, e perde na saída.
Para quem compara open-weight com API fechada, a pergunta relevante não é só o preço do Qwen4-Max. É se os modelos menores da família Qwen4, quando saírem, mantêm a arquitetura nova. Se mantiverem, o Qwen3.8-Flash-Next deixa de ser uma prévia experimental e vira base de um peso aberto de verdade. O card daquele modelo, publicado em agosto, é a melhor previsão disponível do que vem a seguir.
Referência rápida
| O que | Onde |
|---|---|
| Data do lançamento | 16 de novembro de 2026 |
| Model ID | qwen4-max |
| Parametros | 2,4 trilhoes, 71 bilhoes ativos por token |
| Contexto | 1.000.000 de tokens |
| Entrada | US$ 1,50 por milhao de tokens |
| Saida | US$ 4,50 por milhao de tokens |
| Cache implicito | US$ 0,075 por milhao de tokens |
| Custo por tarefa no Work360 | US$ 1,67, contra US$ 4,43 do antecessor |
| Artificial Analysis | 43, nove pontos acima do Qwen3.8-Max |
| Pesos abertos | Nao. Modelos menores prometidos, sem data. |
Perguntas frequentes
O Qwen4-Max tem pesos abertos?
Não. O Qwen4-Max tem pesos fechados e a Alibaba não anunciou model card público. O comunicado diz que modelos menores da série Qwen4 serão liberados como open source mais adiante, sem data. Isso inverte o que a empresa fez com o Qwen3.8-Max, cujo open weight saiu em agosto.
Quanto custa o Qwen4-Max?
US$ 1,50 por milhão de tokens de entrada e US$ 4,50 por milhão de tokens de saída na região internacional, com leitura de cache implícito a US$ 0,075. Escrita de cache explícito custa US$ 1,875 para janela de 5 minutos e US$ 3,00 para 1 hora. Há cota gratuita de 1 milhão de tokens por 90 dias, só em Singapura.
Qual a diferença entre o Qwen4-Max e o qwen4-max-preview?
O preview abriu em 11 de novembro de 2026 só dentro do Token Plan, sem preço por token, sem benchmarks e com data de descontinuação. O lançamento geral de 16 de novembro traz o ID qwen4-max, API pública, preço por token, benchmarks e região de deploy global. O preview continua até 25 de novembro e depois é aposentado.
O Qwen4-Max é melhor que o Claude Opus 5.5?
Depende da tarefa. Ele ganha em Agents’ Last Exam (46,7 contra 43,4) e em trabalho jurídico (21,3 contra 9,2). Perde em Terminal-Bench 4.0 (48,5 contra 59,6), em ProgramBench (31,5 contra 65,0), em Humanity’s Last Exam (51,7 contra 59,8) e em AgentArena (7,5 contra 18,2). E custa uma fração do preço na saída.
Por que ele usa menos tokens que o Qwen3.8-Max?
Dois fatores se somam. A arquitetura Qwen4 mexe em atenção, conexões residuais e embeddings, e o MoE ativa 71 bilhões de parâmetros por token contra 95 bilhões do antecessor na mesma escala de 2,4 trilhões. No Work360 isso rende cerca de 35% menos tokens no raciocínio alto e 48% a 49% menos no Terminal-Bench 4.0.
Como comparo com o Gemini 4 Hydrogen e o Claude Fable 5.2 em preço?
O Hydrogen está em US$ 1,50 de entrada e US$ 7,50 de saída. O Fable 5.2, em US$ 8 e US$ 40. O Qwen4-Max ganha na entrada contra o Hydrogen, empatando, e perde na saída. Contra o Fable 5.2 é cerca de um quinto na entrada e um nono na saída.
Os benchmarks são confiáveis?
São números do próprio fabricante. O gráfico de lançamento é compilado pela Alibaba e cita alguns leaderboards de terceiros sem reprodução independente. Depois do lançamento, a Artificial Analysis mediu 43 no Intelligence Index, e o Vals colocou o modelo em 11º geral e como o melhor chinês. Medições independentes sobre ProgramBench e Terminal-Bench também são mais duras que o gráfico oficial.
O que aconteceu com o Qwen3.8-Max?
Continua disponível com preço de tabela e é o modelo com pesos abertos da família, o Qwen3.8-2.4T-A95B. O ID qwen3.8-max segue na API a US$ 2,00 e US$ 6,00. Para quem precisa de pesos, o Qwen3.8-Max continua sendo a opção da casa.
Referências
- Alibaba Cloud: comunicado oficial do lancamento do Qwen4-Max
- Qwen4-Max: documentacao do modelo no Model Studio
- Model Studio: tabela de precos de inferencia
- Model Studio: lista de modelos lancados
- QwenCloud: changelog de lancamentos de modelos
- Anuncio oficial e grafico de benchmarks no X
- Qwen3.8-Flash-Next: a previa da arquitetura que virou o Qwen4
- DataCamp: leitura dos benchmarks e onde o modelo perde
- The Next Web: lancamento do flagship sem pesos abertos