
10 de novembro de 2026 A MiniMax lançou o H3-Image, um modelo de geração de imagem com pesos abertos que promete entregar uma imagem de 16 megapixels, 4096 x 4096, em menos de 10 segundos. No gráfico oficial da empresa, a versão Highspeed leva 10,3 segundos para gerar um quadro 4K, contra 50 segundos do Google Nano Banana 2.1, 51 segundos no modo de pensamento alto do mesmo modelo e 54,2 segundos do Seedream 5 Pro em 2K. E o preço é de US$ 0,06879 por imagem 4K na tabela cheia, US$ 0,03439 durante a semana de lançamento.
Traduzindo para o que importa: o H3-Image é o primeiro modelo open-weight de imagem que gera 4K nativo, sem upscaler, na velocidade de um upload. Isso muda o que dá pra fazer com imagem gerada por IA. O que não muda é a qualidade, porque isso ainda ninguém mediu fora da MiniMax. E há uma cláusula na licença que transformou o “open-weight” em letra miúda pesada, mas todo mundo precisa saber antes de baixar 135 GB de pesos.
O que é o H3-Image
O H3-Image é a ramificação de imagem do sistema H3 da MiniMax, aquele mesmo que genera vídeo com áudio estéreo nativo. É um diffusion transformer (DiT) denso de 33,1 bilhões de parâmetros, com 50 camadas, dimensão oculta de 5.376, 56 cabeças de atenção, FFN de 14.336 e RoPE multimodal 3D, exatamente a mesma espinha dorsal do H3-Omni-Transformer, só que sem os camadas de áudio.
O que faz o modelo ser rápido não é truque de inference: é destilação. O checkpoint foi destilado para 6 passos de amostragem (6 NFEs) e sem classifier-free guidance. Passe qualquer valor diferente de 6 em num_inference_steps ou diferente de 1 em guidance_scale e a API devolve HTTP 400. Não é bug, é contrato. negative_prompt também não existe.
O encoder de texto é o Qwen3-VL completo do H3, sem modificação, e o DiT lê os estados ocultos da camada 50 dele. O VAE de imagem é um encoder CNN com decoder ViT 2D de 24 camadas, downsampling 16x e 24 canais latentes. O DiT faz patchify 2×2 do latente, ou seja, cada token do transformer cobre um bloco de 32×32 pixels.
| Componente | Especificação |
|---|---|
| DiT (diffusion transformer) | 33,1B parâmetros, single-stream denso, 50 camadas, hidden 5.376, 56 cabeças, FFN 14.336, RoPE multimodal 3D, pesos BF16 com embedding/timestep/output em FP32 |
| Text encoder | Qwen3-VL completo do MiniMax-H3, sem alteração, o DiT lê a camada 50 |
| Image VAE | Encoder CNN + decoder ViT 2D de 24 camadas, 16x downsampling, 24 canais latentes |
| Patchify | 2×2 sobre o latente, cada token cobre 32×32 pixels |
| Amostragem | 6 passos (6 NFEs), sem classifier-free guidance, fixo |
| Precisão dos pesos | 68,65 GB em BF16 |
| Prompt expander (opcional) | MiniMax-H3-Image-PE, 17,9 GB em NVFP4 |
A latência: 4K em 10 segundos
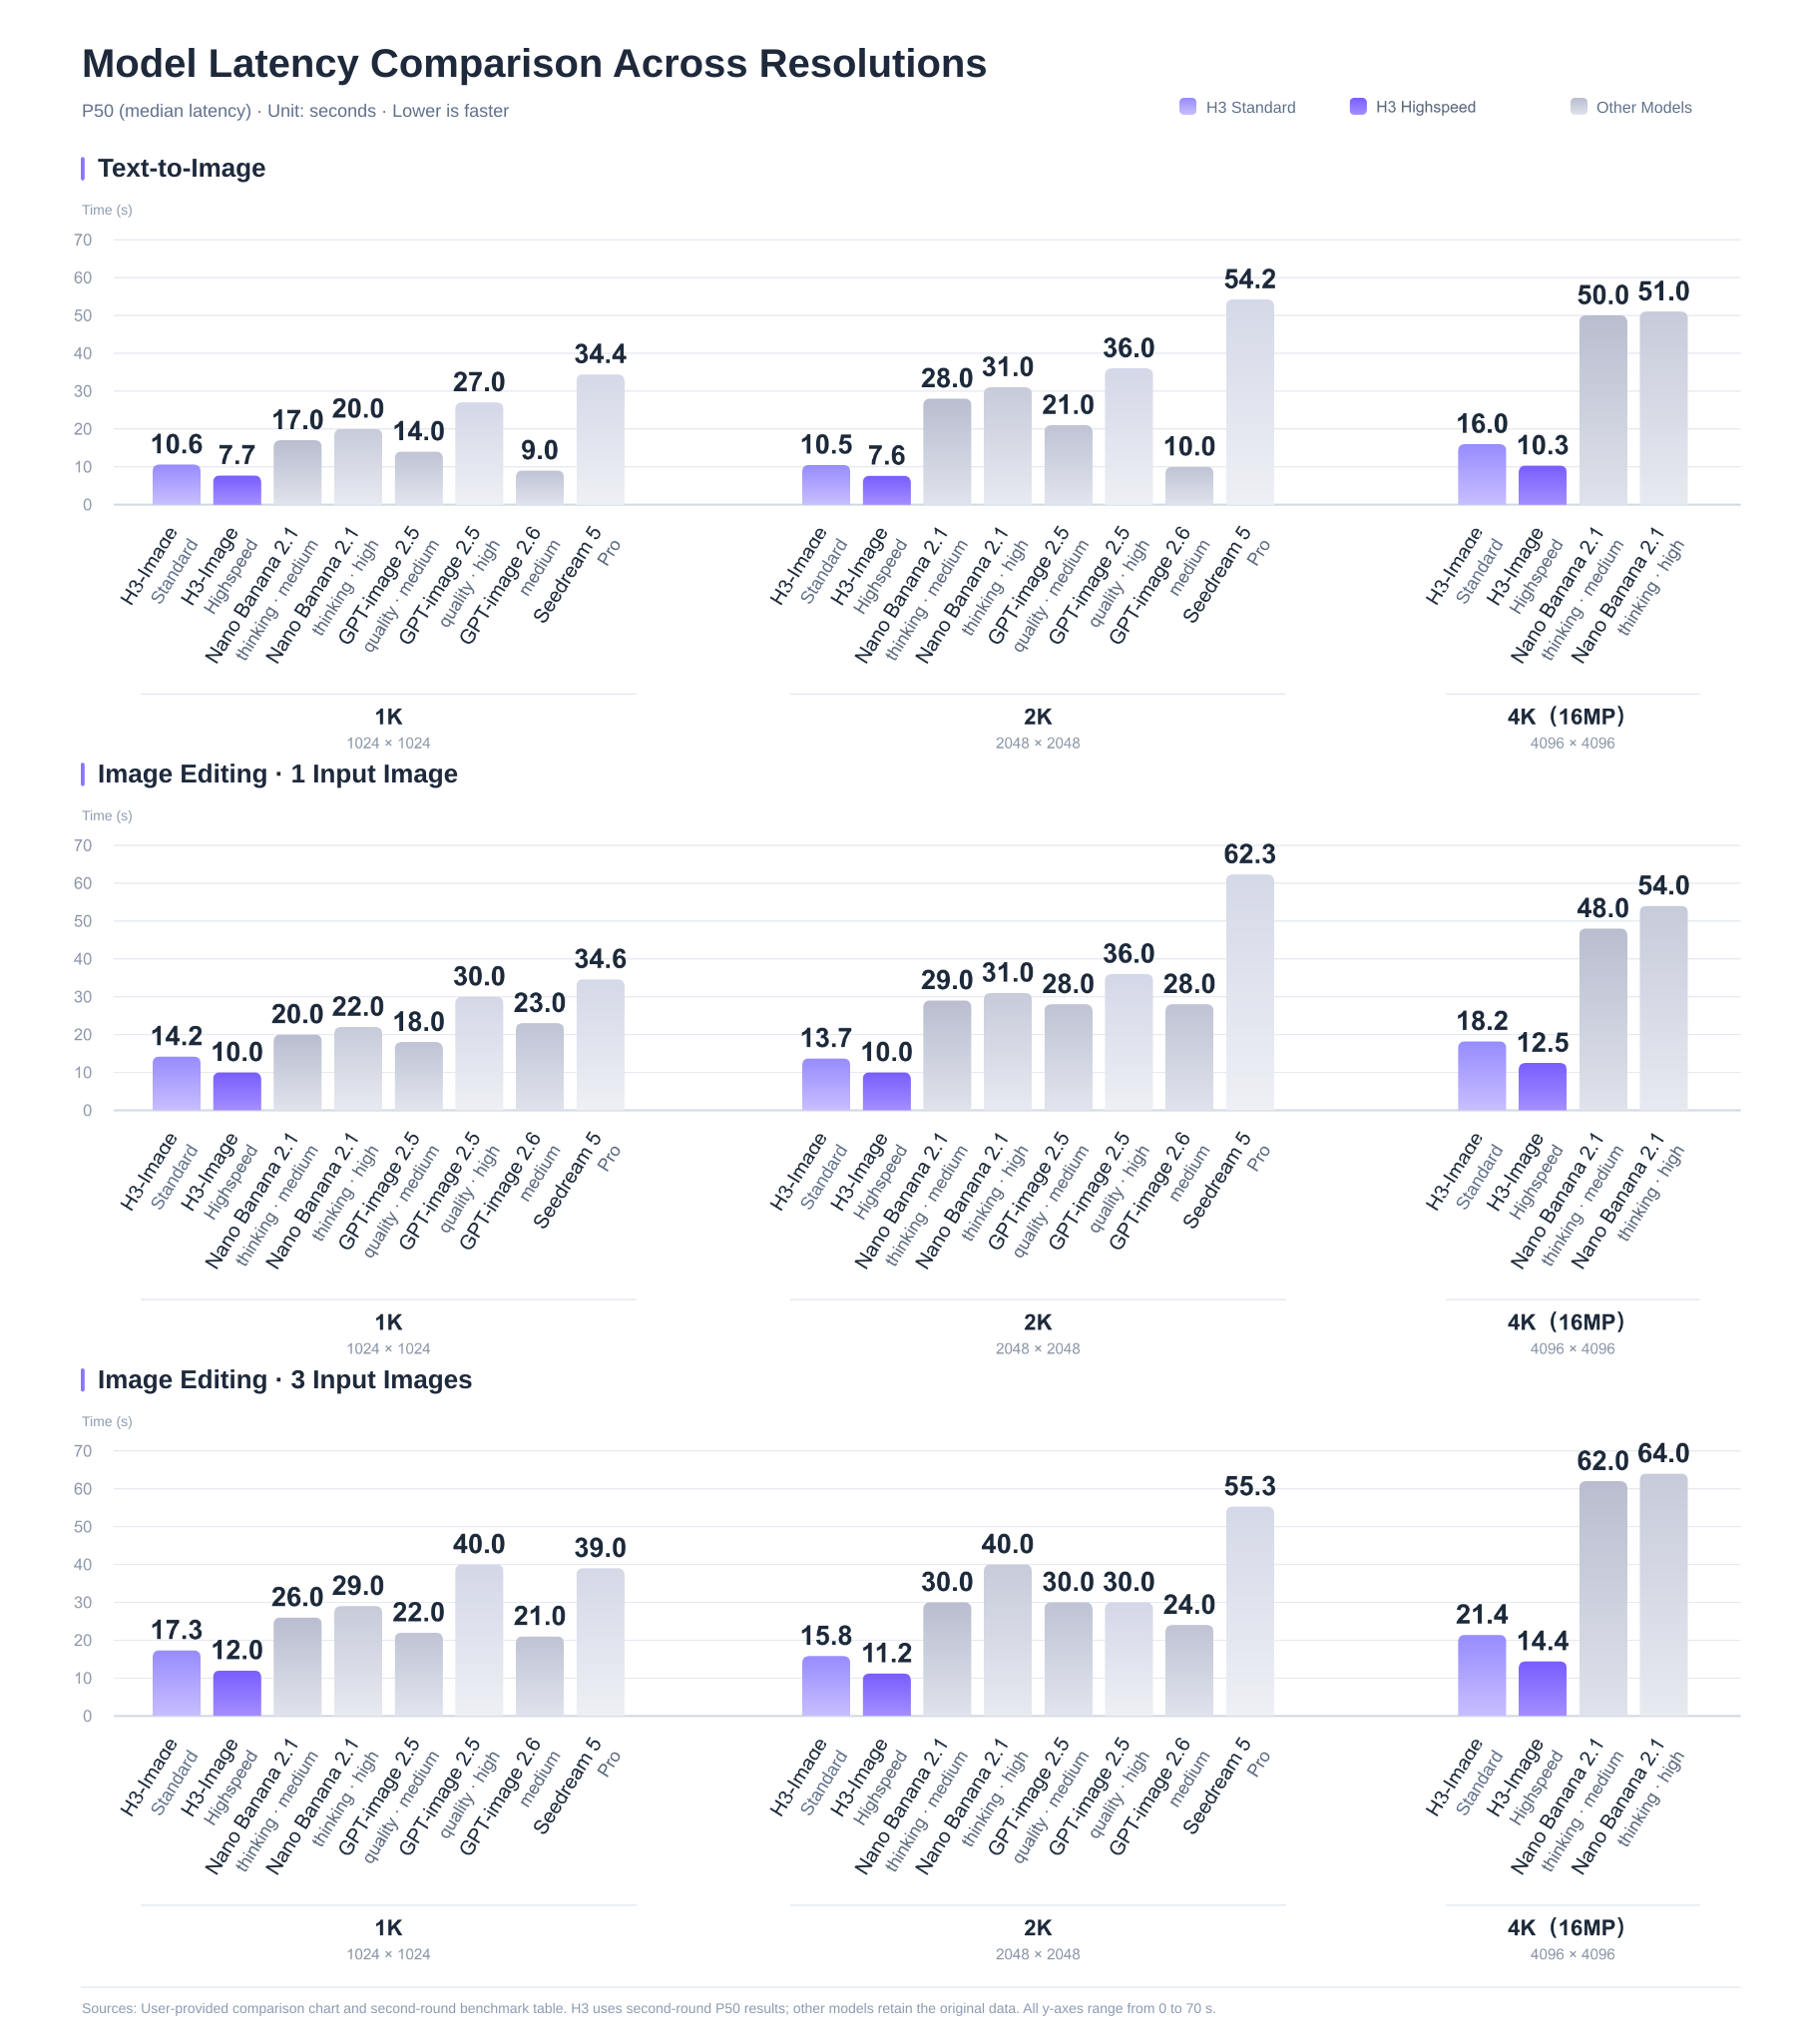
Este é o gráfico que a MiniMax Releases, e ele é o argumento central do lançamento. Os números são P50, mediana, medidos no serviço hospedado, e os modelos comparados são o Google Nano Banana 2.1, o GPT-image 2.5, o GPT-image 2.6 e o Seedream 5 Pro da ByteDance.
| Modelo | 1K (1024×1024) | 2K (2048×2048) | 4K (4096×4096) |
|---|---|---|---|
| H3-Image Highspeed | 7,7s | 7,6s | 10,3s |
| H3-Image Standard | 10,6s | 10,5s | 16,0s |
| GPT-image 2.6 (medium) | 9,0s | 10,0s | n/d |
| GPT-image 2.5 (quality, medium) | 14,0s | 21,0s | n/d |
| Nano Banana 2.1 (thinking, medium) | 17,0s | 28,0s | 50,0s |
| Nano Banana 2.5 (thinking, high) | 20,0s | 31,0s | 51,0s |
| GPT-image 2.5 (quality, high) | 27,0s | 36,0s | n/d |
| Seedream 5 Pro | 34,4s | 54,2s | n/d |
O que o gráfico mostra, em uma frase: o H3-Image bate o GPT-image 2.6 em 2K e 4K e deixa o Nano Banana 2.1 muito atrás.
- Em 4K, onde o jogo é, o Highspeed faz 10,3s contra 50,0s do Nano Banana 2.1. São 4,85 vezes mais rápido. No modo de pensamento alto do Nano Banana, 51 segundos: 4,95 vezes.
- Em 1K o H3-Image ainda é mais lento que o GPT-image 2.6. 7,7s contra 9,0s do GPT-image 2.6 em Highspeed, mas o Standard do H3-Image leva 10,6s, mais que os 9,0s do GPT-image 2.6. Ou seja, a liderança de velocidade só é real a partir de 2K, e só na versão Highspeed.
- O Seedream 5 Pro desaparece em 4K porque nem aparece nos 4K do gráfico, e é o mais lento de todos em 1K e 2K, 34,4s e 54,2s.
- Latência de edição é bem pior que geração. O segundo painel do gráfico, com uma imagem de referência, mostra o H3-Image Highspeed entre 9,0s e 13,7s, contra 48,0s do GPT-image 2.5 em 2K. O terceiro painel, com três imagens de referência, é onde o Nano Banana 2.1 chega a 62,0s e o H3-Image fica em 28,0s.
Ressalva que a MiniMax não faz: o modelo card não dá nenhum tempo de geração. O número de 10 segundos existe só no post de lançamento e só para o serviço hospedado. Se você rodar local, o tempo depende do acelerador, do paralelismo de sequência e da resolução. O guia de deploy da própria empresa cita H200, RTX PRO 6000 Blackwell e AMD Instinct MI350X, e o caminho de baixa latência documentado é sequence parallelism (Ulysses) com 4 GPUs.
O preço: 16 vezes mais pixels por 3 vezes mais dinheiro
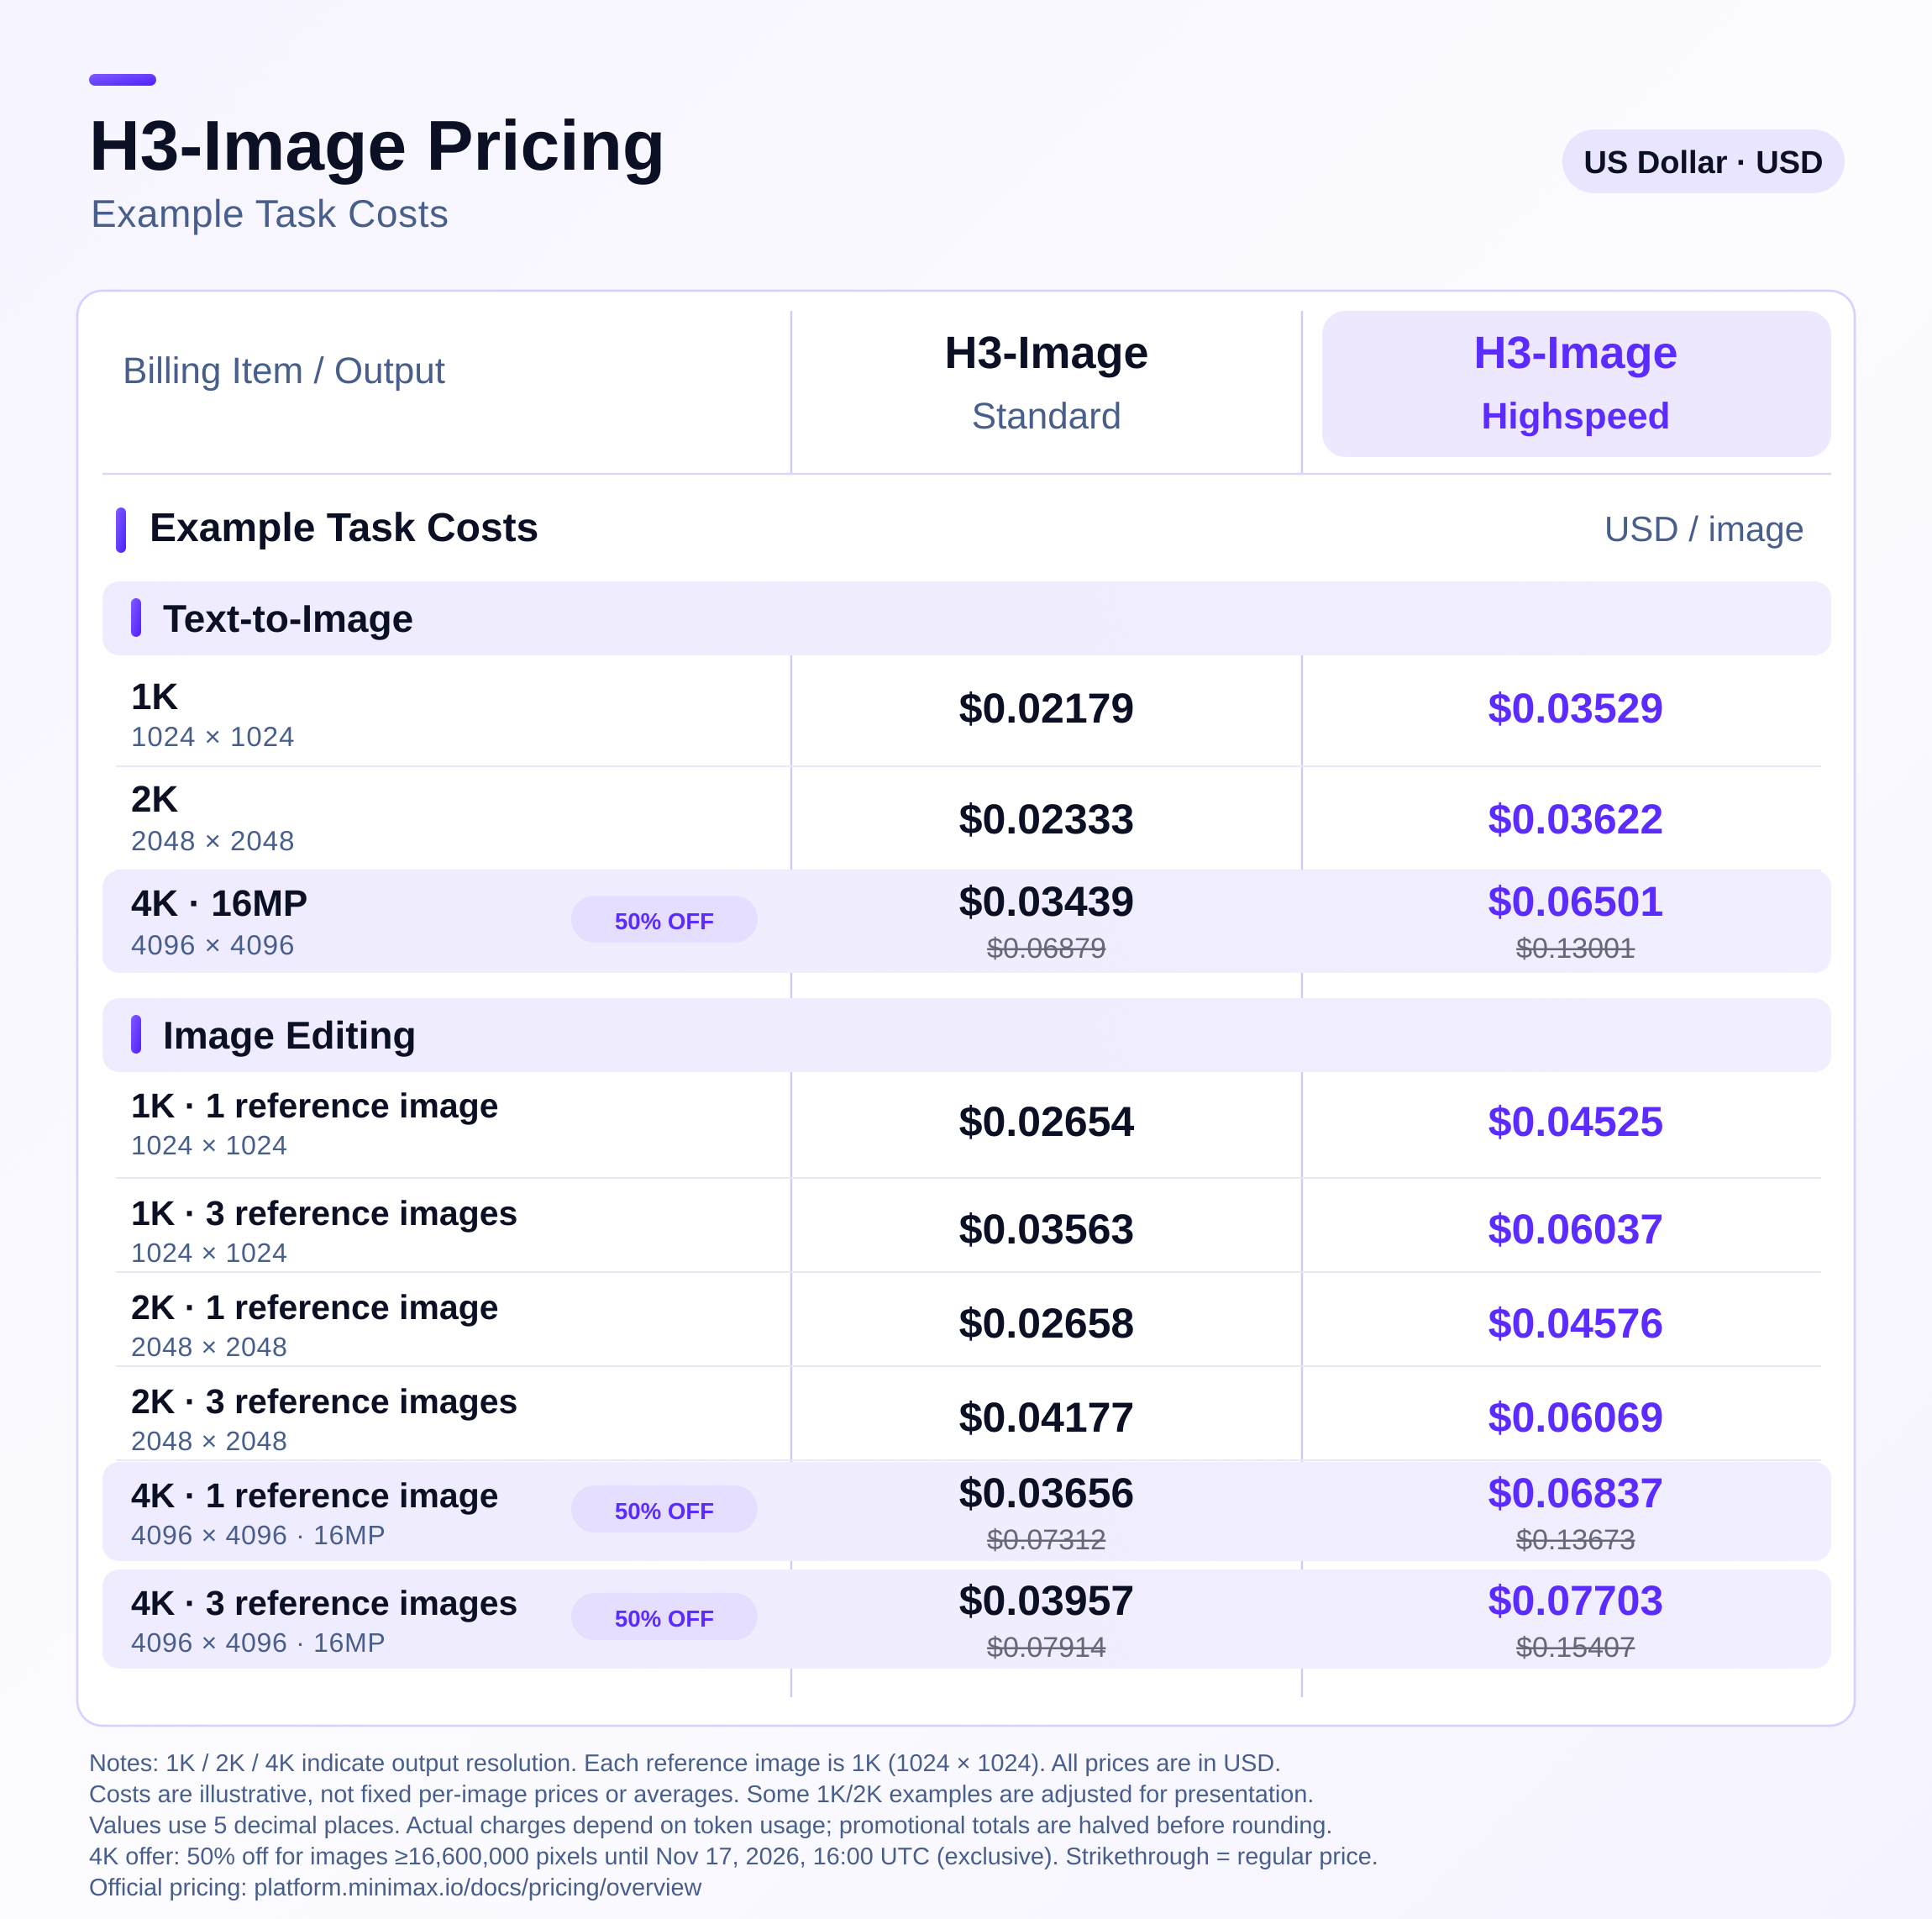
O H3-Image é cobrado por token de imagem, não por imagem. Isso produz uma escada de preço estranhamente plana, e é ali que está a verdade matemática do lançamento.
| Tarefa | Standard | Highspeed |
|---|---|---|
| Texto-para-imagem 1K | US$ 0,02179 | US$ 0,03529 |
| Texto-para-imagem 2K | US$ 0,02333 | US$ 0,03622 |
| Texto-para-imagem 4K | US$ 0,06879 | US$ 0,13001 |
| Edição, 1 referência, 1K | US$ 0,02654 | US$ 0,04525 |
| Edição, 1 referência, 2K | US$ 0,02658 | US$ 0,04576 |
| Edição, 1 referência, 4K | US$ 0,07312 | US$ 0,13673 |
| Edição, 3 referências, 1K | US$ 0,03563 | US$ 0,06037 |
| Edição, 3 referências, 2K | US$ 0,04177 | US$ 0,06069 |
| Edição, 3 referências, 4K | US$ 0,07914 | US$ 0,15407 |
Tarifas por token, no nível Standard:
| Item | Standard | Highspeed |
|---|---|---|
| Input de texto | US$ 2,30 / M tokens | US$ 2,30 / M tokens |
| Input de imagem | US$ 1,50 / M tokens | US$ 3,00 / M tokens |
| Output de imagem | US$ 3,80 / M tokens | US$ 7,60 / M tokens |
Aí está o truque: 16 vezes mais pixels custa pouco mais que 3 vezes mais dinheiro. Uma imagem 1K custa US$ 0,02179; a 4K custa US$ 0,06879. Você multiplica os pixels por 16 e multiplica a conta por 3,16. Isso acontece porque o token count não escala linearmente com a área, e a escada foi desenhada assim.
Contra o Google Nano Banana 2.1, que custa US$ 0,0336 por imagem 1K e US$ 0,113 em 4K, o H3-Image Standard sai 35% mais barato em 1K e 39% mais barato em 4K. No chão de fábrica, quem precisa de 1.000 imagens 4K paga US$ 55 no H3-Image ou US$ 113 no Nano Banana. Isso não é margem, é mudança deunidade.
A licença que proíbe metade do mundo de usar
Aqui é onde o lançamento ganha uma coluna que quase nenhum post vai mencionar. A MiniMax-H3-Image Community License Agreement define no item 5 das Definições:
“Excluded Territories” means the European Union, the United Kingdom, the Republic of Korea and the United States of America.
Traduzido: você não pode usar, reproduzir, modificar, distribuir ou exibir o modelo nem as saídas dele dentro da União Europeia, do Reino Unido, da Coreia do Sul e dos Estados Unidos. Isso não é só sobre os pesos. A Seção V, item 4 do contrato é explícita:
“You may not use, reproduce, modify, distribute, or display the MiniMax-H3-Image Works or any of their Outputs or results outside the Applicable Territory. Any such use outside the Applicable Territory is not authorized by this Agreement.”
Ou seja: uma imagem gerada pelo H3-Image não pode ser publicada nem exibida dentro da UE ou dos EUA. Se você tem audiência nesses territórios, o modelo está fora. A MiniMax diz que está avaliando as leis e regulamentos de compliance e que quem estiver nesses territórios pode falar com eles para obter licença separada, “com controles e guardrails robustos para fins de conformidade”. Na prática, isso é uma porta fechada com três(words) de batente.
Other clauses do mesmo contrato merecem atenção:
- Receita acima de US$ 1 milhão por ano exige autorização escrita prévia, via formulário no platform.minimax.io/license. O mesmo vale para quem oferece o modelo como serviço hospedado para terceiros, independente de receita.
- Você não pode usar as saídas para melhorar outro modelo de IA, exceto o próprio H3-Image e seus derivados.
- Precisa exibir “MiniMax-H3-Image” na interface de qualquer produto ou serviço comercial que use o modelo.
- Quem redistribui precisa entregar a licença, marcar arquivos modificados, incluir um arquivo NOTICE e, no mínimo, publicar um post técnico ou declaração pública sobre a experiência.
Não compare isso com a licença MIT ou Apache dos modelos abertos ocidentais. O H3 do vídeo tem a mesma restrição, e a comunidade já reclamou. É open-weight no sentido de “você pode baixar o arquivo”, não no sentido de “você pode usar”.
Rodar local: 135 GB e um H200
Se a licença não te impediu, o hardware te impede. O repositório do H3-Image tem 68,65 GB em BF16 do DiT, mas o text encoder não está nele: ele vem do repositório do H3 de vídeo, que é o Qwen3-VL completo com 66,7 GB. Uma primeira geração local é um download de aproximadamente 135 GB em dois repositórios, mais o prompt expander opcional de 17,9 GB em NVFP4.
| Item | Detalhe |
|---|---|
| DiT (H3-Image) | 68,65 GB, BF16 |
| Text encoder (do repo MiniMax-H3) | 66,7 GB, Qwen3-VL completo |
| Prompt expander (opcional) | 17,9 GB, NVFP4 |
| Total prático do download | cerca de 135 GB (mais 17,9 GB se quiser o PE) |
| Framework | vLLM-Omni (--omni) ou SGLang |
| Hardware citado | H200, RTX PRO 6000 Blackwell, AMD Instinct MI350X |
| Baixa latência | sequence parallelism Ulysses, 4 GPUs (--usp 4 no vLLM-Omni, --ulysses-degree 4 no SGLang) |
Existe uma pegadinha operacional na API que a documentação menciona e quase ninguém copia: os endpoints de imagem não são idempotentes. Se a requisição dá timeout, ela foi gerada e foi cobrada. O retry cobra de novo. A documentação recomenda desligar o retry automático do SDK, e num trabalho pago em imagens isso importa mais que o desconto.
O que o modelo realmente entrega
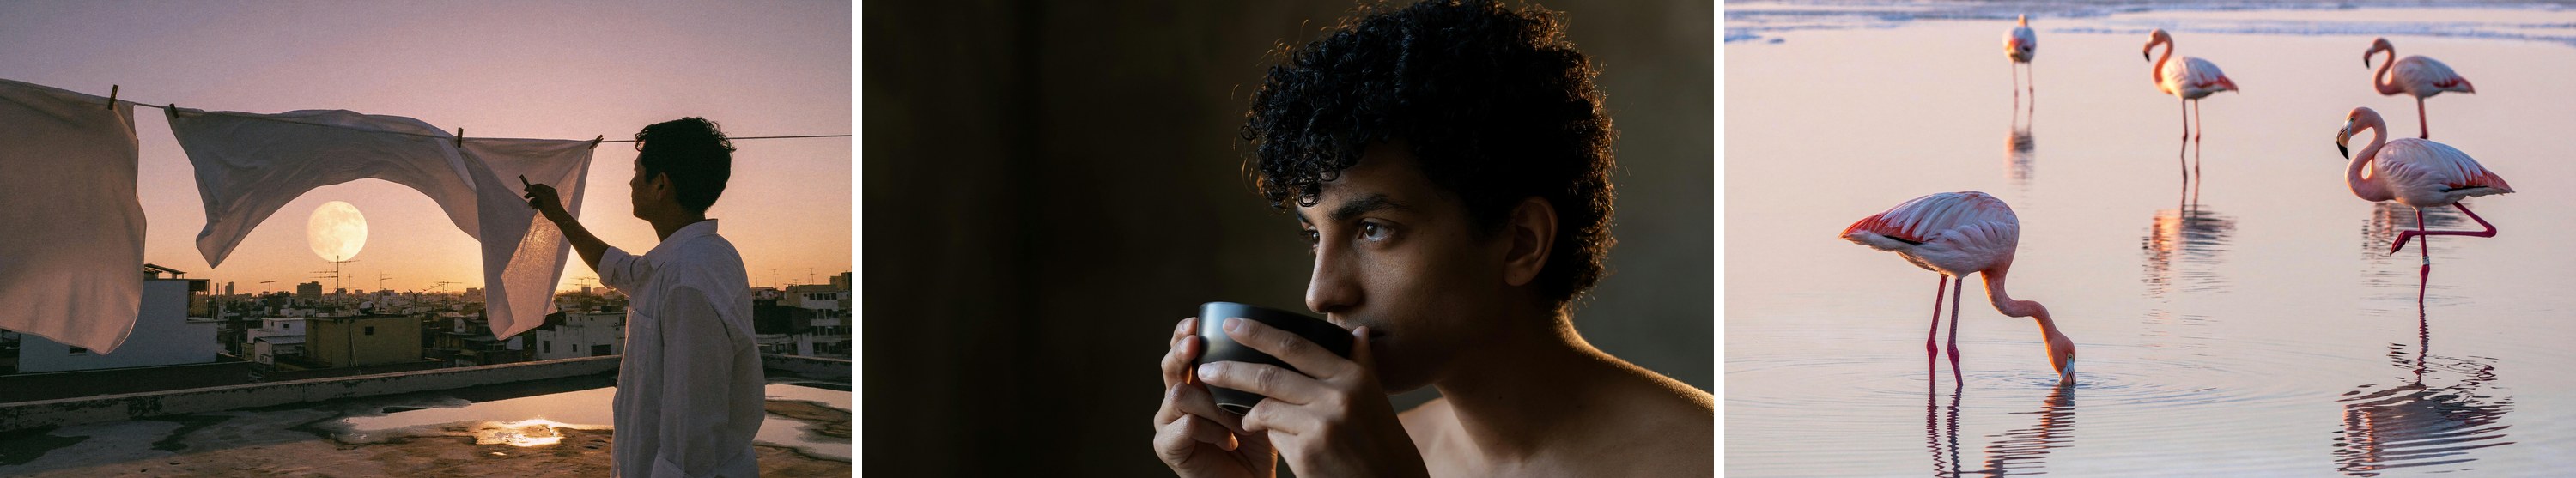
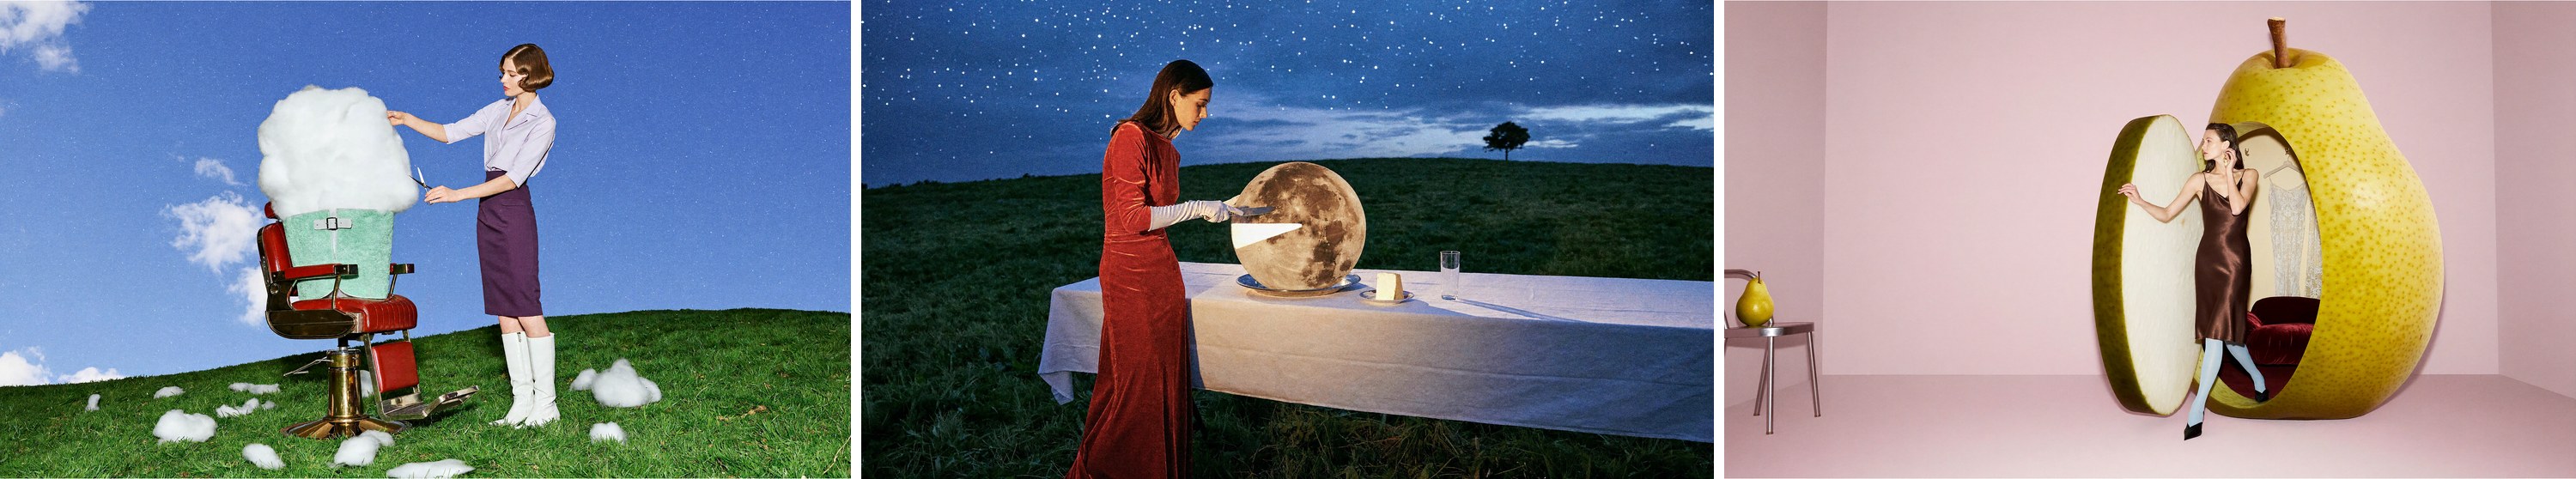
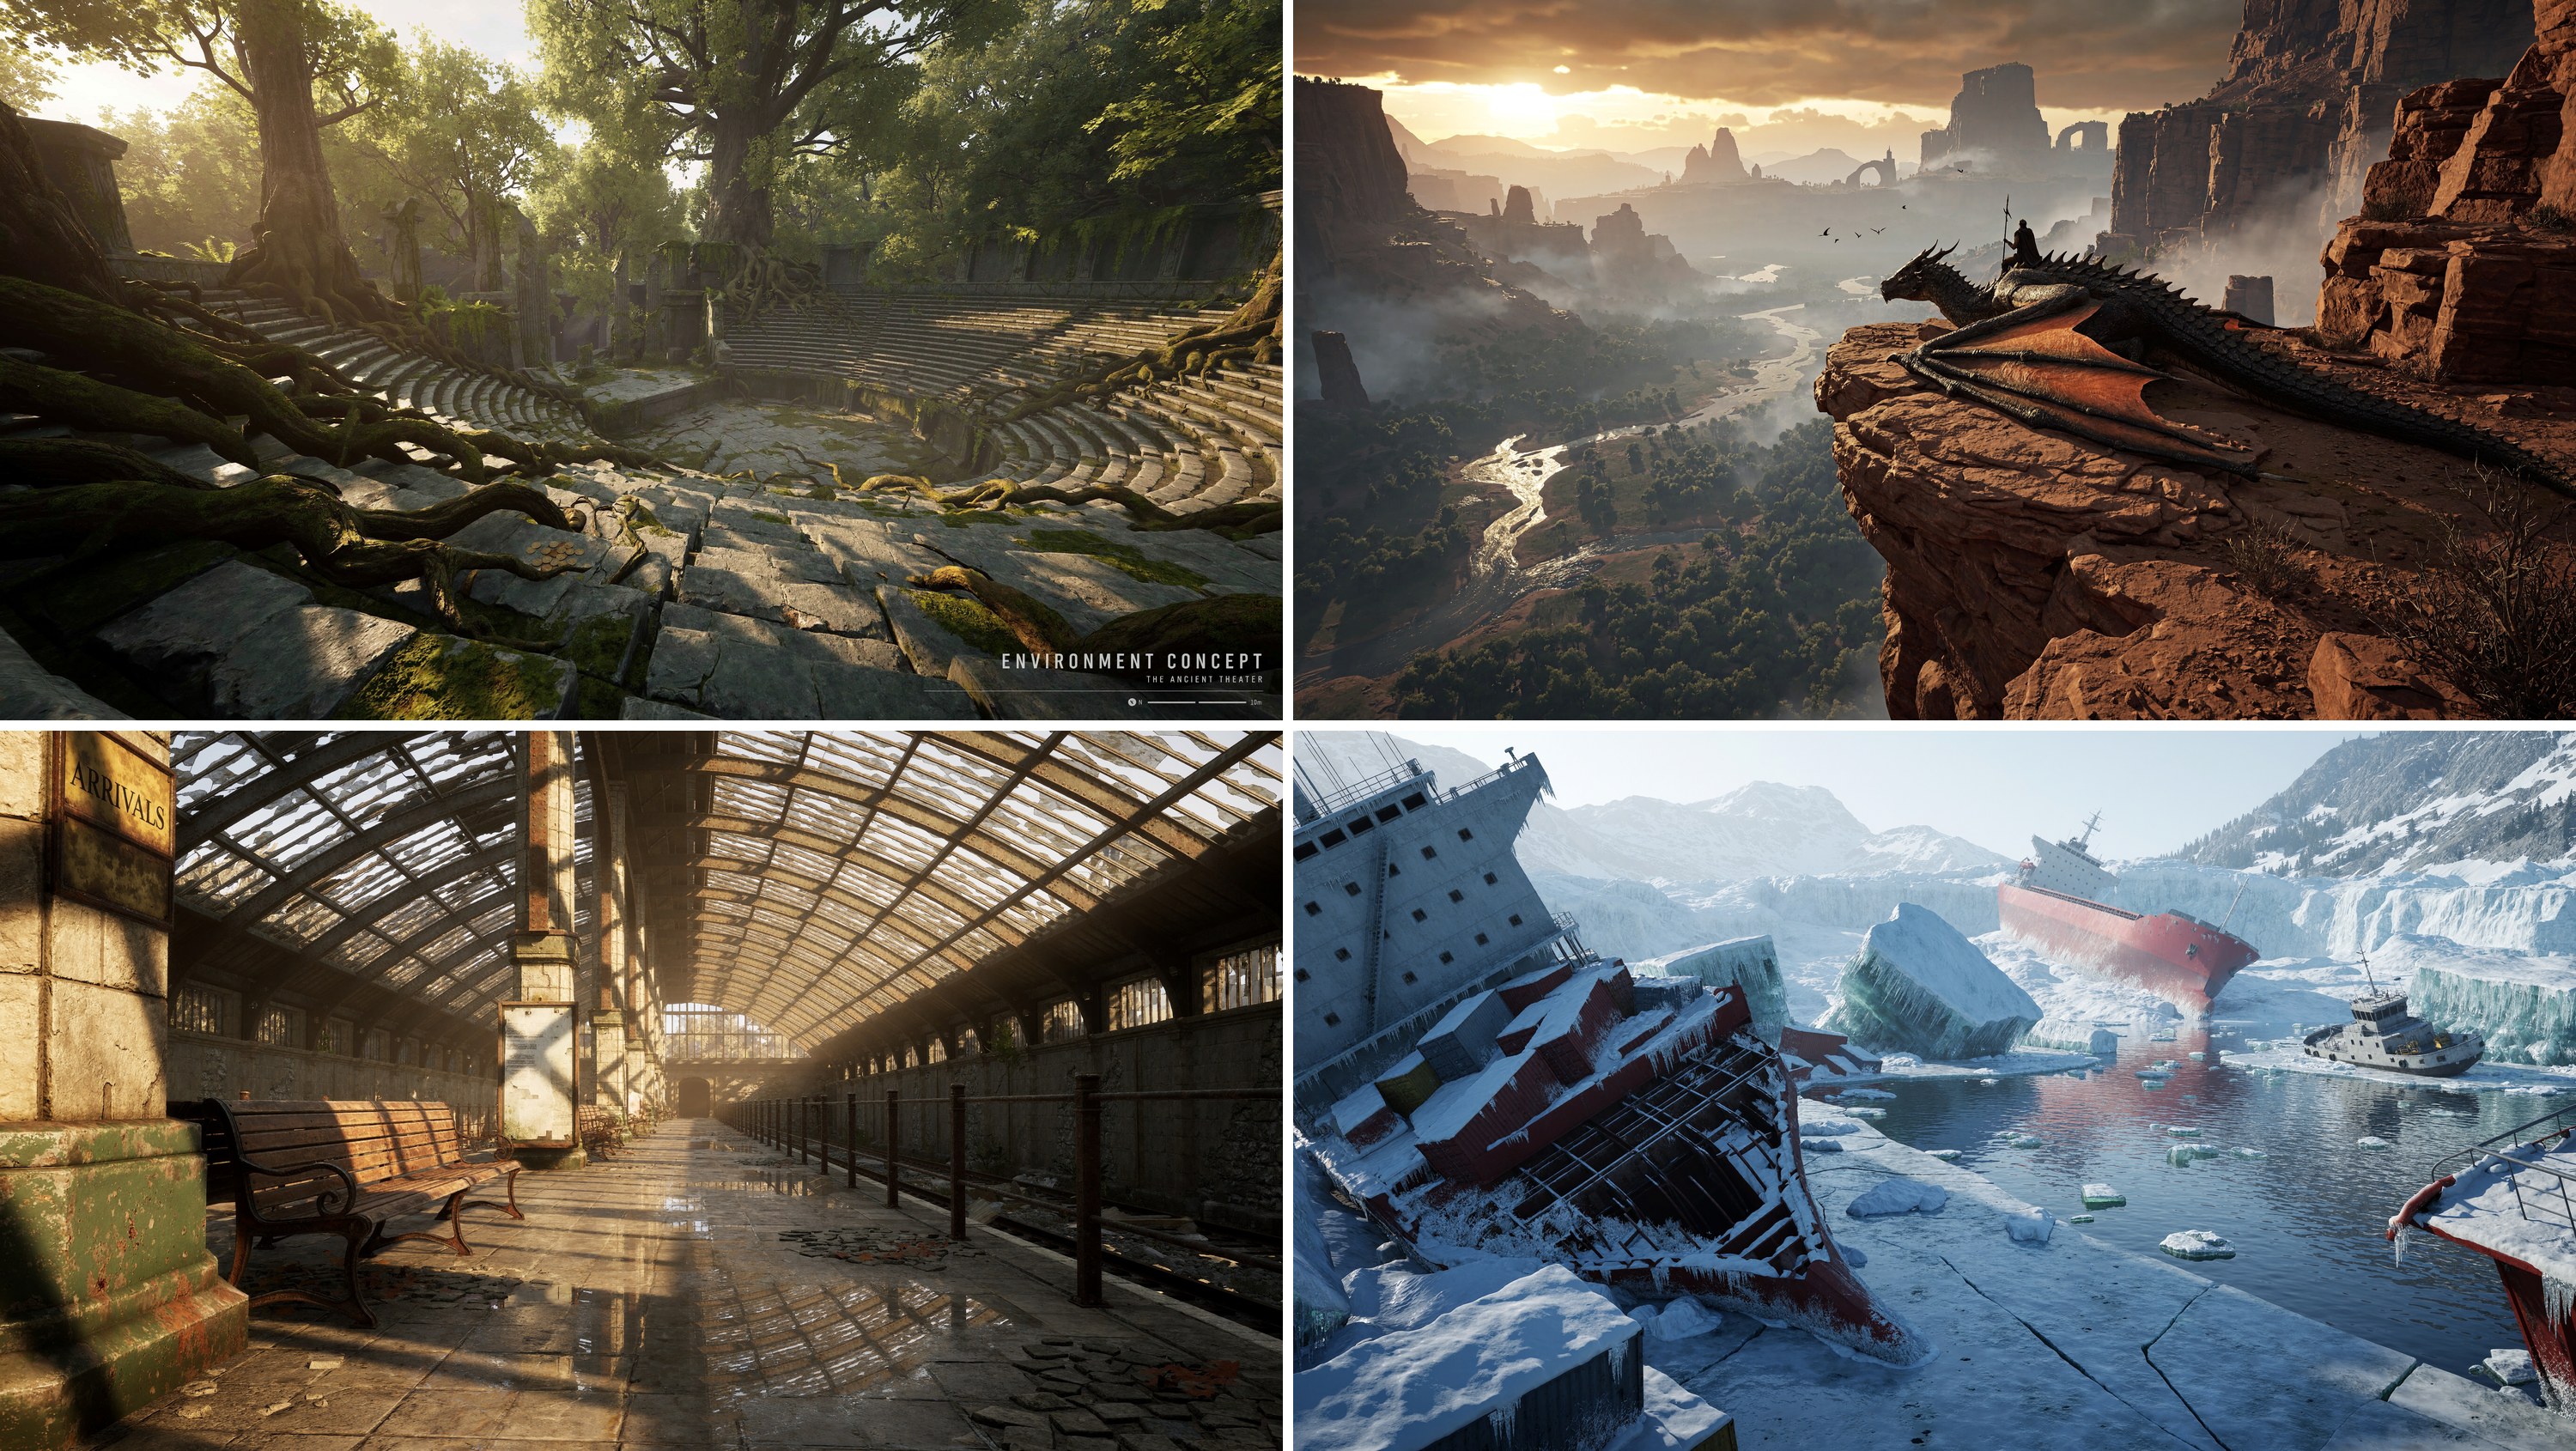
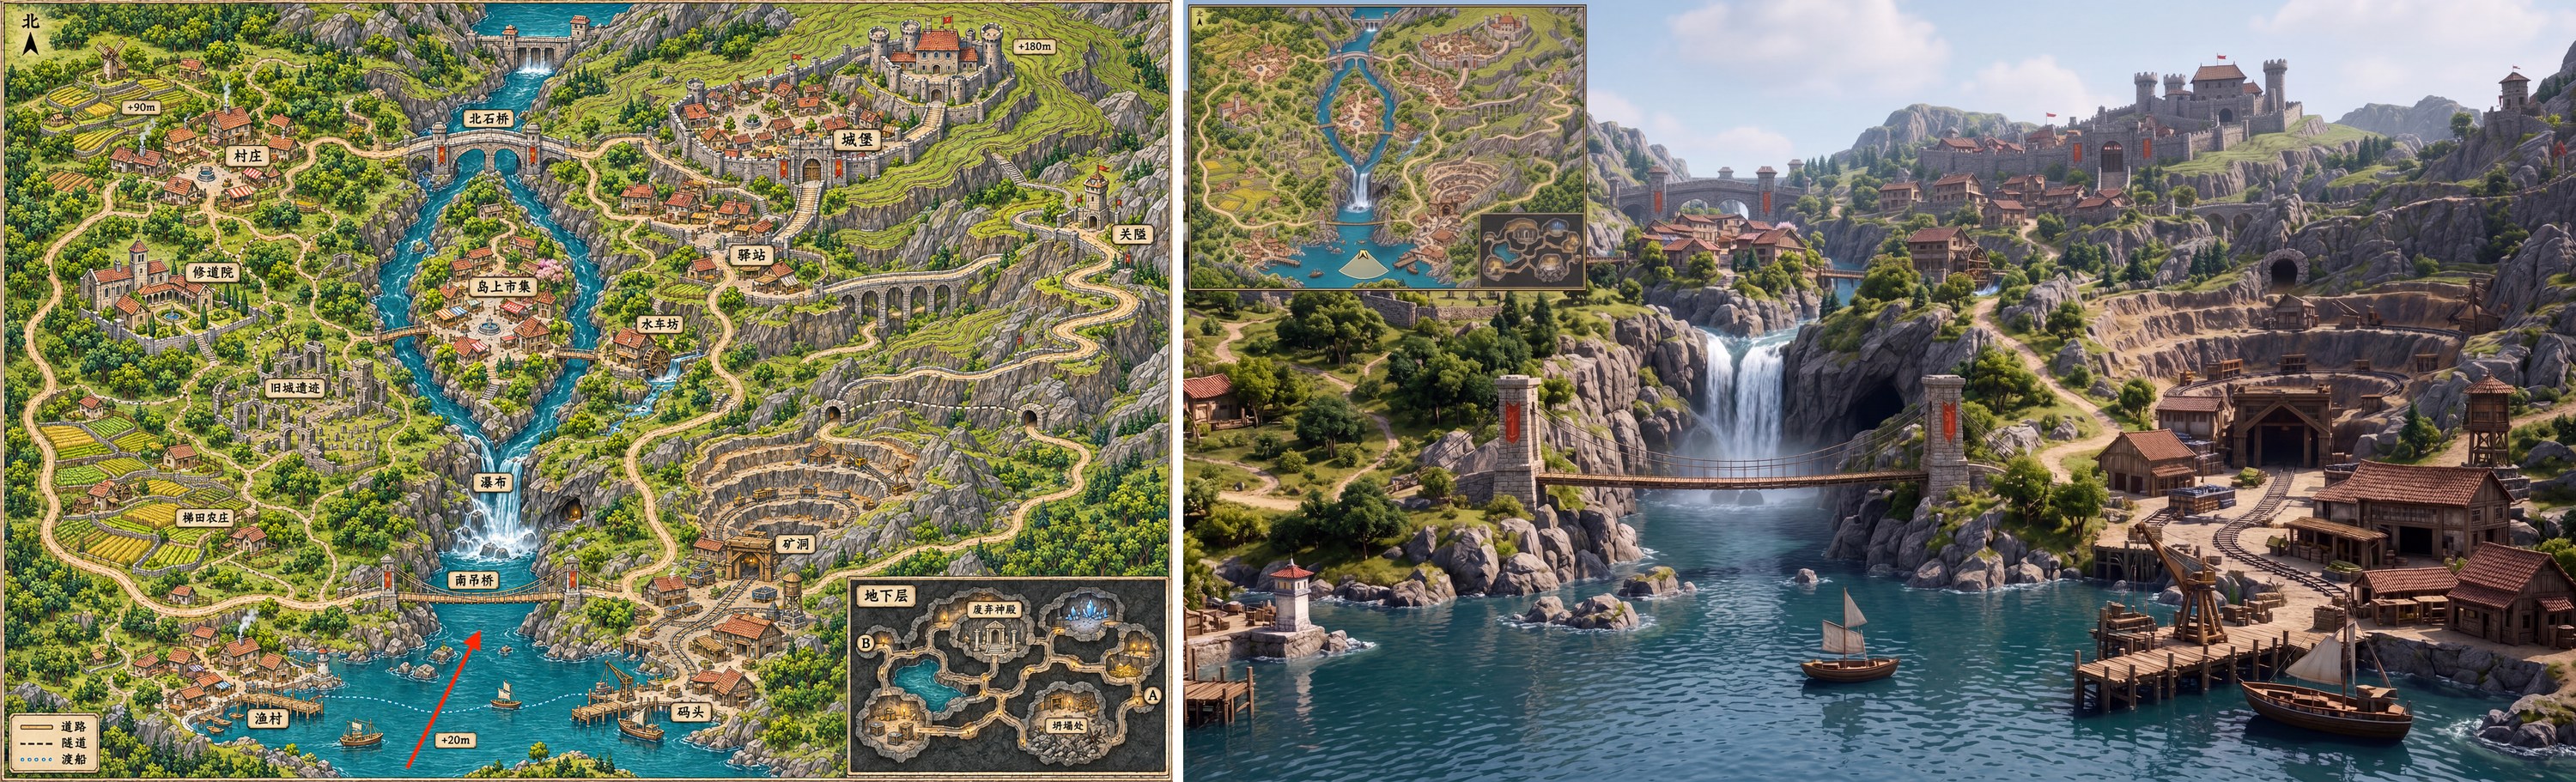
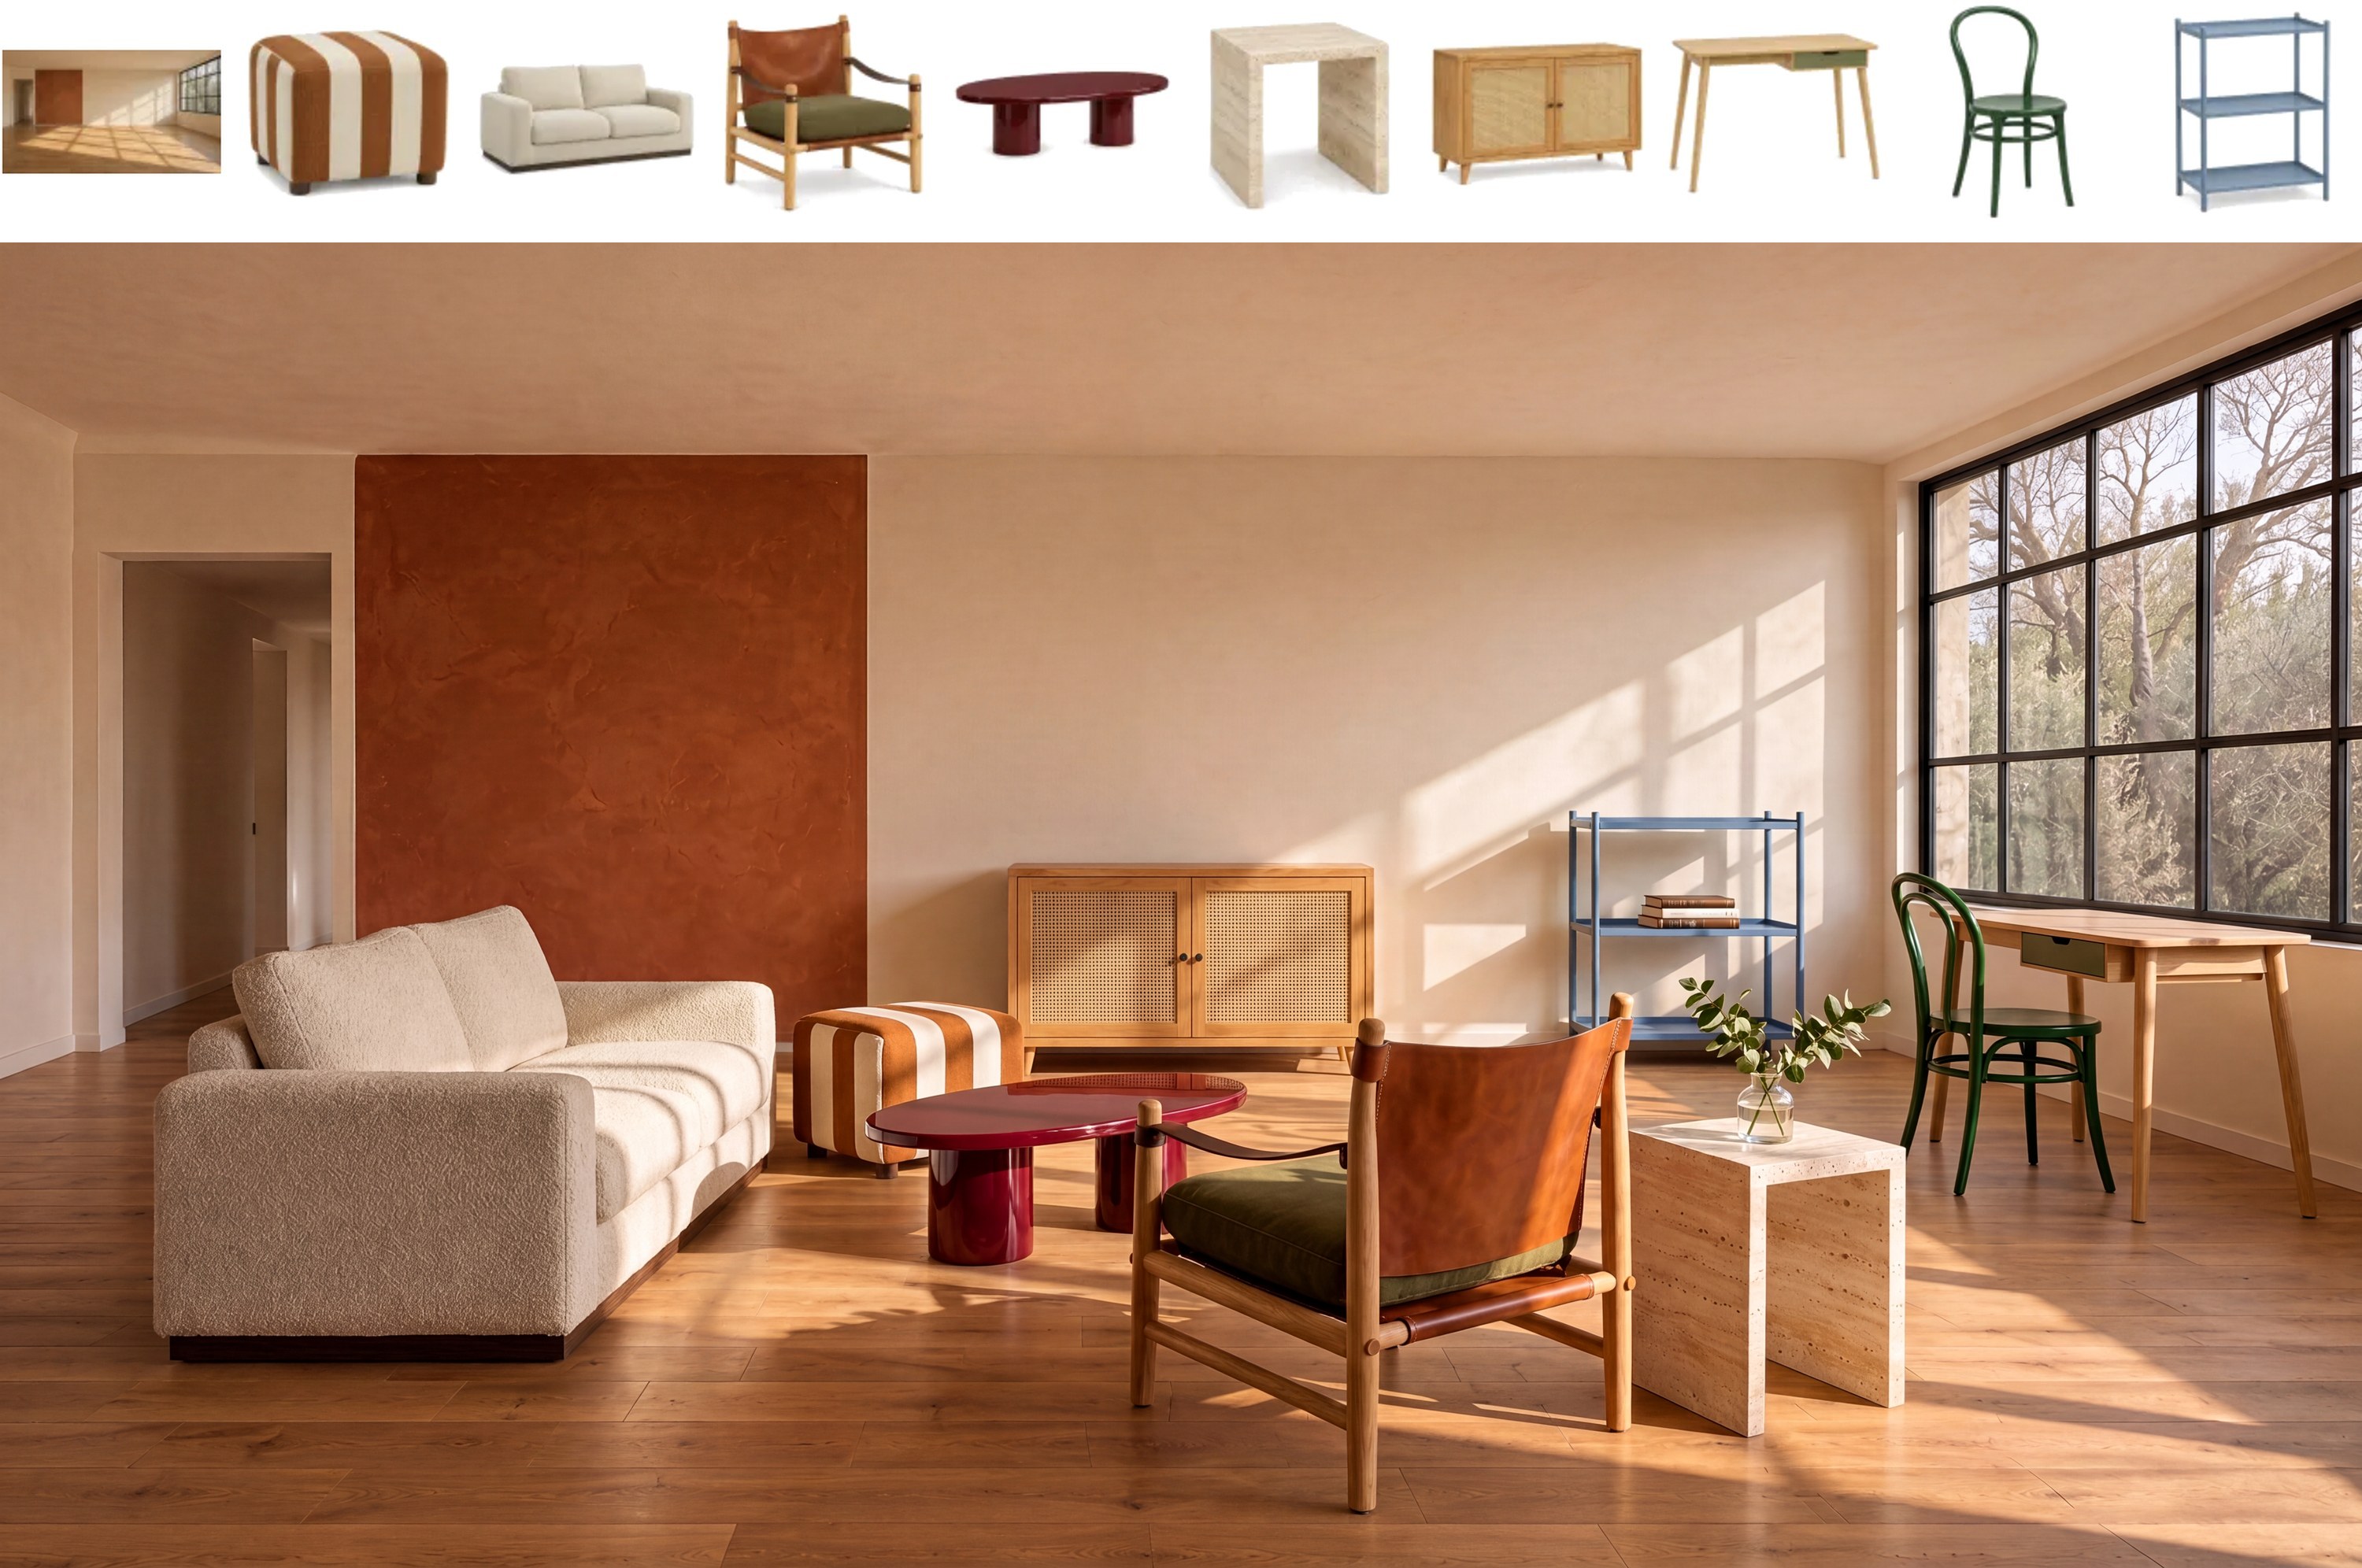
Geração e edição estão no mesmo checkpoint. Você não escolhe entre um modelo de texto-para-imagem e um de edição: é um só, que recebe um prompt e opcionalmente até 16 imagens de referência, endereçadas posicionalmente como <Picture 1>, <Picture 2> no prompt. Cada referência pode receber um papel, tipo “o produto da imagem 1 com a paleta de cores da imagem 2”.
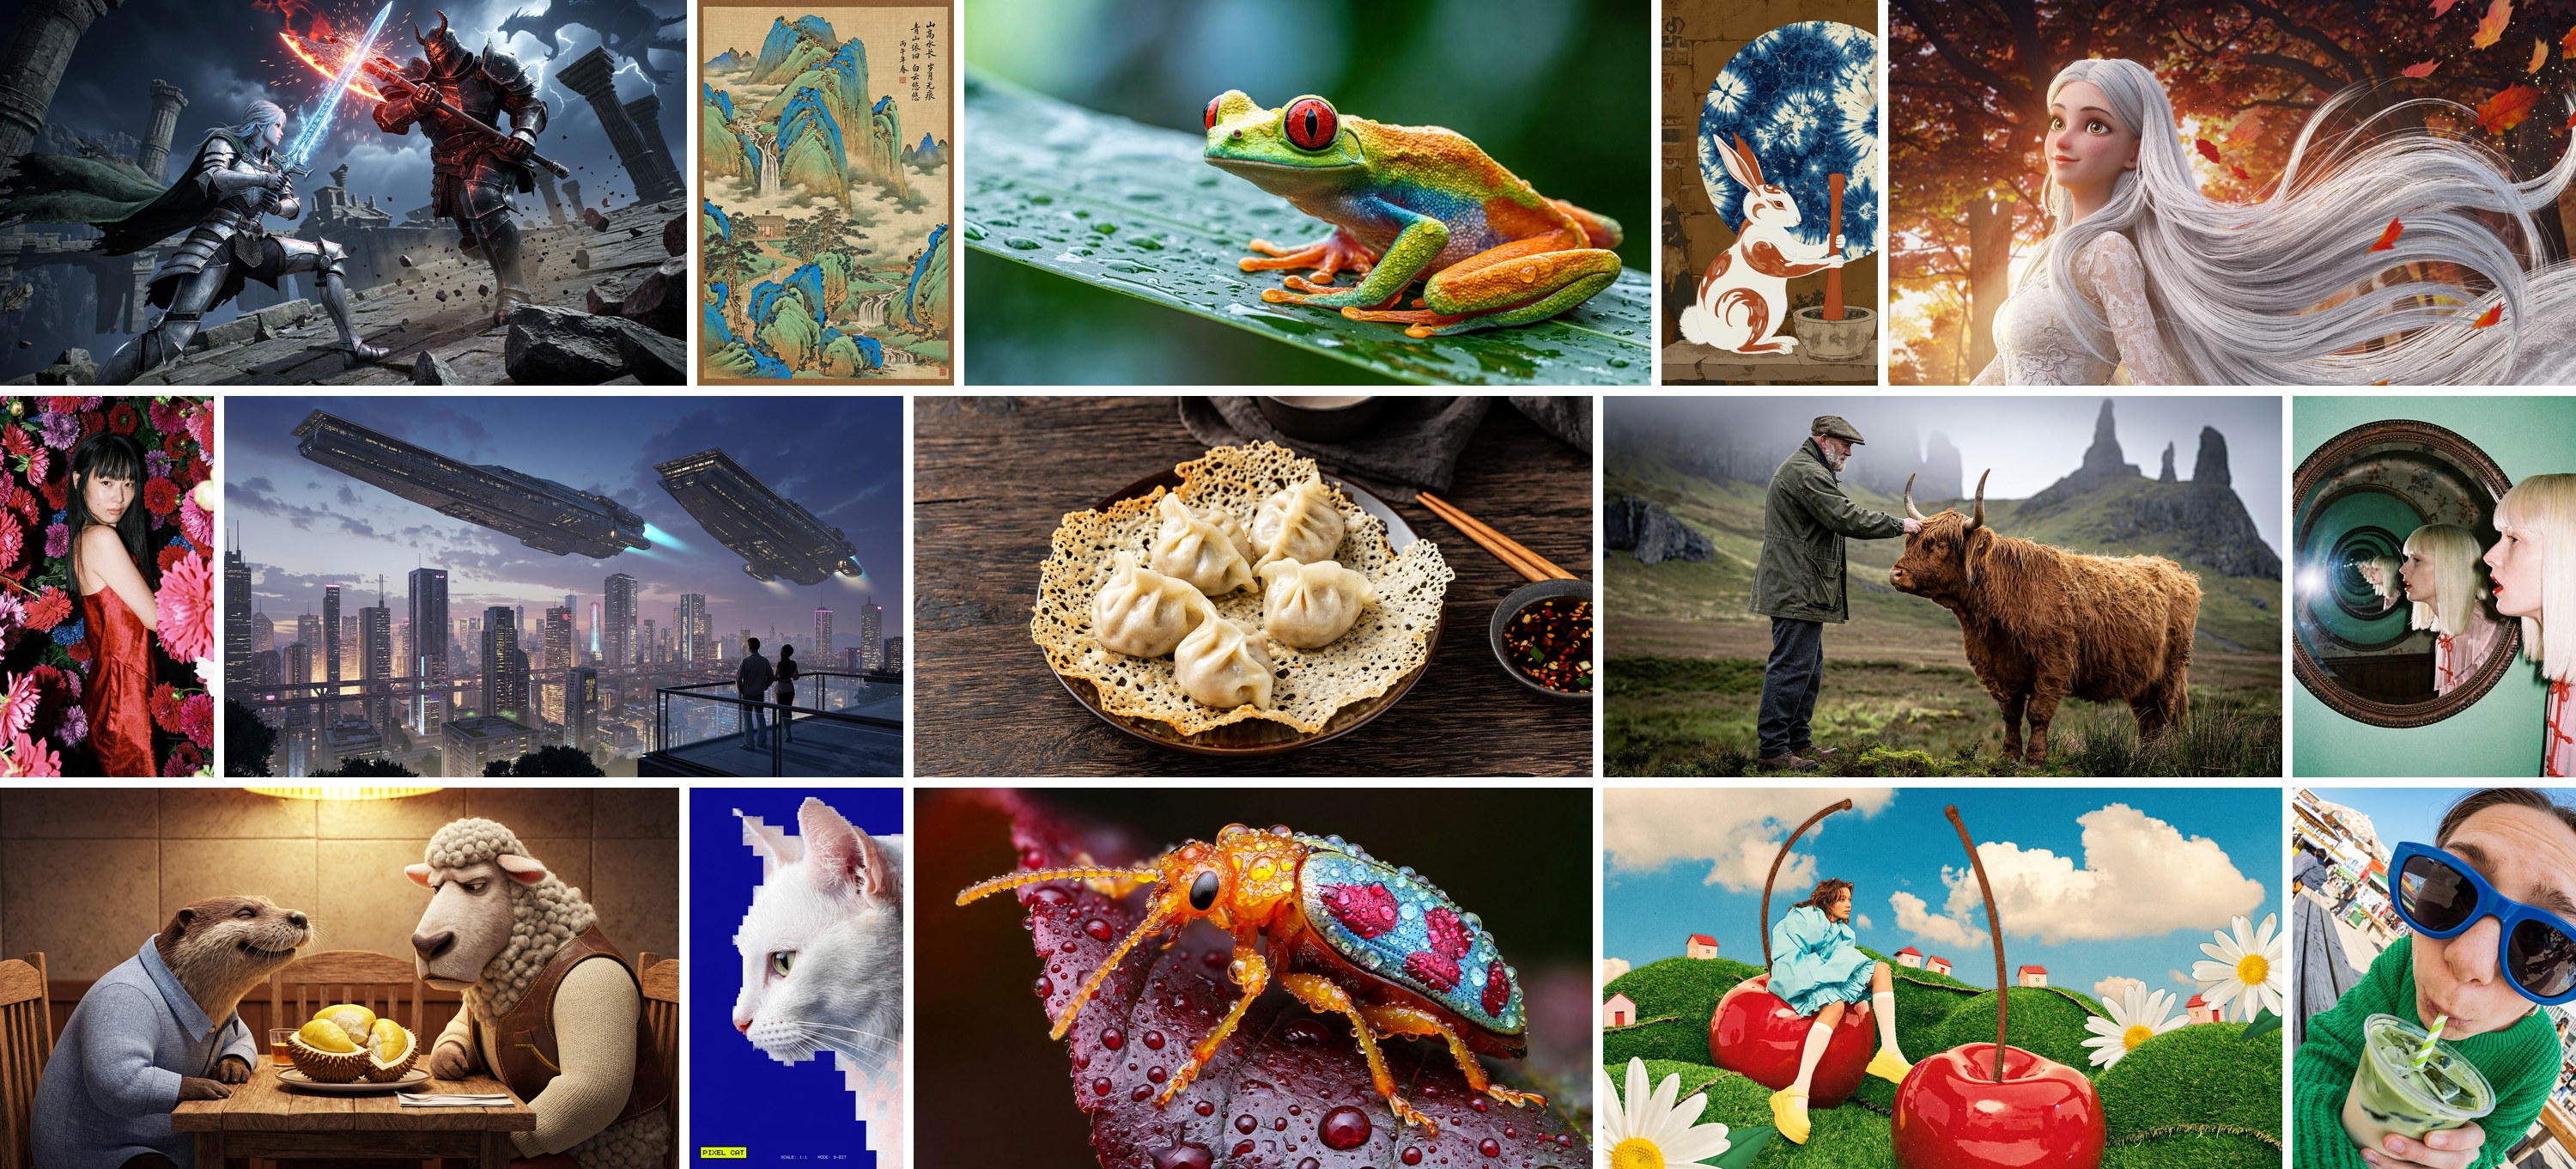
Fotografia
Surreal editorial
Cenarios e personagens em 3D
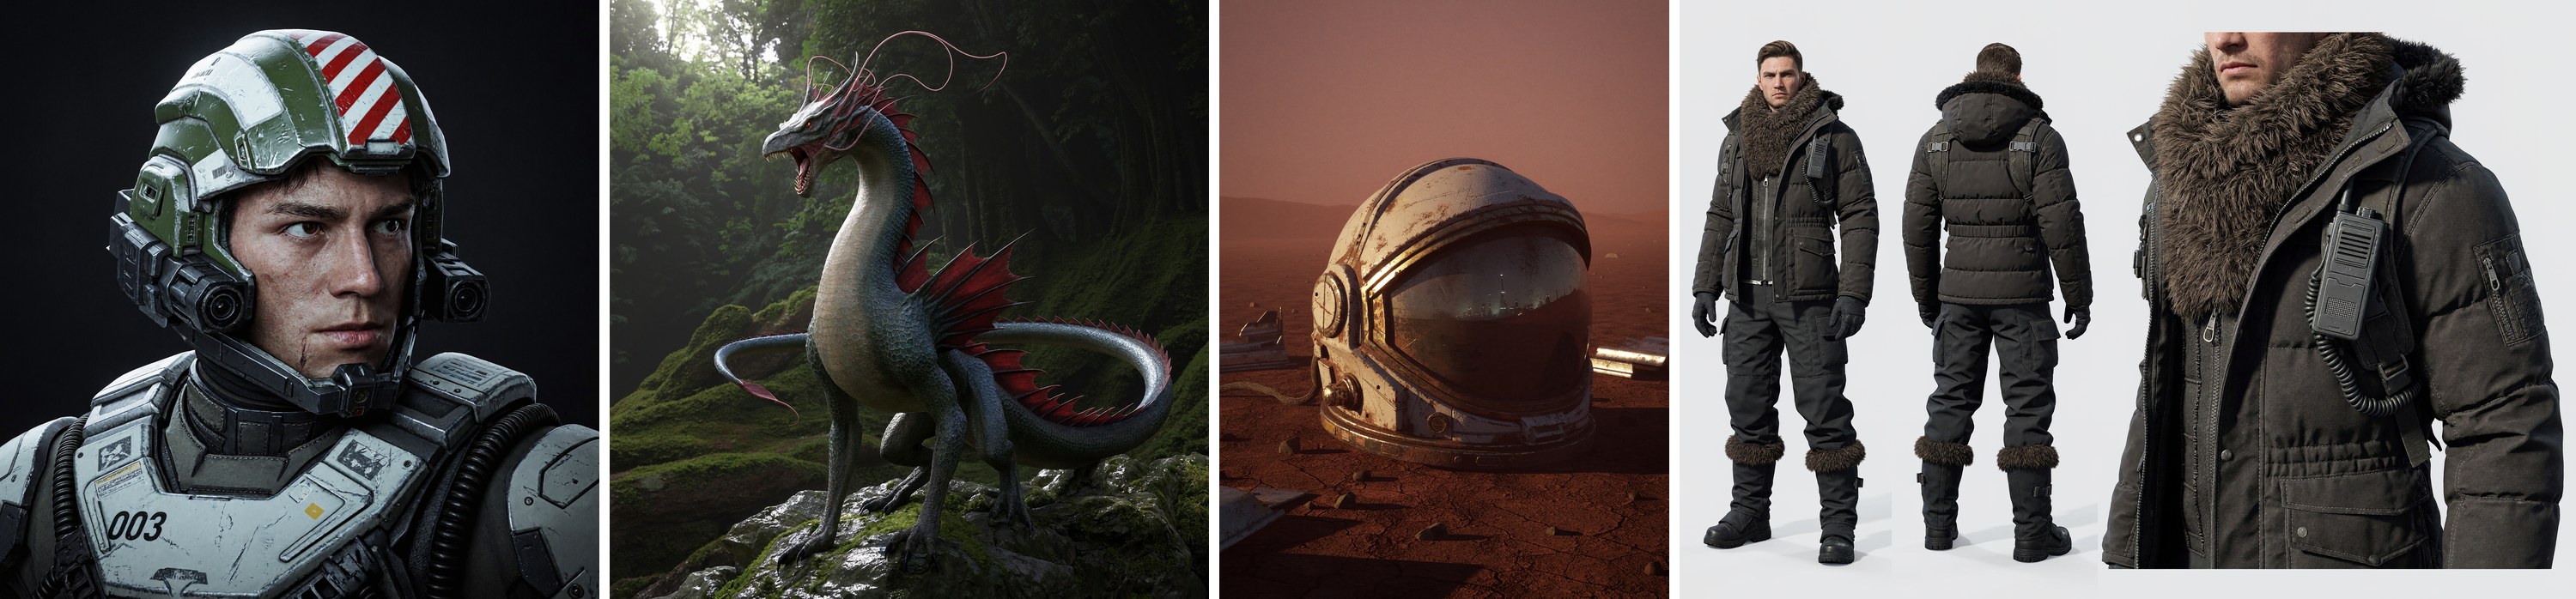
Arte e ilustração
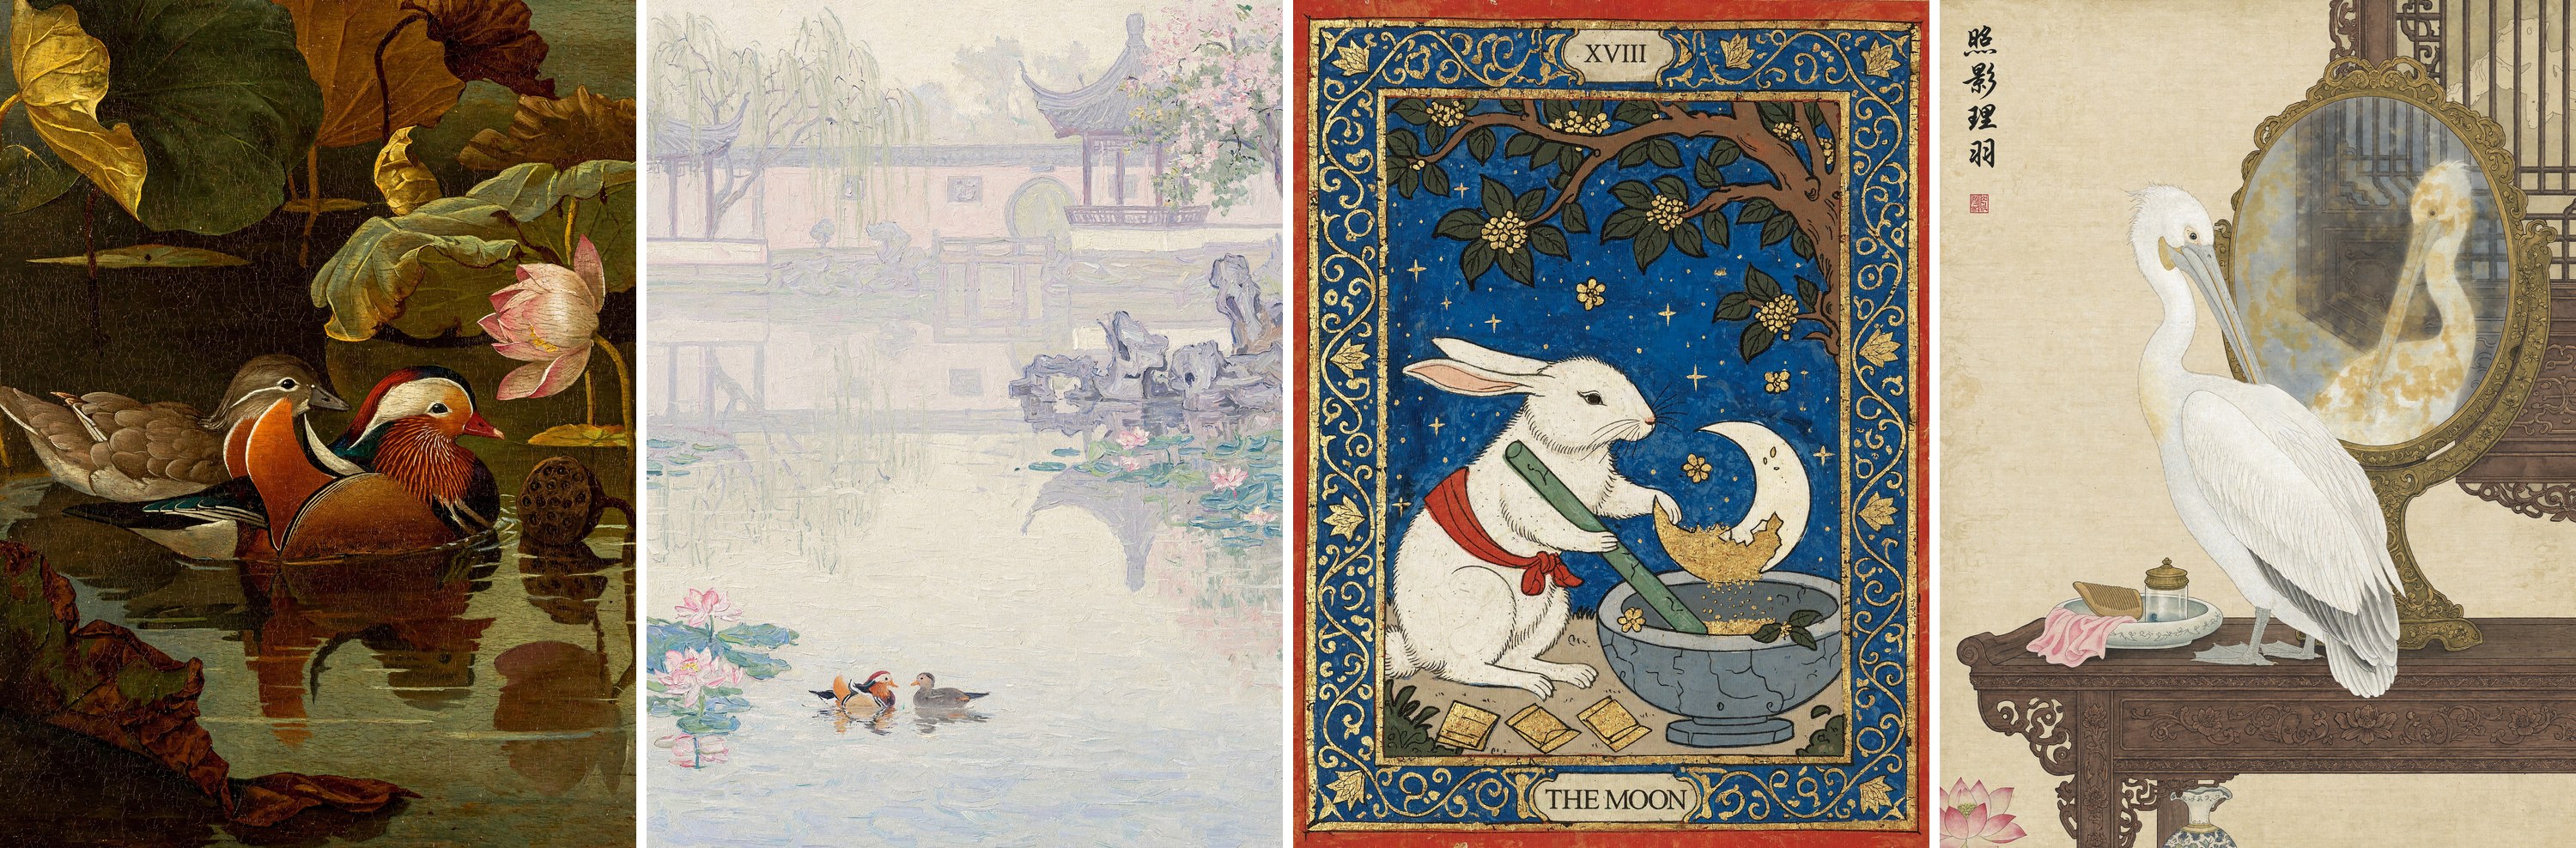
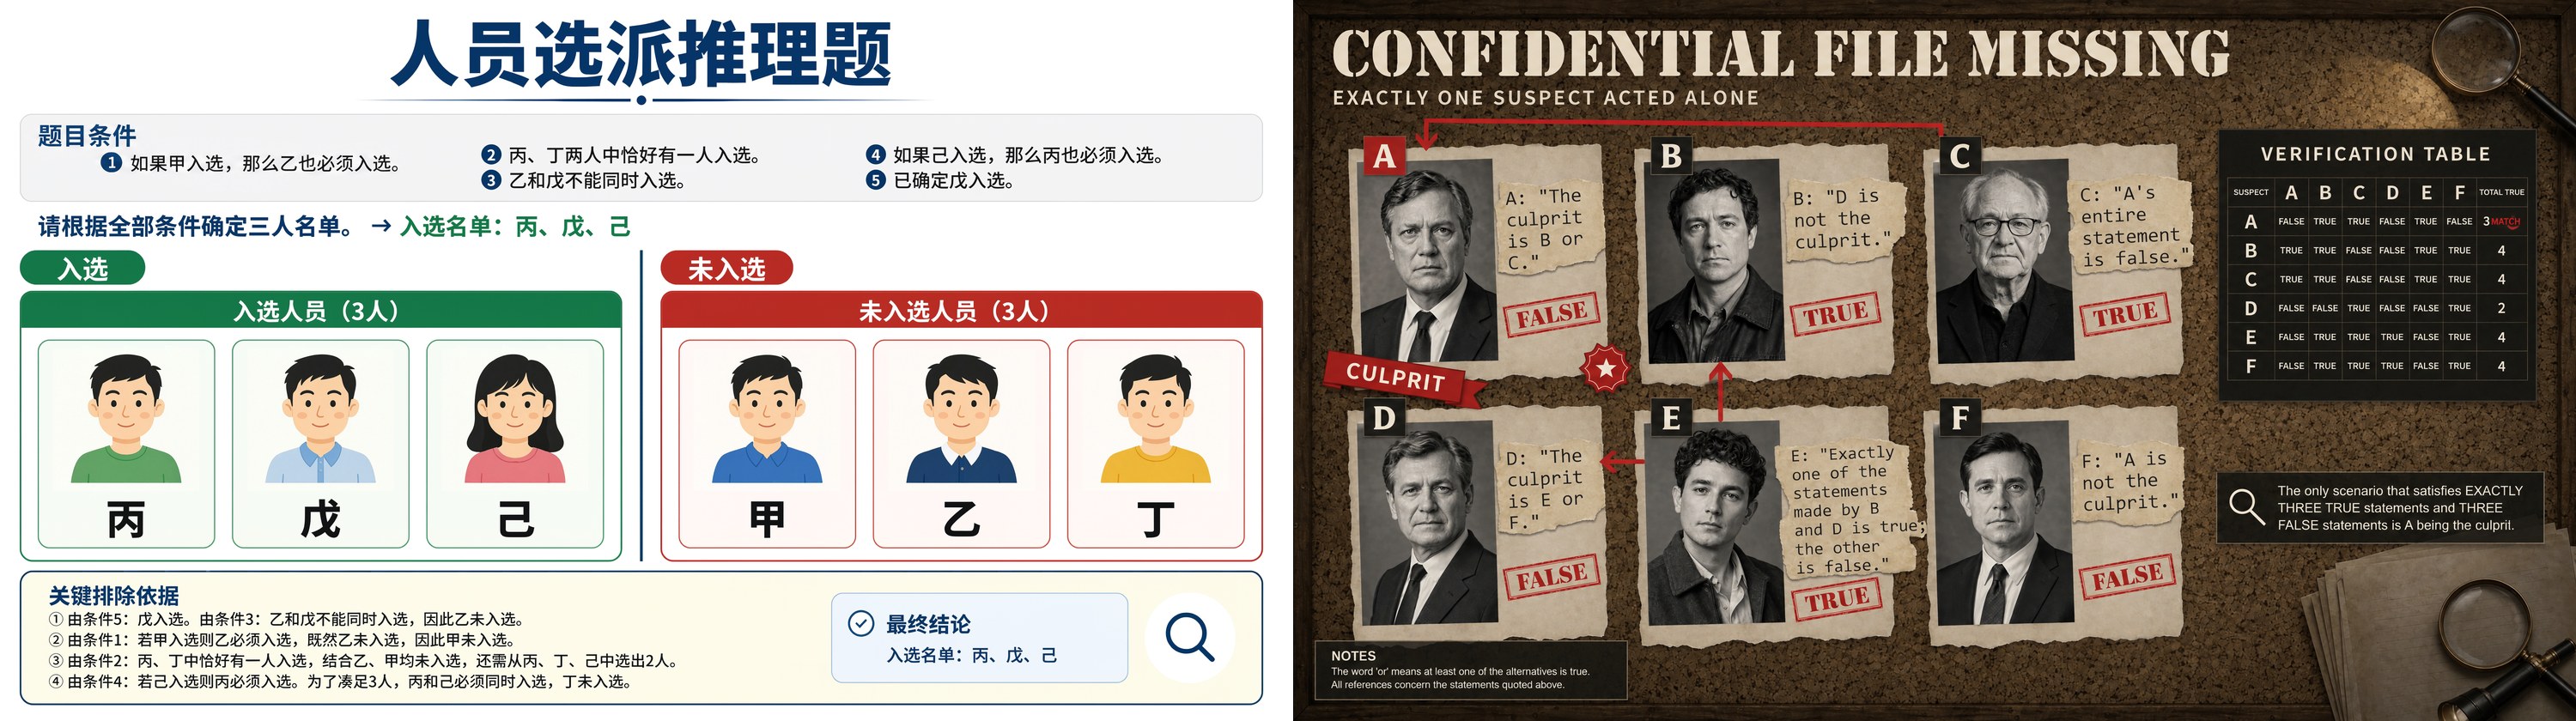
Repare no último bloco: o modelo desenha texto em chinês legível dentro de tabuleiros de lógica. Isso não é comum em geradores de imagem e é o tipo de detalhe que costuma quebrar quando o modelo tenta.
Editar com 10 referências
Este é o argumento mais forte do modelo, porque não é uma demonstração de prompt bonito. A edição parte de referências reais e reconstrói a cena:
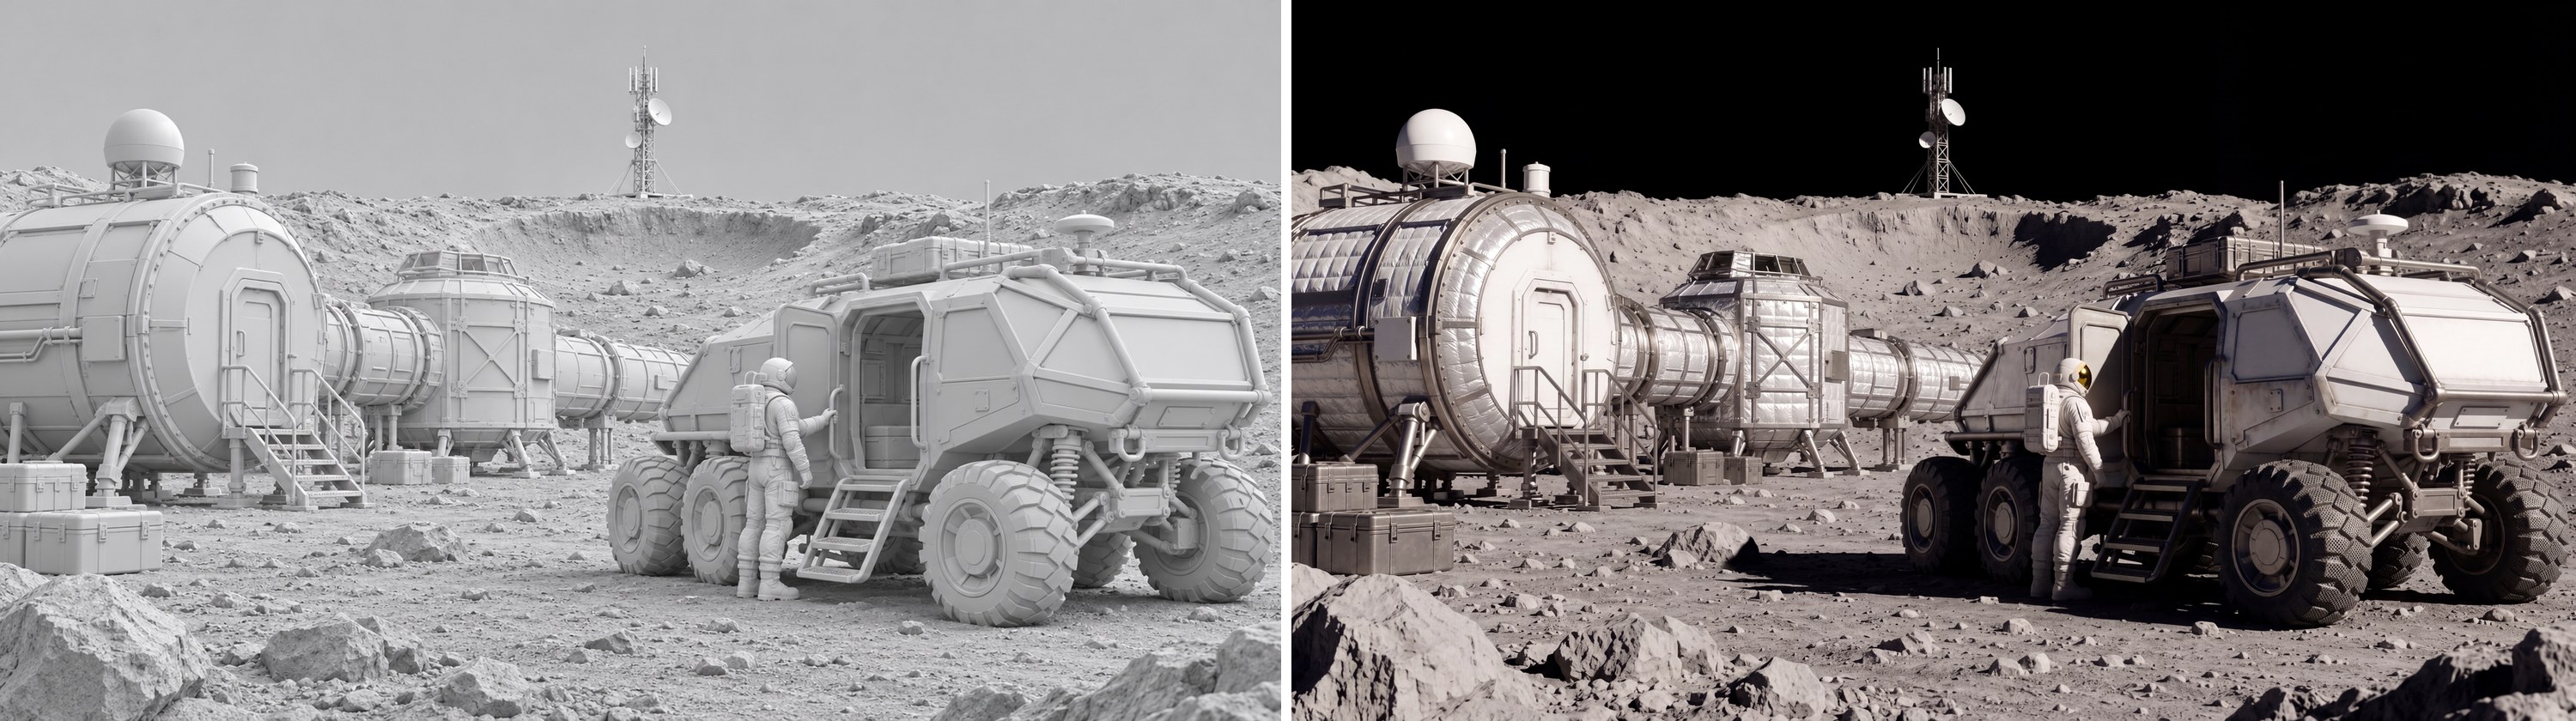
O fluxo real: Context-IR antes do modelo
Um detalhe de arquitetura que muda como você usa o modelo: o H3-Image espera uma descrição detalhada em inglês de toda a imagem. A API do MiniMax converte um prompt curto em qualquer idioma nessa descrição através do H3-Image-Context-IR antes de gerar. O repositório inclui o H3-Image-PE (Prompt Expander) para rodar isso local.
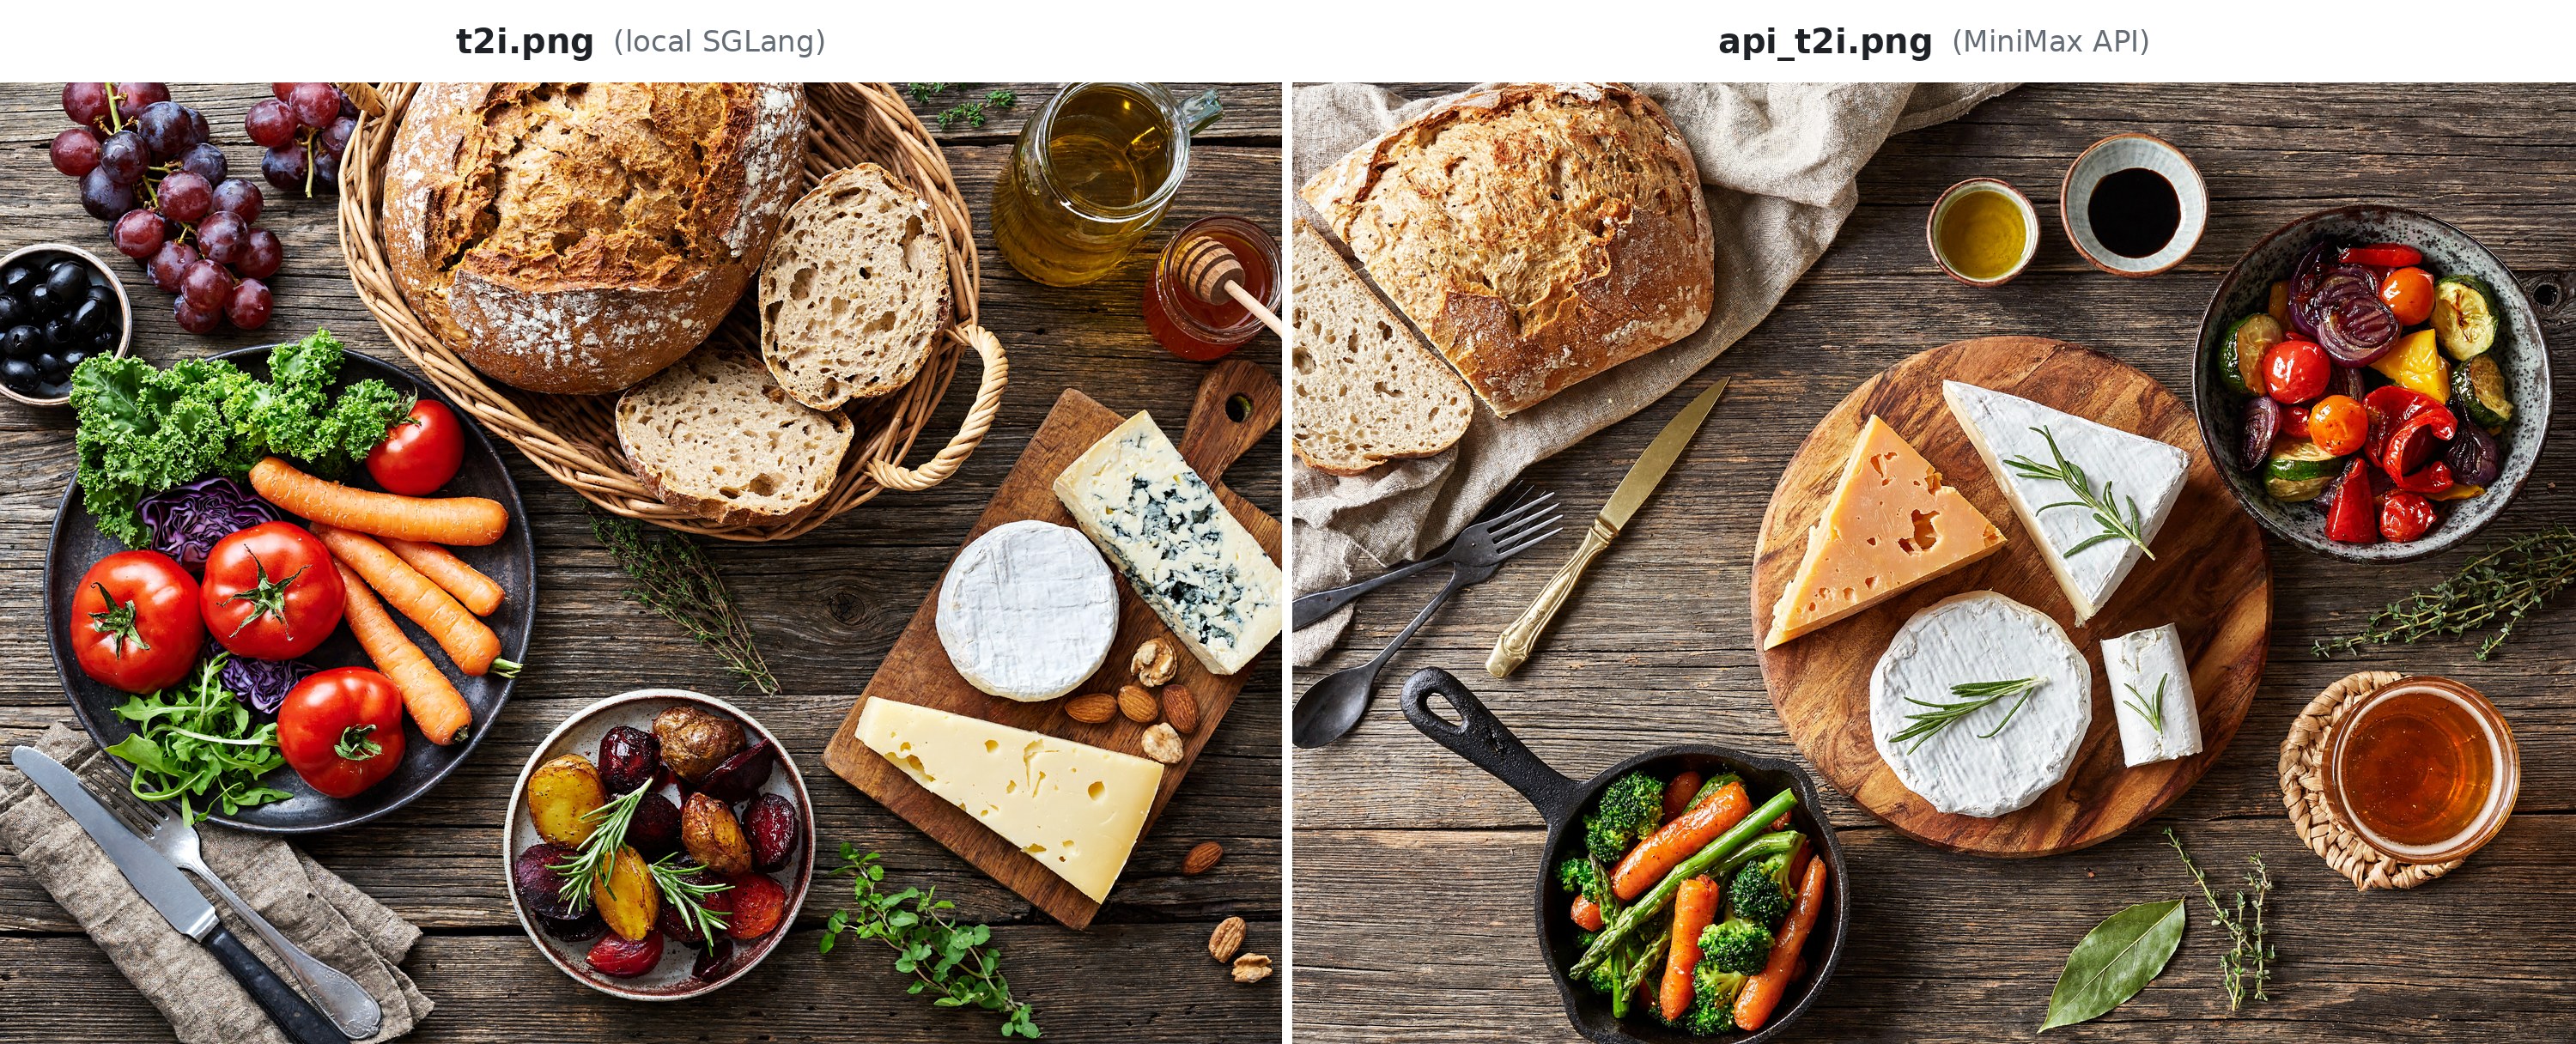
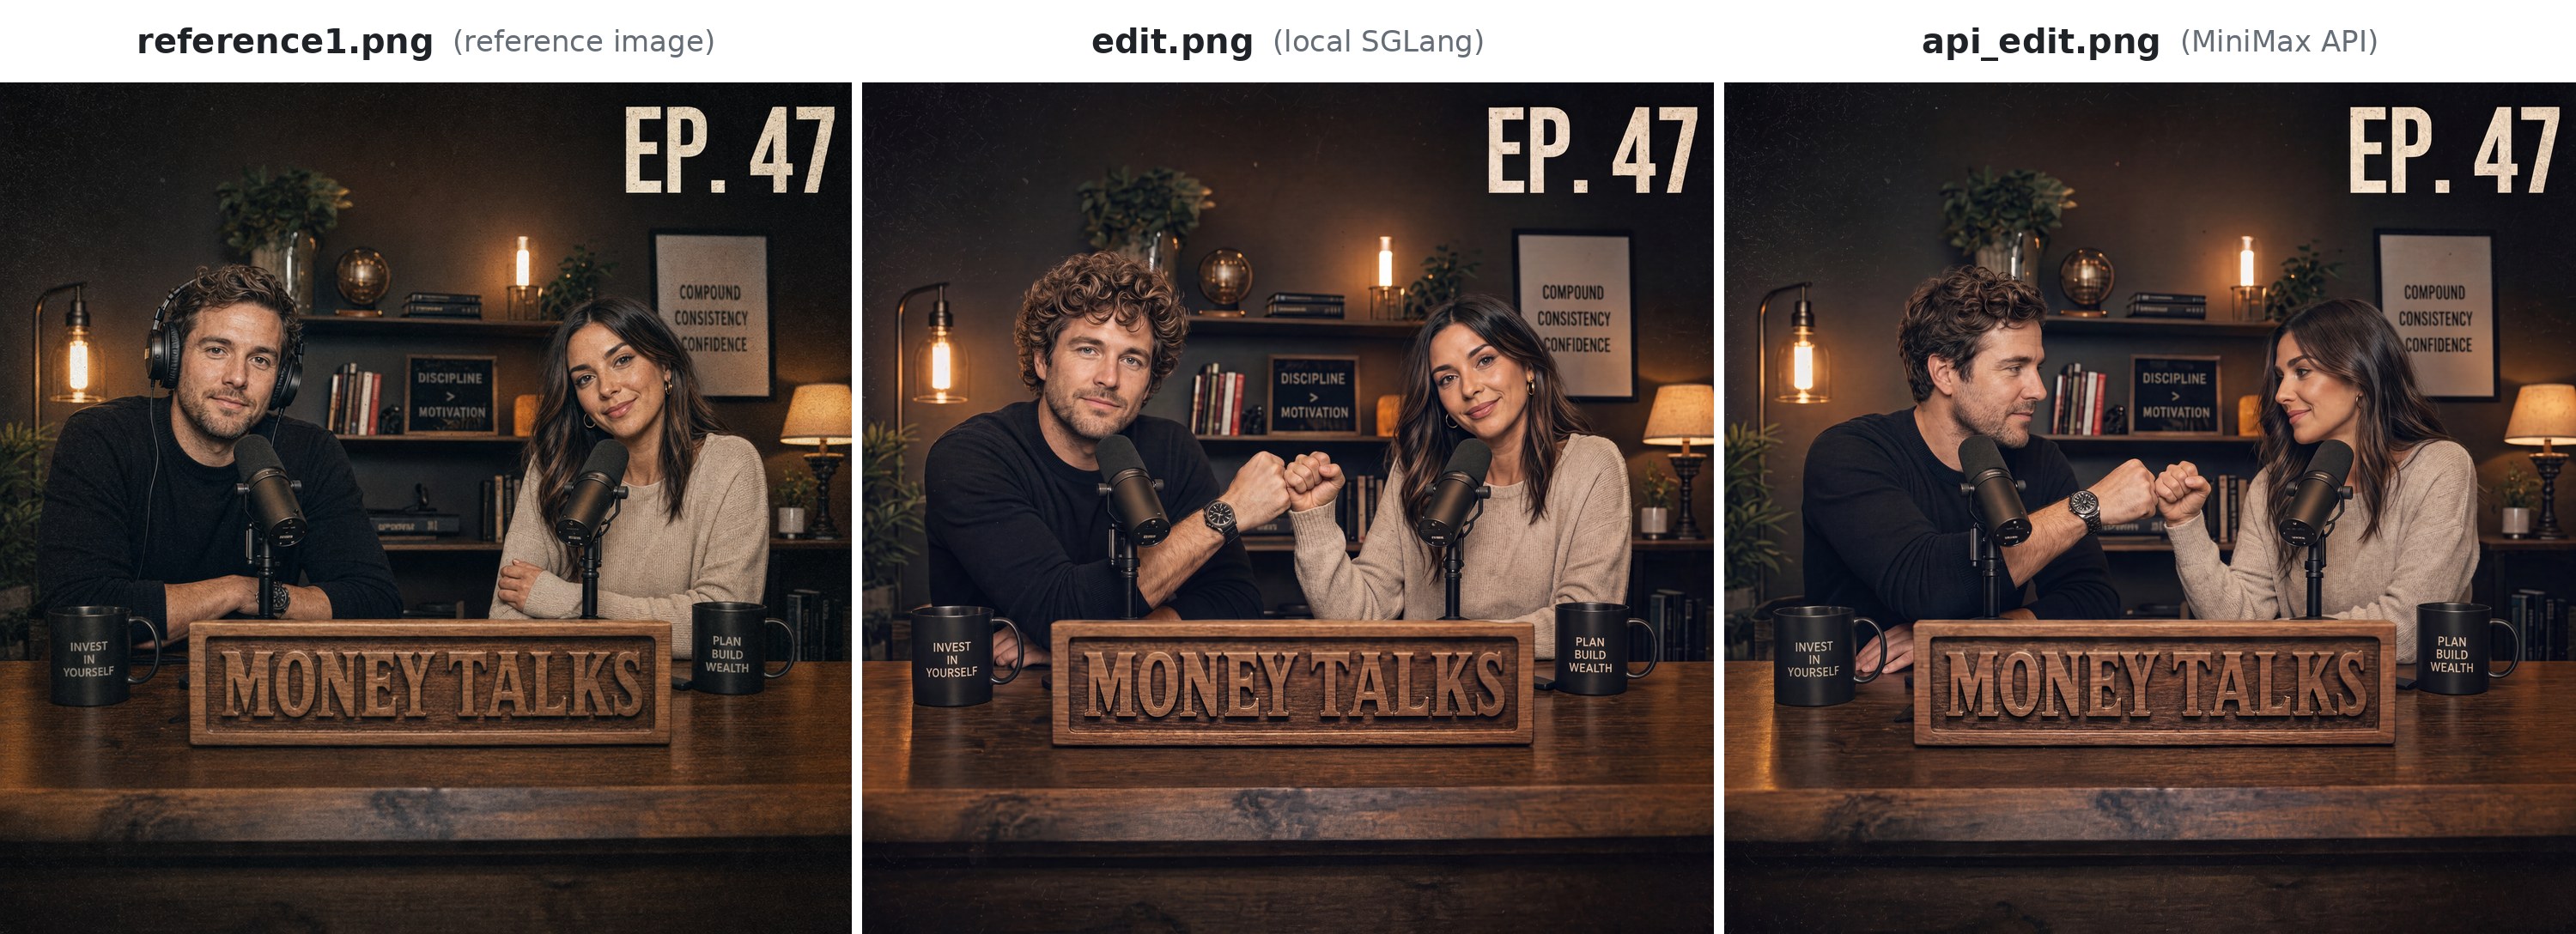
Na prática: se você chama a API com um prompt curto e em português, quem expande é o Context-IR da MiniMax. Se você desliga o enable_prompt_expansion, o prompt vai como está e só os primeiros 4.096 tokens valem, mesmo aceitando até 32.000 caracteres. E na edição o expander é sempre usado.
Resoluções e limites
| Proporção | 16 MP (4K) | 2K |
|---|---|---|
| 1:1 | 4096×4096 | 2048×2048 |
| 4:3 / 3:4 | 4736×3552 / 3552×4736 | 2368×1760 / 1760×2368 |
| 3:2 / 2:3 | 5024×3360 / 3360×5024 | n/d |
| 16:9 / 9:16 | 5472×3072 / 3072×5472 | 2720×1536 |
| 21:9 | 6272×2688 | n/d |
- Faixa de trabalho útil: 4 a 20 megapixels, com melhores resultados por volta de 16 MP. A API aceita saída de 655.360 a 20.000.000 de pixels, proporção entre 1:3 e 3:1.
- Sem upscaler no caminho. O tamanho sai exatamente como pedido, sem arredondar.
- 1 a 10 imagens por requisição, com padrão de 1.
- Formatos de saída: jpeg (padrão), png, webp. Resposta em url (padrão) ou b64_json.
- Não suporta: preview, edição com máscara, fundo transparente.
- Parâmetros travados:
num_inference_stepsem 6,guidance_scaleem 1. Qualquer outro valor dá HTTP 400.negative_prompté rejeitado. - Prompt: até 32.000 caracteres, com apenas ~4.096 tokens efetivos se a expansão estiver desligada.
- Links expiram em 24 horas. Guarde o arquivo se for usar depois.
Perguntas frequentes (FAQ)
Posso usar o MiniMax H3-Image no Brasil?
Sim. A licença exclui a União Europeia, o Reino Unido, a Coreia do Sul e os Estados Unidos. O Brasil está fora da lista de territórios excluídos, então uso pessoal, comercial e redistribuição são permitidos dentro das regras do contrato. Isso muda se você publica conteúdo para audiência na UE ou nos EUA, porque as saídas do modelo também não podem ser exibidas nesses territórios.
O H3-Image é open source de verdade?
Não. É open-weight com licença comunitária própria, o que é uma categoria diferente. Você pode baixar e rodar os pesos, mas a licença impõe restrição territorial, exige autorização escrita acima de US$ 1 milhão de receita anual, proíbe usar as saídas para treinar outro modelo, exige exibir “MiniMax-H3-Image” na interface de produtos comerciais e obriga a entregar a licença e um arquivo NOTICE a quem redistribuir. Não é MIT nem Apache.
Por que 6 passos de amostragem e guidance fixo em 1?
É destilação. O checkpoint foi destilado para 6 NFEs sem classifier-free guidance, e é isso que torna 10,3 segundos em 4K possível. A API trava os dois parâmetros: qualquer valor diferente de 6 em num_inference_steps ou diferente de 1 em guidance_scale devolve HTTP 400, e negative_prompt é rejeitado. A contrapartida é menos liberdade do modelo para corrigir os próprios erros durante a amostragem, algo que costuma aparecer em detalhes finos de textura.
Quanto custa gerar 1000 imagens 4K?
US$ 68,79 no Standard com a tabela cheia, ou US$ 34,39 com o desconto de 50% da semana de lançamento. No Highspeed, US$ 130,01 ou US$ 65,01 com desconto. Para comparação, o Google Nano Banana 2.1 fica em torno de US$ 113 por mil imagens 4K. Atenção: o desconto expira em 17 de novembro de 2026 às 16:00 UTC e só se aplica a saídas com 16,6 milhões de pixels ou mais, ou seja, só em 4K de verdade.
Dá para rodar o H3-Image em uma GPU de consumo?
Tecnicamente dá para carregar os pesos, mas não é prático. São 68,65 GB do DiT em BF16 mais 66,7 GB do text encoder Qwen3-VL, que vem de outro repositório, somando cerca de 135 GB de download. O guia da MiniMax cita H200, RTX PRO 6000 Blackwell e AMD Instinct MI350X, e o caminho de baixa latência é sequence parallelism com 4 GPUs. Se o seu objetivo é economia, a API a US$ 0,02179 por imagem 1K é mais barata que a conta de luz por muito tempo.
O que é o H3-Image-Context-IR e por que importa?
O modelo espera uma descrição detalhada em inglês de toda a imagem. O Context-IR é o módulo que transforma um prompt curto em qualquer idioma nessa descrição antes da geração, e ele está disponível como endpoint próprio (POST /v1/h3_image_context_ir) e como modelo local separado (MiniMax-H3-Image-PE, 17,9 GB em NVFP4). Se você desligar a expansão de prompt, só os primeiros 4.096 tokens do prompt valem, mesmo aceitando 32.000 caracteres.
O modelo faz upscale ou gera 4K nativo?
Gera nativo. Não há upscaler no caminho. A saída sai exatamente no tamanho pedido, entre 655.360 e 20.000.000 de pixels, com proporção entre 1:3 e 3:1, e nunca é arredondada ou redimensionada. A faixa de trabalho útil é de 4 a 20 megapixels, com melhores resultados por volta de 16 MP.
Existe algum benchmark de qualidade publicado?
Não. O model card afirma “o melhor seguimento de instrução entre modelos open-source” sem anexar tabela nenhuma. Não há GenEval, DPG-Bench, números de preferência humana nem entrada nos rankings de imagem do Artificial Analysis. A única evidência de qualidade existente é a galeria do próprio fabricante. Os números de latência e preço são self-reported, e a latência se refere ao serviço hospedado, não a hardware local.
Qual a pegadinha operacional da API?
Os endpoints de imagem não são idempotentes. Se a requisição dá timeout, ela foi gerada e foi cobrada normalmente. Um retry automático do SDK cobra de novo. A documentação recomenda desligar o retry automático, e num trabalho pago em imagens isso pesa mais que qualquer desconto. E os links das URLs de resposta expiram em 24 horas, então baixe o arquivo se for usar depois.
O que isso significa
- A MiniMax atacou o ponto certo. Todo mundo competia em qualidade perceptual; ninguém tinha aberto o jogo da latência em 4K. Publicar um gráfico com P50 contra o Nano Banana 2.1, o GPT-image 2.5, o GPT-image 2.6 e o Seedream 5 Pro na mesma resolução é uma escolha de guerra, e o Highspeed a 10,3s em 4K é um número que dá para verificar numa tarde.
- Se a velocidade for real, 4K deixa de ser pipeline de batch. US$ 0,06879 por imagem 4K muda a conta de catálogos de e-commerce, fundos de print e variações de anúncio. Você itera em 4K, não em 1K, e deixa o upscaler fora da discussão. Esse é o efeito prático maior do lançamento, e ele depende inteiramente da latência se sustentar fora do serviço da MiniMax.
- A escada de preço é a parte mais subestimada. 16 vezes mais pixels por 3,16 vezes mais dinheiro é o que torna a coisa viável. Se a MiniMax tivesse cobrado proporcional ao pixel, o 4K sairia a US$ 0,35 e ninguém usaria.
- Open-weight com trava territorial não é open source. A licença proíbe UE, Reino Unido, Coreia do Sul e Estados Unidos, e isso inclui as saídas, não só os pesos. Para um modelo que se apresenta como “para sustentar a pesquisa aberta”, a restrição é de outro mundo. A MiniMax vai chamar isso de conformidade regulatoria; a leitura prática é que metade do mercado do Occidente não pode tocar no modelo.
- Não existe benchmark de qualidade. Nenhum. O model card diz “o melhor seguimento de instrução entre modelos open-source” e não anexa tabela nenhuma. Não há GenEval, não há DPG-Bench, não há preferência humana, não há entrada nos rankings de imagem do Artificial Analysis. O único lugar onde há evidência de qualidade é a galeria do próprio fabricante, que é exatamente o tipo de evidência desenhada para parecer boa. O modelo pode ser excelente e a única coisa que existe hoje é a promessa da empresa sobre o próprio produto.
- 6 passos de amostragem é uma faca de dois gumes. É o que torna 10,3s em 4K possível, e é também a escolha que costuma dar para o modelo menos liberdade para corrigir os próprios erros. Quem vier do Flux ou do SDXL vai sentir a diferença de “guidance” fino, porque ele não existe:
guidance_scaletravado em 1 é a assinatura da destilação. - O desconto de 50% acaba em seis dias. Ele vale só para saídas com 16,6 milhões de pixels ou mais, ou seja, só para 4K real, e expira em 17 de novembro de 2026 às 16:00 UTC. Quem orça pipeline em US$ 0,03439 está orçando uma promoção. Some com isso antes de fechar a planilha.
Onde usar
- API:
POST /v1/images/generations(texto-para-imagem) ePOST /v1/images/edits(edição, multipart com as referências). Variante rápida trocandomodelparaMiniMax-H3-Image-Highspeed. - Context-IR:
POST /v1/h3_image_context_irpara expandir o prompt antes de gerar. - Apps: Hailuo AI (hailuoai.video), agente desktop (agent.minimax.io), MiniMax Code e a plataforma de API (platform.minimax.io).
- Pesos: huggingface.co/MiniMaxAI/MiniMax-H3-Image, com prompt expander opcional em MiniMaxAI/MiniMax-H3-Image-PE.
- Deploy: vLLM-Omni ou SGLang, com receita oficial em recipes.vllm.ai.
Para ler depois no blog
- Meta lança Muse Spark Open: primeiro modelo aberto americano que compete com Qwen, Kimi e GLM
- Anthropic lança Claude Fable 5.2 e Mythos 5.2: o modelo que formaliza Fermat em 30 horas
- O novo Google Gemini 4 Argon empata com GPT-6 Astra a 60% do custo
Referências consultadas
- MiniMax H3-Image: Bringing 4K Image Generation into the 10-Second Era (MiniMax Research)
- MiniMaxAI/MiniMax-H3-Image, model card e pesos abertos (Hugging Face)
- MiniMax-H3-Image Community License Agreement, texto integral
- Image Generation Guide (documentação da API MiniMax)
- Pricing Overview, seção Image (documentação da API MiniMax)
- MiniMax-H3-Image: 16 MP in 10 Seconds, Still Unmeasured (Orca Router)
- MiniMax-H3-Image vs Nano Banana 2.1: price vs proof (Orca Router)
- MiniMax H3 Image Highspeed, custos medidos por token (Runware)
- MiniMax H3 Image na plataforma fal.ai
- MiniMax H3-Image Open Weights, Pricing and Limits
Todas as imagens deste post são oficiais: capa e gráficos do blog da MiniMax Research, e galeria de showcase do model card no Hugging Face. Os números de latência e preço são self-reported pela MiniMax, exceto onde indicado. Nenhum benchmark de qualidade independente foi publicado até o momento.