
A Meta acaba de reentrar de cabeça na corrida do open-weight depois do tropeço do Llama 4. Nesta quinta-feira (15 de outubro de 2026), a empresa de Mark Zuckerberg publicou os pesos do Muse Spark Open, um MoE multimodal de 816 bilhões de parâmetros totais (42B ativos por token), janela de 1 milhão de tokens, e a primeira vez que um modelo de fronteira dos EUA consegue rodar em dois Mac Studio com chip M5 Ultra ligados via MLX. A Meta afirma, sem esconder, que o objetivo é claro: tomar dos chineses a coroa dos modelos abertos.
Na própria conta de Alexandr Wang, diretor de IA da Meta, no X: Muse Spark Open is the most capable US open-weight model to date. O ponto é geopolítico tanto quanto técnico, porque nos últimos 18 meses o ecossistema aberto virou um monopólio chinês. Qwen, da Alibaba, Kimi K3, da Moonshot AI, e GLM, da Z.ai, ditam o padrão. A Meta quer trazer a faixa de fronteira de volta para os Estados Unidos sem trancar o modelo.
Os pesos já estão no ar em Hugging Face, AWS SageMaker, Google Cloud Model Garden e Microsoft Foundry, com inferência hospedada em Baseten, Fireworks, Groq, Modal, Nebius, OpenRouter e Together AI. A licença é nova, chamada Muse Model License, permite uso comercial livre até US$ 20 milhões de receita anual em 12 meses, e exige o selo Built with Muse Spark Open em produtos derivados.
A geopolítica do open-weight em 2026
Quem acompanha o cenário de modelos abertos sabe que o jogo virou chinês. O top 5 de open-weight hoje é praticamente um leilão entre Moonshot, Alibaba e Zhipu. A Meta, que foi rainha absoluta com o Llama 2 e o Llama 3, perdeu o trono quando o Llama 4 chegou fraco e a OpenAI/Anthropic passaram a dominar a fronteira fechada. O Muse Spark Open é a tentativa de recuperar esse terreno.
A jogada é inteligente. A Meta não está tentando destronar Kimi K3 ou Qwen3.8-Max no agregado, está mirando o que ninguém chinês ainda entregou bem: multimodal nativo em larga escala com pesos abertos rodando em hardware de consumidor. O parágrafo mais importante do blog da Meta é este: Muse Spark Open is the first model in its class to run on your desktop using two Apple M5 Ultra Mac Studios with the latest MLX framework. Dois Mac Studio viram um supercomputador com 1 TB de memória unificada. É um movimento que mira especificamente developers e times de pesquisa que não querem depender de API fechada.
A parceria com a Apple é incomum. Zuckerberg agradeceu publicamente John Ternus, CEO da Apple desde a transição de Tim Cook. A Apple tem motivos próprios, já que o Apple Silicon, sem competição direta da NVIDIA no segmento cliente, ganha um argumento novo para vender Mac Studio M5 Ultra como workstation de IA. É uma jogada de mercado para os dois lados.
Especificações e arquitetura
O Muse Spark Open é o segundo modelo aberto do Meta Superintelligence Labs. O primeiro foi o Muse Glimmer 30B de agosto, um modelo denso pequeno, derivado de destilação do Muse Spark e otimizado para rodar local em GPU única. O Spark Open é o irmão grandão.
Especificações principais, retiradas direto do model card e do blog técnico da Hugging Face:
- Parâmetros totais: 816B (MoE esparso)
- Parâmetros ativos por token: ~42B
- Arquitetura: Sparse MoE com 256 experts por camada, 8 selecionados por token
- Camadas: 62 layers, hidden dim 8192, GQA 128/16 heads, 64 dim cada
- Contexto: 1.048.576 tokens (1M)
- Input: texto, imagens, áudio e vídeo
- Output: texto
- Formatos de checkpoint: BF16 (1.5 TB em safetensors) e NVFP4 (otimizado para NVIDIA Blackwell)
- Tokenizer: mesmo vocabulário do Muse Glimmer, ~202k tokens, multimodal-aware
- Perception Encoder: 1.8B params, ViT-G/14, 50 layers, suporte nativo a imagem e vídeo
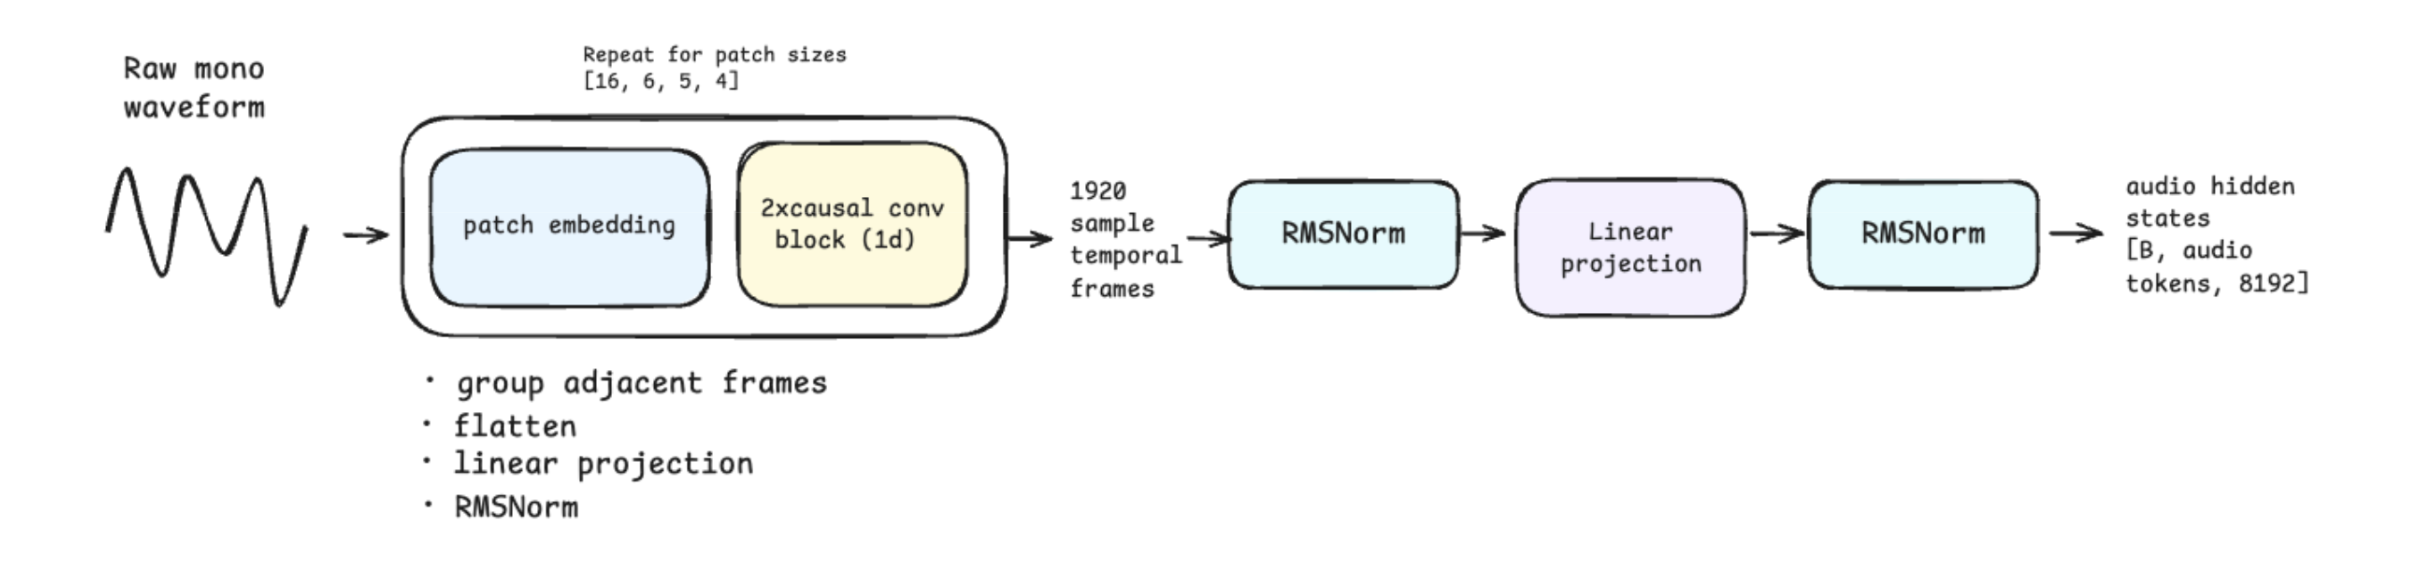
- Audio Encoder: 12.5 tokens por segundo (1 token a cada 80ms)
- Treinamento: iniciado a partir do Muse Spark 1.2, pós-treinamento adicional de segurança para versão aberta
Diagrama da arquitetura MoE

Pipeline do perception encoder (imagem e vídeo)

Audio encoder, 1 token a cada 80ms
Benchmarks, o que ele ganha e onde perde
A Meta publicou uma tabela comparando o Spark Open com os modelos abertos e fechados mais relevantes do momento. Vale a leitura honesta.
A tabela oficial da Meta

A leitura geral: o Muse Spark Open ganha em agentic coding (JobBench, MCP-Atlas), empata em raciocínio (MMLU, GPQA) e fica atrás dos chineses em coding puro de terminal. Onde ele se diferencia é em tool use, com 89.2 no MCP-Atlas, melhor que todos os rivais listados.
Comparativo agregado com os modelos abertos chineses e americanos
| Benchmark | Muse Spark Open | Kimi K3 | GLM 5.3 | Qwen3.8-Max | Inkling (Thinking Machines) | Nemotron 3 Ultra |
|---|---|---|---|---|---|---|
| Parâmetros totais / ativos | 816B / 42B | 2.8T / 104B | 753B / 40B | 2.4T / 95B | 975B / ~ | ~700B / ~ |
| Contexto | 1M | 1M | 1M | 1M (262K nativo) | 1M | 1M |
| Modality nativa | texto + imagem + vídeo + áudio | texto + imagem | texto | texto + imagem + vídeo | texto + imagem + áudio | texto + imagem |
| Artificial Analysis Index | ~42 (estimado, 4º de 189) | 57.1 (#4) | 60.0 (atrás Kimi K3) | ~Top 8 | 42 | ~38 |
| JobBench (agentic) | 61.8 (líder) | — | — | — | 31.1 | 27.2 |
| MCP-Atlas (tool use) | 89.2 (líder) | ~Fable 5 -0.5 | 77.0 | — | — | — |
| Terminal-Bench 2.1 (coding terminal) | 76.4 | 88.3 (#1) | 81.0 | 86.6 | — | — |
| SWE-bench Pro (engenharia) | — | — | 62.1 | 67.7 | — | — |
| GPQA Diamond (ciência) | 89.5 | 93.5 | 91.7 | 92.6 | — | — |
| DeepSWE (coding long-horizon) | 60.0 | 67.5 | 69.0 | 56.6 | — | — |
| HLE-Diamond (no tools) | 1.8 (muito baixo) | — | — | — | — | — |
| Preço API input/output (US$ / 1M) | — (sem API Meta oficial; via parceiros) | $3.00 / $15.00 | $1.40 / $4.40 | $2.00 / $6.00 | — | — |
| Licença | Muse Model License (grátis até US$ 20 milhões/ano) | MIT modificada (condições pós US$ 20 milhões) | MIT (irrestrita) | Qwen License | Apache 2.0 | Nvidia Open |
Fontes: Meta Research (research.meta.ai/blog/muse-spark-open), Hugging Face (huggingface.co/blog/meta-muse-spark-open), SiliconANGLE, Artificial Analysis, turingpost.com, fastino.ai, SiliconANGLE para o scorecard. Benchmarks ainda em consolidação independente, valores self-reported marcados como tal.
O dado que mais incomoda: HLE-Diamond ficou em 1.8, ridiculamente baixo. É um benchmark novo da Meta, parecido com o Humanity’s Last Exam, focado em raciocínio científico de fronteira. O número sugere que o Spark Open foi calibrado mais para coding e tool use do que para perguntas puras de raciocínio, ou que precisa de muito mais raciocínio do que o default para performar nesse teste. Vale acompanhar.
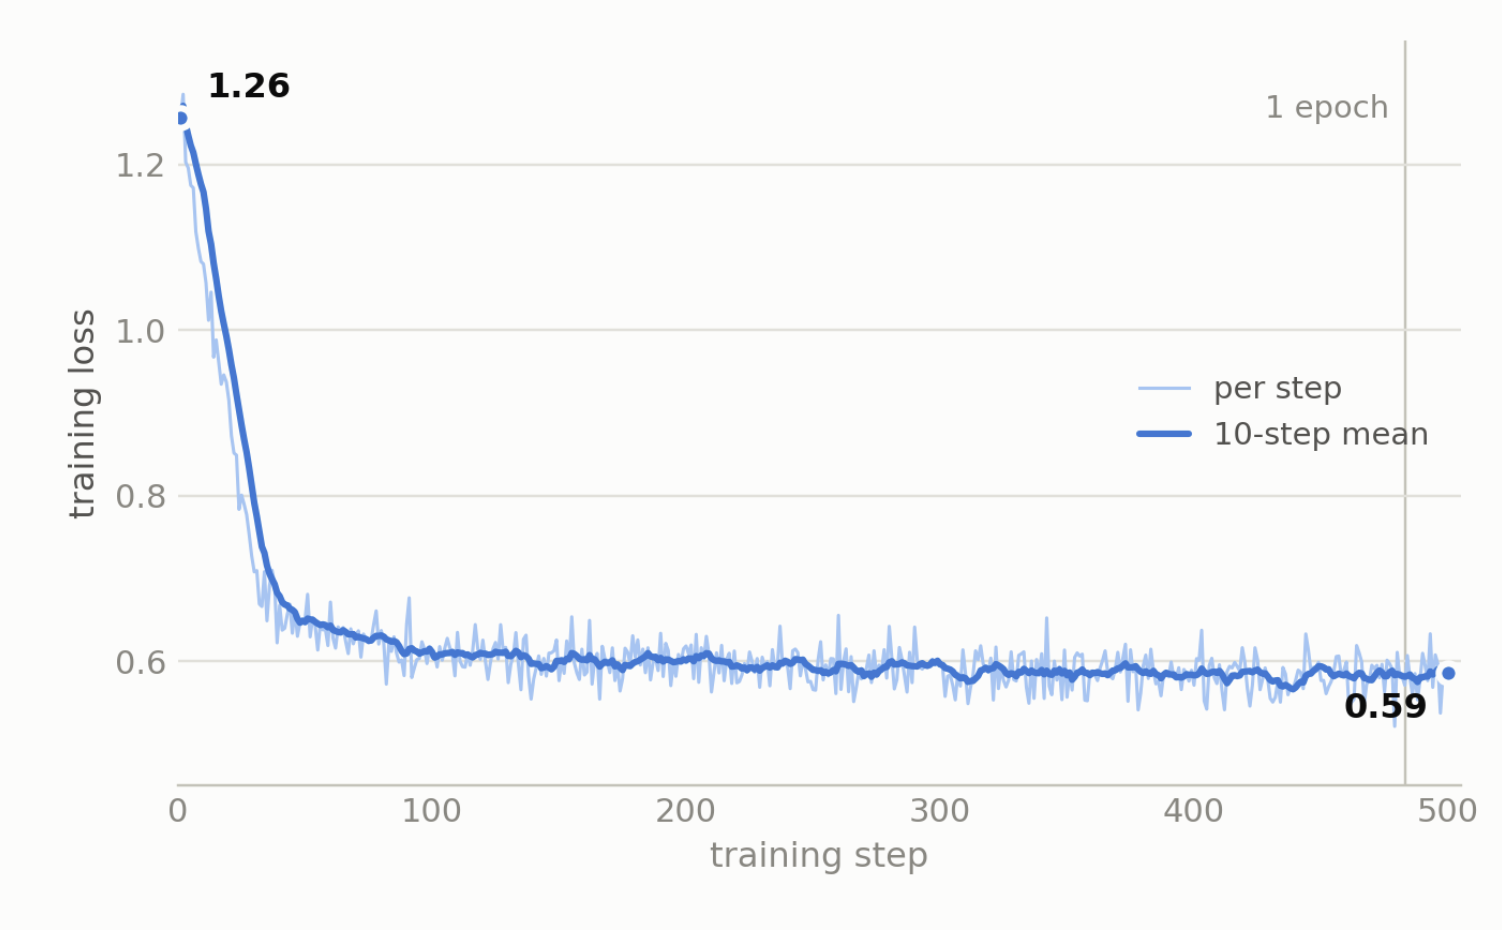
Curvas de treinamento

Roda em dois Mac Studio? Sim, mas com letra miúda
A Meta fez um demo que viralizou: o Muse Spark Open rodando 100% on-device em dois Mac Studio com M5 Ultra ligados via MLX, fazendo tarefas reais de produção. O mais impressionante é a conta: cada Mac Studio tem 512 GB de memória unificada utilizável pela GPU, e 1.2 TB/s de bandwidth. Dois juntos = 1 TB de memória efetivamente disponível, com largura de banda suficiente para ler a fatia pequena de parâmetros que cada token precisa.
O MLX é o framework de machine learning nativo da Apple, escrito em Swift e Python. A Meta lançou um adapter MLX oficial junto com os pesos, então é baixar e rodar.
O que foi demonstrado on-device:
- Ice Cubes (cliente Mastodon iOS open source): o modelo navegou no código, fez bug fixes, adicionou features novas, e gerou um build completo funcional, tudo sem internet depois do download dos pesos.
- DaVinci Resolve: o modelo revisou footage frame a frame, identificou os momentos mais fortes, e cortou vertical para TikTok/Reels automaticamente.
Rodando no MLX da Apple


Letra miúda importante: a Meta destaca que esse setup é o melhor caminho para rodar um modelo poderoso na sua mesa, mas não é trivial. Você precisa de dois Mac Studio (cada um partindo de ~US$ 4.000-6.000 com chip M5 Ultra e 512 GB de RAM), conhecimento de MLX e de ferramentas de linha de comando. Quem quer praticidade vai usar um provedor de inferência como Together AI ou Fireworks AI, onde o preço por token é competitivo e o deploy é de minutos.
Onde rodar (e quanto custa) hoje
A Meta montou uma pilha de inferência completa no dia 0. Sete provedores já estão com o modelo no ar, mais de uma dezena de engines suportados e otimizações oficiais em todos os principais hardwares.
Provedores de inferência hospedada
- Baseten (deploy self-managed)
- Fireworks AI
- Groq
- Modal
- Nebius
- OpenRouter
- Together AI
Engines suportados
- vLLM com kernels Helion customizados, 1.03-3.95x speedup em NVIDIA e AMD
- SGLang com 3% speedup end-to-end em AMD MI350
- TensorRT-LLM (NVIDIA)
- Apple MLX (Mac Studio M5 Ultra)
- llama.cpp (consumer, com quantização)
- Hugging Face Transformers
- Unsloth (LoRA e fine-tuning)
- AMD ROCm (MI355X, MI350, MXFP4)
Onde baixar os pesos
- Hugging Face: meta-models/Muse-Spark-Open-816B-A42B (BF16) e -NVFP4 (4-bit)
- Amazon SageMaker AI
- Google Cloud Model Garden
- Microsoft Foundry Models
Como rodar local em Apple Silicon (5 minutos):
# 1. Instalar mlx-lm
pip install -U mlx-lm

# 2. Baixar os pesos do Hugging Face
huggingface-cli download meta-models/Muse-Spark-Open-816B-A42B

# 3. Rodar
mlx_lm.generate --model meta-models/Muse-Spark-Open-816B-A42B \
    --prompt "Write a Python script that uses asyncio to fetch 100 URLs in parallel."
A licença: como a Meta tentou resolver a treta do open-weight comercial
A nova Muse Model License é o documento mais controverso do lançamento. A Meta precisava equilibrar três coisas: tornar o modelo usável comercialmente, proteger receita futura de quem vende o modelo como serviço, e manter aceso o debate sobre pesos abertos responsáveis.
O que pode livremente
- Desenvolvedores podem usar, modificar, fazer fine-tune e embutir o modelo em produtos próprios sem pagar nada, mesmo se a empresa passar de US$ 20 milhões de receita anual, desde que não vendam o modelo hospedado como serviço.
- Pesquisa, educação, projetos pessoais e experimentação são livres.
- Produtos derivados precisam carregar a marca Built with Muse Spark Open.
O que precisa de acordo separado
- Empresas que vendem o modelo como model-as-a-service (API gerenciada, hosting pago) e ultrapassaram US$ 20 milhões em receita bruta em 12 meses precisam de licença comercial específica da Meta.
O que é proibido
- Uso militar direto.
- Infraestrutura crítica (energia, água, transporte, saúde em cenários de risco de vida).
- A Meta não detalhou o resto da lista restritiva, o documento completo fica no Hugging Face.
O ponto positivo é que a licença é mais permissiva que a do Llama 4 (que tinha community license agreement agressiva) e mais clara que a do Kimi K3 (que também tem regra de US$ 20 milhões mas com mais zonas cinzentas). O ponto negativo é que fica atrás do MIT irrestrito do GLM 5.3, que é o padrão-ouro de permissividade no ecossistema aberto hoje.
O que isso significa, na prática
Algumas leituras honestas sobre o lançamento e suas implicações.
- A Meta recuperou o direito de falar de open-weight em pé de igualdade com a China. Por um ano, a empresa foi omissa enquanto Qwen, Kimi e GLM ditavam o que existia em aberto. O Muse Spark Open é a primeira resposta à altura, ainda que não seja o melhor modelo aberto em todas as métricas.
- Open-weight americano não significa o mais capaz. O Spark Open perde de Kimi K3 no índice agregado da Artificial Analysis (60 vs ~42), perde de GLM 5.3 em coding e perde de Qwen3.8-Max em multimodal. Mas ganha onde americanos tradicionalmente ganham, em tool use, agentic coding e suporte a hardware de consumidor.
- A jogada da Apple é mais importante do que parece. A Meta fez uma aliança com a Apple em momento que a empresa de Cupertino tenta vender workstations caras para o mercado de IA. O Muse Spark Open rodando em M5 Ultra é o tipo de demo que justifica US$ 10.000 em hardware para um developer solo. Isso muda o cálculo de quem compra GPU NVIDIA.
- OpenAI e Anthropic não vão se mexer com isso. A briga por open-weight é entre Meta, Alibaba, Moonshot, Z.ai e DeepSeek. OpenAI e Anthropic continuam 100% no mercado de API fechada, e o Spark Open não muda esse cálculo.
- O license da Meta é liberal mas não o mais liberal. Tem a trava de US$ 20 milhões de receita para quem revende o modelo como serviço. Empresas pequenas e developers estão livres, o que é o caso de 95% do ecossistema. Mas se a Meta quiser competir de verdade com o MIT do GLM, a próxima versão precisa ir além.
- É um momento geopolítico, não só técnico. O governo americano vem pressionando big tech a manter liderança em IA aberta, especialmente contra a China. O Muse Spark Open aparece com selo Made in USA, otimizado para hardware americano (Apple, NVIDIA, AMD), com a narrativa de american open-weight is back. É política industrial disfarçada de release técnico.
Perguntas frequentes (FAQ)
Muse Spark Open é o primeiro modelo de IA verdadeiramente frontier da Meta liberado com pesos abertos. Foi anunciado em 15 de outubro de 2026 e é um MoE (Mixture of Experts) multimodal com 816 bilhões de parâmetros totais, 42 bilhões ativos por token, janela de 1 milhão de tokens, suporte a texto, imagem, vídeo e áudio de entrada, com saída em texto. O modelo foi treinado pelo Meta Superintelligence Labs a partir do Muse Spark 1.2 com pós-treinamento adicional de segurança para a versão aberta.
Muse Wonder e Muse Wonder Full são modelos fechados lançados em 12 de outubro de 2026, acessíveis só pela Meta Model API e pelo Muse Code. O Muse Spark Open é a versão aberta, com pesos públicos, otimizada para coding e agentic work, multimodal nativa. O Spark Open é maior (816B vs 1M-tokens do Wonder) mas calibrado para tarefas diferentes: o Wonder para agentes pessoais, o Spark Open para developers e empresas que precisam rodar o modelo localmente ou em cloud privada.
Kimi K3 (2.8T / 104B ativos) lidera o índice agregado da Artificial Analysis com 60, e vence em Terminal-Bench 2.1 (88.3) e Program Bench. GLM 5.3 (753B / 40B ativos) é o mais barato em produção com licença MIT irrestrita. Qwen3.8-Max (2.4T / 95B ativos) é multimodal nativo com visão forte. O Muse Spark Open perde no agregado, mas lidera JobBench (61.8) e MCP-Atlas (89.2), que medem agentic coding e tool use respectivamente. É um trade-off: o Spark Open vence onde americano tipicamente vence (tool use), perde onde chinês tipicamente vence (coding puro de terminal).
É open weight, não open source completo. Open weight significa que os pesos do modelo (o resultado do treinamento) são públicos, e qualquer pessoa pode baixar, rodar, fazer fine-tune e embutir em produtos. Open source completo exigiria também o código de treinamento, os dados de pré-treinamento, o pipeline completo de data prep, etc. O Muse Spark Open libera só os pesos, sob a Muse Model License. Para a maioria dos developers isso é suficiente, porque o que importa é o modelo treinado, não a receita de bolo.
Não direto. O modelo BF16 tem 1.5 TB em safetensors, então você precisa de uma workstation multi-GPU de datacenter (idealmente 4 nodes com 8 H200 cada, ou 1 node com 8x B200 para o NVFP4). Para rodar em hardware menor, existe a versão NVFP4 (4 bits) que cabe em um node B200. Em Apple Silicon, a Meta demonstrou rodando em dois Mac Studio com M5 Ultra e 512 GB de RAM cada, ligados via MLX. Para PCs comuns, o caminho prático é usar um provedor de inferência como Together AI, Fireworks ou Groq.
A Meta não vende API direta do Spark Open, é tudo via provedores parceiros. Os preços variam por host, mas a faixa de mercado para um MoE 816B/42B ativo costuma ficar entre US$ 2-3 por milhão de tokens de input e US$ 8-12 por milhão de output. Together AI e Fireworks tendem a ficar no lado mais barato; OpenRouter agrega vários hosts e cobra spread.
Sim, com uma condição. Se a empresa ganha menos de US$ 20 milhões de receita anual em 12 meses, é uso comercial livre, sem pagar royalty. Se passar desse limite e você quiser revender o modelo como serviço hospedado (model-as-a-service), precisa negociar uma licença comercial específica com a Meta. Para produtos derivados (apps que usam o modelo internamente), a trava de US$ 20 milhões não se aplica, qualquer empresa pode construir produto em cima do Spark Open sem pagar nada.
Não, em agregado. Esses modelos fechados ainda lideram o índice geral da Artificial Analysis por boas margens. O Spark Open compete com eles em agentic coding e tool use, e perde em raciocínio puro, multimodal avançado e conversas longas. Onde ele ganha de todos, surpreendentemente, é em tool use (MCP-Atlas 89.2), porque a Meta calibrou explicitamente para isso. Para agents que precisam chamar ferramentas com precisão, ele é competitivo até com fronteira fechada.
Sim, com algumas vias. A Meta documenta TorchTitan como framework oficial para continuar o treinamento. Para LoRA, a vLLM lançou suporte oficial com Verl FSDP2 como trainer, rank 32 alpha 64, cobrindo attention, MoE latent projections e routed experts. A recomendação é começar com LoRA antes de partir para fine-tune completo, porque o modelo é caro de treinar.
A Meta rodou o modelo pelo seu próprio framework de segurança, o Meta Superintelligence Scaling Framework, e afirma que os thresholds de risco foram atendidos. O pós-treinamento adicional de segurança foi adicionado justamente para reduzir o risco de uso dual (good e bad). O model card lista as categorias avaliadas. Empresas que adotarem precisam rodar suas próprias avaliações internas antes de uso em produção, especialmente para uso com dados de clientes ou infraestrutura crítica.
A Meta sinalizou modelos open-weight maiores no futuro, sem data. O Muse Glimmer continua sendo o modelo denso pequeno (30B), o Spark Open é a versão MoE grande, e a família fechada (Wonder, Wonder Full) segue a fronteira proprietária. O próximo passo lógico é uma variante de raciocínio mais forte,蒸馏 de versões maiores do Spark, e expansão do suporte a mais línguas além de inglês.
Conclusão
O Muse Spark Open não é só mais um modelo aberto. É a primeira resposta americana de peso à hegemonia chinesa no open-weight, vem com parceria incomum com a Apple, licença comercial clara e otimização para hardware de consumidor. Perde no agregado para Kimi K3, mas ganha onde importa para developers e times de produto que precisam de tool use forte e inferência controlável.
Se a Meta conseguir manter o ritmo e liberar uma variante com raciocínio mais forte, ou um modelo multimodal ainda maior nos próximos meses, a hegemonia chinesa no open-weight começa a ter contrapeso real. Vale baixar os pesos, testar com seu workload, e ver se o trade-off faz sentido para o seu caso.
Para ler depois no blog
- Meta lança Muse Wonder e Muse Wonder Full: a IA frontier para agentes pessoais que vai bater de frente com OpenAI e Anthropic
- Conheça o Jev da TypeSafe AI: os modelos ‘System One’ e o fim das alucinações em código
- O novo Gemini 3.8 Live chegou: a virada de chave do Google na inteligência artificial de voz
- O novo Google Gemini 4 Argon empata com GPT-6 Astra a 60% do custo
Referências consultadas
- Introducing Muse Spark Open, The Most Capable US Open-Weight Model to Date (Meta AI Research)
- Welcome Muse Spark Open: open-weight frontier multimodal mixture-of-experts model from Meta (Hugging Face)
- Meta releases 816B-parameter Muse Spark Open for coding and agent work (SiliconANGLE)
- Day 0 support for Muse Spark Open on vLLM (vLLM Blog)
- Meta apresenta novo modelo aberto de IA para competir com a China (Folha C-Level / AFP)
- Meta apresenta novo modelo de IA ‘aberto’ para competir com a China (O Globo / AFP)
- Chinese LLMs in 2026: Full List, Licenses and Best Picks (Turing Post)
- The Best Open Weight Models of Summer 2026 (Fastino)
- Kimi K3 vs Qwen3.8-Max vs GLM-5.2: The 2026 Comparison (Tech Stuff)
- Introducing Muse Glimmer: An Open Agentic Model That Runs on Your Device (Meta AI Research)