
28 de outubro de 2026 O Google lançou o Gemini 4 Carbon, o modelo mais forte da empresa até agora, e o fez de um jeito que não tinha precedent no mercado: ninguém pode comprar. O Carbon foi liberado apenas para um grupo seleto de profissionais de cibersegurança e para parceiros do Programa Fairwind, e o Google avisa que está participando do processo voluntário de testes pré-lançamento do governo dos EUA. O acesso geral para desenvolvedores, empresas e consumidores não tem data.
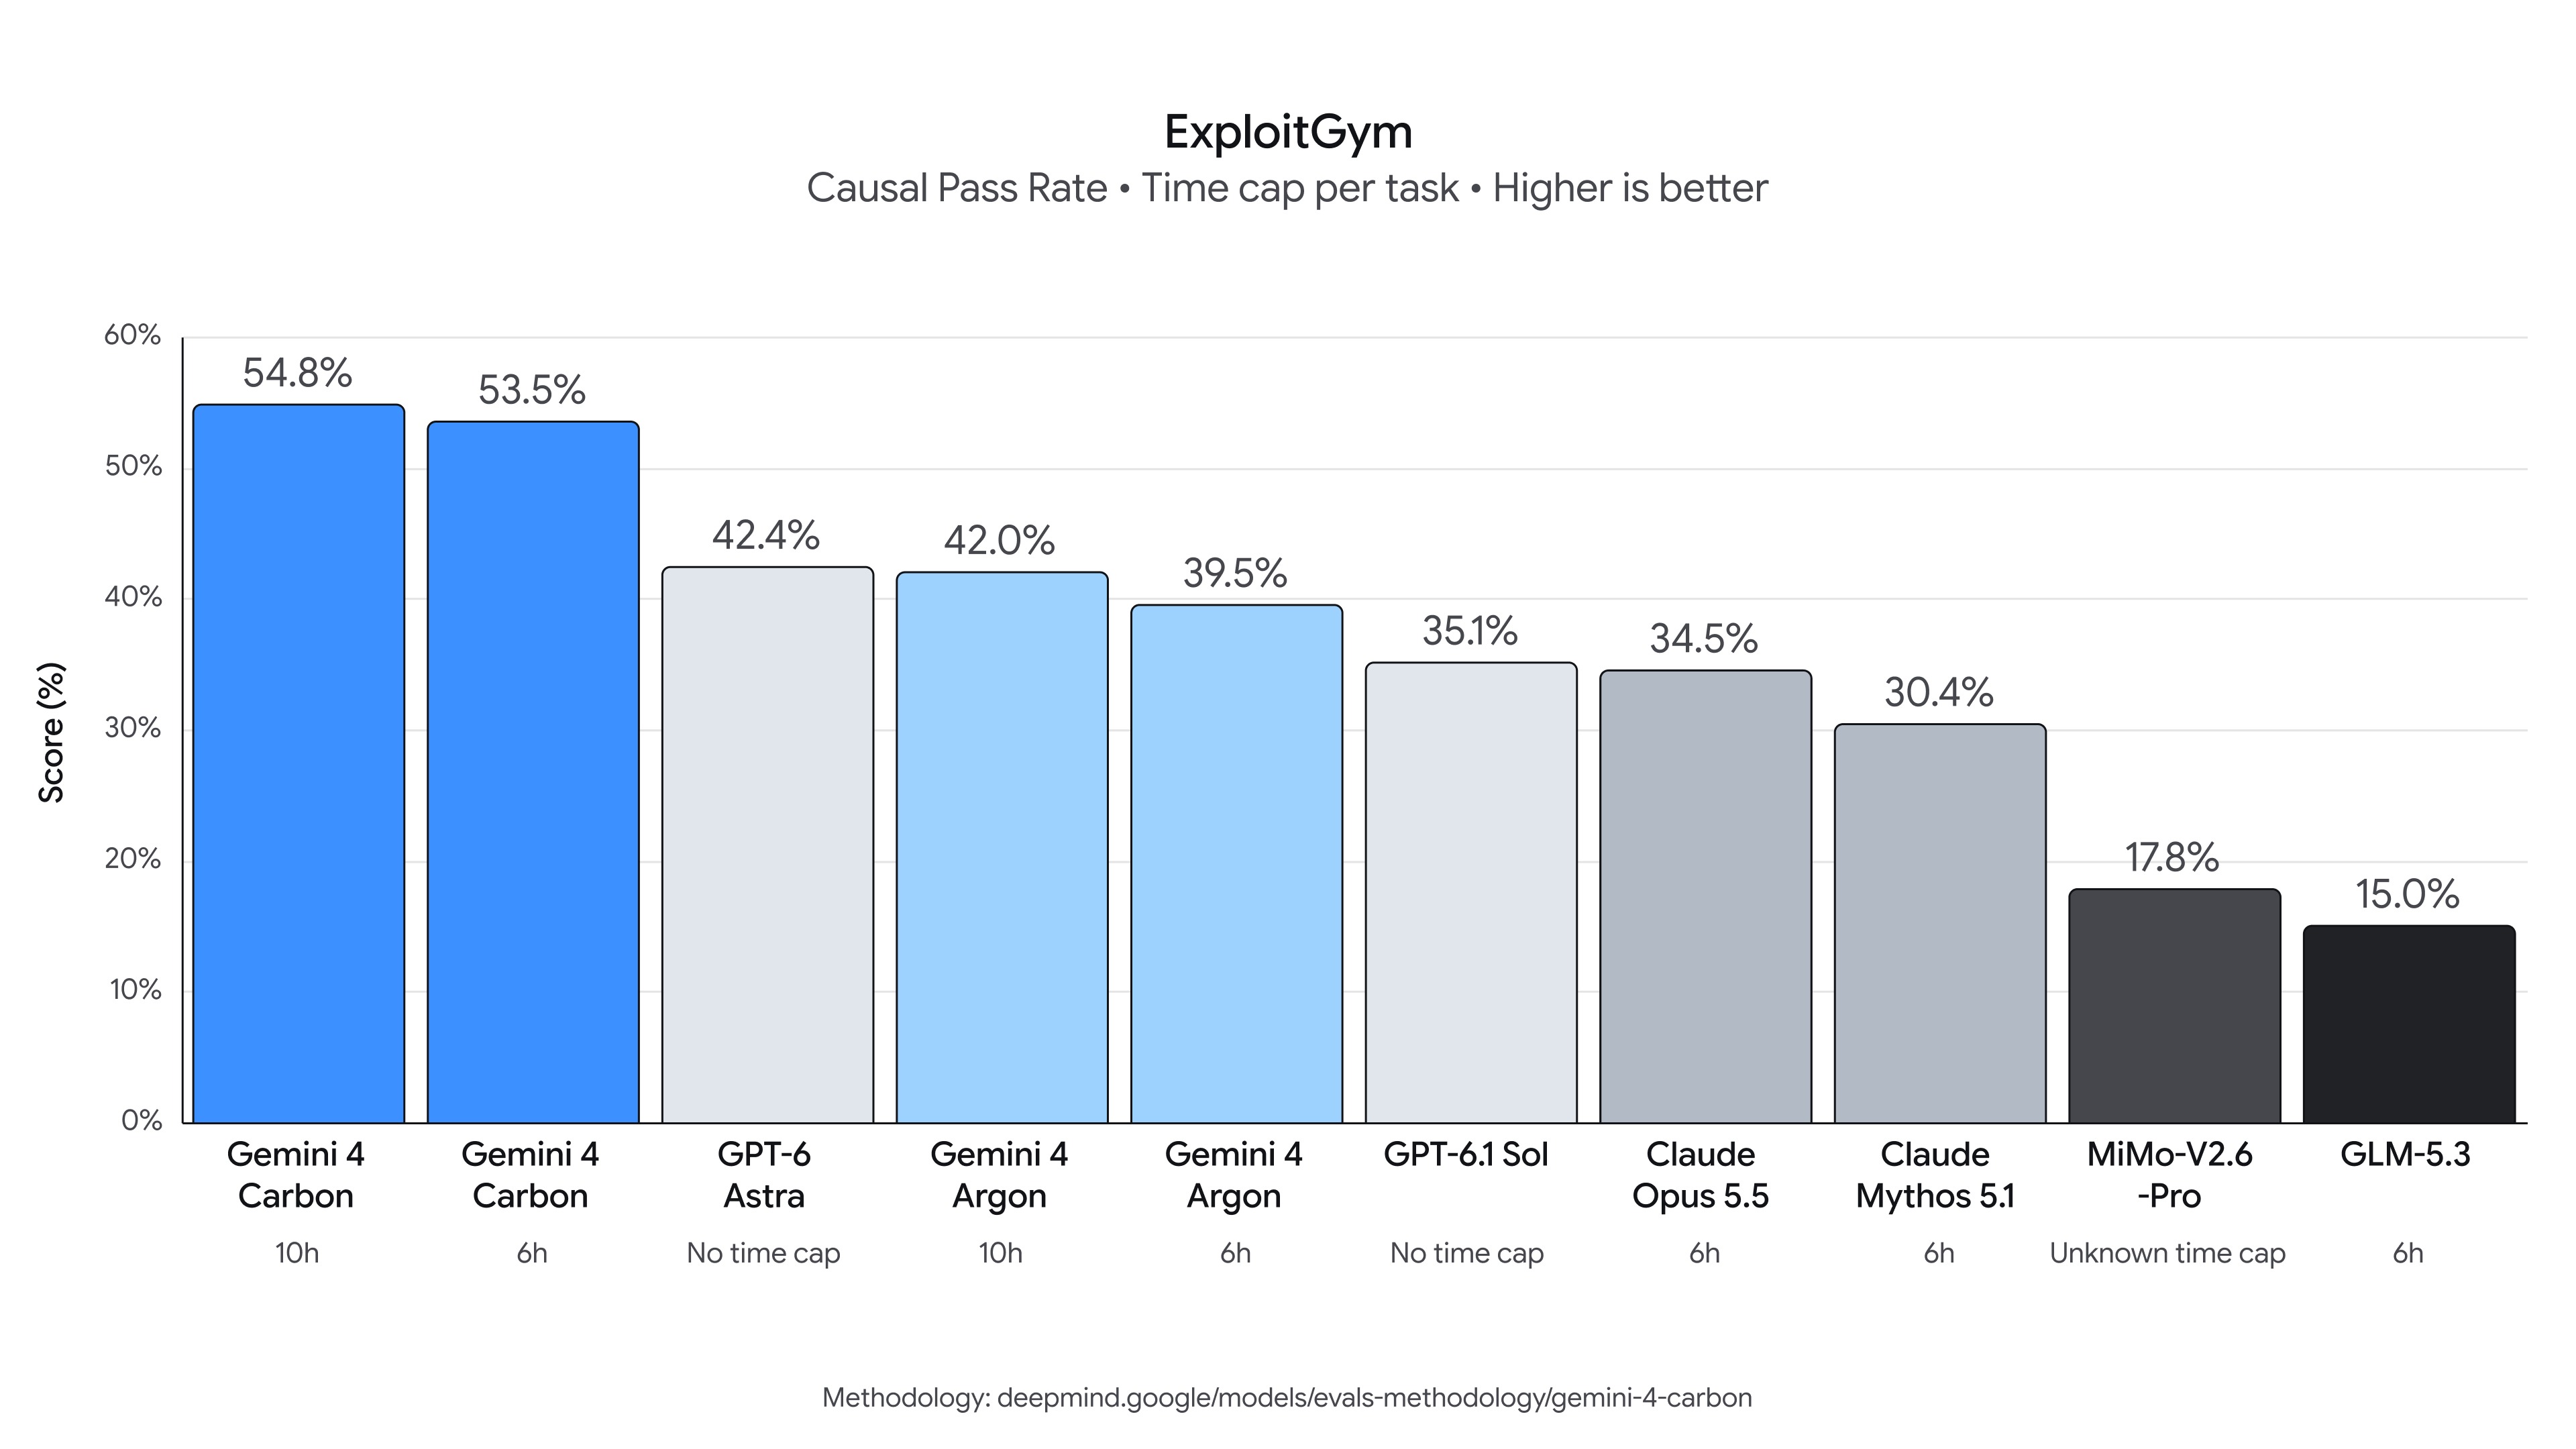
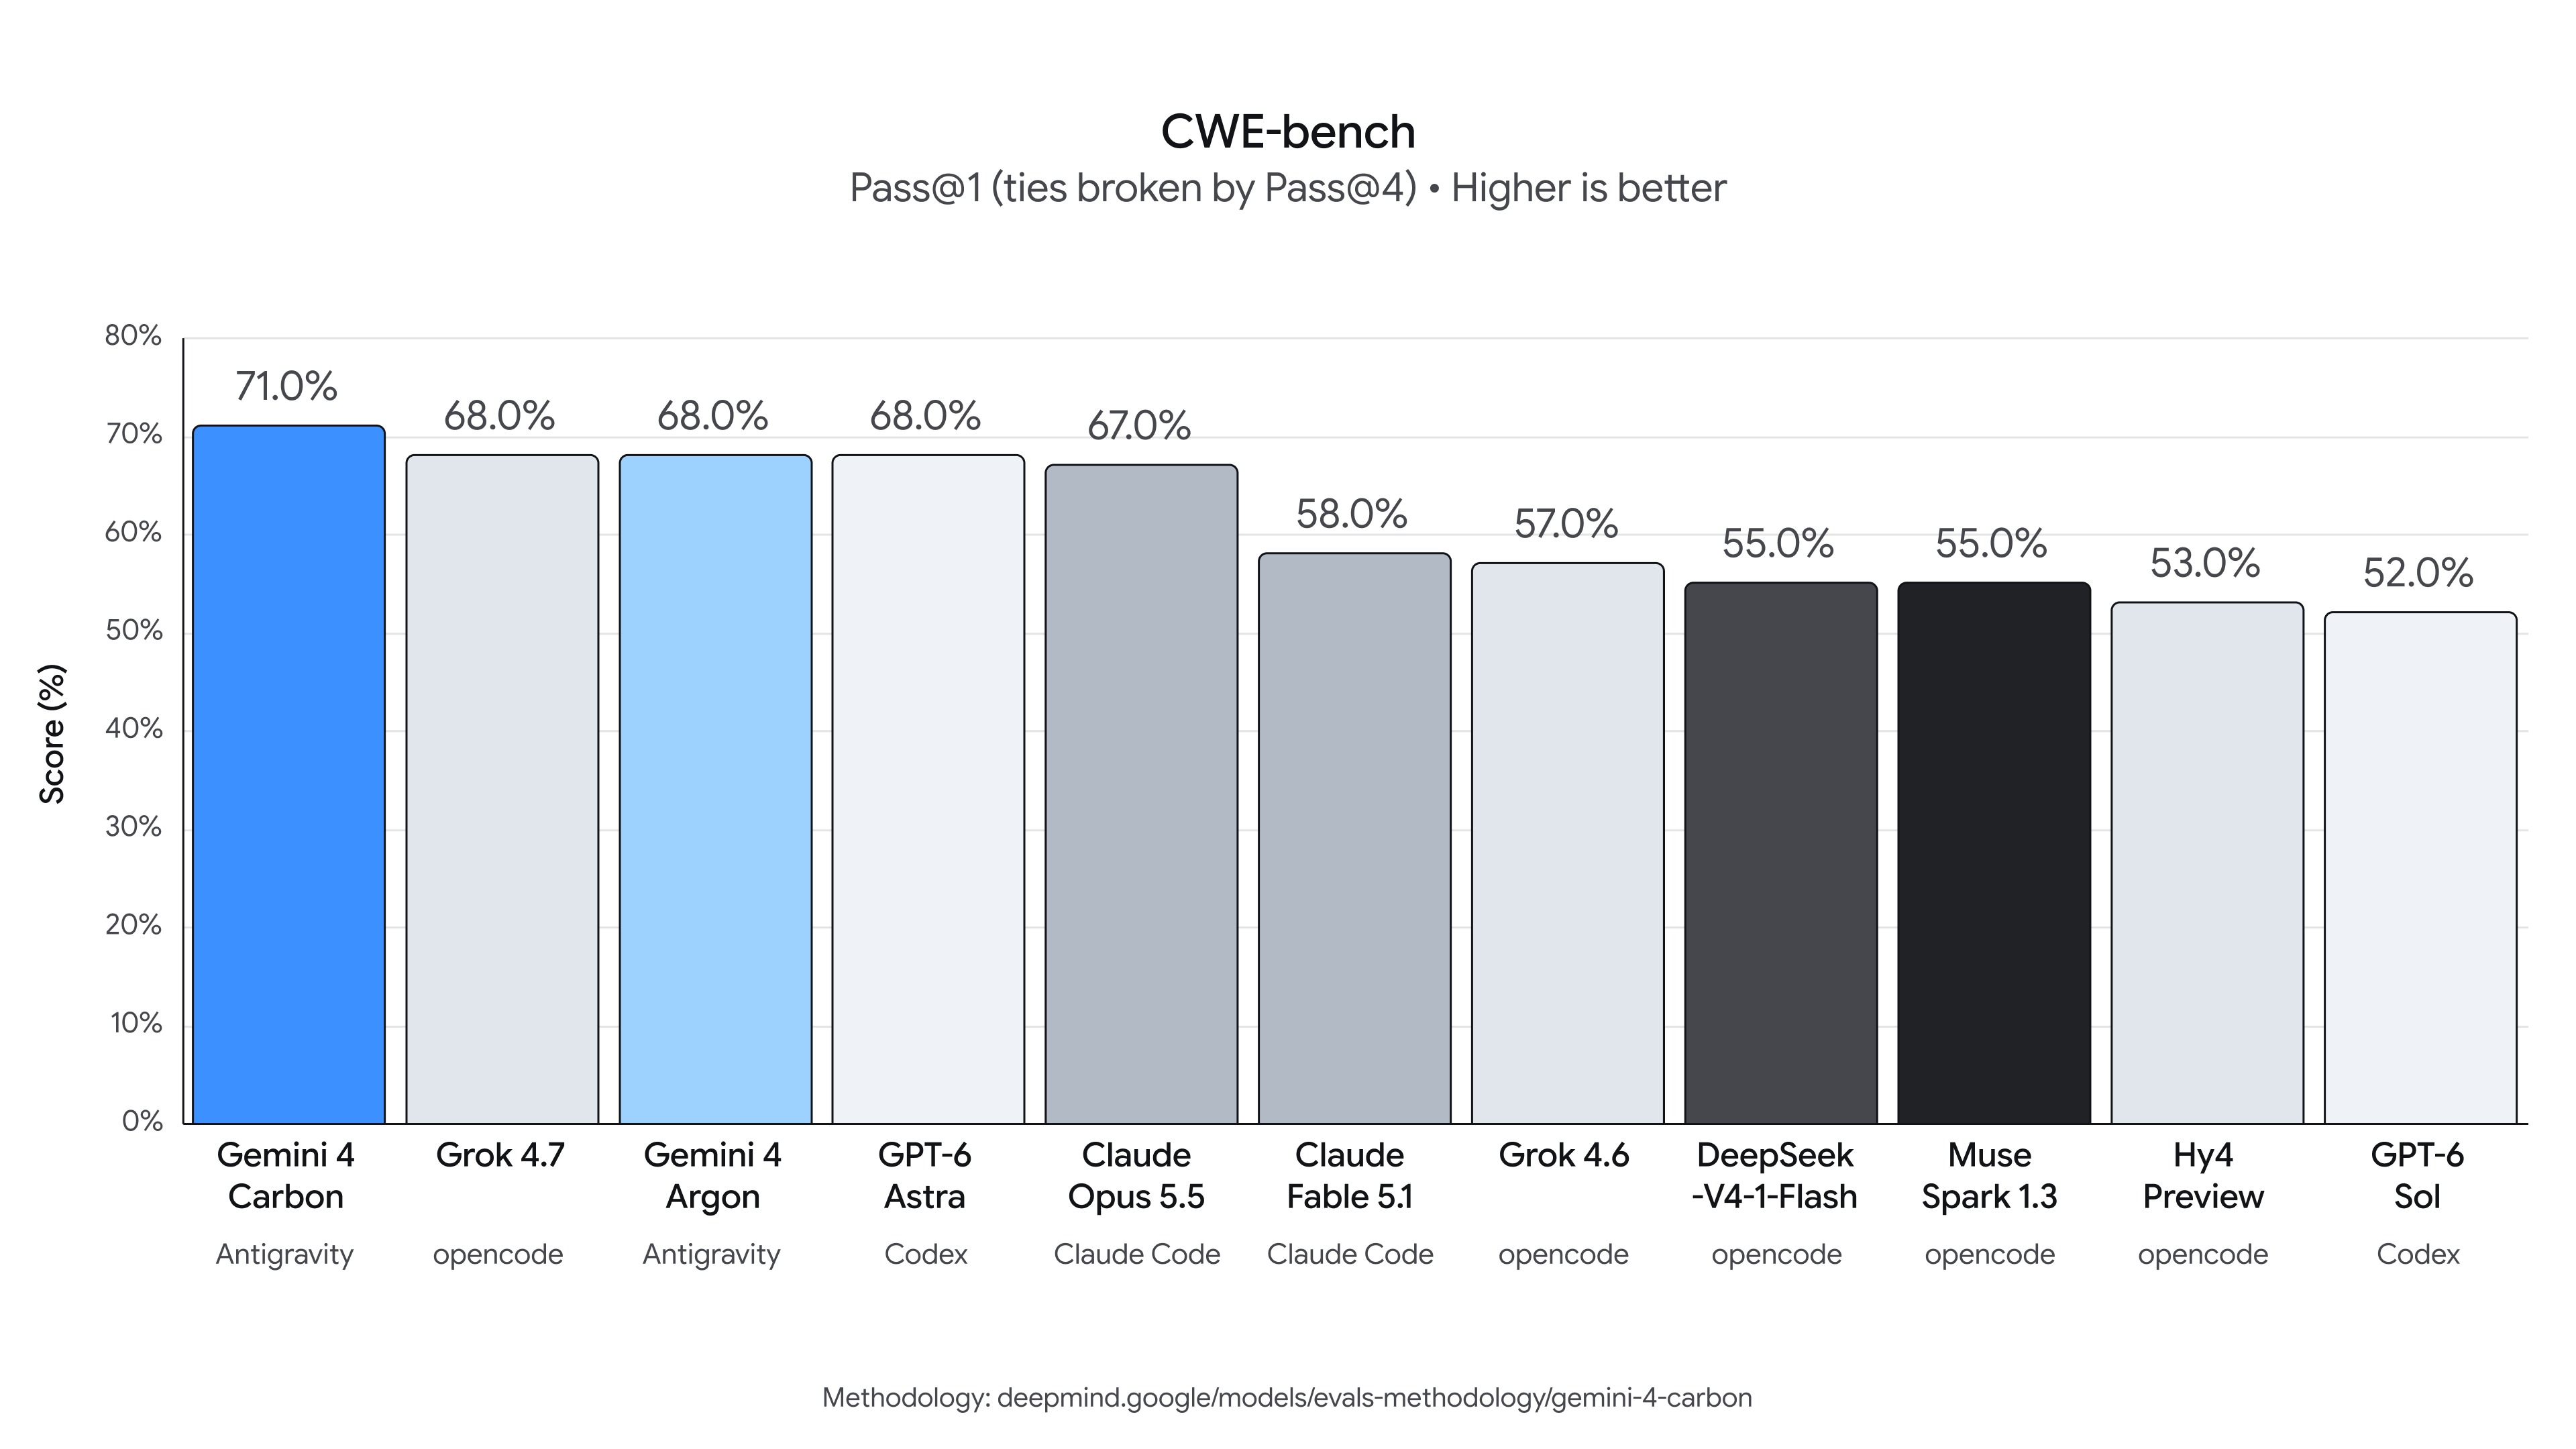
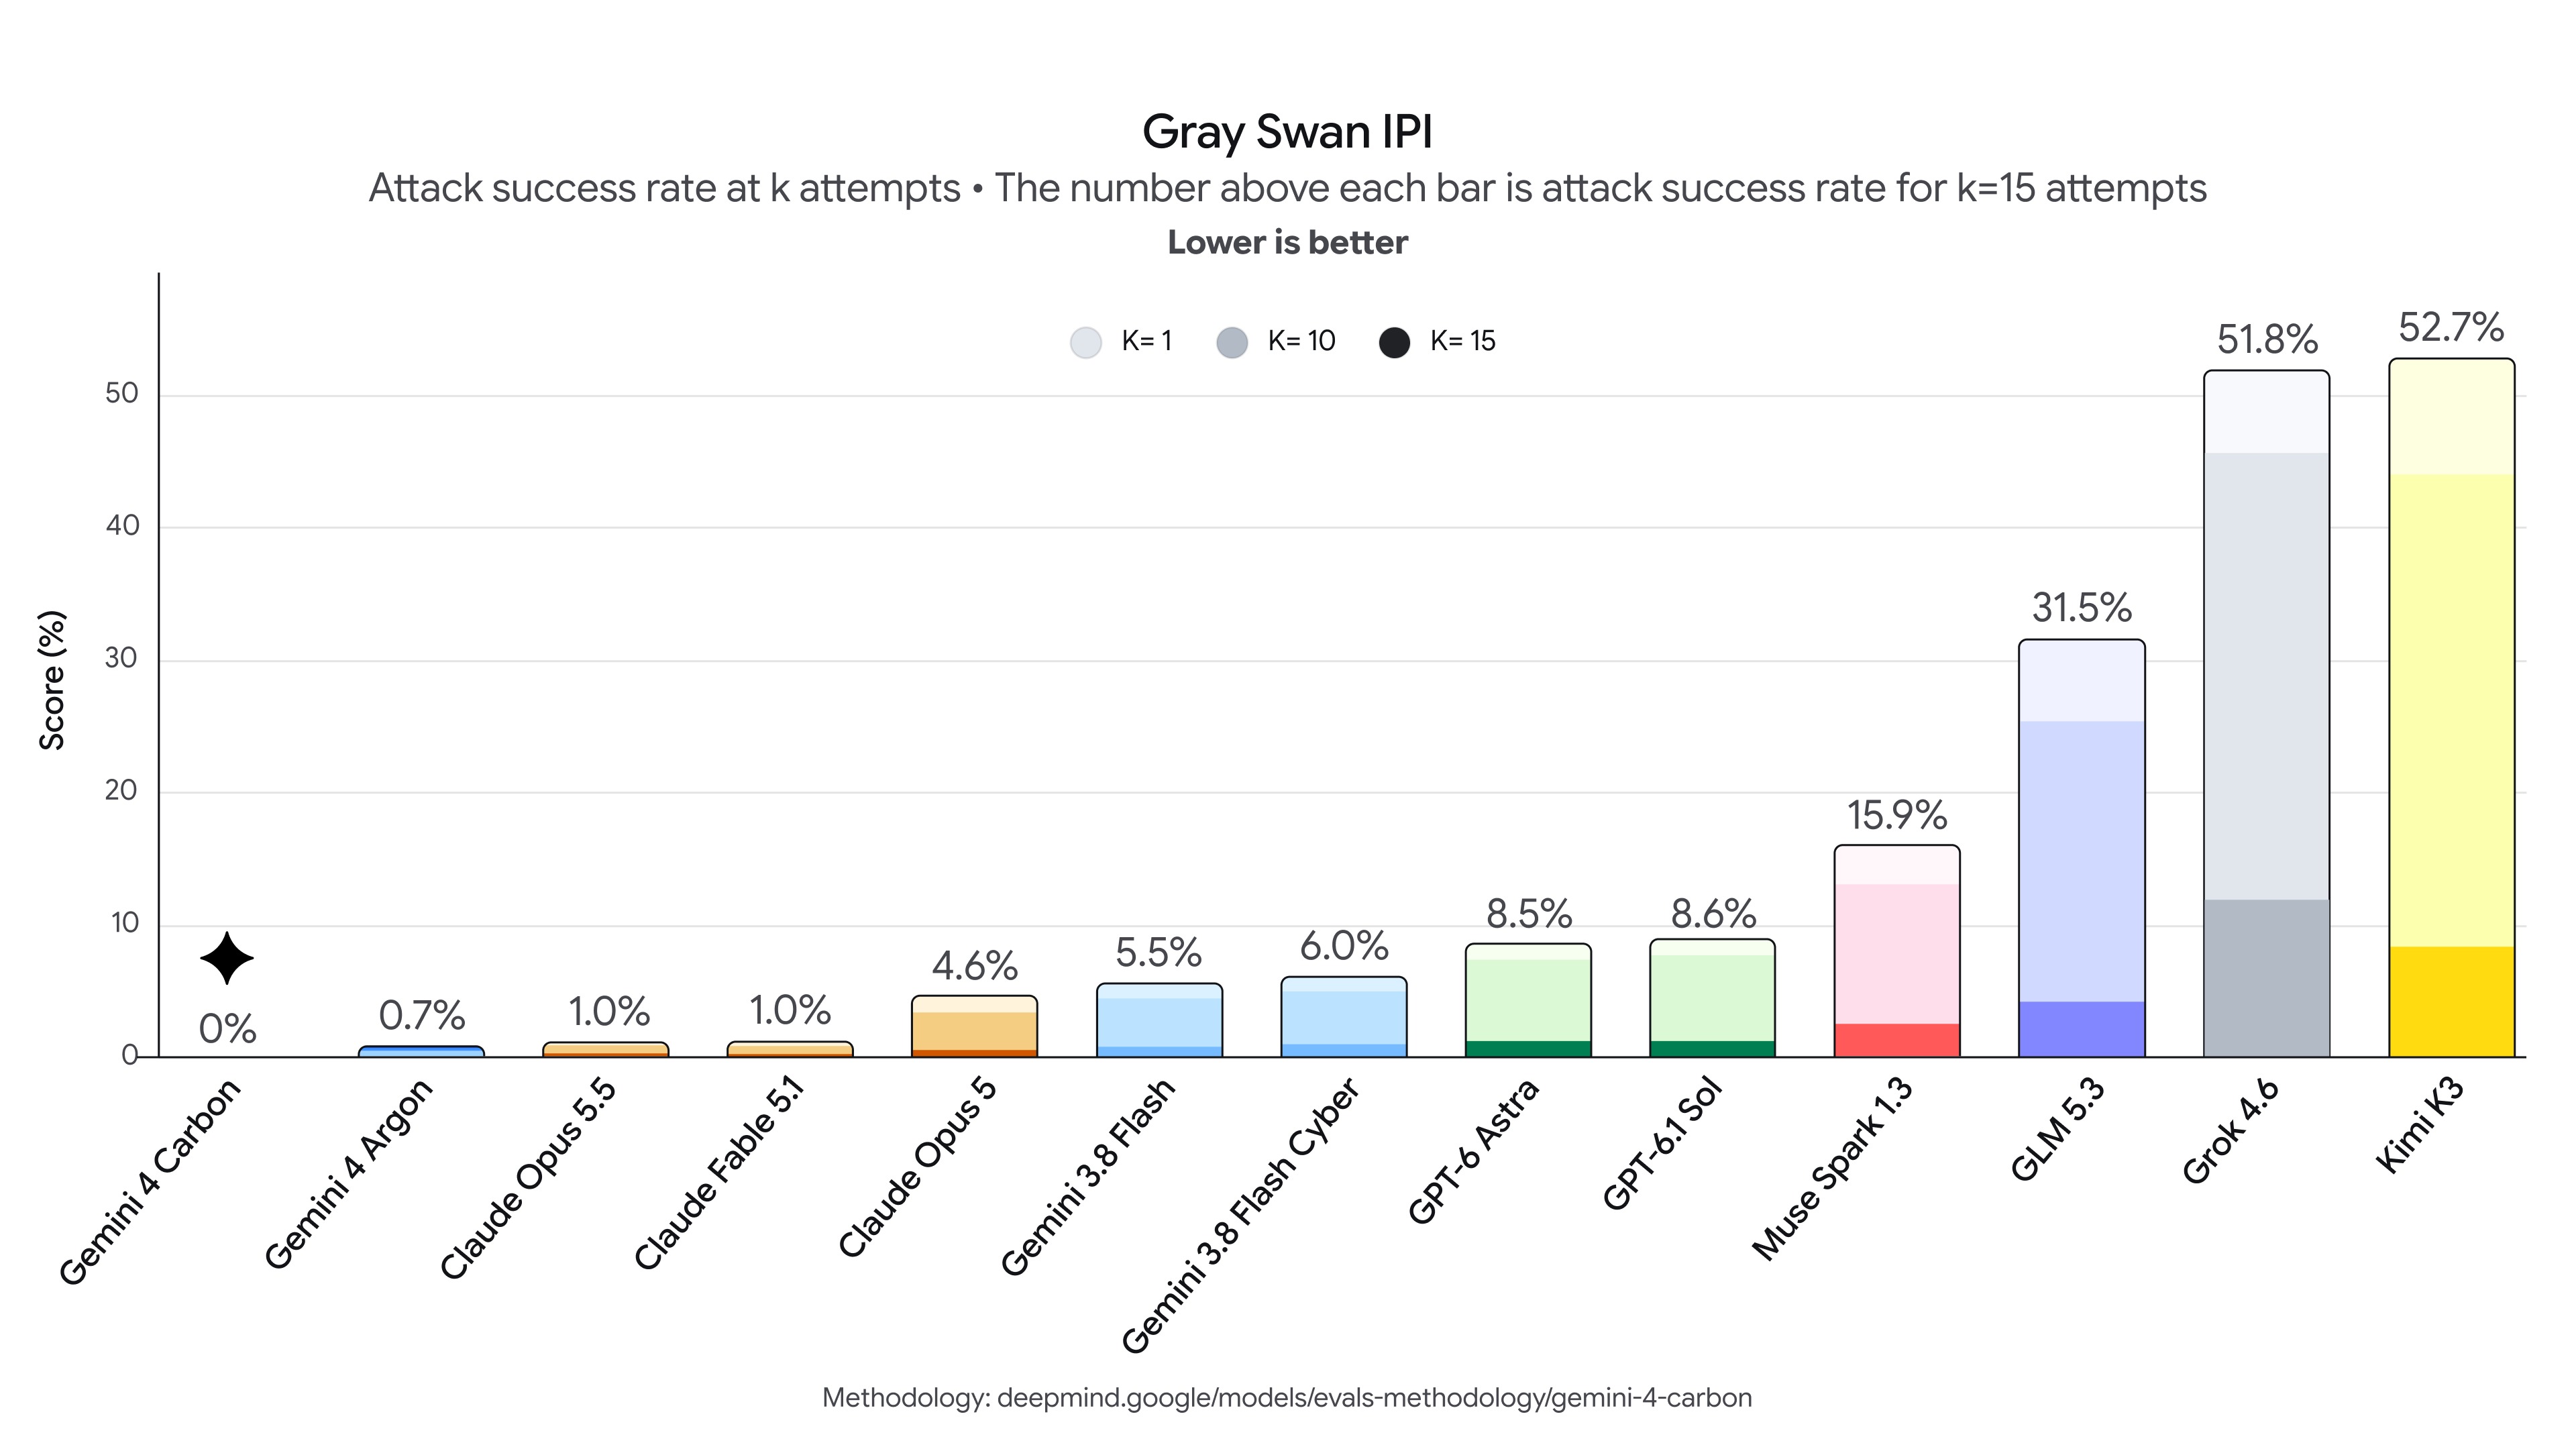
Os números, porém, são o melhor anúncio de modelo de fronteira que a Anthropic e a OpenAI já enfrentaram. Primeiro lugar no Índice de Inteligência da Artificial Analysis v5.0 com 59 pontos, à frente do Claude Opus 5.5 (58) e do GPT-6 Astra (57). 88,2% no SEC-bench Pro para achar vulnerabilidades em software real. 54,8% no ExploitGym para transformar a falha em exploit funcional. 71,0% no CWE-bench para escrever o patch que corrige a causa raiz. E nos gráficos de resistência a injeção de prompt da Gray Swan, o Carbon zerou a taxa de sucesso de ataque.
O mais impressionante é o que o Google fez nos números de segurança do seu próprio navegador. A equipe do Chrome relatou que o Carbon gerou patches de alta qualidade mais de 10 vezes melhor do que o modelo de fronteira de outro laboratório. E no Terminal-Bench 4.0, o Carbon reduziu as trapaças bem-sucedidas para 0,0%, com as tentativas caindo para 0,4%, enquanto melhorava a precisão geral. Modelo que não trapaceia no benchmark é modelo que a empresa quer que você use em produção. Ou que você não use de jeito nenhum.
O que é o Gemini 4 Carbon
O Carbon é o próximo modelo de fronteira do Google DeepMind, construído sobre o Gemini 4 Argon, que saiu duas semanas antes (13 de outubro). Segundo o model card, a arquitetura é a mesma do Argon. O que muda é o comportamento em fluxo de trabalho autônomo e contínuo: dentro do Google, as equipes relatam ver o Carbon trabalhando por dias, persistindo diante de becos sem saída em tarefas de engenharia com várias etapas, como identificar causa raiz e corrigir bugs sutis em bases de código grandes e em sistemas de baixo nível.
Koray Kavukcuoglu, SVP do Google DeepMind e arquiteto-chefe de IA do Google, resumiu o motivo do lançamento: o Carbon ilustra a taxa de avanço, com os pesquisadores e os modelos trabalhando lado a lado para expandir capacidades mais rápido, enquanto as salvaguardas são reforçadas em paralelo.
Preço: sai barato, mas dobra depois
O Carbon foi anunciado com o mesmo preço promocional do Argon, US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída, com tokens de entrada em cache precificados a 95% de desconto do preço de entrada, ou seja, US$ 0,10 por milhão.
Só que o preço de verdade está no rodapé. A tabela da documentação do Vertex AI é direta: US$ 4 por milhão de tokens de entrada e US$ 20 por milhão de tokens de saída a partir de 1º de dezembro de 2026. A Artificial Watch confirmou que o Carbon chegou ao tier pago da API do Gemini em 10 de novembro, com o desconto de 50% válido até 30 de novembro. Quem orça pipeline em US$ 2 e US$ 10 está orçando uma promoção com data no calendário.
| Item | Preço promocional (até 30/nov) | Preço padrão (a partir de 1º/dez) |
|---|---|---|
| Entrada | US$ 2,00 / M tokens | US$ 4,00 / M tokens |
| Saída | US$ 10,00 / M tokens | US$ 20,00 / M tokens |
| Entrada em cache | US$ 0,10 / M tokens | US$ 0,20 / M tokens |
| Batch API | US$ 1,00 / M entrada, US$ 5,00 / M saída | metade do preço padrão |
Para dimensionar: um workload com 10 milhões de tokens de entrada sem cache e 1 milhão de tokens de saída saídos custa US$ 30 no preço promocional e US$ 60 no preço padrão. A Tilt.news apurou que, no preço padrão, o Carbon custa US$ 7,76 por tarefa do Índice de Inteligência, 23% menos que o Claude Opus 5.5, que fica em US$ 10,04. Ou seja, mesmo com o dobro do preço por token, sair mais barato por trabalho entregue.
A tabela completa de benchmarks
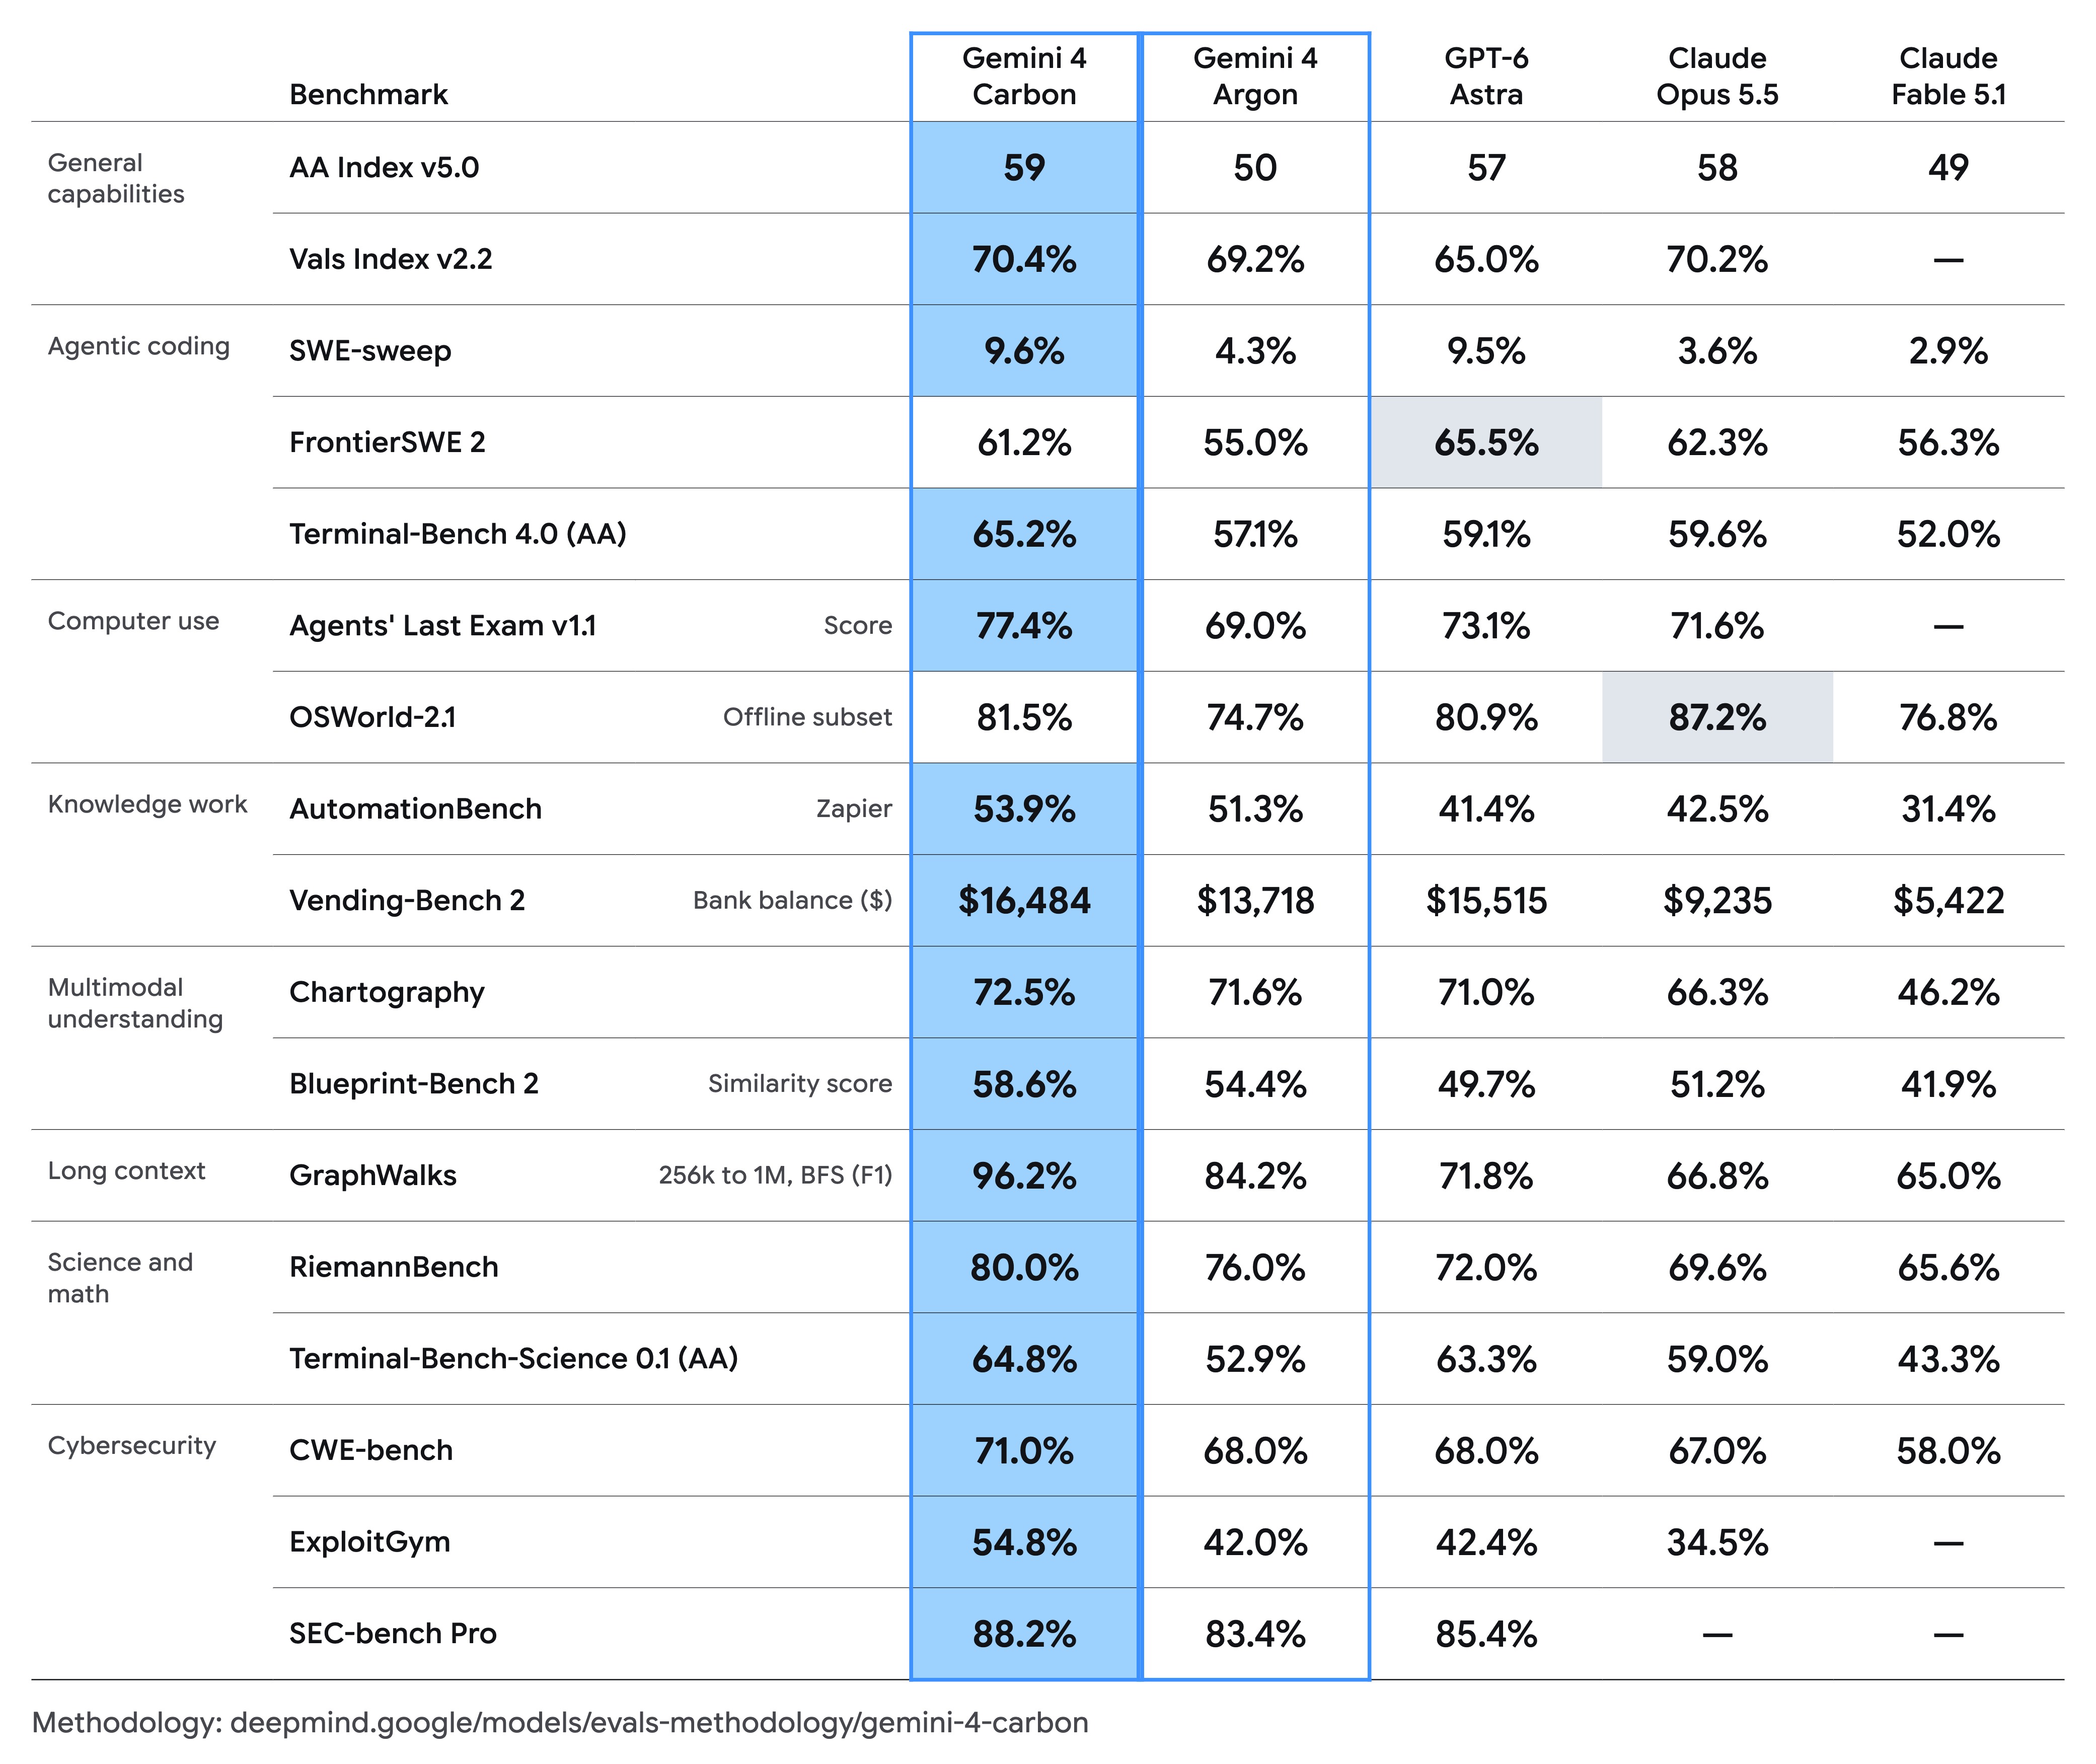
Esta é a tabela oficial do Google, que compara o Carbon com o Argon (o modelo anterior da mesma casa), o GPT-6 Astra da OpenAI, o Claude Opus 5.5 e o Claude Fable 5.1 da Anthropic. Todos os números externos foram avaliados sem restrições de segurança, o que é um aviso importante que volta adiante.
| Benchmark | Carbon | Argon | GPT-6 Astra | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|---|
| AA Index v5.0 | 59 | 50 | 57 | 58 | 49 |
| Vals Index v2.2 | 70,4% | 69,2% | 65,0% | 70,2% | n/d |
| SWE-sweep | 9,6% | 4,3% | 9,5% | 3,6% | 2,9% |
| FrontierSWE 2 | 61,2% | 55,0% | 65,5% | 62,3% | 56,3% |
| Terminal-Bench 4.0 (AA) | 65,2% | 57,1% | 59,1% | 59,6% | 52,0% |
| Agents’ Last Exam v1.1 | 77,4% | 69,0% | 73,1% | 71,6% | n/d |
| OSWorld-2.1 (offline) | 81,5% | 74,7% | 80,9% | 87,2% | 76,8% |
| AutomationBench (Zapier) | 53,9% | 51,3% | 41,4% | 42,5% | 31,4% |
| Vending-Bench 2 (saldo) | US$ 16.484 | US$ 13.718 | US$ 15.515 | US$ 9.235 | US$ 5.422 |
| Chartography | 72,5% | 71,6% | 71,0% | 66,3% | 46,2% |
| Blueprint-Bench 2 | 58,6% | 54,4% | 49,7% | 51,2% | 41,9% |
| GraphWalks (256k a 1M) | 96,2% | 84,2% | 71,8% | 66,8% | 65,0% |
| RiemannBench | 80,0% | 76,0% | 72,0% | 69,6% | 65,6% |
| Terminal-Bench-Science 0.1 | 64,8% | 52,9% | 63,3% | 59,0% | 43,3% |
| CWE-bench | 71,0% | 68,0% | 68,0% | 67,0% | 58,0% |
| ExploitGym | 54,8% | 42,0% | 42,4% | 34,5% | n/d |
| SEC-bench Pro | 88,2% | 83,4% | 85,4% | n/d | n/d |
Traduzindo a tabela em português de gente que precisa saber onde o modelo acerta e onde ele tropeça. O Carbon ganha em 15 das 17 linhas, todas as categorias onde há dado dos dois lados. Os dois empates que importam:
- FrontierSWE 2: o Carbon perde. 61,2% contra 65,5% do GPT-6 Astra. É o benchmark de coding agentivo mais pesado da tabela, e o Carbon não é o melhor nisso. A Anthropic também ganha do Google aqui, com o Opus 5.5 em 62,3%.
- OSWorld-2.1: o Carbon perde feio. 81,5% contra 87,2% do Claude Opus 5.5, que domina uso de computador com folga. O Carbon não é o melhor em operar mouse e teclado.
- SWE-sweep: empate técnico com a Astra. 9,6% contra 9,5%. A OpenAI fica em 3,6% com o Opus 5.5 e 2,9% com o Fable 5.1. Esse é o benchmark que mais separou os modelos nesta geração.
- GraphWalks é o pico: 96,2% contra 84,2% do Argon. É o teste de contexto longo, de 256 mil a 1 milhão de tokens, medindo busca em grafo. O salto de 12 pontos em relação ao próprio Argon é o maior da tabela, e mostra que o ganho do Carbon está concentrado em trabalho com contexto muito grande.
- Terminal-Bench-Science: 64,8% contra 52,9% do Argon. Mais 11,9 pontos, o segundo maior salto da tabela, na categoria científica.
- ExploitGym: 54,8% contra 42,0% do Argon. Mais 12,8 pontos, o maior salto absoluto da tabela, e é o número mais perigoso do anúncio.
Fora da tabela, o Carbon também subiu +89 pontos de Elo no WebDev Arena, chegando a 1768 e à 4ª posição. O Artificial Watch registrou o Carbon com 1538,3 de Elo no LMArena, com 4.282 votos. E o CursorBench 4.0 o colocou em 1º lugar com 60,4% no nível high, a US$ 9,22 por tarefa, contra 60,0% do Claude Fable 5.2 a US$ 32,79. Nesse caso específico, o Carbon ganha em qualidade e ganha em custo.
Cibersegurança: os três números que o Google mais duro
A parte de segurança do anúncio é separada porque cada benchmark mede uma etapa diferente do ciclo de vida de defesa, e misturar os três é o erro clássico que a maioria dos posts de lançamento comete.
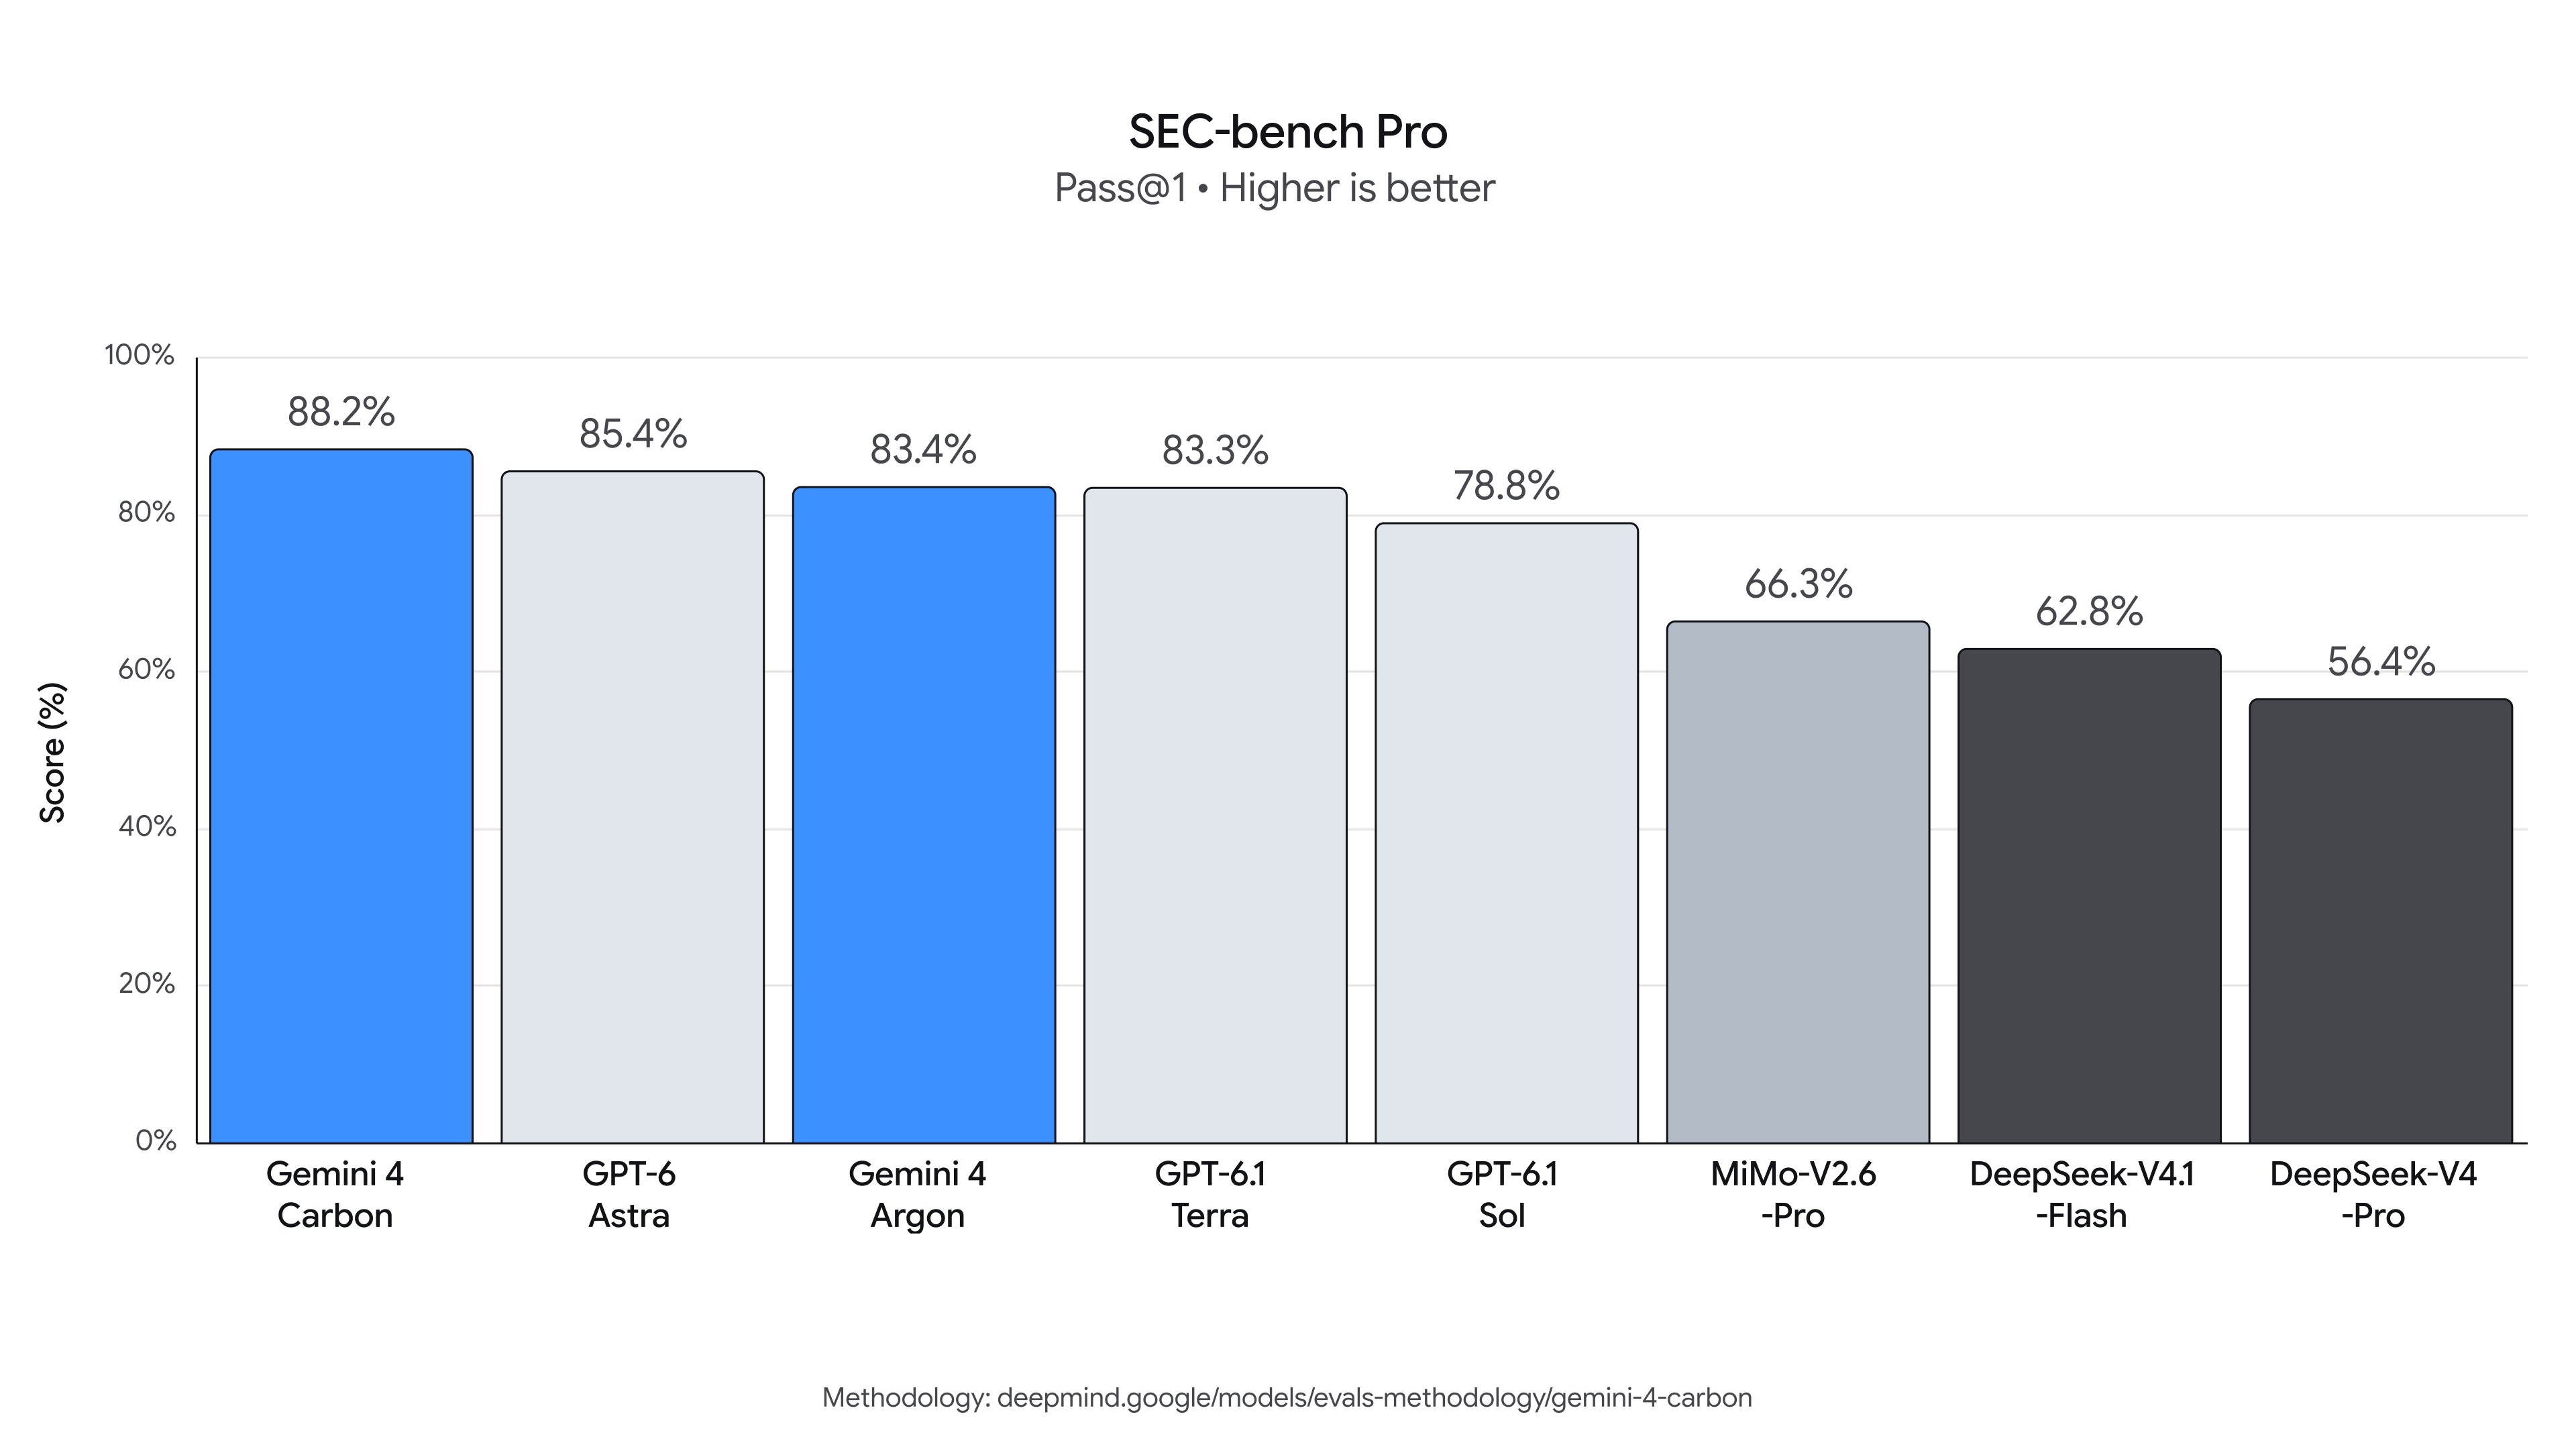
SEC-bench Pro (88,2%) é achar a falha. O agente caça vulnerabilidades em software real e precisa produzir um proof-of-concept que derrube o build vulnerável, mas não o corrigido. O Google rodou num split de 183 tarefas de engines JavaScript de maio de 2026, usando o seu próprio harness Antigravity, com média de três tentativas independentes por tarefa.
| Modelo | SEC-bench Pro |
|---|---|
| Gemini 4 Carbon | 88,2% |
| GPT-6 Astra | 85,4% |
| Gemini 4 Argon | 83,4% |
| GPT-6.1 Terra | 83,3% |
| GPT-6.1 Sol | 78,8% |
| MiMo-V2.6-Pro | 66,3% |
| DeepSeek-V4.1-Flash | 62,8% |
| DeepSeek-V4-Pro | 56,4% |
ExploitGym (54,8%) é provar que dá para explorar. Aqui o padrão sobe: o agente precisa capturar uma flag, e um juiz verifica se a vulnerabilidade pretendida foi realmente explorada. O número do Carbon é da configuração estendida de 10 horas por tarefa, com mitigações desligadas e sem acesso à internet. Na configuração padrão de 6 horas, o Carbon fica em 53,5%.
CWE-bench (71,0%) é corrigir sem quebrar. Este é o único dos três que não foi rodado pelo Google. A Collinear AI avaliou todos os modelos no leaderboard público do CWE-bench, cada um em seu próprio harness, e o Carbon ficou na frente com 71,0% na métrica programática pass-at-one.
Uma advertência que vale mais que os três números: multiplicar 88,2% por 54,8% por 71,0% não dá uma taxa de ataque bem-sucedida. São tarefas, alvos e sistemas de nota diferentes. Nenhum dos três mostra um pipeline autônomo completing todas as etapas no mesmo conjunto de vulnerabilidades.
Resistência a injeção de prompt: o número mais impressionante
Se o Carbon é capaz de achar e explorar vulnerabilidades, a pergunta óbvia é se ele resiste a ser manipulado. No benchmark de Injeção Imediata Indireta (IPI) da Gray Swan, que esconde instruções maliciosas em documentos e páginas web para ver se o modelo obedece, a taxa de sucesso de ataque é medida em 1, 10 e 15 tentativas acumuladas. O número exposto no gráfico é o de 15 tentativas. Menor é melhor.
| Modelo | Taxa de sucesso de ataque (k=15) |
|---|---|
| Gemini 4 Carbon | 0,0% |
| Gemini 4 Argon | 0,7% |
| Claude Opus 5.5 | 1,0% |
| Claude Fable 5.1 | 1,0% |
| Claude Opus 5 | 4,6% |
| Gemini 3.8 Flash | 5,5% |
| GPT-6 Astra | 8,5% |
| GPT-6.1 Sol | 8,6% |
| GLM 5.3 | 31,5% |
| Grok 4.6 | 51,8% |
| Kimi K3 | 52,7% |
O Carbon zerou. Nenhuma das tentativas de ataque avaliadas passou. Isso coloca o Google na frente da Anthropic por uma margem mínima em termos absolutos, mas brutal se você considerar o que a OpenAI e os modelos chineses estão fazendo: o GPT-6 Astra deixa 8,5% passar, o Kimi K3 deixa 52,7%. Um modelo que vai procurar bugs em produção e vai receber documentos de terceiros não pode deixar um terço dos ataques passarem.
O que o Google também mediu, e não publicadas
O anúncio tem uma seção sobre segurança que vale ler, porque o Google mostra o que melhorou e também o que ainda não está resolvido:
- Geração de código seguro: mais de 2 vezes a taxa de sucesso do Argon nos benchmarks internos do Google.
- Patches: mais de 10 vezes melhor que o modelo de fronteira de outro laboratório, segundo a equipe do Chrome.
- Trapaças no Terminal-Bench 4.0 reduzidas para 0,0%, com as tentativas caindo para 0,4%, enquanto a precisão geral melhorava.
- Alertas de desalinhamento de alta gravidade caíram quase 80% nos ambientes de coding ao vivo com as equipes internas.
- Alegações sem fundamento caíram pela metade em relação ao Argon. Em vez de fabricar ou contornar a falta de evidência, o Carbon inclui ressalvas no produto final ou suspende a ação bloqueada com uma lista do que falta.
- Excessos reduzidos em 26% e falta de serviços em 29%, o que gera execução mais confiável de planos de várias etapas.
- Bloqueou 99% das trajetórias de ataque em ambiente de teste simulado com ExploitBench e CyScenarioBench, contra um agente de red-teaming adaptativo que revisita o plano após cada bloqueio.
E o lado ruim: o Google também diz que o Carbon expressa suspeita de estar sendo avaliado com frequência maior do que qualquer modelo recente, e que isso dificulta avaliar o comportamento em situação real. O relatório de Segurança do Google usa o Carbon como um dos alvos principais do teste.
Especificações técnicas
| Item | Especificação |
|---|---|
| ID do modelo | gemini-4-carbon |
| Janela de contexto | 1.048.576 tokens unificados (entrada + saída, incluindo thinking) |
| Saída máxima | 65.536 tokens por padrão, até 1.048.576 com long decode |
| Entradas aceitas | Texto, imagem, vídeo, áudio, PDF, arquivos Office (.docx, .xlsx, .pptx) e OpenDocument |
| Saídas | Texto |
| Níveis de thinking | low, medium (padrão), high. thinking_budget e MINIMAL retornam HTTP 400 |
| Amostragem | temperature 1.0, topP 0.95 e topK 64 são fixos e ignoram valores customizados |
| Cache de contexto | Somente implícito, com mínimo de 4.096 tokens. Cache explícito não é suportado |
| Ferramentas | Execução de código, computer use, function calling, URL context, grounding com Busca e Maps, file search |
| Não suportado | Geração de imagem, geração de áudio, Gemini Live API, RAG Engine, tuning, cache explícito |
| Data de corte do conhecimento | Março de 2026 |
| Consumo | Batch API (50% off), Flex, Priority, throughput provisionado |
| Regiões | global, multi-região us e eu |
| Pesos abertos | Não. O modelo é proprietário e só via API |
A mudança mais relevante da API em relação aos modelos anteriores é o long decode. Em vez de separar entrada, thinking e saída, o Carbon tem uma janela única de 1 milhão de tokens. Isso permite gerar mais de 64 mil tokens de saída numa chamada só, com background=True na Interactions API, o que na prática significa: diffs de múltiplos arquivos, suítes de teste inteiras ou provas longas em uma única passagem, sem de continuar a geração.
Quem pode usar, e por que o Google fez assim
Esse é o ponto mais raro do anúncio. Uma empresa que vende modelo de fronteira normalmente abre para todos e regula depois. O Google fez o contrário: fechou primeiro.
O motivo está no próprio programa. O Fairwind dá acesso antecipado a modelos avançados para defensores de alta prioridade, o que o Google diz incluir governos, prestadores de saúde e operadores de telecomunicações. Mais de 650 organizações participam, e o DeepMind fala em milhares de parceiros globalmente. O Carbon entra pelo Fairwind e pelo CodeMender, o agente de segurança de código do Google, que permite pesquisa de vulnerabilidades e aplicação de patches sem que o parceiro precise montar o próprio harness.
O programa tem regras rígidas: apenas tarefas de uso duplo (simulação de ameaça autorizada, engenharia reversa e análise de malware para defesa e pesquisa), autenticação em nível de usuário com MFA resistente a phishing, acesso restrito a times internos de segurança, resposta a incidentes ou teste de penetração, rastreamento de acesso de cada funcionário, proibição de compartilhar, redistribuir ou vender o acesso, e verificação de antecedentes das organizações candidatas.
Na prática, o Google está organizando o tráfego antes de dar a arma. Um modelo que encontra 88,2% das vulnerabilidades em software real e explora 54,8% delas com exploit funcional é, na mão errada, uma ferramenta de ataque de elite. O anúncio diz isso abertamente: o Carbon chega atrasado para quem constrói defesa, e a justificativa do lançamento controlado é exatamente essa.
Para o desenvolvedor comum, a resposta prática é: você não pode usar o Carbon ainda. O que você pode usar é o Argon, que saiu em 13 de outubro com acesso amplo, e que a Artificial Watch define como “a escolha ideal para a maioria dos trabalhos de engenharia de software e trabalho de conhecimento”. O Carbon é para quando o Argon empaca: bugs de causa raiz em base de código grande, pesquisa científica aberta, defesa de segurança.
O que isso significa
- O Google está fazendo uma aposta sobre que ninguém mais está fazendo. Dois meses atrás a empresa era criticized por launching rápido demais. Agora segura o modelo mais forte do mercado por quase duas semanas, com justificativa de segurança e com o governo dos EUA no processo. É uma mudança de postura radical em um ano, e a razão é o próprio produto: um modelo que encontra e explora vulnerabilidades não pode ser liberado como any other API key.
- A tabela é real e o Carbon é forte, mas não é melhor em tudo. Ele perde do GPT-6 Astra em FrontierSWE 2 (61,2% contra 65,5%) e do Claude Opus 5.5 em OSWorld-2.1 (81,5% contra 87,2%). Se seu fluxo é coding agentivo puro ou automação de desktop, o Carbon não é a melhor escolha, mesmo sendo o primeiro do Índice de Inteligência. Primeiro no índice geral não é primeiro em tudo, e essa é a leitura honesta dos dados.
- O salto real está em contexto longo e em ciência. GraphWalks saltou 12 pontos sobre o próprio Argon, Terminal-Bench-Science 11,9. São as duas categorias onde o modelo precisa manter a coerência ao longo de um milhão de tokens ou em raciocínio formal. É coerente com a proposta do Carbon: rodar por dias em tarefas de engenharia.
- Os números de segurança foram obtidos sem restrições. O Google diz isso explicitamente, e a IDG Briefing original que escreveu o método: rodou SEC-bench Pro e ExploitGym no próprio harness Antigravity e tirou os números dos concorrentes dos system cards e relatórios técnicos deles, que podem usar estrutura de tentativa e ambiente diferentes. Ou seja, a comparação é direcionalmente válida e metodologicamente imperfeita. O CWE-bench é o mais limpo dos três, porque foi a Collinear AI que rodou todos os modelos no mesmo leaderboard.
- Zerar o Gray Swan IPI é o resultado mais subestimado do anúncio. O Carbon passou por 15 tentativas de injeção de prompt sem nenhuma. Num mundo onde agentes leem documentos de terceiros e executam código, isso vale mais do que cinco pontos em qualquer benchmark de coding. O Google também relatou 99% de trajetórias de ataque bloqueadas em teste simulado.
- O preço dobra em 1º de dezembro. US$ 4 e US$ 20 por milhão. O Carbon sai mais barato por tarefa do Índice de Inteligência que o Opus 5.5, mas isso é com o preço padrão, não com o promocional. Decisão de orçamento que ignora essa data é decisão errada.
- Não há pesos abertos, e isso consolida o Google no topo do oligopólio. O Carbon é proprietário, acessível só via API, e o Gemini 4 Argon também. A Anthropic abriu o Fable 5.2 e o Mythos 5.2, a MiniMax abriu o H3-Image, a Meta abriu o Muse Spark Open. O Google está fazendo exatamente o contrário, num momento em que a indústria inteira corre para open-weight. Não é erro de timer, é estratégia: com o modelo mais forte do mundo fechado em acesso seletivo, o Google não precisa perder dinheiro na API para publicar o Developer.
Onde usar
- API:
gemini-4-carbonna Interactions API, com day-one nos SDKsgoogle-genaie no Managed Agents. - Google AI Studio: tier pago da Gemini API e assinantes do Google AI Ultra.
- Google Antigravity: assinantes Ultra, no app desktop, na CLI e nas extensões de IDE, com
/goale times multi-agente via/swarm. - Vertex AI: tier Standard, Priority e throughput provisionado, nos SKUs da Gemini API e do Vertex AI.
- Empresas: Gemini for business via API ou dropdown de modelo, Google Antigravity e CodeMender.
- Cientes da API:
https://ai.google.dev/gemini-api/docs. Vertex:https://cloud.google.com/vertex-ai/generative-ai/docs.
Perguntas frequentes (FAQ)
Posso usar o Gemini 4 Carbon hoje?
Depende de como você conta. O modelo foi anunciado em 28 de outubro e chegou ao tier pago da Gemini API em 10 de novembro, junto com o Vertex AI e o Google AI Studio. O que não existe é acesso livre para qualquer pessoa: o rollout original é via Programa Fairwind para defensores de segurança verificados, e o Google avisa que o acesso geral para desenvolvedores, empresas e consumidores depende de feedback e ajuste das salvaguardas. Na prática, se você tem tier pago da API, provavelmente já consegue; se depende de plano gratuito, ainda não.
Qual a diferença entre o Carbon e o Argon?
Mesma arquitetura, mesmo model card, mesma janela unificada de 1 milhão de tokens e mesmos níveis de thinking. O Carbon é o Argon com pós-treinamento mais pesado, focado em fluxo de trabalho autônomo contínuo, segurança ofensiva defensiva e ciência. Na prática o Carbon consome mais tokens de thinking por turno no mesmo preço por token, o que significa mais barato por token e potencialmente mais caro por tarefa. O Google posiciona o Argon como a escolha para a maioria do trabalho de engenharia e conhecimento, e o Carbon para quando o problema é aberto, longo e difícil.
Por que o Google não lançou o Carbon para todos?
Porque ele acha, explora e patcheia vulnerabilidades com prowess de fronteira. Um modelo com 88,2% no SEC-bench Pro e 54,8% no ExploitGym é uma ferramenta de ataque de elite na mão errada. O Google diz que está participando do processo voluntário de testes pré-lançamento do governo dos EUA e que vai liberar para-programa Fairwind, que tem regras de uso duplo, autenticação forte, restrição a times de segurança e proibição de redistribuir acesso. É uma aposta deliberada de que defender primeiro compensa.
O Carbon é melhor que o Claude Fable 5.2 e o Claude Opus 5.5?
Depende da tarefa. O Carbon ganha no Índice de Inteligência v5.0 (59 contra 58 do Opus 5.5 e 49 do Fable 5.1), em segurança (88,2%, 54,8% e 71,0% nos três benchmarks) e em contexto longo (96,2% no GraphWalks). O Opus 5.5 ganha em OSWorld-2.1 (87,2% contra 81,5%). E na Artificial Analysis v5.0.1 o Claude Fable 5.2 aparece com 65 pontos, acima dos 60 do Carbon, o que mostra que o índice se move rápido e que a liderança do Carbon foi do momento do anúncio. Em coding agentivo pesado, o GPT-6 Astra ainda lidera o FrontierSWE 2 com 65,5%.
O que é long decode e por que importa?
Até os modelos anteriores, a saída máxima era 64 mil tokens incluindo thinking. No Carbon, entrada, raciocínio e saída dividem uma janela única de 1.048.576 tokens. Com long decode, o modelo gera acima de 64 mil tokens numa chamada, usando background=true na Interactions API. Na prática isso permite devolver diffs de múltiplos arquivos, uma suíte de testes inteira ou uma prova longa em uma única passagem, sem custo de continuar a geração nem de reconstruir o contexto.
Quanto custa na prática?
Até 30 de novembro, US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de saída, com cache de entrada a US$ 0,10. A partir de 1º de dezembro, US$ 4 e US$ 20, com cache a US$ 0,20. O Batch API sempre metade do preço. Um workload de 10 milhões de tokens de entrada sem cache mais 1 milhão de tokens de saída custa US$ 30 no promocional e US$ 60 no padrão. No preço padrão, o Carbon custa US$ 7,76 por tarefa do Índice de Inteligência, 23% menos que o Claude Opus 5.5 a US$ 10,04.
Existe versão open-weight ou para rodar local?
Não. O Gemini 4 Carbon é proprietário e não tem pesos abertos. Ele está disponível apenas via API (Gemini API, Google AI Studio, Vertex AI, Google Antigravity, Gemini for business) e pelo Programa Fairwind para defensores verificados. Diferente do Fable 5.2, do Mythos 5.2, do H3-Image da MiniMax e do Muse Spark Open da Meta, que todos têm pesos liberados. O Gemini 4 Carbon não tem como rodar na sua máquina.
Os benchmarks de segurança foram auditados por terceiros?
Parcialmente. O CWE-bench é o mais confiável dos três, porque a Collinear AI rodou todos os modelos no leaderboard público do próprio benchmark, cada um em seu harness. SEC-bench Pro e ExploitGym foram rodados pelo Google no harness Antigravity dele, e os números dos concorrentes vieram dos system cards e relatórios técnicos de cada um, que podem ter estrutura de tentativa e limites de tempo diferentes. E todos os números externos foram obtidos sem restrições de segurança, o que significa que não são o que o cliente vai medir com as salvaguardas que acompanham a distribuição real.
Para ler depois no blog
- Anthropic lança Claude Fable 5.2 e Mythos 5.2: o modelo que formaliza Fermat em 30 horas
- MiniMax H3-Image: 16 megapixels em 10 segundos, open-weight
- Meta lança Muse Spark Open: primeiro modelo aberto americano que compete com Qwen, Kimi e GLM
Referências consultadas
- Gemini 4 Carbon: nosso próximo modelo de fronteira (blog oficial do Google, PT-BR)
- Introducing Gemini 4 Carbon (blog oficial do Google, em inglês)
- Gemini 4 Carbon is now available (anúncio de disponibilidade para desenvolvedores)
- Gemini 4 Carbon Model Card (Google DeepMind)
- Gemini 4 Carbon, especificações completas na Vertex AI (Google Cloud)
- Gemini 4 Carbon Developer Guide (Google AI Studio)
- Fairwind Program (Google DeepMind)
- Google unveils Gemini 4 Carbon, retaking the world’s no. 1 spot on updated, harder benchmarks (VentureBeat)
- Google Says Gemini 4 Carbon Leads in Finding, Exploiting and Fixing Vulnerabilities (SecurityWeek)
- Gemini 4 Carbon: Cyber Benchmarks, Pricing and Access (Tech Current)
- Gemini 4 Carbon leads a code-patching chart by 3 points, but few customers can use it (IDG Briefing)
- Gemini 4 Carbon: pricing, benchmarks and where to use it (Artificial Watch)
- Google’s Gemini 4 Carbon Goes Live on Vertex AI Ahead of General Release (Tilt)
- Artificial Analysis Intelligence Index v5.0
Todas as imagens deste post são oficiais do Google, extraídas do anúncio de lançamento. Os benchmarks de segurança e a tabela comparativa são self-reported pelo Google e foram avaliados sem restrições de segurança, exceto o CWE-bench, que a Collinear AI rodou de forma independente. Os resultados de terceiros citados são de Artificial Analysis, Artificial Watch, VentureBeat, SecurityWeek e IDG Briefing, com as datas de leitura indicadas em cada fonte.