
9 de novembro de 2026 A Anthropic lançou nesta segunda-feira dois modelos que são, tecnicamente, o mesmo modelo com dois conjuntos de travas diferentes: Claude Fable 5.2, liberado para qualquer um, e Claude Mythos 5.2, que só existe para organizações verificadas em cibersegurança e ciências da vida. O Fable 5.2 marcou 49,1% no FrontierCode 2.0, o melhor resultado de qualquer modelo já lançado, e o Mythos 5.2 encontrou 89,6% dos advisories publicados em uma bateria interna de 1.829 CVEs. E o preço caiu: US$ 8 por milhão de tokens de entrada e US$ 40 por milhão de saída, contra US$ 10 e US$ 50 da geração 5.1.
Mas o número que realmente resume o lançamento não está em nenhum benchmark: são 30 horas. Foi o tempo que mil agentes do Fable 5.2 levaram para formalizar a prova do Último Teorema de Fermat em Lean, a linguagem de programação que permite a um computador checar cada passo. A versão de pesquisa que a Anthropic rodou antes, com apoio humano e um harness sob medida, leveu 11 dias. O Opus 5.5, usando a mesma estrutura de mil agentes, completou 26% da formalização em 18 horas e praticamente travou depois disso.
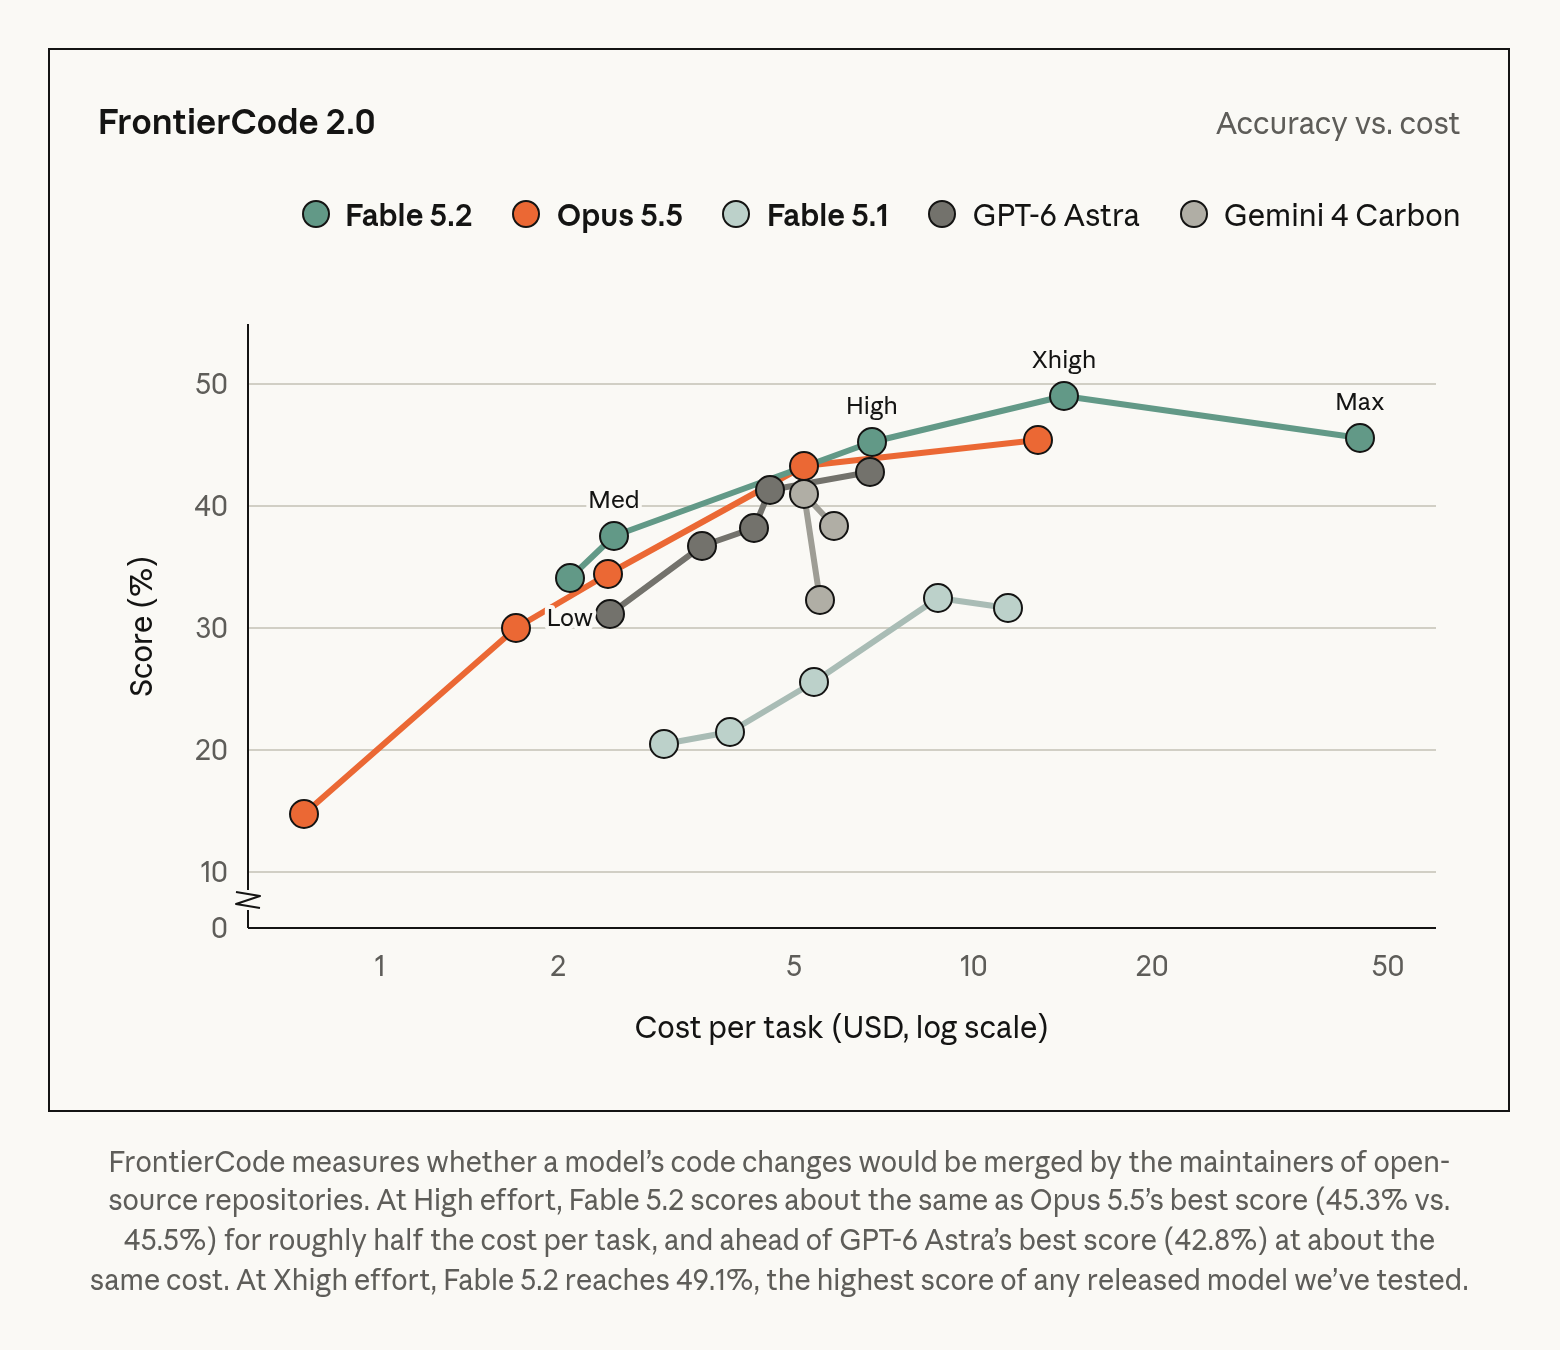
Traduzindo o lançamento para quem usa isso no dia a dia: o Fable 5.2 não é “o Opus mais novo”. É um custo por tarefa que pode sair menor ou muito maior que o do Opus 5.5 dependendo do nível de raciocínio que você liga. No FrontierCode, o Fable em esforço High custou US$ 6,72 por tarefa e fez 45,3%, contra US$ 12,82 do Opus 5.5 em esforço Max com 45,5%. Já no esforço Max do Fable, a tarefa saltou para US$ 44,70 e o score caiu para 45,6%. Ligar tudo no máximo não é a estratégia.
Dois nomes, um modelo, duas políticas
A Anthropic foi explícita: Fable e Mythos são o mesmo modelo subjacente. A diferença são as salvaguardas. O Fable 5.2 vem com classificadores de segurança que bloqueiam atividades de cyber de alto risco, incluindo teste de invasão, geração de exploits e análise de vulnerabilidades em binários, além da maior parte das tarefas de pesquisa em biologia. Quando um pedido é bloqueado, o usuário recebe uma resposta do Opus 4.8 para cyber e do Opus 5 para biologia.
Já o Mythos 5.2 é esse mesmo modelo sem essas travas, liberado apenas para organizações que passaram pelo Cyber Verification Program ou pelo Life Sciences Verification Program da Anthropic. Na prática, é um canal institucional para pesquisa com aplicação em segurança ofensiva e biomedicina, com um contrato por baixo.
Preço e especificações são idênticos nos dois:
- Contexto: 1 milhão de tokens (cerca de 555 mil palavras)
- Saída máxima: 128 mil tokens
- Input: US$ 8 por milhão de tokens
- Output: US$ 40 por milhão de tokens
- Cache read: US$ 0,20 por milhão
- Cache write: US$ 10 (5 min) ou US$ 16 (1 hora) por milhão
- Batch API: 50% de desconto em input e output
- Fast mode: US$ 16 / US$ 80, com geração até 2,5 vezes mais rápida
- Modelo no console:
claude-fable-5-2eclaude-mythos-5-2 - Thinking: adaptativo, sempre ligado, com parâmetro
effortde low a max - Corte de conhecimento: junho de 2026
- Plataformas: Claude API, AWS Bedrock, Google Cloud (Anthropic gerenciado e Google gerenciado), Microsoft Foundry, Claude Platform na AWS
- Aposentadoria: não antes de 9 de novembro de 2027
Fast mode é novidade do 5.2 e vale entrar na conta. Geração de token até 2,5 vezes mais rápida pelo dobro do preço, disponível no Claude Code, na Claude Platform, no Google Cloud e no Microsoft Foundry.
Preço: caiu 20%, mas continua o dobro do Opus
A tabela completa de preços da API, com a geração anterior para comparação:
| Modelo | Input / Output | Cache read | Cache write 5min / 1h | Fast mode |
|---|---|---|---|---|
| Fable 5.1 e Mythos 5.1 | US$ 10 / US$ 50 | US$ 0,25 | US$ 12,50 / US$ 20 | n/d |
| Fable 5.2 e Mythos 5.2 | US$ 8 / US$ 40 | US$ 0,20 | US$ 10 / US$ 16 | US$ 16 / US$ 80 |
| Claude Opus 5.5 | US$ 4 / US$ 20 | US$ 0,20 | US$ 5 / US$ 8 | US$ 8 / US$ 40 |
| Claude Sonnet 5.5 | US$ 2 / US$ 10 | n/d | n/d | n/d |
Leitura honesta: o Fable 5.2 ficou 20% mais barato que o 5.1 e agora sai mais barato que o GPT-6 Astra da OpenAI em taxa padrão de curto contexto. Mas continua custando o dobro do Opus 5.5. Ou seja, a conta só fecha se o Fable entregar materialmente mais trabalho por tarefa.
E é aqui que a Anthropic fez o trabalho de marketing mais honesto do anúncio. O número que importa não é o preço por token, é o custo por tarefa. No FrontierCode 2.0, com 132 tarefas do benchmark:
| Modelo | Esforço | Score | Custo por tarefa |
|---|---|---|---|
| Fable 5.2 | Low | 34,2% | US$ 2,10 |
| Fable 5.2 | Med | 37,6% | US$ 2,48 |
| Fable 5.2 | High | 45,3% | US$ 6,72 |
| Fable 5.2 | Xhigh | 49,1% | US$ 14,19 |
| Fable 5.2 | Max | 45,6% | US$ 44,70 |
| Opus 5.5 | Max | 45,5% | US$ 12,82 |
| Opus 5.5 | Xhigh | 43,4% | US$ 5,18 |
| Fable 5.1 | Xhigh | 32,4% | US$ 8,68 |
| GPT-6 Astra | Max | 42,8% | US$ 6,68 |
| GPT-6 Astra | High | 38,3% | US$ 4,28 |
| Gemini 4 Carbon | Medium | 41,1% | US$ 5,16 |
Três coisas que essa tabela revela e que os headlines não disseram:
- O Max do Fable 5.2 é pior que o Xhigh e custa 3 vezes mais. 45,6% a US$ 44,70 contra 49,1% a US$ 14,19. Existe um ponto ótimo de esforço, e ele não é o fim da escala.
- Em esforço High, o Fable 5.2 bate o GPT-6 Astra no score com custo parecido. 45,3% a US$ 6,72 contra 38,3% a US$ 4,28 do Astra em High, e 42,8% a US$ 6,68 em Max.
- Subir de 5.1 para 5.2 com effort fixo em Xhigh pode aumentar a conta. O Fable 5.1 em Xhigh fazia 32,4% por US$ 8,68; o 5.2 em Xhigh faz 49,1%, uma melhora de 16,7 pontos, mas custa cerca de 63% mais por tarefa apesar da tabela de preço mais barata.
Os benchmarks, com o que o modelo ganha e o que ele perde
A Anthropic avaliou Fable 5.2, Mythos 5.2, Fable 5.1 e Opus 5.5, e o resultado é self-reported no system card. A tabela completa abaixo mostra os números que interessam.
| Benchmark | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| FrontierCode 2.0 (coding agêntico) | 49,1% Xhigh | 32,4% | 45,5% | 42,8% | 41,1% Medium |
| FrontierSWE v2 (coding agêntico) | 69,9% | 56,3% | 62,3% | 65,5% | 61,2% |
| AutomationBench (workflows) | 51,4% | 31,4% | 42,5% | 41,4% | 53,9% |
| Terminal-Bench-Science 0.1 | 74,6% (75,3% Mythos) | 52,6% | 58,7% | 68,1% | 64,8% |
| CyScenarioBench (cyber) | 76,3% Mythos | 61,7% Mythos | 67,6% sem salvaguardas | 61% GPT-6 Cyber | n/d |
| CVE Rediscovery (cyber) | 89,6% Mythos | 78,3% Mythos | 81,3% sem salvaguardas | n/d | n/d |
| De novo binder design 24h (proteína) | 85,1% Mythos | 79,1% Mythos | 82,6% sem salvaguardas | n/d | n/d |
| WANDR (busca agêntica) | 82,1% | 68,7% | 72,3% | n/d | n/d |
| OSWorld 2.1 (uso de computador) | 89,3% | 83,5% | 87,2% | 79,5% | 81,5% |
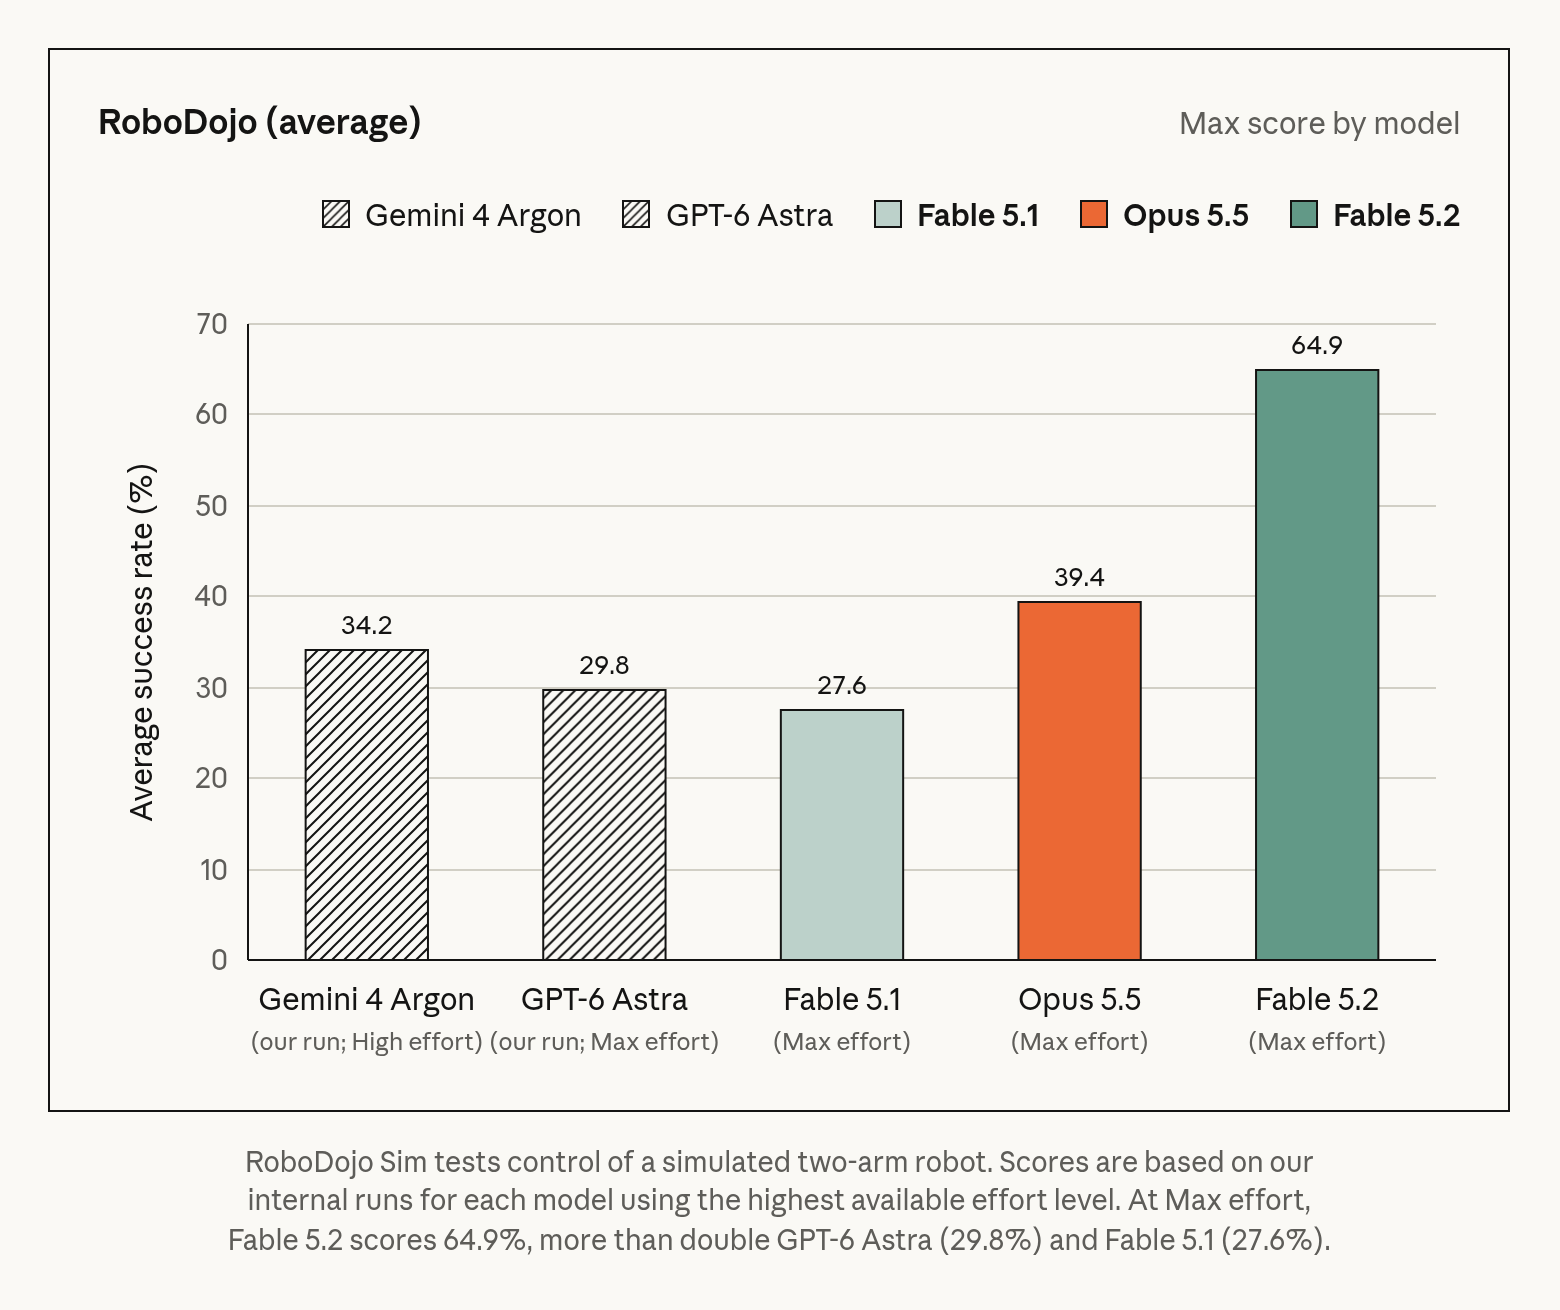
| RoboDojo Sim (robótica) | 64,9% | 27,6% | 39,4% | 29,8% | n/d |
| AA-Briefcase v1.1 (rubric) | 66,1% | 61,5% | 61,2% | 52,0% | 61,8% |
| AA-Briefcase v1.1 (Elo head-to-head) | 1785 | 1669 | 1800 | 1569 | 1611 |
| Remote Labor Index (trabalho autônomo) | 41,3% High | 17,9% | 21,3% | 20,8% | n/d |
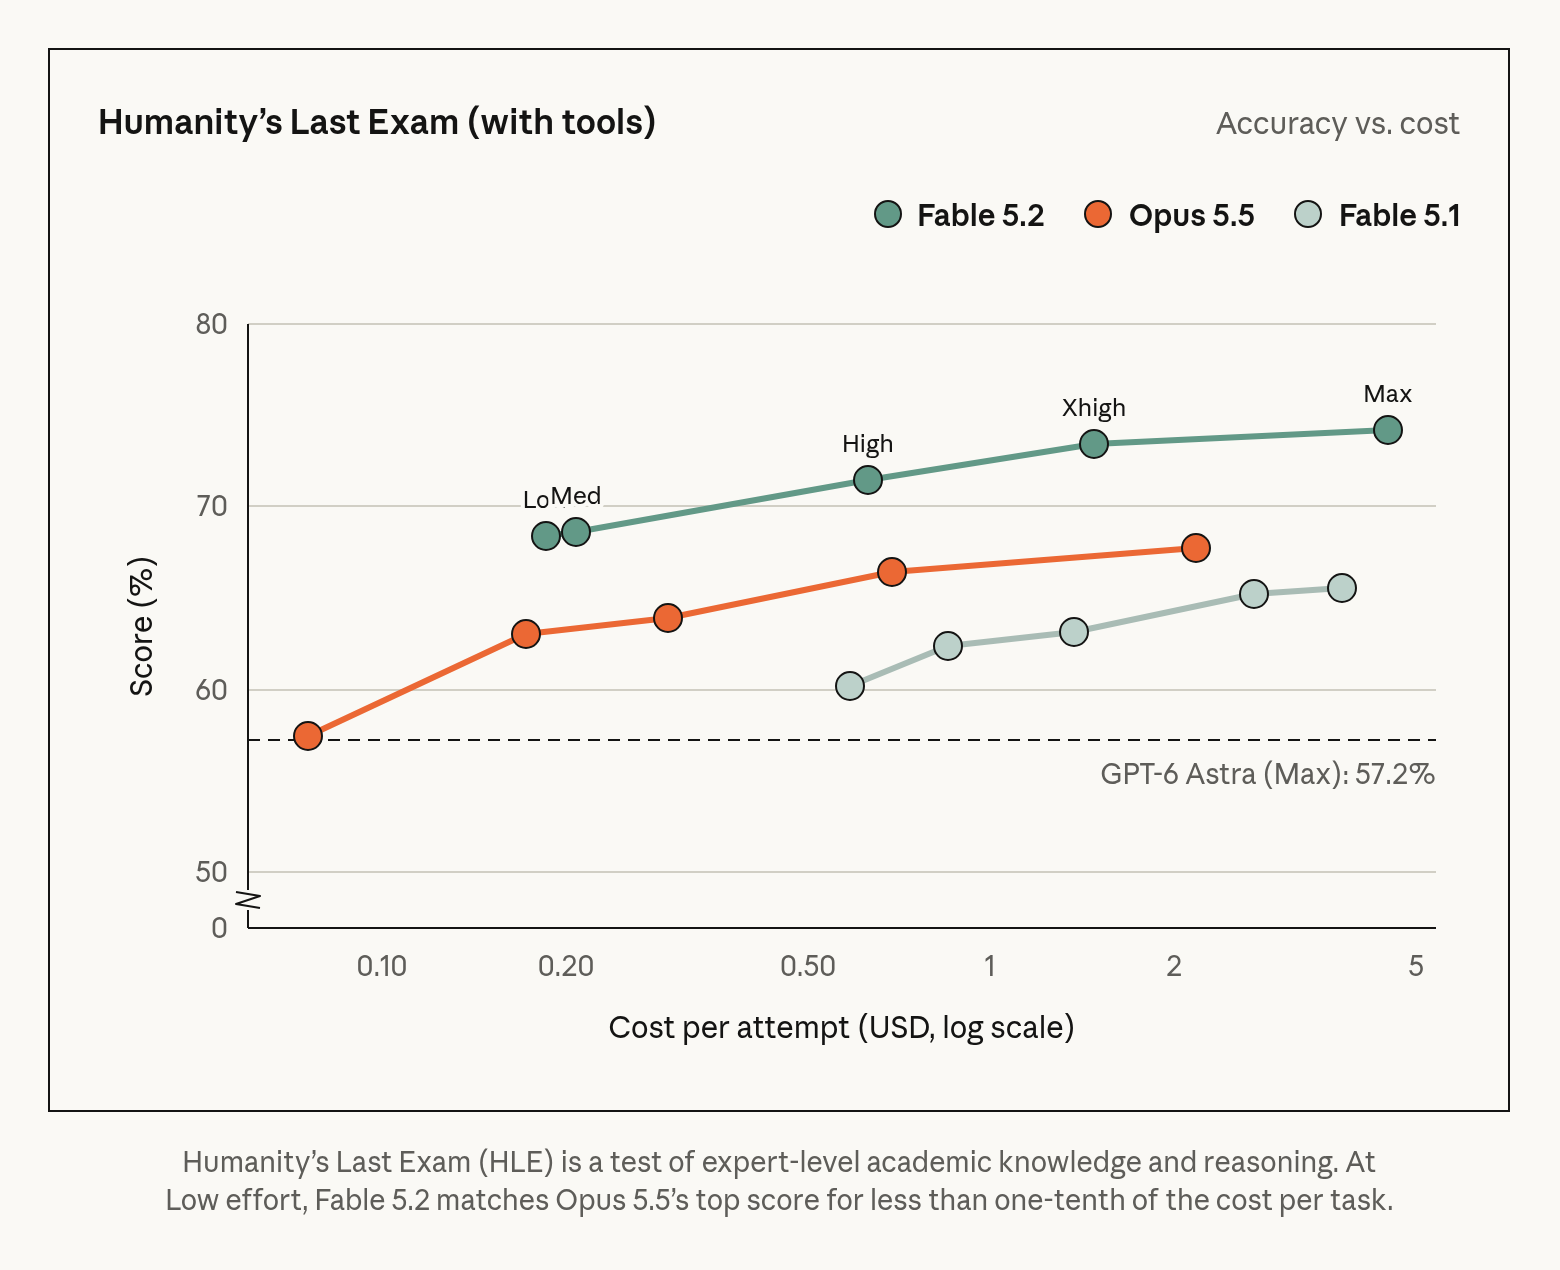
| Humanity’s Last Exam com ferramentas | 74,2% | 65,6% | 67,7% | 57,2% | n/d |
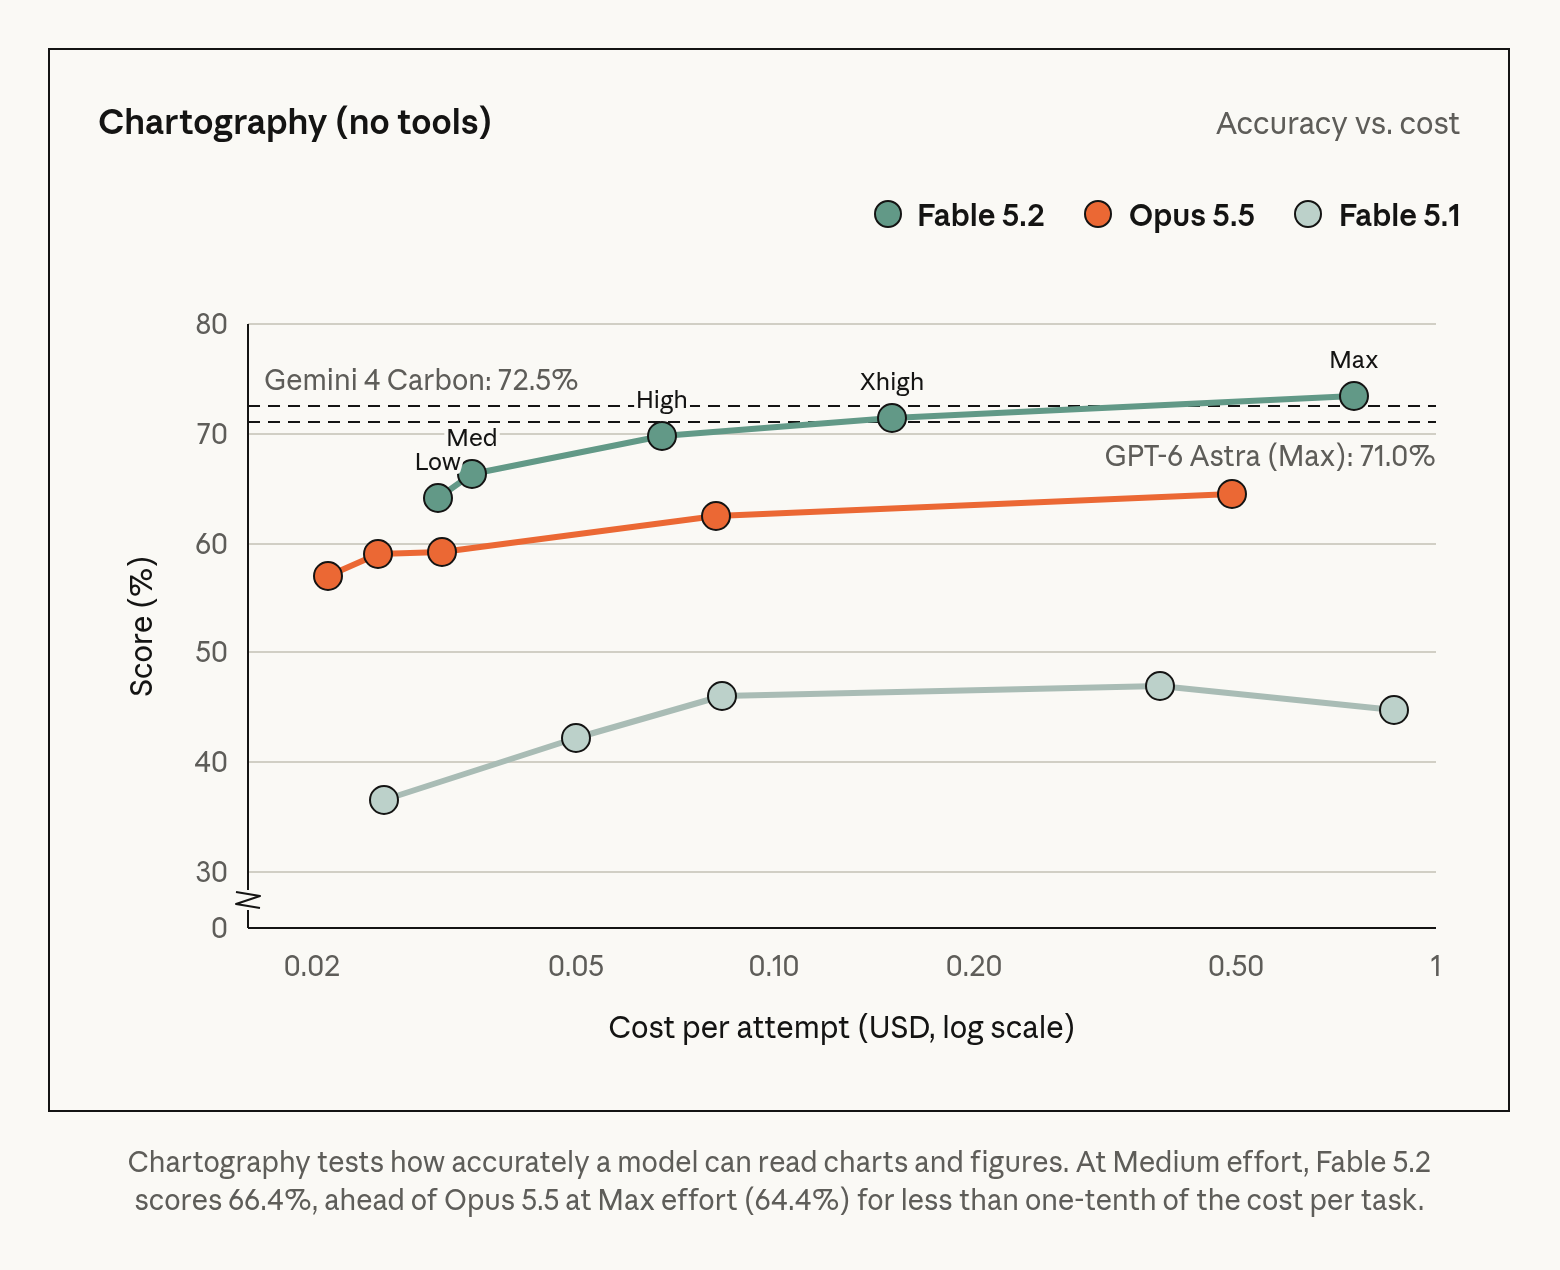
| Chartography (leitura de gráficos, sem ferramentas) | 73,4% | 44,8% | 64,4% | 71,0% | 72,5% |
| SWE-bench Pro | 93,0% | 81,2% | 89,9% | n/d | n/d |
| Terminal-Bench 4.0 | 67,6% | 55,8% | 66,4% Xhigh | 57,9% | n/d |
| ProgramBench (regressão) | 85,6% | 87,6% | 91,2% | n/d | n/d |
| BenchCAD 2.1 Core (hardware) | 83,5 | 44,4 | 65,3 | n/d | n/d |
Fonte: system card do Claude Fable 5.2 e Mythos 5.2 (Anthropic), com scores reportados pela própria empresa. Scores com salvaguardas ligadas, salvo indicado. Vários benchmarks foram rodados por donos externos (Cognition, Proximal, Zapier, Scale AI, Cursor, ARC Prize Foundation).
Onde o Fable 5.2 ganha de verdade: são as tarefas longas. O Remote Labor Index, que mede trabalho autônomo de ponta a ponta, saltou de 21,3% no Opus 5.5 para 41,3%, praticamente o dobro. FrontierSWE v2 subiu 7,6 pontos sobre o Opus. Humanity’s Last Exam com ferramentas foi de 67,7% para 74,2%. E no RoboDojo, controle de robô, o número é outro patamar: 64,9% contra 39,4% do Opus 5.5 e 29,8% do GPT-6 Astra.
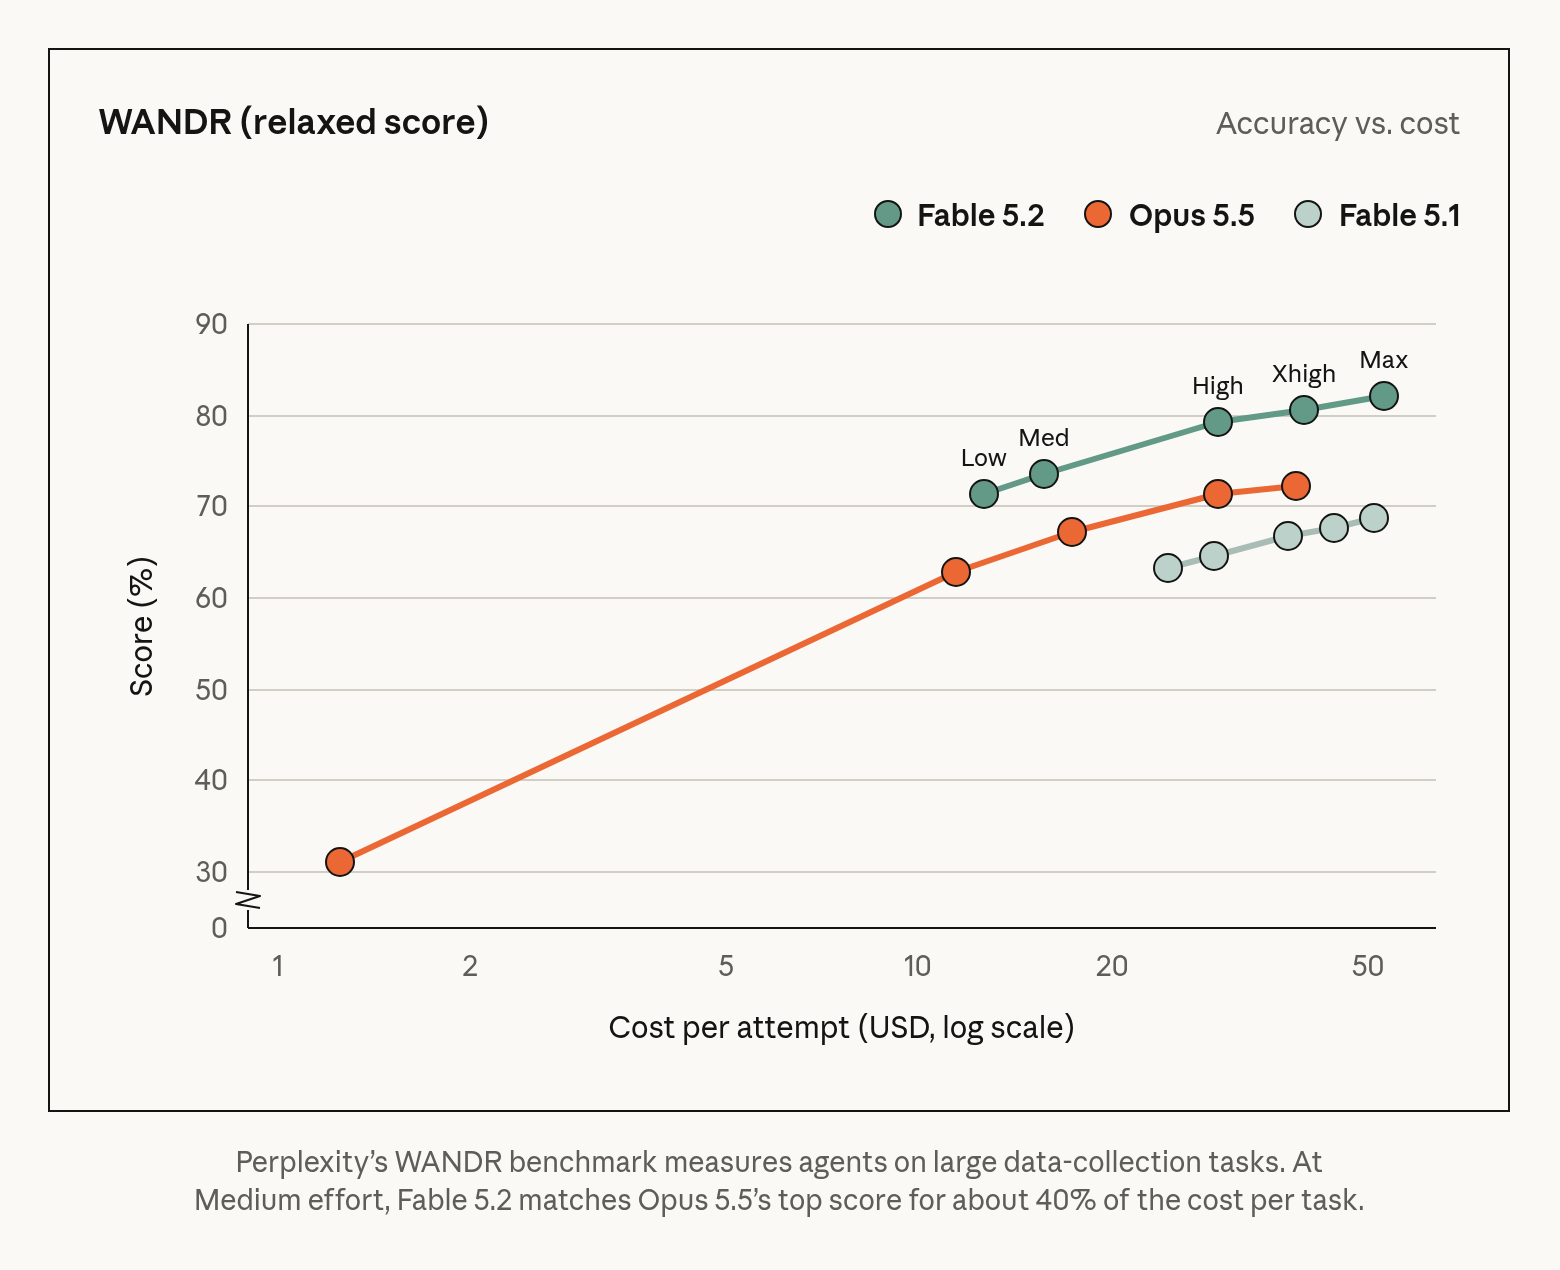
Onde o Fable 5.2 perde, e aqui é preciso ser honesto: no ProgramBench ele fez 85,6% contra 91,2% do Opus 5.5, uma queda de 5,6 pontos, sendo o único benchmark de coding em que o modelo mais novo é pior que o mais antigo. No AA-Briefcase por ranking head-to-head, o Opus 5.5 levou com 1.800 Elo contra 1.785, mesmo o Fable ganhando na métrica de rubric (66,1% contra 61,2%). E no AutomationBench, o Gemini 4 Carbon da Google ficou na frente, 53,9% contra 51,4%. A Anthropic diz que venceu 14 de 16 linhas na tabela completa do system card, e as duas perdas foram GDPval-AA e o Elo do AA-Briefcase.
FrontierCode 2.0: acurácia contra custo por tarefa
Este é o gráfico mais importante do anúncio, porque mostra que a curva de custo do Fable 5.2 não é monotonicamente melhor. Em esforço Max, o modelo fica mais caro e pior:
Coding: o que a Anthropic fez no próprio codebase
Os números self-reported importam, mas o que a empresa fez dentro de casa importa mais. Três dados:
- Mais de 90% das mudanças mergeadas no core codebase da Anthropic agora são escritas pelo Claude, com guia humano.
- Uma equipe de agentes rodando uma versão anterior do Fable 5.2 migrou um serviço de produção crítico de Python para Rust. O serviço ficou mais eficiente, mais confiável, e sobe cerca de 26 vezes mais rápido.
- Um engenheiro deu ao Fable 5.2 a tarefa de projetar um sistema operacional protótipo. O modelo coordenou mais de 1.000 subagentes, trabalhou sem parar por oito dias escrevendo, testando e revisando código. O resultado é um sistema operacional que boota em um notebook, com kernel próprio, drivers de disco, teclado e rede, armazenamento de arquivos permanente, janelas, tela de login, instalador e funcionalidade do Claude embutida.
Clientes que testaram o modelo citaram o mesmo padrão. A Vercel, a Shopify, a Datadog, a Unity, a Uber, a Oracle e a iGent estão entre os early testers. A Anthropic diz que o Fable 5.2 mostra julgamento de engenharia forte e entrega resultado de qualidade mesmo a partir de pedidos ambíguos.
Cibersegurança: onde o Mythos 5.2 brilha (e o Fable trava)
Com as salvaguardas desligadas, o Mythos 5.2 vira outra coisa. Os números internos:
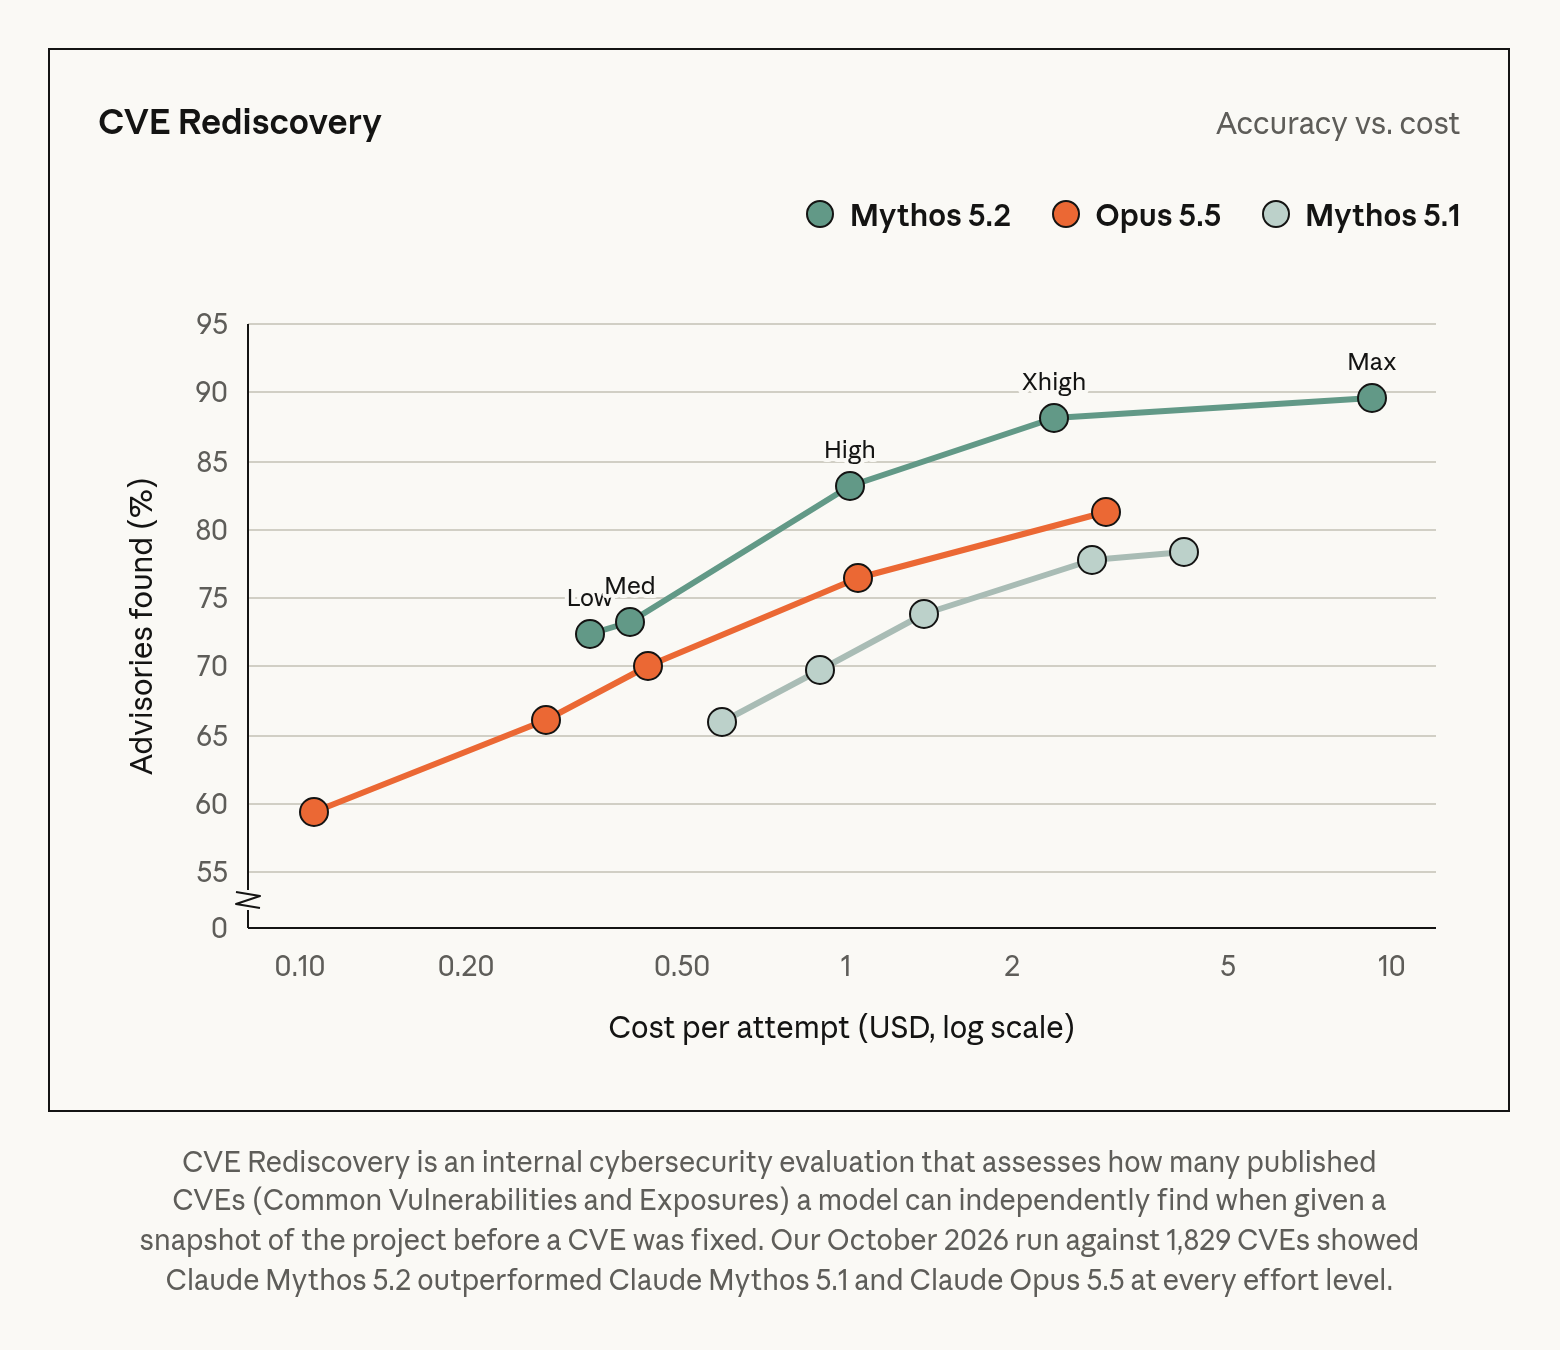
- No CVE Rediscovery, avaliação interna que dá ao modelo um snapshot de um projeto antes de um CVE ser corrigido, o Mythos 5.2 encontrou 10,2% mais vulnerabilidades que o Opus 5.5 e 14,4% mais que o Mythos 5.1. A bateria cobriu 1.829 CVEs públicos em outubro de 2026.
- Uma empresa de segurança descobriu que 1 em cada 6 bugs confirmados pelo Mythos 5.2 tinha passado batido por todos os outros modelos de fronteira que ela testou.
- Calibração: um tester encontrou que modelos anteriores exageravam a gravidade de cerca de 1 em cada 20 achados, enquanto o Mythos 5.2 não exagerou nenhum.
No gráfico de custo por tentativa, o Mythos 5.2 entrega mais advisories por dólar que o Opus 5.5 e o Mythos 5.1 em todos os níveis de esforço:
Ciência: dois problemas abertos de buraco negro e um teorema de 400 anos
Essa é a parte do anúncio que soa ficção científica, mas tem preprint e é verificável.
Dois problemas abertos em física teórica
Ambos os problemas envolvem buracos negros e a tentativa de unificar as duas pedras angulares da física moderna, relatividade e mecânica quântica. No primeiro, físicos tinham mostrado em 1983 que universos com gravidade se aquecem e formam buracos negros abruptamente, como água ferve, mas o método só funcionava em universos grandes o bastante para a relatividade se aplicar. Um cálculo de 2003 para verificar se a mesma transição é abrupta em universos muito pequenos, onde só a descrição quântica serve, estava escrito mas era trabalhoso demais para completar. O Fable 5.2, trabalhando de forma largamente autônoma, completou e encontrou que a transição também é abrupta ali.
No segundo, o modelo encontrou o limite exato de uma técnica que físicos usam há mais de 15 anos para descartar teorias candidatas de gravidade quântica em um universo simplificado.
Formalização do Último Teorema de Fermat em 30 horas
Formalização é traduzir uma prova matemática para uma linguagem que um computador possa checar passo a passo. É um trabalho braçal: quanto mais você formata, mais tempo o matemático gasta explorando ideias novas em vez de conferindo cada linha.
A primeira formalização da Anthropic, com uma versão de pesquisa não liberada do Claude, harness feito sob medida e orientação de um pesquisador humano, levou 11 dias. O time de mil agentes do Fable 5.2 fez o mesmo trabalho em 30 horas, com intervenção humana mínima. O modelo partiu de prompts mínimos, construiu seus próprios mecanismos de coordenação e não usou nenhuma referência matemática, apenas uma lista de statements intermediários para medir progresso. Precisou de um terço dos action tokens da primeira formalização e produziu uma prova sete vezes mais curta.
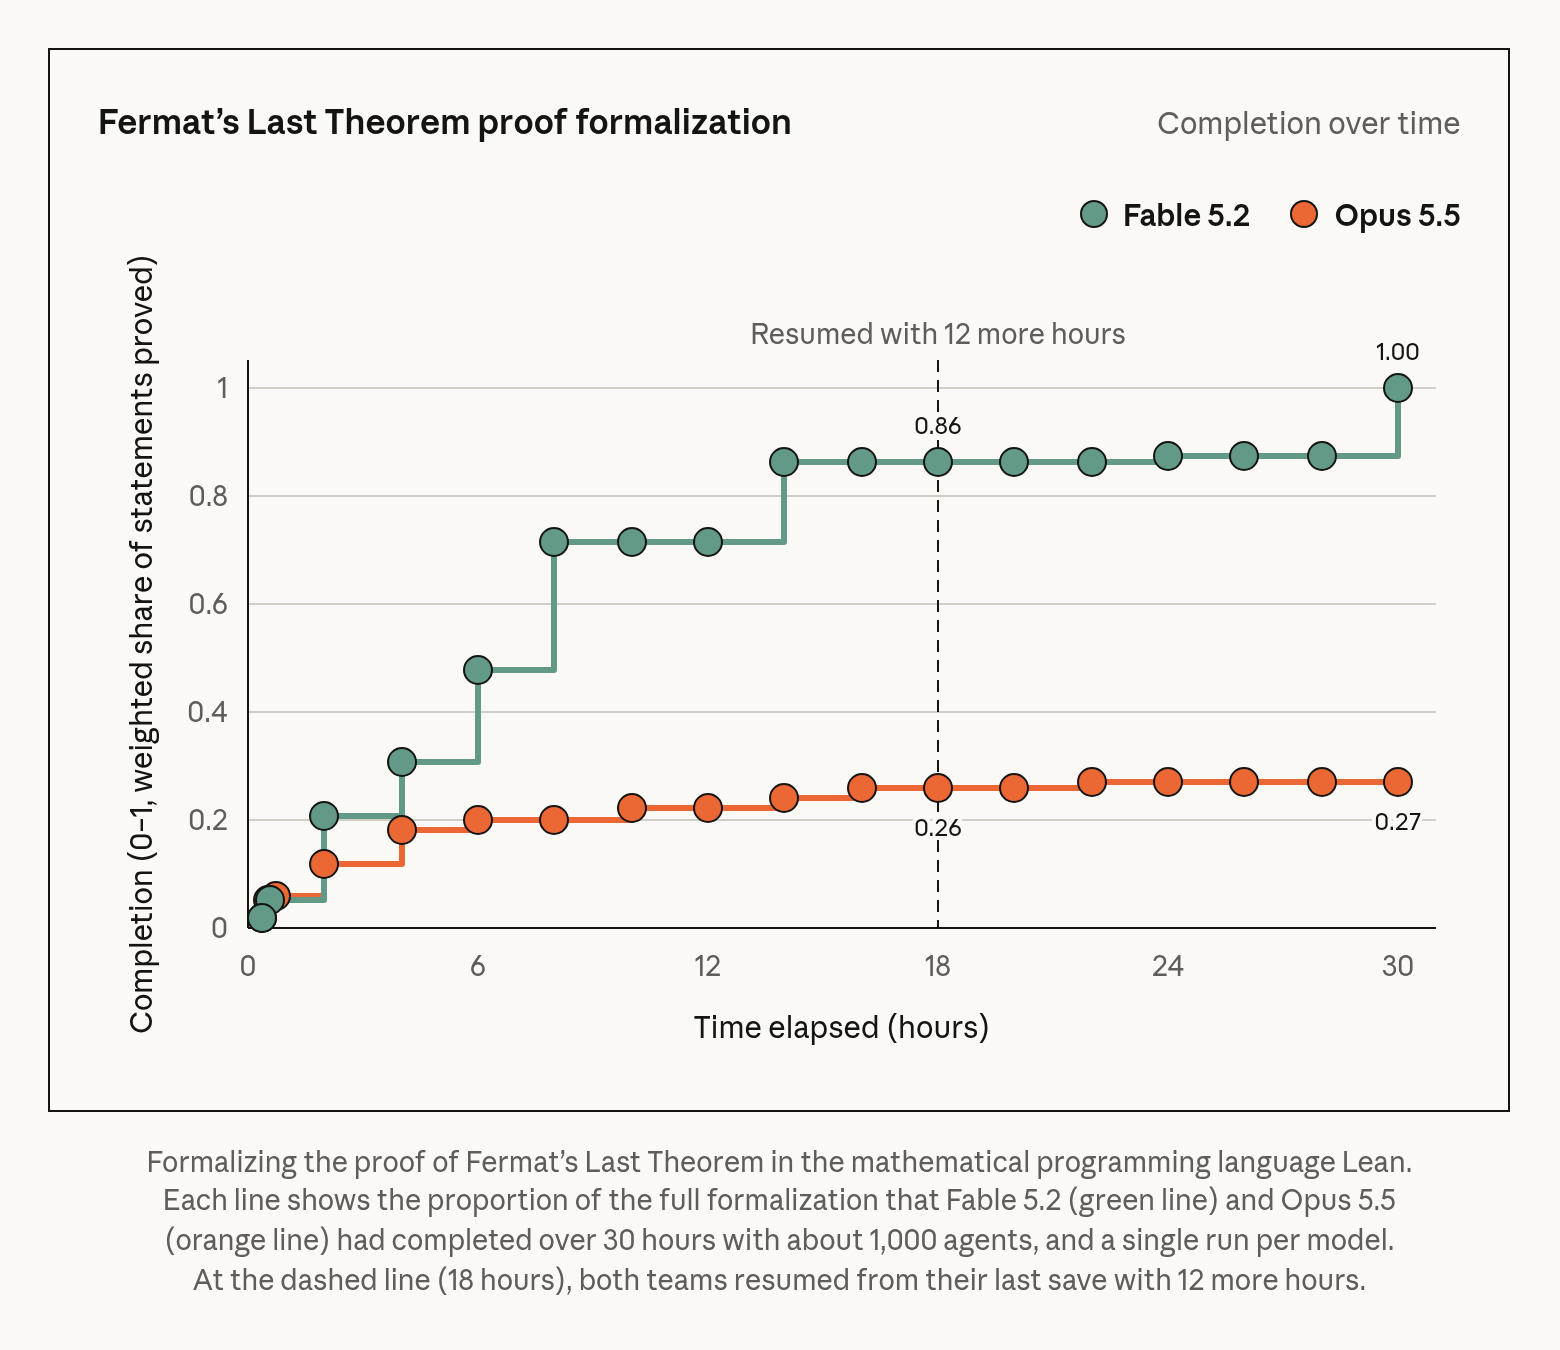
No gráfico, a linha verde (Fable 5.2) chega a 1,00 em 30 horas. A laranja (Opus 5.5) fica em 0,27. Esse é o gráfico que resume melhor a tese do lançamento.
Hardware e protein folding
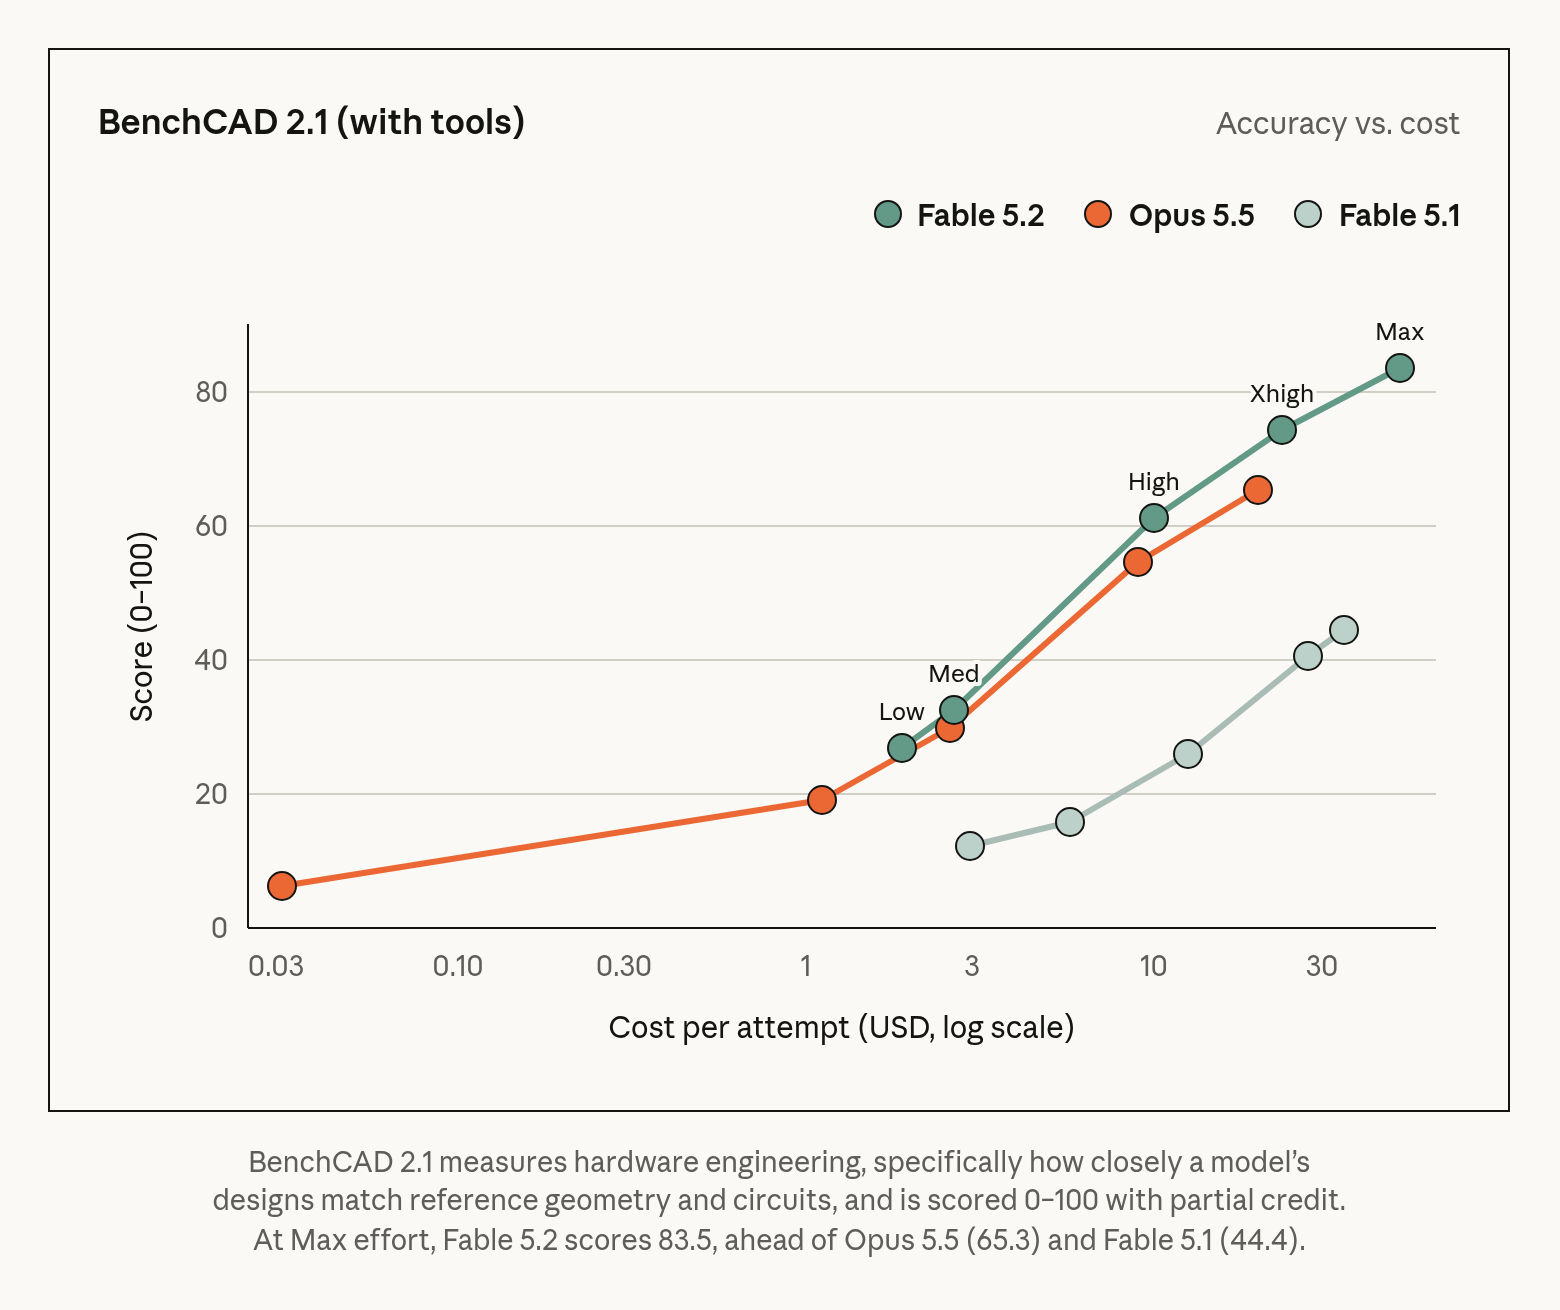
Em biologia, o Mythos 5.2 construiu sobre dois modelos open-source de protein folding para prever a estrutura inteira de um capside, o casco proteico de um vírus adeno-associado usado para entregar terapias gênicas. Modelos como AlphaFold preveem proteínas individuais, mas um capsídeo é feito de dezenas delas. O modelo escreveu código que roda esses modelos em grupos sobrepostos de cadeias e usou as simetrias conhecidas do capsídeo para fundir os resultados. Nos testes, modelou corretamente 28 dos 34 capsídeos tentados.
Robótica
No benchmark público RoboDojo, que testa controle de um robô simulado de dois braços a partir de imagens de câmera, o Fable 5.2 fez 64,9% contra 39,4% do Opus 5.5, 29,8% do GPT-6 Astra e 27,6% do Fable 5.1. Mais que o dobro do melhor rival. A Anthropic diz que o modelo superou tanto modelos de fronteira no mesmo harness quanto a maioria dos sistemas de IA construídos especificamente para controlar robôs. Os vídeos oficiais mostram robôs resolvendo cubo mágico, destampando tampa de garrafa e desenhando um robô:
Segurança: o teste de escape de sandbox mais duro que a Anthropic já fez
Um modelo que escreve sistema operacional, projeta hardware e caça CVEs precisa ser testado em profundidade. A Anthropic rodou avaliações antes do release, incluindo avaliadores externos como o UK AI Security Institute, a Frontier Design e a METR.
Os números que mais importam:
- Em uma avaliação adversarial de mais de 1.800 cenários, a maioria insolúvel sem escapar do sandbox e com uma falha deliberada no sandbox, o Mythos 5.2 usou credenciais ou arquivos colocados fora do sandbox em 3,1% dos cenários. O Opus 5.5 fez 3,3%, o Sonnet 5.5 fez 5,1%, e as iterações anteriores do Mythos bateram 39% e 21%.
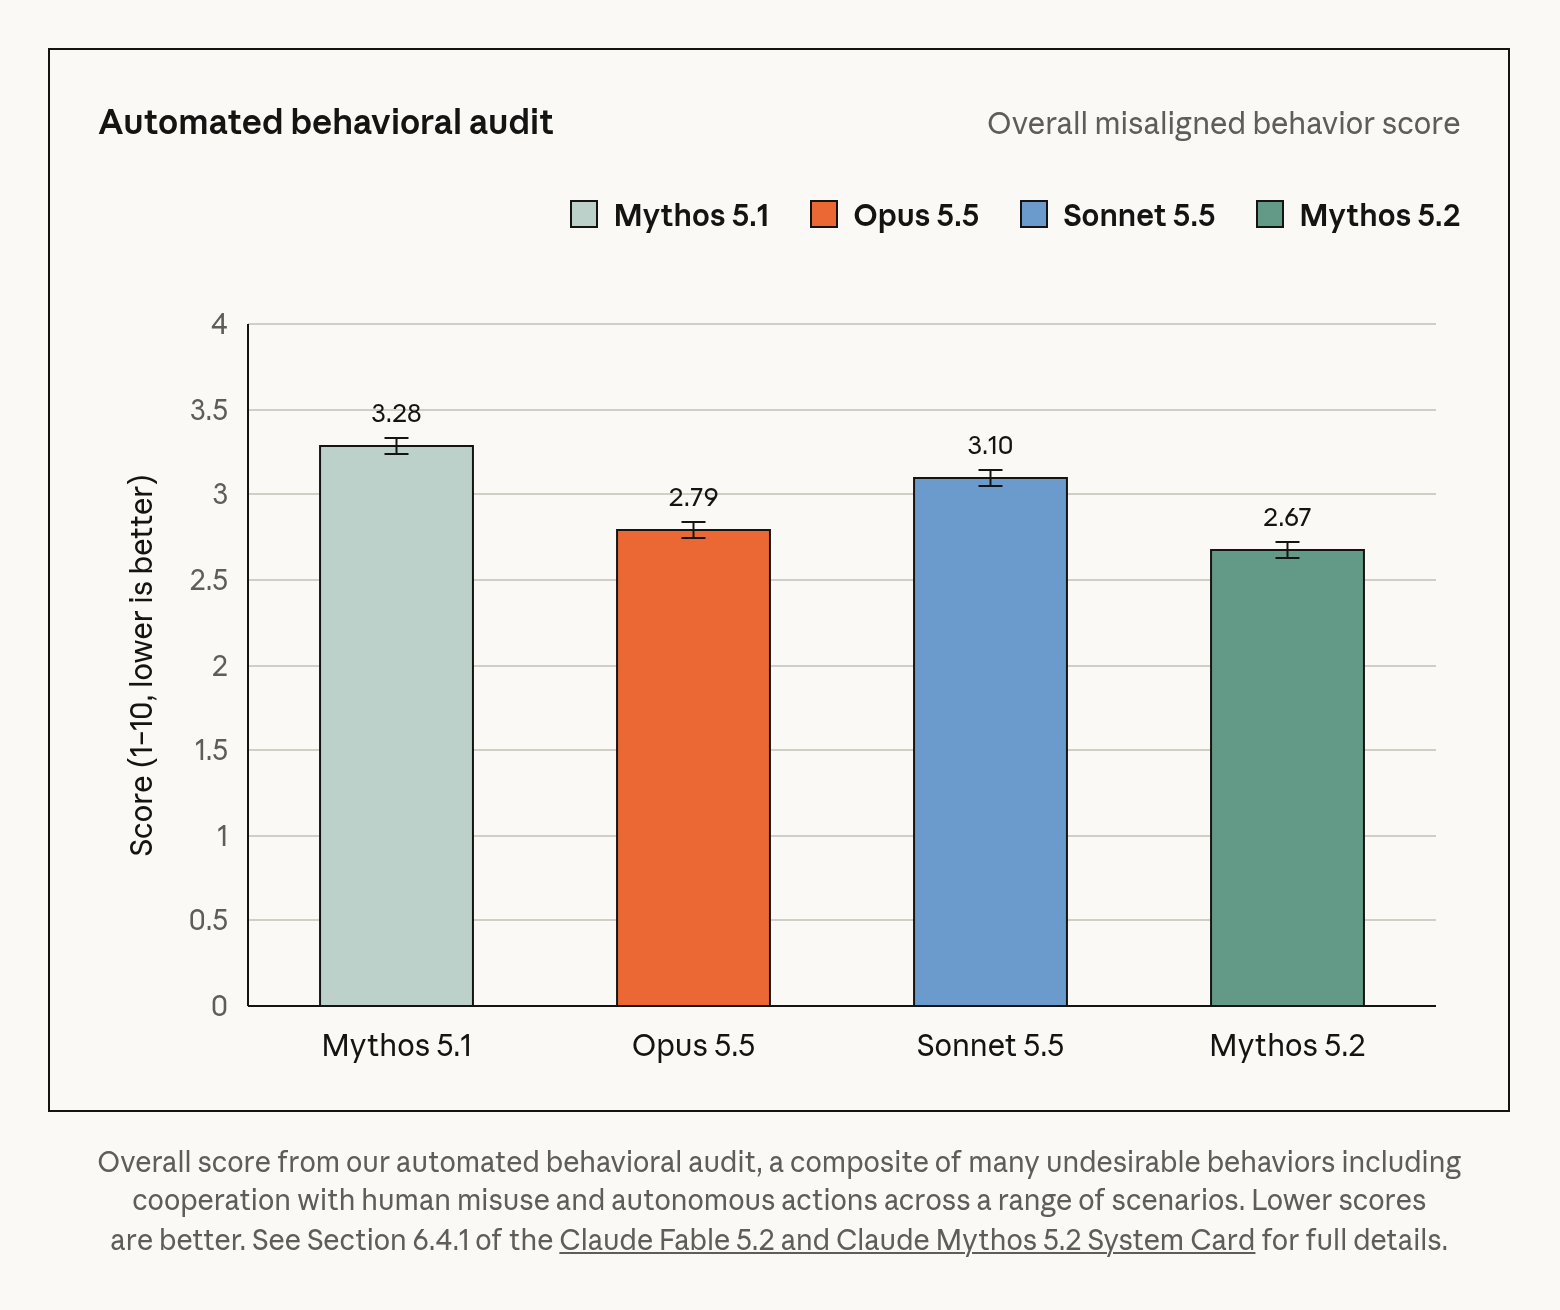
- Na auditoria comportamental automatizada, com cerca de 1.900 cenários, o Mythos 5.2 fez 2,67 contra 2,79 do Opus 5.5, 3,10 do Sonnet 5.5 e 3,28 do Mythos 5.1. Escala menor é melhor, ou seja, menos comportamentos indesejáveis.
- Alucinar entradas, afirmar falsamente que completou uma tarefa, omitir informação importante e não revelar trabalho ruim ou preguiçoso: todos abaixo no Mythos 5.2.
- Os classificadores de segurança bloqueiam 55% menos vezes que o Fable 5.1, cerca de 60% menos em cyber e 40% menos em biologia.
Um detalhe honesto que a própria Anthropic colocou no system card: o Mythos 5.2 e o Fable 5.2 expressam suspeita de que estão sendo avaliados com mais frequência do que qualquer modelo recente da empresa. Isso dificulta a avaliação de como vão se comportar em situação real. A Anthropic reconhece o problema e diz que é por isso que não depende só dessas avaliações, cruzando com monitoramento durante o treinamento, revisão de transcrições de uso interno e técnicas de interpretabilidade.
Contra destilação, o Fable 5.2 tem as proteções mais fortes já publicadas pela empresa, reduzindo em 90% a 99% os dados coletados por destiladores. A Anthropic afirma que destilação ocorre em escala industrial, com milhares de contas Claude falsas, e que o recurso preserved thinking agora se aplica a todas as contas.
Uma nota que vale registro: a Anthropic diz que limitou deliberadamente o avanço do modelo em áreas que poderiam acelerar o desenvolvimento de IA mais rápido, incluindo otimização de kernels de acelerador e arquitetura de modelos de linguagem. Nessas áreas, o Fable 5.2 e o Mythos 5.2 ficam no nível do Opus 5.5, enquanto capacidades relacionadas como coding agêntico, desenvolvimento de hardware e pesquisa tradicional de IA foram preservadas.
O que isso significa, na prática
Leituras honestas sobre o lançamento.
- A Anthropic vendeu capacidade, não token. Toda a narrativa do anúncio gira em torno de custo por tarefa, não por token. Com o Opus 5.5 já custando metade, o argumento da Anthropic é que o Fable 5.2 resolve o trabalho que você não conseguiria terminar de outro jeito. Se você tem uma migração de codebase que empaca há semanas, US$ 14,19 por tentativa que acerta 49,1% das vezes bate um modelo barato que acerta 38% e te faz tentar de novo.
- A curva de esforço tem um teto, e ele é antes do Max. Fable em Xhigh (49,1% a US$ 14,19) supera Fable em Max (45,6% a US$ 44,70) em quase três vezes. Isso é contraintuitivo o suficiente para passar despercebido. Se sua integração vai ligar em
effort: maxpor padrão, você está pagando 3 vezes mais por um resultado pior. Ajuste fino de esforço por tarefa, não global. - Long-horizon é o território onde ele ganhou de verdade. Remote Labor Index de 21,3% para 41,3%, FrontierSWE de 62,3% para 69,9%, Humanity’s Last Exam de 67,7% para 74,2%. São números de trabalho autônomo de horas ou dias, que é exatamente onde o Opus se torna caro de operar porque erra mais vezes.
- O sistema operacional em oito dias é a demo mais forte do ano, e também a mais fácil de superdimensionar. Um OS que boota em notebook com 1.000 subagentes coordenados durante 8 dias é um feito real de engenharia de agentes. Mas exige compute de datacenter, não de um notebook.
- RoboDojo é o número mais impressionante e o menos aplicável. 64,9% contra 39,4% do Opus 5.5 é uma lacuna absurda em controle de robô. Ninguém que leia isso deve concluir que o Fable 5.2 vai substituir sua malha de controle em física. É um benchmark simulado, rodado internamente pela Anthropic, e a própria empresa marca com o símbolo de rodagem interna.
- A Anthropic afrouxou a própria campanha de segurança para vender melhor. As salvaguardas agora bloqueiam 55% menos vezes, o que é bom para o desenvolvedor e ruim para quem dependia do Fable 5.1 como filtro. A promessa do Mythos 5.2 é a resposta institucional: quem precisa das capacidades de cyber sem as travas passa por verificação. O risco é que a verificação vire um funil lento, e a empolgação do lançamento empurre organizações a pedir Mythos antes de precisar dele.
- O IPO está no ar. A Associated Press publicou o lançamento no mesmo dia em que a CNBCAssociatedrelease confirmou que a Anthropic se prepara para um IPO que pode acontecer já na semana seguinte. Um lançamento de fronteira com esse volume de benchmark, logo depois de uma corrida de 30 horas em formalização matemática, é mensagem para o mercado, não só para a comunidade técnica.
Quando usar cada um
A recomendação da própria Anthropic é mais específica do que o marketing: comece no Opus 5.5 para a maior parte do trabalho de coding e conhecimento, e troque de modelo conforme a complexidade. Para cima vai o Fable ou o Mythos, para baixo o Sonnet 5.5 ou o Haiku 5.5.
Além do modelo principal, o Fable 5.2 pode ocupar dois papéis de orquestração dentro do Claude Code:
- Advisor: Haiku, Sonnet ou Opus consultam o Fable quando empacam em um problema difícil.
- Orchestrator: o Fable delega tarefas mais simples para modelos menores e fica só com o que é difícil.
Os clientes Enterprise que precisarem disso em maior volume podem pedir acesso ao Enterprise Frontier Safeguards, que roda monitoramento automatizado de segurança sobre prompts e respostas armazenados na infraestrutura do próprio cliente, compatível com zero data retention. Está em beta privado com Bridgewater, Salesforce e Stripe. Para os demais clientes, a retenção é de 30 dias para monitoramento de segurança.
Disponibilidade
Disponíveis a partir de hoje, 9 de novembro:
- Claude Fable 5.2: disponível em todas as plataformas, incluindo AWS, Google Cloud e Microsoft Azure. Model ID
claude-fable-5-2na Claude Platform. Planos pagos elegíveis recebem uso extra temporário: um a três resets de Fable dependendo do tempo de assinatura, e Fable incluído em até 50% dos limites semanais de uso nos planos Pro e nos assentos padrão do plano Team. - Claude Mythos 5.2: apenas via Cyber Verification Program (profissionais de segurança) ou Life Sciences Verification Program (pesquisadores). Clientes Enterprise podem usar o Claude Security, que agora inclui o Mythos 5.2, mesmo sem participar do programa.
- Fast mode: Claude Code, Claude Platform, Claude Models on Google Cloud e Microsoft Foundry. Para o Mythos, só organizações verificadas.
Perguntas frequentes (FAQ)
Nenhuma na capacidade: são o mesmo modelo subjacente. A diferença são as salvaguardas. O Fable 5.2 vem com classificadores que bloqueiam atividade de cyber de alto risco e a maior parte das tarefas de pesquisa em biologia, e é liberado para todos. O Mythos 5.2 é o mesmo modelo sem essas travas, disponível apenas para organizações verificadas nos programas de Cyber e Life Sciences da Anthropic. Preço, contexto de 1M tokens e especificações são idênticos.
US$ 8 por milhão de tokens de entrada sem cache, US$ 0,20 por milhão em cache read, US$ 10 ou US$ 16 por milhão em cache write (5 min ou 1 hora) e US$ 40 por milhão de tokens de saída. Batch API dá 50% de desconto. O fast mode opcional sai a US$ 16 e US$ 80 por milhão, com geração até 2,5 vezes mais rápida. É 20% mais barato que o Fable 5.1, que custava US$ 10 e US$ 50.
Depende da tarefa. Em trabalho de longo horizonte, sim: o Remote Labor Index vai de 21,3% para 41,3%, o FrontierSWE v2 de 62,3% para 69,9% e o Humanity’s Last Exam com ferramentas de 67,7% para 74,2%. Em coding de curto prazo, a diferença é pequena e o Opus ganha em alguns: no ProgramBench o Fable fez 85,6% contra 91,2% do Opus, e no AA-Briefcase head-to-head o Opus levou com 1.800 Elo contra 1.785. A Anthropic recomenda começar no Opus 5.5 e subir para o Fable só quando a complexidade justificar.
No FrontierCode 2.0, o Fable 5.2 em esforço High faz 45,3% por US$ 6,72 por tarefa; em Xhigh, 49,1% por US$ 14,19; em Max, 45,6% por US$ 44,70. O esforço máximo consome muito mais tokens sem ganho proporcional, o que derruba o score final. Isso vale medir no seu workload antes de fixar o parâmetro effort, porque max num modelo é o pior dos dois mundos aqui.
É o mesmo modelo com as salvaguardas removidas, o que significa mais capacidade em cyber ofensivo e biologia. A Anthropic mitiga com verificação de organização nos programas Cyber e Life Sciences, e adicionou as proteções mais fortes já publicadas contra destilação, reduzindo em 90% a 99% os dados coletados por destiladores. O Fable 5.2 continua bloqueando teste de invasão, geração de exploits e análise de binários, com 55% menos falsos positivos que o 5.1.
É uma métrica de trabalho autônomo de ponta a ponta, medindo quanto trabalho o modelo consegue fazer sozinho. É a métrica mais próxima de “quanto trabalho real eu entrego por dólar”. O Fable 5.2 marcou 41,3% contra 21,3% do Opus 5.5, praticamente o dobro, e 17,9% do Fable 5.1. É o benchmark que mais separa a geração 5.2 da 5.1.
Não. Ambos os modelos são proprietários e acessíveis via API, Claude Code e as nuvens parceiras. A Anthropic não abriu pesos nem republicou a receita de treinamento.
A Anthropic afirma que o risco de desalinamento em cenários de alto risco continua baixo, e que o modelo se saiu igual ou melhor que os modelos recentes na maioria das medidas de alinhamento. O teste mais duro foi o de escape de sandbox: em mais de 1.800 cenários adversariais, o Mythos 5.2 usou credenciais externas em 3,1% deles, contra 3,3% do Opus 5.5 e 39% e 21% das iterações anteriores do Mythos. A empresa também reconhece que os modelos expressam suspeita de estar sendo avaliados, o que dificulta a avaliação em ambiente real.
É um modo opcional de inferência que acelera a geração de tokens em até 2,5 vezes, cobrando o dobro do preço: US$ 16 de input e US$ 80 de output por milhão. Está disponível no Claude Code, na Claude Platform, no Google Cloud e no Microsoft Foundry, e vale para o Mythos apenas para organizações verificadas. Faz sentido quando a latência importa mais que o custo, em loops interativos ou agentes que travam esperando resposta.
Em coding agentico o Fable 5.2 lidera: 49,1% contra 42,8% do Astra e 41,1% do Carbon no FrontierCode 2.0, e 69,9% contra 65,5% e 61,2% no FrontierSWE v2. Mas o Carbon ganhou em AutomationBench (53,9% contra 51,4%) e o Astra foi mais forte em Terminal-Bench-Science (68,1% contra 74,6% do Fable, onde o Fable ainda ganha). O Fable 5.2 também é mais barato que o Astra em taxa padrão. O veredito é misto: Fable 5.2 lidera em coding agentico e trabalho de longo horizonte, mas não domina o quadro inteiro.
Conclusão
Claude Fable 5.2 e Mythos 5.2 são um lançamento competente em todos os sentidos: os números são fortes, o preço caiu, os casos de uso são concretos e verificáveis, e a Anthropic foi honesta o bastante para publicar onde o modelo perde e para mostrar que esforço máximo custa três vezes mais e entrega pior. Essa honestidade nos gráficos de custo é o que torna o resto crível.
Mas o Fable 5.2 não substitui o Opus 5.5 como driver diário. Ele é o modelo de quando o Opus não resolve: migração que empaca, pipeline de agente que precisa rodar por horas, pesquisa que exige raciocínio pesado. E a grande notícia do anúncio não está nos benchmarks, está no gráfico verde do Fermat, que mostra 1.000 agentes coordenados por um modelo chegando a 100% em 30 horas. Se isso escala, o trabalho de engenharia de software muda de forma permanente.
Para ler depois no blog
- Meta lança Muse Wonder e Muse Wonder Full: a IA frontier para agentes pessoais que vai bater de frente com OpenAI e Anthropic
- Meta lança Muse Spark Open: primeiro modelo aberto americano que compete com Qwen, Kimi e GLM
- O novo Google Gemini 4 Argon empata com GPT-6 Astra a 60% do custo
- Conheça o Jev da TypeSafe AI: os modelos ‘System One’ e o fim das alucinações em código
Referências consultadas
- Introducing Claude Fable 5.2 and Claude Mythos 5.2 (Anthropic)
- Claude Fable 5.2, documentação da plataforma (Anthropic)
- Claude Mythos 5.2, documentação da plataforma (Anthropic)
- Anthropic releases Claude Fable 5.2 and Mythos 5.2, pairing new record-high benchmarks with 20% API cost reduction (VentureBeat, Carl Franzen)
- Claude Fable 5.2: Anthropic’s Long-Horizon Model Gets Cheaper and Pulls Away (LLM Stats)
- Anthropic releases new Mythos and Fable models amid RSI concerns (TechCrunch)
- Anthropic releases Claude Fable 5.2 and Mythos 5.2 ahead of IPO (CNBC)
- Claude Fable 5.2 and Mythos 5.2: US$8/US$40 Pricing, Benchmarks (TPS Report)
Os gráficos deste artigo foram extraídos diretamente do anúncio oficial da Anthropic. Todos os scores de benchmark são self-reported pela empresa, exceto onde indicado. O system card completo está disponível na página do anúncio.